-
OCP Global Summit 2026 리뷰최신 기술동향 2026. 10. 19. 08:00
반도체 및 AI 데이터센터 동향을 파악하기 위해, 10월 12~15일 미국 산호세에서 열린 OCP (Open Compute Project) Global Summit 2026을 직접 다녀왔다. 참고로 저번에 정리한 Computex 글보다는 기술적인 내용이 많다. Computex는 젠슨황을 비롯한 주요 기업 CEO들의 키노트가 메인이었으면, OCP는 AI 데이터센터 규격을 위한 엔지니어들의 발표가 메인이기 때문이다. 이 글은 현장의 키노트·세션·부스에서 확인한 내용을 정리한 리뷰다.
OCP가 열리는 산호세의 McEnery Convention Center 1. Computex와 OCP, 그리고 이번 리뷰의 관점
Computex가 칩·서버 회사가 "이 칩으로 무엇을 할 수 있나"를 보여 주는 공급사(벤더) 중심 행사라면, OCP는 Meta·Google· Microsoft 같은 수요자(하이퍼스케일러)가 "우리 데이터센터에는 이런 규격이 필요하다"를 얘기하는 자리다. (벤더사들도 와서 Proposal을 한다.) 이런 이유로, Computex와 OCP를 둘 다 들어야, 공급과 수요 양 측의 관점을 볼 수 있다는 생각으로 상반기에는 Computex, 하반기에는 OCP를 참석하게 되었다. OCP는 2011년 Facebook(현 Meta)이 자사 데이터센터 설계를 공개하며 시작한 비영리 단체이고, 지금은 회원사 약 600곳이 함께 랙·전력·냉각·네트워크의 공통 설계 기준을 만든다. 2025년 10월에는 AMD·Arm·NVIDIA도 이사회에 합류했다.
이번 리뷰는 세 가지를 기준으로 봤다.
- 하이퍼스케일러가 "필요하다"고 밝힌 기술과 배치 규모
- 실물인지 발표인지 (칩·랙·데모 vs 문서·로드맵)
- 하이퍼스케일러가 "아직 없다"고 말한 부분 (새 사업 기회)
2. 데이터센터 통합 설계 - 칩부터 전력까지 "세트"로 설계하고, 부품은 규격으로 사 온다
AI 데이터센터는 GPU 수만 개가 한 몸처럼 돌아야 해서, 칩·랙·네트워크·전력·냉각 중 하나만 따로 고르면 전체가 가장 약한 곳에 맞춰진다. 그래서 하이퍼스케일러는 스위치·랙·전원을 OCP 규격에 맞춰 직접 설계하고, 주요 부품은 협력사에서 사 온다. Microsoft·Oracle 키노트와 Meta·NVIDIA 세션에서 공통으로 보인 구조를 정리하면 아래와 같다[1][2][3].
층 하이퍼스케일러가 직접 설계 협력사에서 사 오는 부품 칩 MS Maia 300(추론)·Cobalt 200(CPU)·DPU·보안칩 4종, Meta MTIA, Google TPU - "칩·SW·시스템을 함께 설계" HBM·기판·첨단 패키징, 레이저, 전력반도체 랙 · 전원 Meta ORW 랙, MS Mt Diablo(±400V 전원 랙), NVIDIA MGX·800V 설계 기준안, Google·MS·NVIDIA SST 공통 규격(구현은 협력사) 파워셸프·커넥터·버스웨이, SST·배터리, 차단기 네트워크 Meta Tahan 스위치·ESUN 규격, MS MRC 전송 규칙, Oracle 광모듈 감시 규격 제안 스위치 칩(Broadcom), 광모듈·케이블, NIC·리타이머 냉각 MS Mt. Atlas 열교환기·구역 냉각, Oracle 냉각 신뢰성 기준 공동 표준화 냉각판·CDU·펌프·배관, 누수 감지 보안 · 운영 Tessera 서버 보안칩 규격(Oracle·MS·Marvell), DPU 공통 틀, 고장 예측 운영 보안칩·DPU 실물, 진단·검증 도구 직접 설계하는 이유는 '최적화'로 정리된다. 물량이 많은 하이퍼스케일러들 입장에서는 자기 시스템에 최적화된 칩, 전력 등을 설계하는 것이 가성비가 좋다.규모 면에서도 GPU 수만 개가 발을 맞춰 돌면 먼지 낀 광모듈 하나가 학습 전체를 늦춘다(Oracle). 그래서 자기 기준으로 상태를 재고 바로 뺄 수 있어야 한다.또한, 자신들의 설계 내에서 공급사를 늘려 가격을 낮추기 위한 요인도 있다. Meta는 스위치 규격·OS·전송 규칙을 공개해 만들 수 있는 회사를 늘렸고, Google·MS·NVIDIA는 새 변압기(SST) 규격의 요구 사항을 하나로 맞췄다(규격 0.3판 공동 저자).
개방 랙(Open Rack)이란
랙은 서버를 층층이 꽂는 철제 틀이고, "개방 랙"은 설계도가 OCP에 공개돼 여러 회사가 같은 규격으로 만드는 랙이다. 바깥 폭은 대부분 600mm로 같고 안쪽 장비 칸 폭과 전원 위치가 다르며, Meta가 기여한 ORW만 2배 폭(1,200mm)이다[4][5].
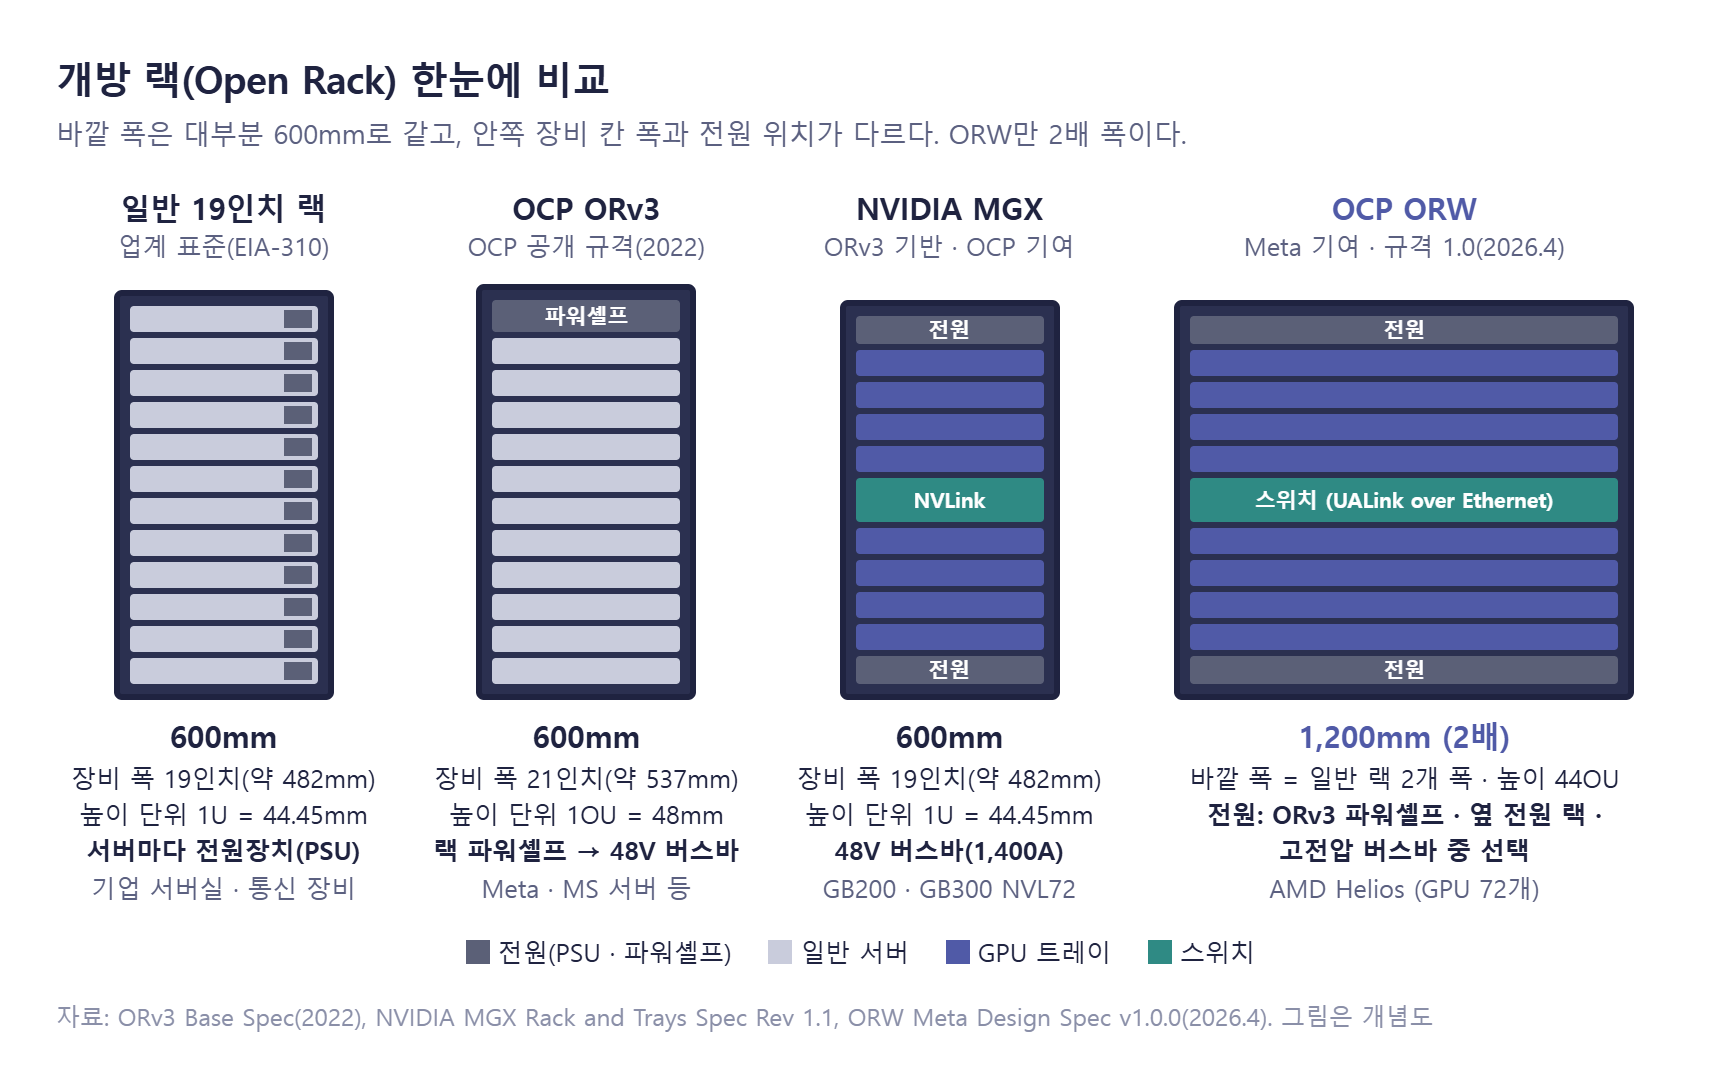
그림 1. 일반 19인치 랙 · OCP ORv3 · NVIDIA MGX · OCP ORW 비교
- ORv3: 바깥 폭 600mm 그대로, 안쪽 칸을 21인치로 넓히고 전원을 랙에 모았다.
- NVIDIA MGX: ORv3를 고쳐 19인치 장비가 들어가게 한 랙이고, 설계는 OCP에 공개했다(2024.10). Meta는 같은 GB200을 자체 ORv3 고전력 랙(Catalina, 140kW)에 쓴다.
- ORW가 2배 폭인 이유: 칩이 커지고 무거워져서다. 트레이 하나에 큰 가속기 4개를 나란히 놓고, 같은 무게를 2배 바닥 면적에 나누며(프레임은 최소 4.7톤을 버티게 설계), 배관·케이블 공간이 넓어 선반을 하나씩 따로 빼서 수리할 수 있다. 대신 바닥 공간을 더 쓰고 줄 배치를 새로 짜야 한다. NVIDIA는 600mm 폭에 GPU 72개를 빽빽하게 넣는 쪽이다.
이 구조에서 "또 하나의 스위치·랙·AI 칩"을 만드는 회사는 고객이 곧 경쟁자가 된다. 반대로 ESUN·SST·Tessera 같은 규격 작업에 깊게 관여하는 부품 회사일수록 다음 발주를 받을 가능성이 높아진다.
3. 키노트 - 에이전트가 CPU 시장을 다시 키운다
첫날 키노트에서 가장 인상적이었던 것은 GPU가 아니라 CPU 이야기였다. AMD와 Arm이 같은 날 "에이전트 AI가 CPU 수요를 폭발시킨다"는 같은 메시지를 냈다.
AMD Lisa Su - 2026년은 추론의 해
Computex의 주요 연사가 Nvidia의 젠슨황이었다면, OCP의 주요 키노트 연사는 AMD의 Lisa Su였다. Lisa Su는 학습 연산이 2020년부터 매년 5배씩 늘어나는 가운데 올해 추론이 AI 시장의 약 60%로 학습을 넘어섰고, 에이전트 트래픽은 연초 대비 14배(OpenRouter 기준)라고 했다. 월 토큰 사용은 2년 새 95배, 지금은 월 약 4경 개다[6]. 에이전트는 GPU만 쓰지 않는다. 모델이 계획을 세우면 CPU가 코드 실행·검색·DB 조회·API 호출을 하고, 그 결과를 다시 모델이 읽는 과정을 수십~수백 번 반복한다. 토큰이 늘수록 CPU도 함께 늘어나는 구조다.
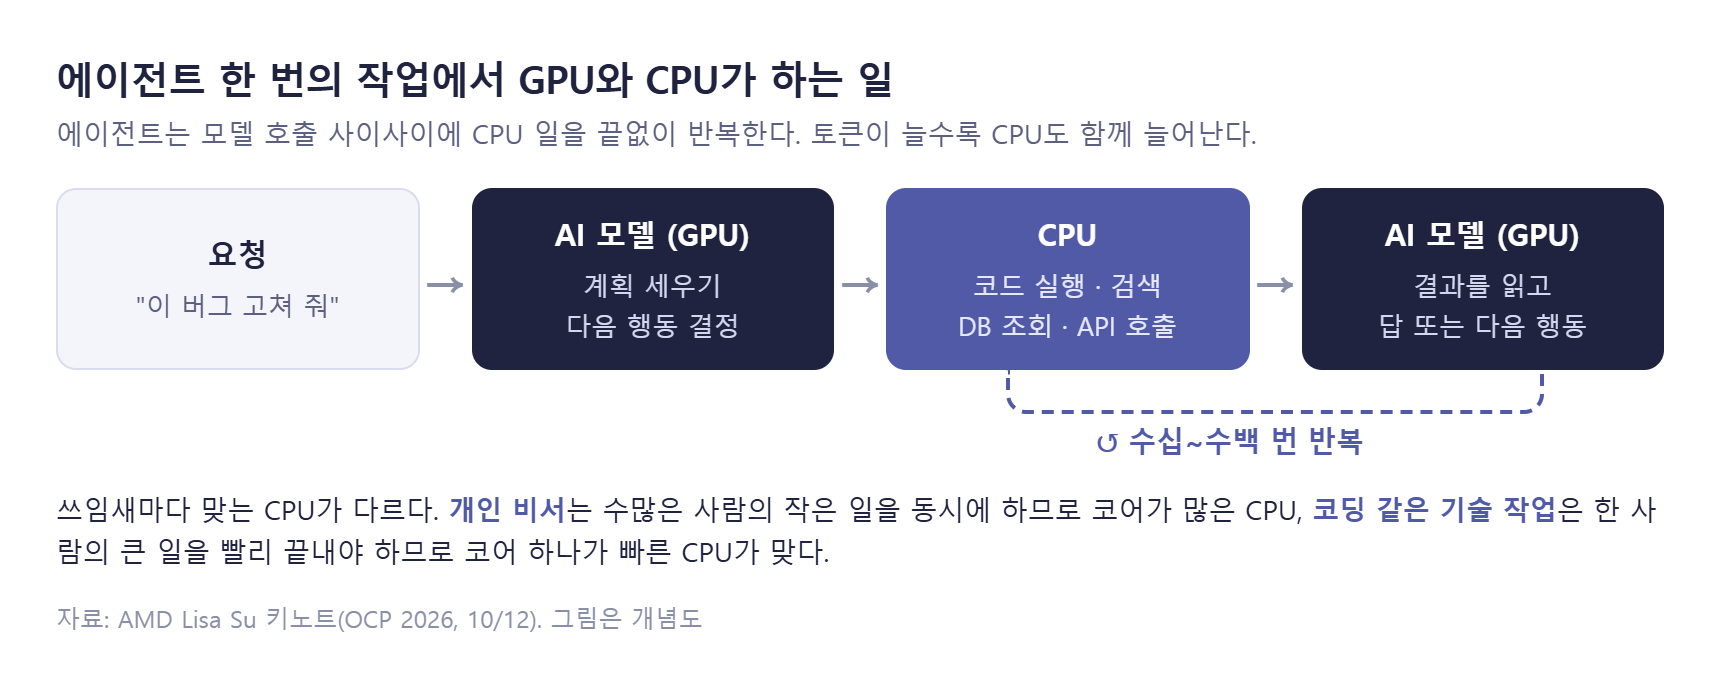
그림 2. 에이전트 한 번의 작업에서 GPU와 CPU가 하는 일
그래서 AMD는 데이터센터 CPU 시장 전망을 9개월 새 세 번 올려, 2025년 약 $26B에서 2030년 약 $220B(연 50% 이상)로 잡았다. 1년 전만 해도 "약 $20B, 한 자릿수 성장"으로 보던 시장이다. AI 가속기 시장은 2030년 약 $1.4T로 봤다(모두 AMD 자체 추정). 현재는 Nvidia에 밀리고 있지만, 빠른 추격에 나서고 있다.
AMD Helion - 에이전트를 위한 CPU 랙
키노트 당일(10/12) AMD는 에이전트가 도구를 돌리는 CPU "샌드박스"를 랙 단위로 묶은 Helion을 공개했다. 하이퍼스케일러에게는 GPU 랙 옆에 둘 CPU 전용 랙을, 기업에게는 CPU·GPU·범용 서버를 한 랙에 담은 올인원 랙을 11월부터 파트너(Cisco·Dell· Foxconn·HPE·Lenovo·QCT·Supermicro·Wiwynn)를 통해 공급하고, 설계는 OCP에 공개한다.
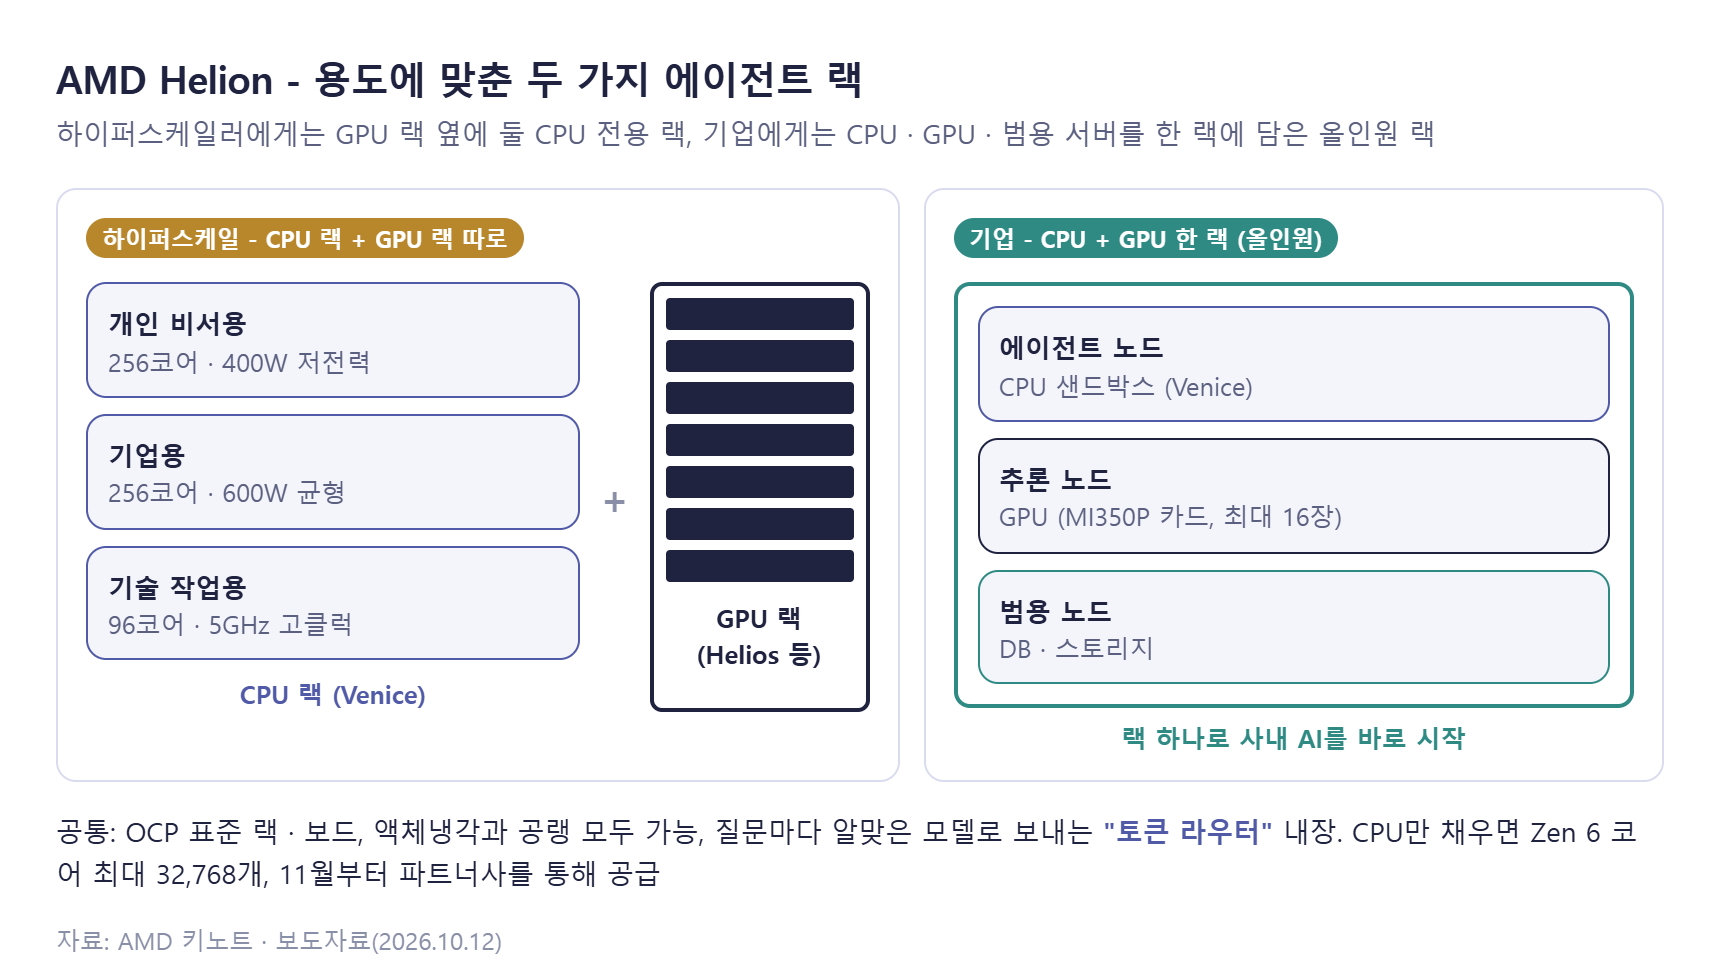
그림 3. Helion 두 가지 구성 - 하이퍼스케일용 CPU 랙과 기업용 올인원 랙
- 에이전트 종류마다 다른 CPU: 개인 비서 에이전트는 256코어를 400W에 촘촘히(전력당 에이전트 수가 핵심), 기업 에이전트는 256코어 600W, 어려운 계산은 96코어 5GHz 고클럭으로 나눴다.
- 랙 하나에 Zen 6 코어 최대 32,768개: AMD는 "경쟁 랙보다 약 40% 많다"고 했다. NVIDIA Vera CPU 랙(약 2만 2,500코어)의 약 1.45배다[8].
- GPU 옆 CPU "Verano" 실물 공개: 저전력 메모리(LPDDR)로 시스템 전력을 낮추고 GPU와 가장 빠르게 연결하는 CPU로, 최대 192코어, 2027년 상반기 출시 예정이다.
- Helios(GPU 랙): 9월 양산 출하를 시작해 첫 시스템이 OpenAI·Meta·Microsoft·Oracle·Anthropic에 설치됐고, 내년 상반기까지 생산을 늘린다.
NVIDIA가 3월 Vera CPU 랙을 발표한 데 이어 AMD가 Helion을 내놓으면서, 두 회사의 경쟁은 GPU 랙에서 "에이전트용 CPU 랙"까지 넓어졌다.
Arm - AI 데이터센터 안 CPU의 세 가지 일
Arm은 AI 데이터센터 안 CPU의 일을 세 가지로 나눴다. GPU를 지휘하는 헤드 노드, 사람의 요청을 받는 클라우드 CPU, 에이전트를 돌리는 CPU다. 에이전트는 전용 가상 머신을 쓰는 "잠들지 않는 가상 사용자"라서, 요청이 사람 속도가 아니라 기계 속도로 생긴다는 것이다[7].

그림 4. 하나의 AI 데이터센터, 세 가지 CPU 일
설계만 팔던 Arm은 3월 첫 자체 칩 AGI CPU(136코어)를 공개하고 Meta·OpenAI·리벨리온·SK텔레콤 등을 고객으로 확보했다. 10/12에는 Fujitsu·Meta·OpenAI와 협력한 백서 "How to Define CPU and Software Stack Performance for Agentic AI"를 내고, 세 가지 CPU의 성능을 각각 다른 기준으로 재자고 OCP에 제안했다. 지금의 CPU 점수(SPEC 등)는 "계산을 얼마나 빨리 하나"만 잰다. 에이전트용 기준(가상 머신을 몇 개 돌리나, 얼마나 잘 격리하나)을 Arm 진영이 먼저 정하면, 구매자가 CPU를 고르는 잣대 자체가 바뀐다. Arm은 2030년 데이터센터 전력 수요 전망도 1년 새 160GW에서 220GW로 약 38% 올렸다.
에이전트 CPU를 놓고 맞붙는 네 진영
진영 · 칩 명령어 · 칩당 코어 랙 하나 코어 수 강점 · 약점 Arm AGI CPU Arm · 136 공랭 8,160, 액체냉각(200kW) 4만 5천 이상 랙당 성능 x86의 2배 주장, 고객사 확보 · 고객인 클라우드와 경쟁 우려 AMD Venice
(Helion)x86 · 최대 256 최대 32,768 기존 x86 소프트웨어 그대로 · NVIDIA와 클라우드 자체 칩 사이에 끼인 위치 NVIDIA Vera Arm · 88 약 2만 2,500 (액체냉각) CPU 전용 랙도 판매(Meta 등) · 칩당 코어는 적음 클라우드 자체 칩 Arm · Graviton 등 - 자기 서비스에 가장 최적화 · 외부에 범용으로 쓰이긴 어려움 숫자는 각 회사 발표 기준이다. TrendForce는 지금 AI 데이터센터의 CPU:GPU 비율이 1:4~1:8인데 에이전트 작업에서는 1:1~1:2로 되돌아간다고 봤다[9]. AMD의 "CPU 시장 약 8.5배" 전망과 같은 방향이다. CPU 랙이 늘면 GPU의 HBM 말고도 CPU 쪽 서버 D램(256코어 CPU는 16채널), 저전력 메모리 모듈(SOCAMM), 기판 수요가 추가로 커진다.
4. 광통신 - "꽂을까, 붙일까"와 레이저 병목
광 연결은 전기 신호를 빛으로 바꾸는 "광엔진"을 칩에서 얼마나 가까이 두느냐로 나뉜다. 가까울수록 전기가 덜 새서 전력은 줄지만, 고장 났을 때 그 부품만 빼서 바꾸기는 어려워진다.
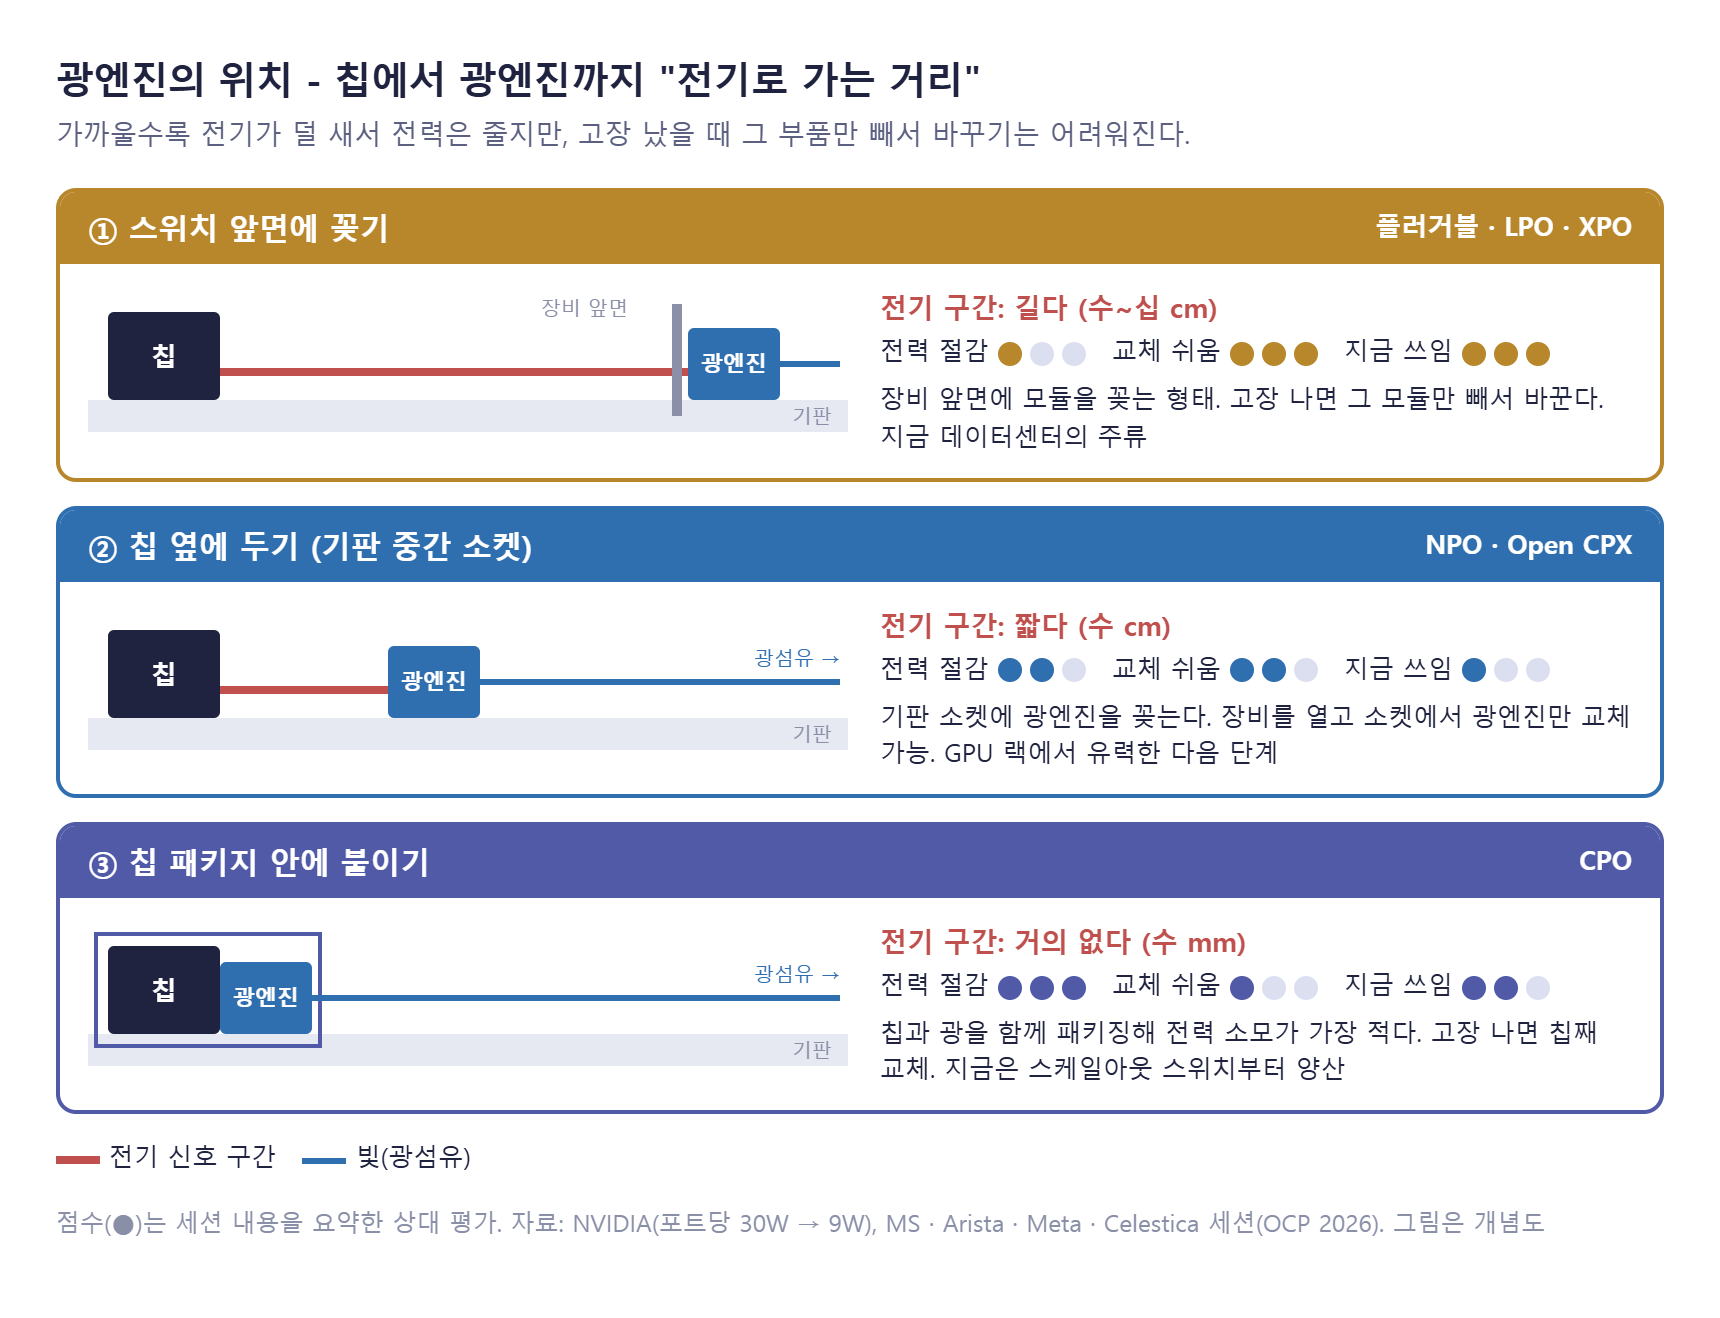
그림 5. 광엔진의 위치 - 칩에서 광엔진까지 "전기로 가는 거리"가 다르다
각 기업들마다 선호하는 방식, 주장하는 기술 트렌드의 방향은 조금씩 달랐다. 특히, 최종적으로는 CPO로 간다는 것에는 큰 이견이 없는 듯 했으나, 시점에 따라서는 조금씩 차이가 있었다.
- 스위치(스케일아웃): CPO가 시작됐다. 아직 깔린 스위치 대부분은 꽂는 모듈이지만, NVIDIA Spectrum-X·Quantum-X와 Broadcom 3세대가 CPO이고, Meta는 102.4T CPO 스위치를 공개했다. 스위치는 포트가 수백 개라 전력 절감 효과가 가장 크고(포트당 30W → 9W, NVIDIA)[12], GPU보다 교체 부담이 작다.
- GPU 트레이(스케일업): 지금은 AMD Helios·NVIDIA Vera Rubin 모두 랙 안이 구리다. 다음은 CPO보다 XPO·NPO가 먼저라는 의견이 많았다. MS·Arista는 GPU 트레이를 칩이 나오기 2~4년 전에 설계하는데, CPO는 그때 광 부품·공급사를 정해야 하고 표준도 덜 됐다고 설명했다. 꽂는 방식은 트레이를 먼저 만들고 광은 나중에 골라 끼우며, 고장 나면 모듈만 바꾸면 된다. 그래서 "추론용은 1~2세대는 XPO로 충분"하다는 것이다[11].
- 랙 사이 GPU 연결: 지금은 플러거블·LPO 모듈이고, 다음은 OCI다. OCI는 Broadcom이 Meta·MS·OpenAI·AMD·NVIDIA와 만든 랙 사이 광 규격으로, 구리(DAC)와 같은 전력(7pJ/bit)으로 500m까지 간다. 지금 랙 안에서만 구리로 묶는 GPU 72개를 2028년에는 여러 랙·열의 GPU 1,000개 이상까지 광으로 묶자는 것이다[14].
꽂는 모듈의 세 갈래 - DSP, LPO, XPO
기존 광모듈은 흐트러진 신호를 디지털로 다듬는 칩(DSP)이 들어 있어 전력과 열이 크다. LPO는 DSP를 빼서 전력을 줄이고, XPO는 플러거블의 새 표준 폼팩터로 더 크고 액체냉각이 되는 슬롯이라 안에 LPO든 DSP형이든 골라 꽂는다.
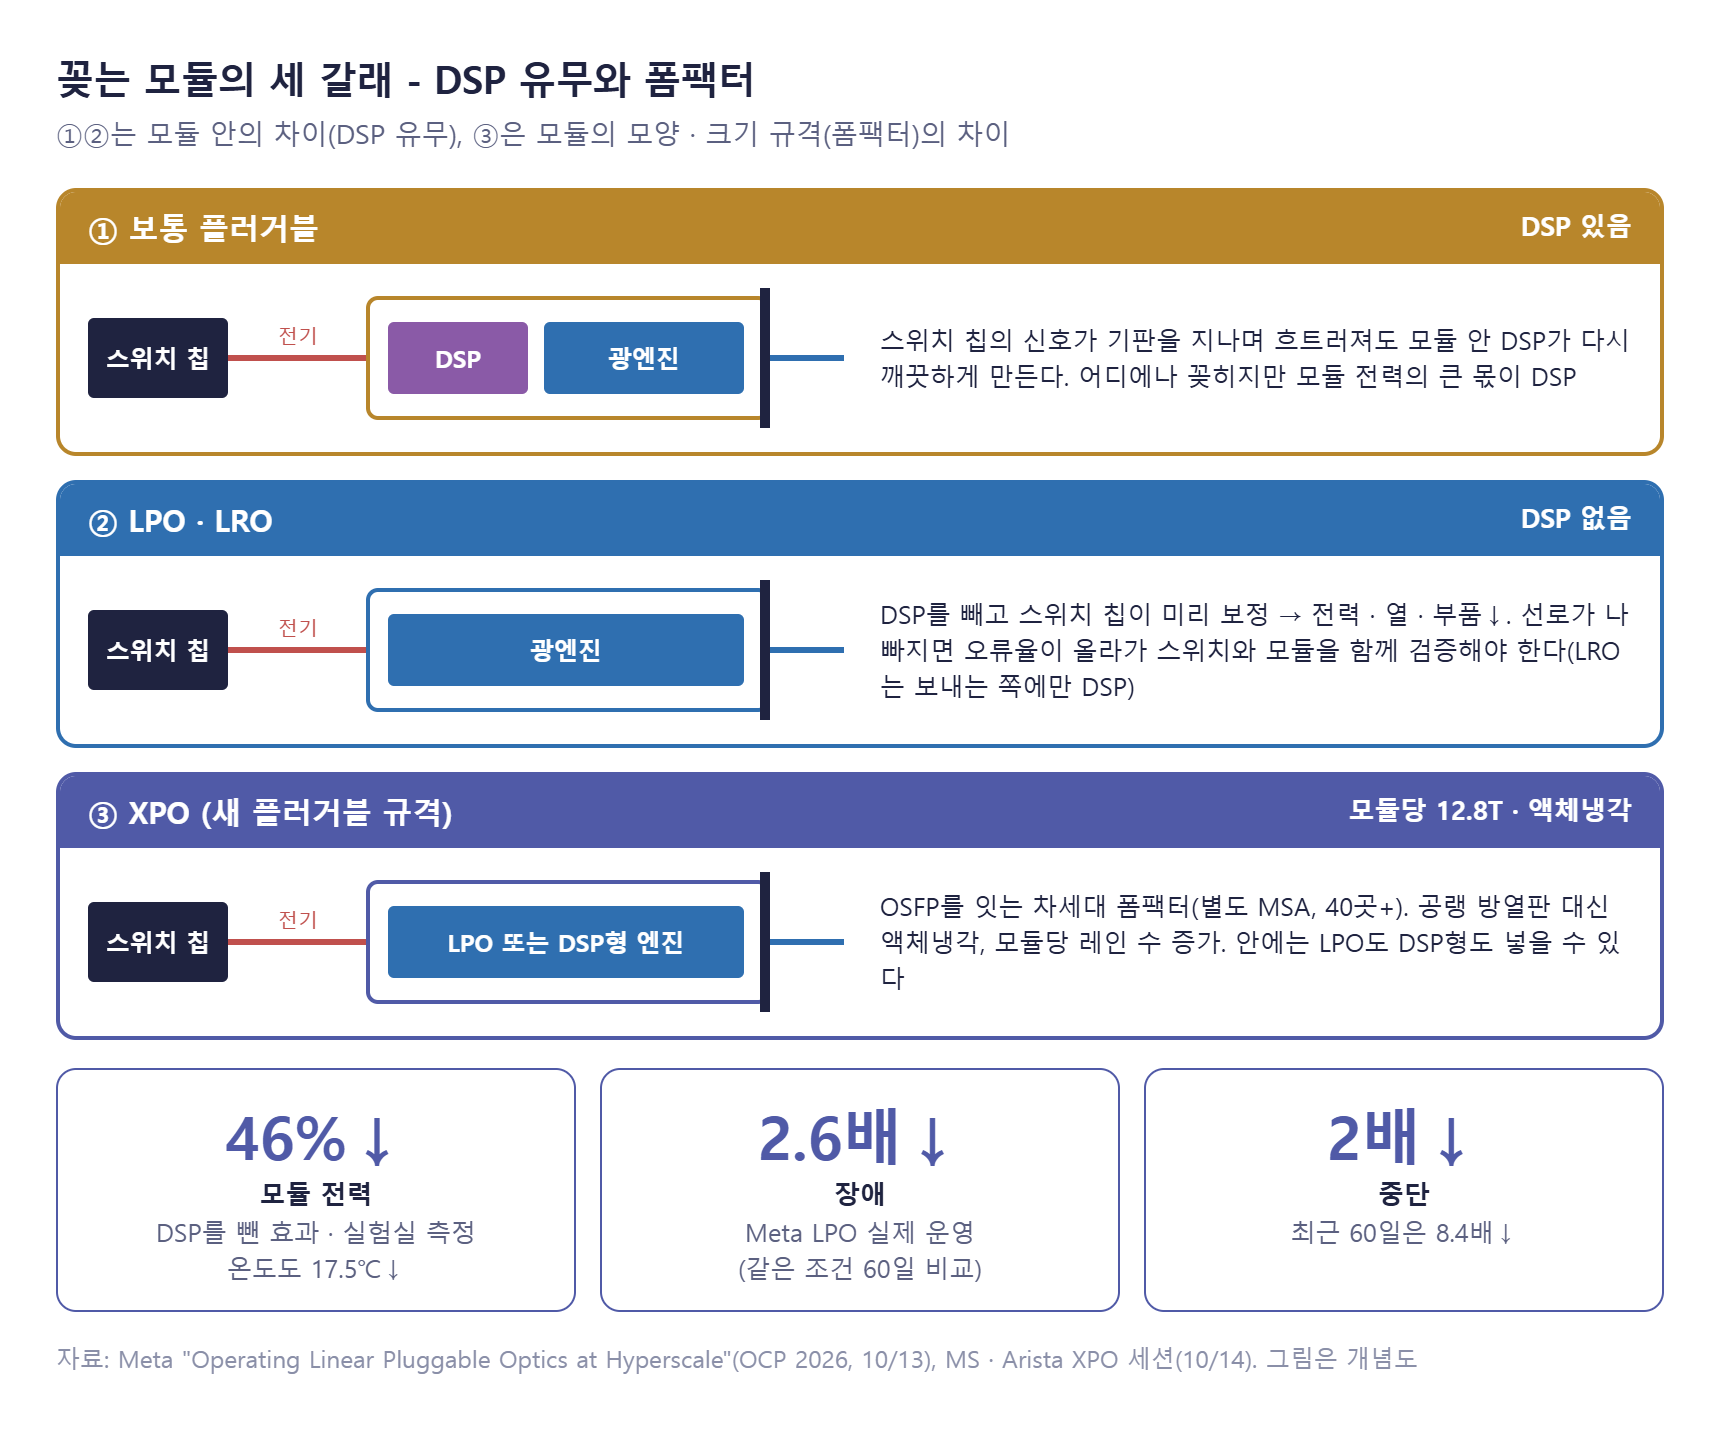
그림 6. 꽂는 모듈의 세 갈래 - DSP 유무와 폼팩터
Meta의 LPO 운영 데이터가 흥미로웠다[10]. DSP를 빼자 실험실 측정에서 모듈 전력은 46% 줄고 온도는 17.5℃ 내려갔다. 실제 운영에서는 장애가 2.6배, 중단은 2배 적었다(최근 60일은 8.4배). DSP는 모듈 안에서 가장 뜨겁고 복잡한 칩이라, 이걸 빼니 고장 날 부품이 하나 줄고 고장 유형 하나가 통째로 사라졌다는 설명이다. 다만 모듈 한 개만 놓고 보면 둘은 비슷하고, 이득은 스위치와 모듈을 같은 조건으로 맞춰 비교한 "구조적" 결과다. 대신 LPO는 선로가 나빠지면 오류율이 올라가므로 스위치와 모듈을 함께 검증해야 한다.
XPO vs CPO - 하나가 이기는 게 아니라 자리마다 다르다
구분 OSFP (현재 플러거블) XPO (차세대 플러거블) NPO (Open CPX) CPO 광엔진 위치 앞면 모듈 앞면 모듈 (OSFP 8개분 대역폭) 칩 옆 소켓 칩 패키지 안 용량 모듈 1.6T 모듈 12.8T, 1OU 스위치 204.8T 엔진 단위 스위치 1대에 엔진 16개 전력 가장 높음 중간 (LPO로 쓰면↓) 낮음 가장 낮음 (포트당 30W → 9W) 고장 나면 모듈만 교체 모듈만 교체 엔진만 교체 (소켓) 칩·트레이까지 교체 공통 규격 있음 XPO MSA (2026.3, 40곳+) Open CPX (MSA 2026.3, 규격 2026.9) 회사별 (OIF 공통 틀 일부) 양산 지금 주력 2027 목표 개발 중 스위치 양산 시작 채택 흐름을 시간순으로 보면 이렇다[11][13][14][15].
- 2024: Broadcom 51.2T CPO 스위치 소량 출하
- 2025.10: Broadcom 102.4T CPO 출하 발표 - 광 전력 70%↓
- 2026.3: NVIDIA가 레이저 2사(Lumentum·Coherent)에 각 $2B 투자, Arista XPO MSA 결성, GPU 간 광 규격 OCI MSA(AMD·Broadcom·Meta·MS·NVIDIA·OpenAI) 결성, Open CPX MSA(Marvell·Ciena 등) 결성
- 2026.8: NVIDIA 이더넷 CPO 스위치 본격 양산
- 2026.10 OCP: Meta 102.4T CPO 스위치 공개, MS는 GPU 쪽에 XPO 시험, Astera "2~3년은 NPO, CPO는 차세대 칩부터", Lumentum 앞면 교체형 외부 레이저, Celestica CPO 스위치 2027 양산
정리하면 "스위치는 CPO 양산 시작, GPU 옆은 XPO·NPO가 먼저, CPO가 최종 목적지"다. 하이퍼스케일러는 운영이 편한 XPO·NPO를 단기 목표로 보고, CPO 개발은 Broadcom·NVIDIA 같은 협력사와 진행하고 있다. 칩 옆·패키지 광 포트는 2025년 100만 개 미만에서 2030년 연 1억 개 이상으로 늘 전망이다(LightCounting)[13].
구리 vs 광 - 랙 안은 아직 구리
구리는 싸고 전력이 적게 들지만 속도가 오를수록 닿는 거리가 짧아지고, 광은 멀리 가지만 비싸고 전력을 더 쓴다. 랙 안과 이웃 랙(~4m)은 구리, 그 너머는 광이라는 데는 대체로 동의했고, 전환 속도에서만 기업마다 생각이 갈렸다[16].
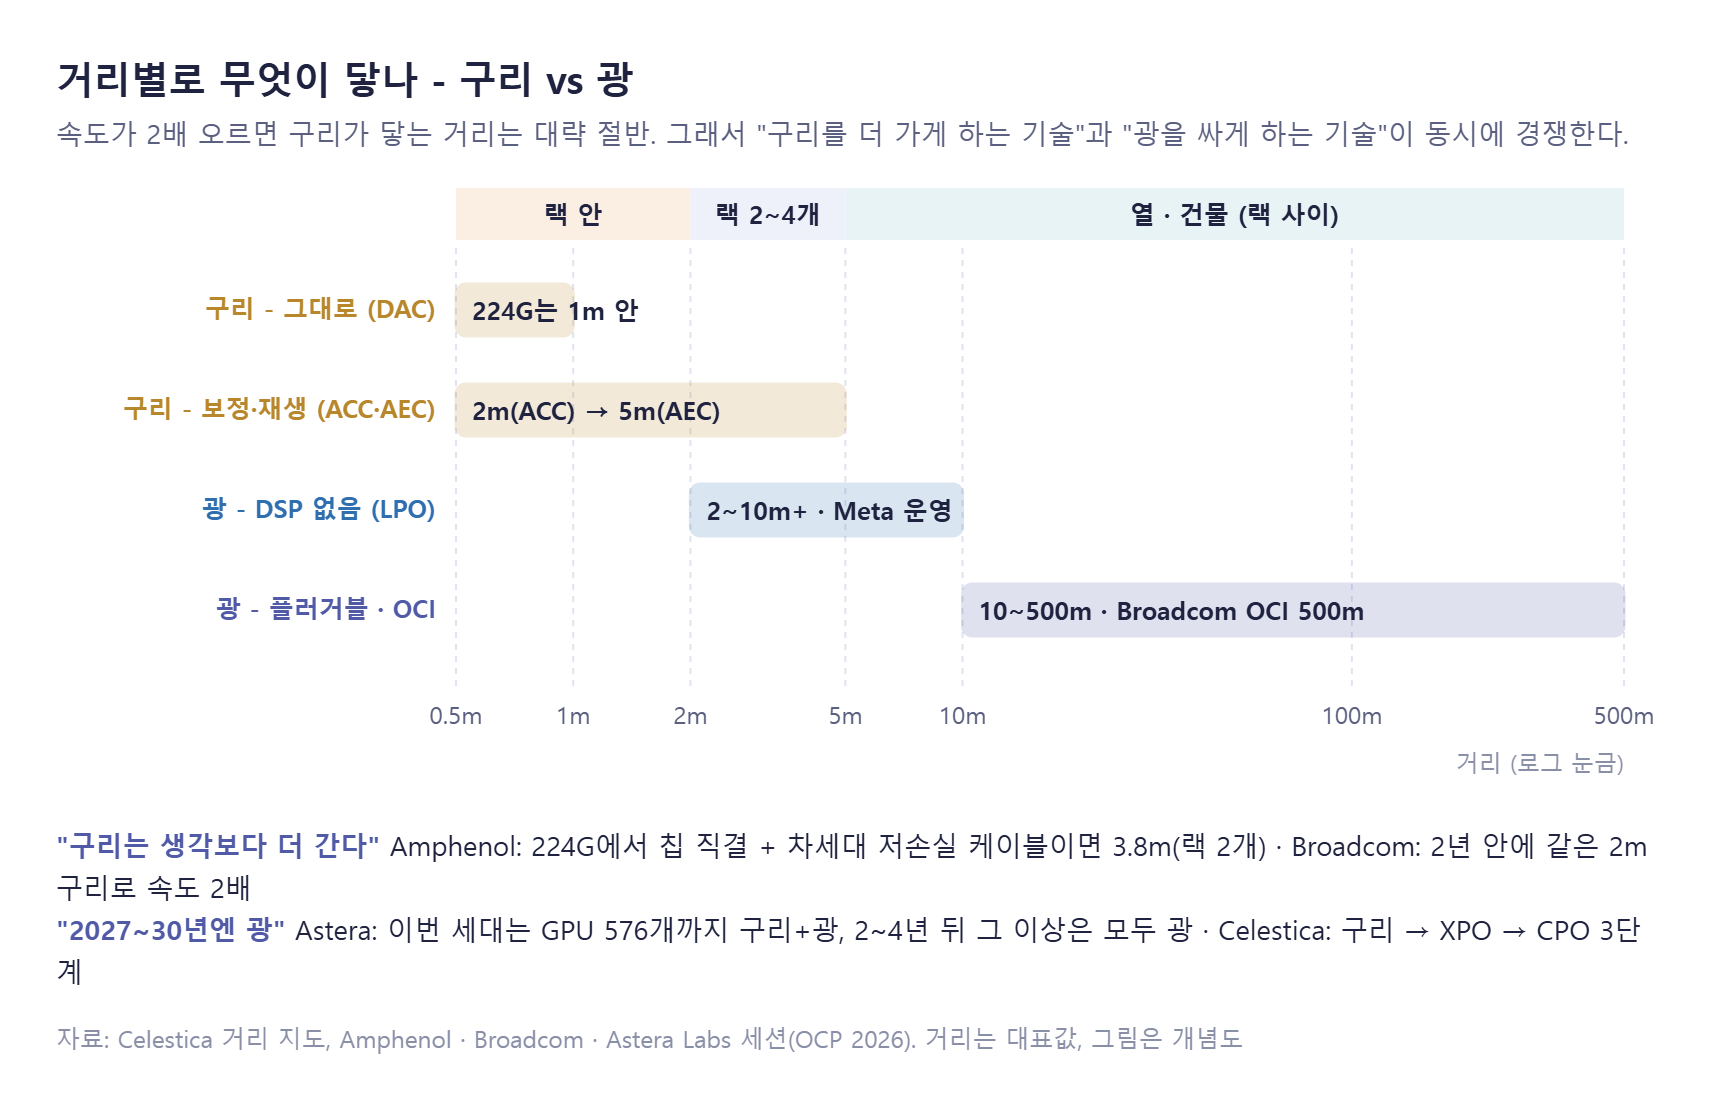
그림 7. 거리별로 무엇이 닿나 - 속도가 2배 오르면 구리가 닿는 거리는 대략 절반
- "구리는 생각보다 더 간다": Amphenol은 지금 속도(224G)에서 칩 직결 + 차세대 저손실 케이블이면 3.8m(랙 2개)까지 구리로 간다고 했다. Broadcom은 2년 안에 새 신호 방식으로 같은 2m 구리에서 속도를 2배 올릴 수 있다고 했다.
- "2027~30년엔 광": AMD는 Helios가 전부 구리지만 "전기 선으로 묶는 마지막 세대 중 하나"라고 했다. Astera는 이번 세대는 구리+광으로 GPU 576개까지, 2~4년 뒤 그 이상은 모두 광이라고 봤고, Celestica는 구리 → 꽂는 광(XPO) → 붙이는 광(CPO) 3단계로 간다고 했다.
지금은 2~5m(랙 몇 개)를 리타이머가 든 구리 케이블(AEC)로 잇는 것이 일반적이다. 다만 모델이 커져 스케일업의 단위가 랙을 넘어가면 스케일업에도 광이 들어올 가능성이 있다.
빛은 누가 만드나 - 레이저 병목
광 연결에서 빛을 만드는 부품은 레이저(InP 반도체)이고, 실리콘 광 칩(PIC)은 그 빛에 데이터를 싣기만 한다. 광이 늘수록 레이저 공급이 병목이 되고, 뜨거운 칩 옆에서는 레이저 수명이 줄어든다. 그래서 앞면에 꽂는 외부 레이저 모듈(ELSFP)이 CPO의 기본 구성이 되고 있다[15].
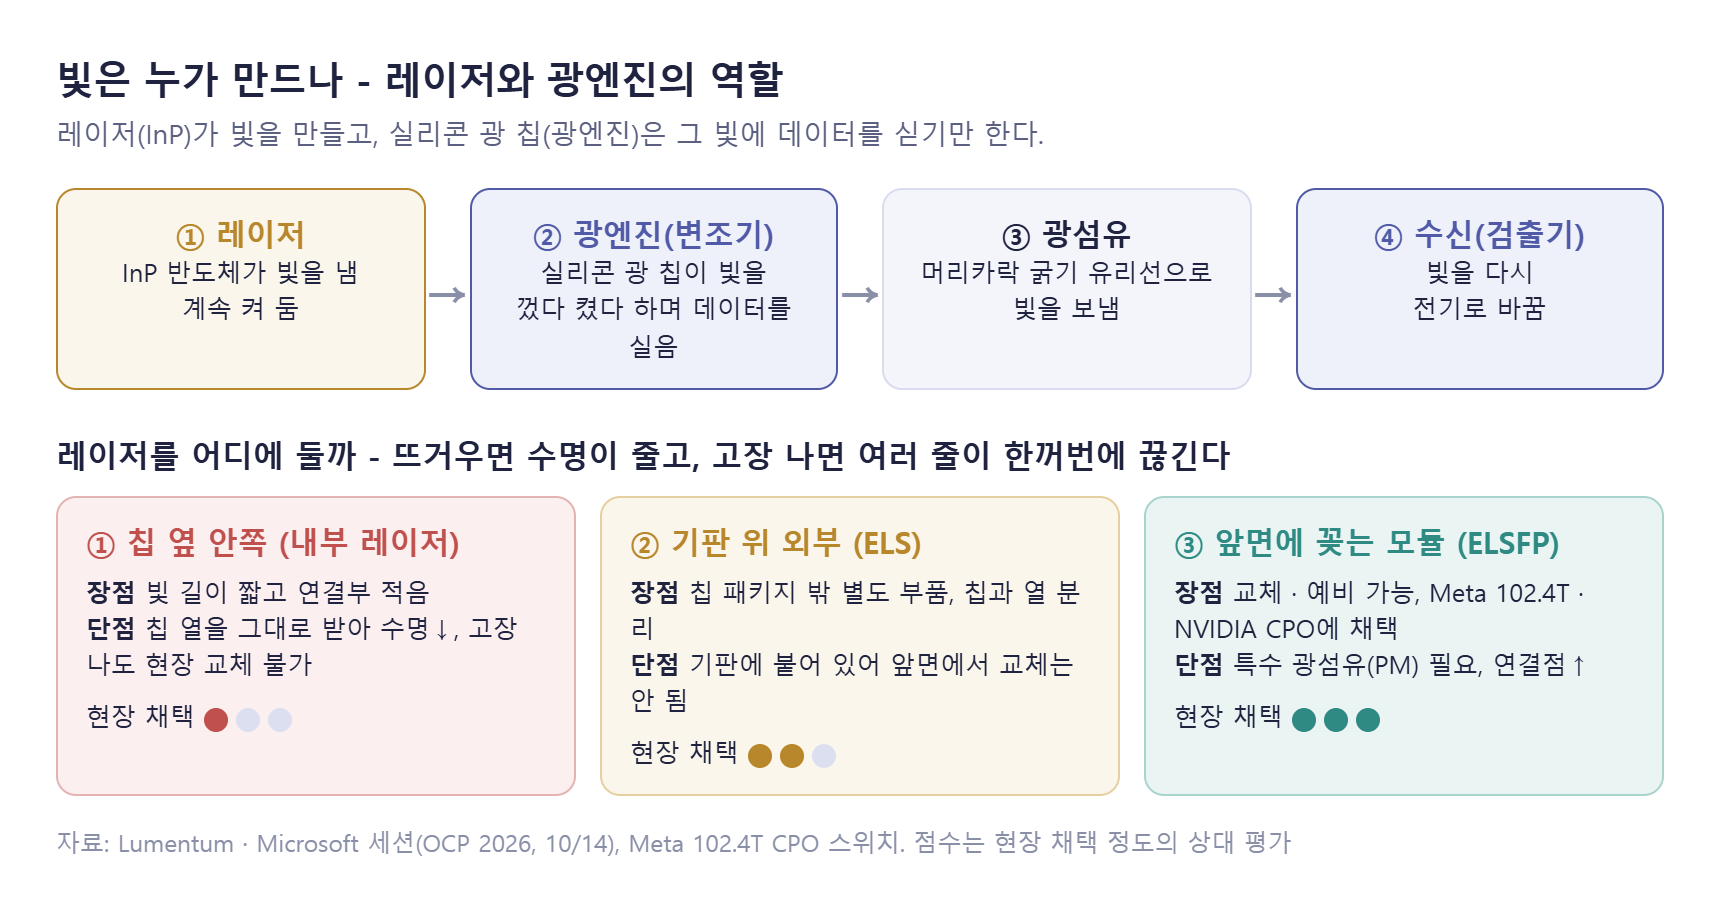
그림 8. 빛이 데이터가 되는 길과 레이저를 두는 세 자리
- 공급은 소수: InP 레이저는 Lumentum·Coherent 등 소수가 만든다. NVIDIA가 3월 두 회사에 각 $2B를 투자한 이유다.
- 수요는 배로: "느리고 넓게" 방식(OCI 1세대)은 파장 4개를 쓰므로 레이저 수가 늘고, 요구 사양도 높다(50℃에서 350mW, 효율 20%).
- CPO에서 바꿀 수 있는 것과 없는 것: 앞면 레이저 모듈과 광섬유 연결부는 바꿀 수 있지만, 칩 패키지 안의 광엔진(변조기·검출기)은 고장 나면 칩째 바꿔야 한다(MS).
"빠르고 좁게" vs "느리고 넓게"
전송 속도를 올리는 방법은 줄마다 속도를 계속 올리거나(4줄 × 400G), 느린 줄을 아주 많이 묶는 것이다(400줄 × 4G). 앞쪽은 공급이 부족한 InP 레이저가 필요하고, 뒤쪽은 값싼 LED·VCSEL(InP 불필요)이나 다파장 레이저로 간다.
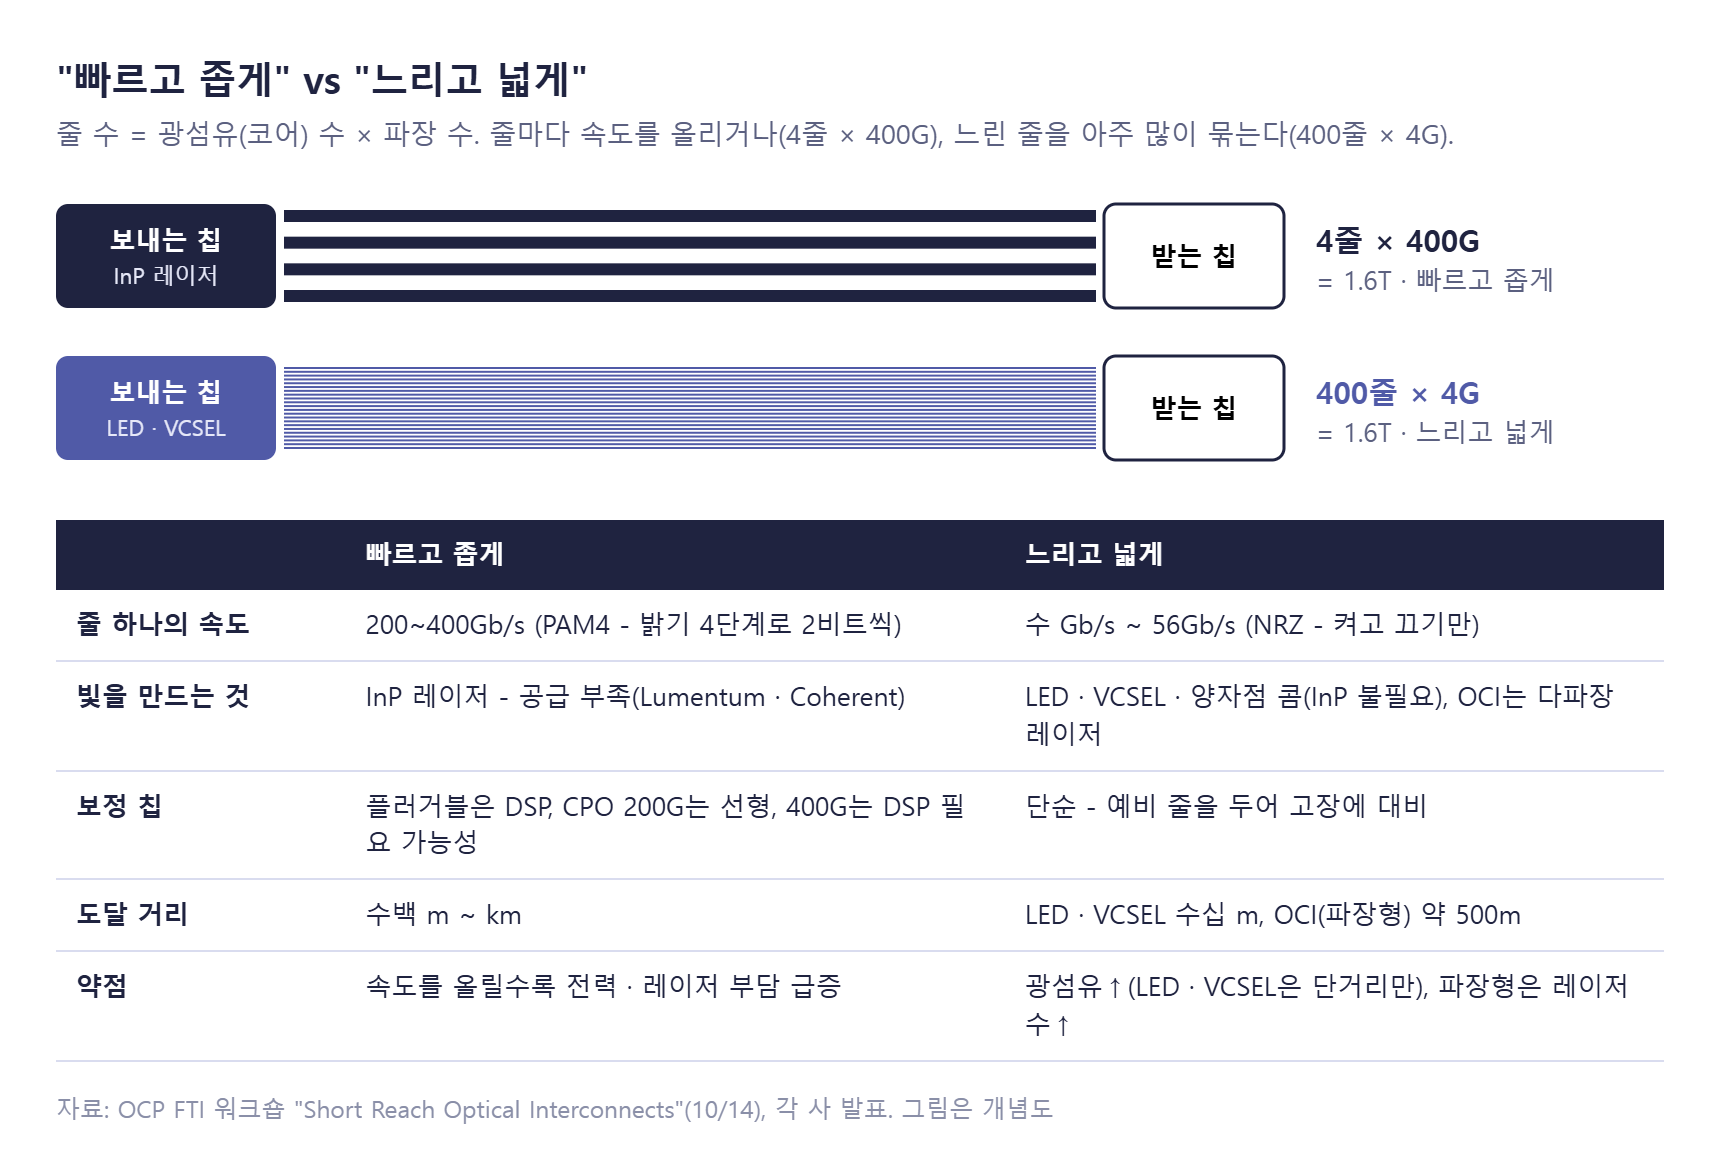
그림 9. 빠르고 좁게 vs 느리고 넓게
"느리고 넓게" 쪽은 스타트업이 주도하고 있었다[17].
- Avicena: 마이크로LED 한 줄 최대 4Gb/s(송신 80fJ/bit), 3Gb/s × 335줄로 1Tbps를 내는 평가키트 출하(2026.8)
- LightXcelerate: 마이크로VCSEL + 19코어 광섬유, 광섬유 1개당 608Gb/s
- Quintessent: 칩 하나에서 8파장을 내는 양자점 콤 레이저, Series A $40M(2026.8)
- 파장형(OCI·Ayar Labs·Lightmatter): 한 가닥에 여러 색, 색당 32~56G(OCI 1세대는 50G × 4파장)
LED·VCSEL·양자점은 InP 공급망을 피해 가는 길이다. 다만 MS(MOSAIC)·MediaTek도 마이크로LED 광케이블을 2027년 말 상용화 목표로 개발하고 있어[18], 대형사가 관심을 가지는 것은 긍정적이지만 대형사가 주도하면 스타트업의 몫이 줄어들 수도 있다.
5. 네트워크 - 랙 안은 "하나처럼", 랙 사이는 "여러 길로"
<스케일업과 스케일아웃>
AI 데이터센터의 네트워크는 둘로 나눠 봐야 한다. 스케일업은 랙 안 GPU 수십 개를 빠른 선으로 묶어 한 GPU처럼 쓰는 것이고(자주, 빠르게 - 예: 한 층의 연산을 여러 GPU가 나누는 텐서 병렬, 전문가 병렬), 스케일아웃은 랙 여러 개가 메시지(패킷)를 주고받는 것이다(빈도는 적지만 크기가 큼 - 예: 데이터·파이프라인 병렬, 추론의 KV 캐시 전달).
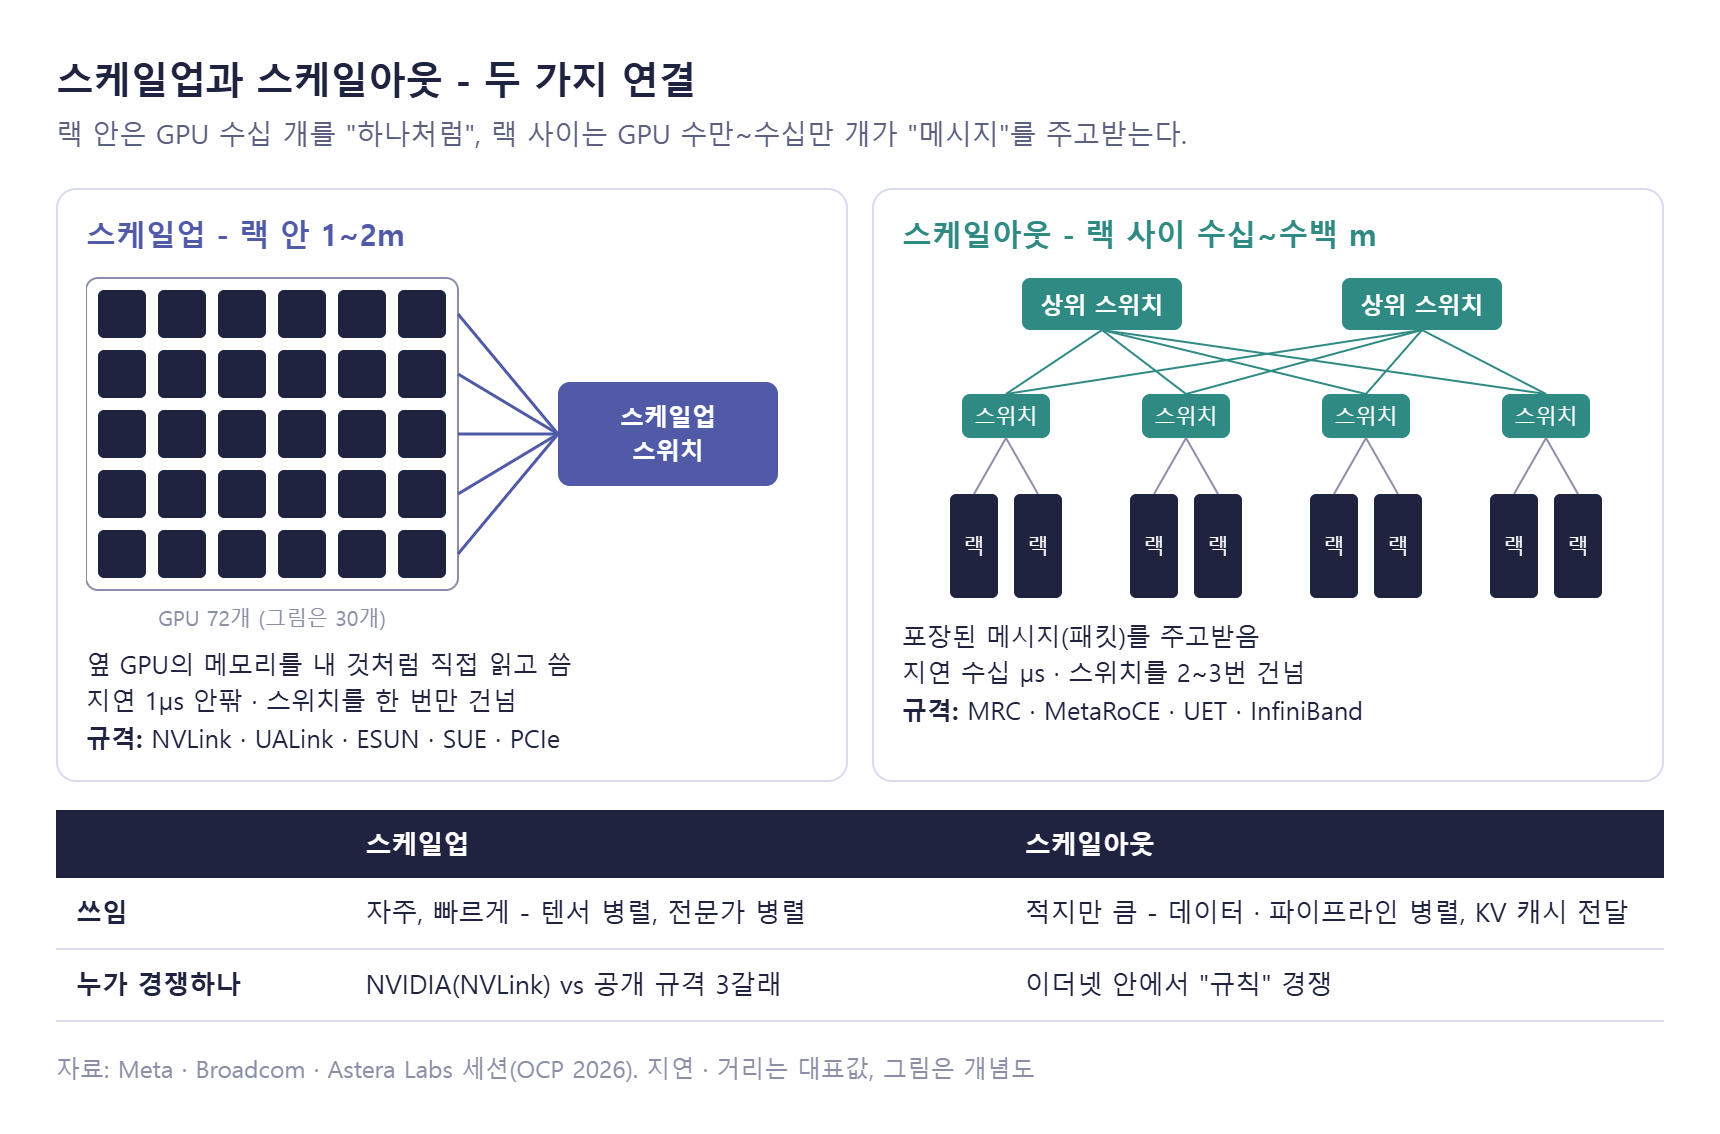
그림 10. 스케일업과 스케일아웃
<스케일업 규격 - NVLink 혼자였던 자리에 공개 규격이 들어오다>
랙 안 GPU를 하나처럼 묶는 규격은 오랫동안 NVIDIA 전용 NVLink뿐이었다. 공개 진영은 AMD 주도의 GPU 전용 새 규격(UALink), 이더넷을 다듬는 규격(SUE·ESUN), 기존 PCIe의 세 갈래이고, 올해 처음 랙 단위 제품이 나왔다[21].

그림 11. 스케일업 규격 4갈래의 흐름 - 누가 만들었고, 언제 제품이 나왔나
- 올해 달라진 것: 공개 규격이 스위치 칩에서 랙 제품으로 넓어졌다. AMD Helios(9월 출하), Meta Tahan(운영 중), Astera Orion(설계 공개, 랙은 2027)이다.
- 이더넷으로 모이는 중: 올해 나온 공개 진영 제품은 PCIe(Astera)를 빼면 모두 이더넷 스위치 위에서 돌아간다. 이더넷 기반 ESUN 1.0(2026.3)에는 175곳 이상이 참여한다.
NVLink 랙은 스위치 칩·규칙을 NVIDIA가 쥔다. 공개 규격 랙은 스위치 칩·케이블·커넥터·연결 칩을 따로 고를 수 있어 부품 회사의 자리가 생긴다. 부품 회사가 어느 규격 작업에 들어가 있는지가 다음 발주의 신호다.
<스케일아웃 - 이더넷 위에서 "여러 길" 규칙으로>
랙 사이(스케일아웃)는 이더넷 기반의 새 규격이 InfiniBand를 밀어내는 흐름이 굳어졌다. 학습은 GPU 수만 개가 발을 맞추므로 가장 느린 한 길이 전체 속도를 정한다. 그래서 패킷을 한 길로만 보내던 옛 규칙(RoCE) 대신, 여러 길로 흩어 보내는 새 규칙(MRC·MetaRoCE·UET)으로 옮겨 가고 있다.
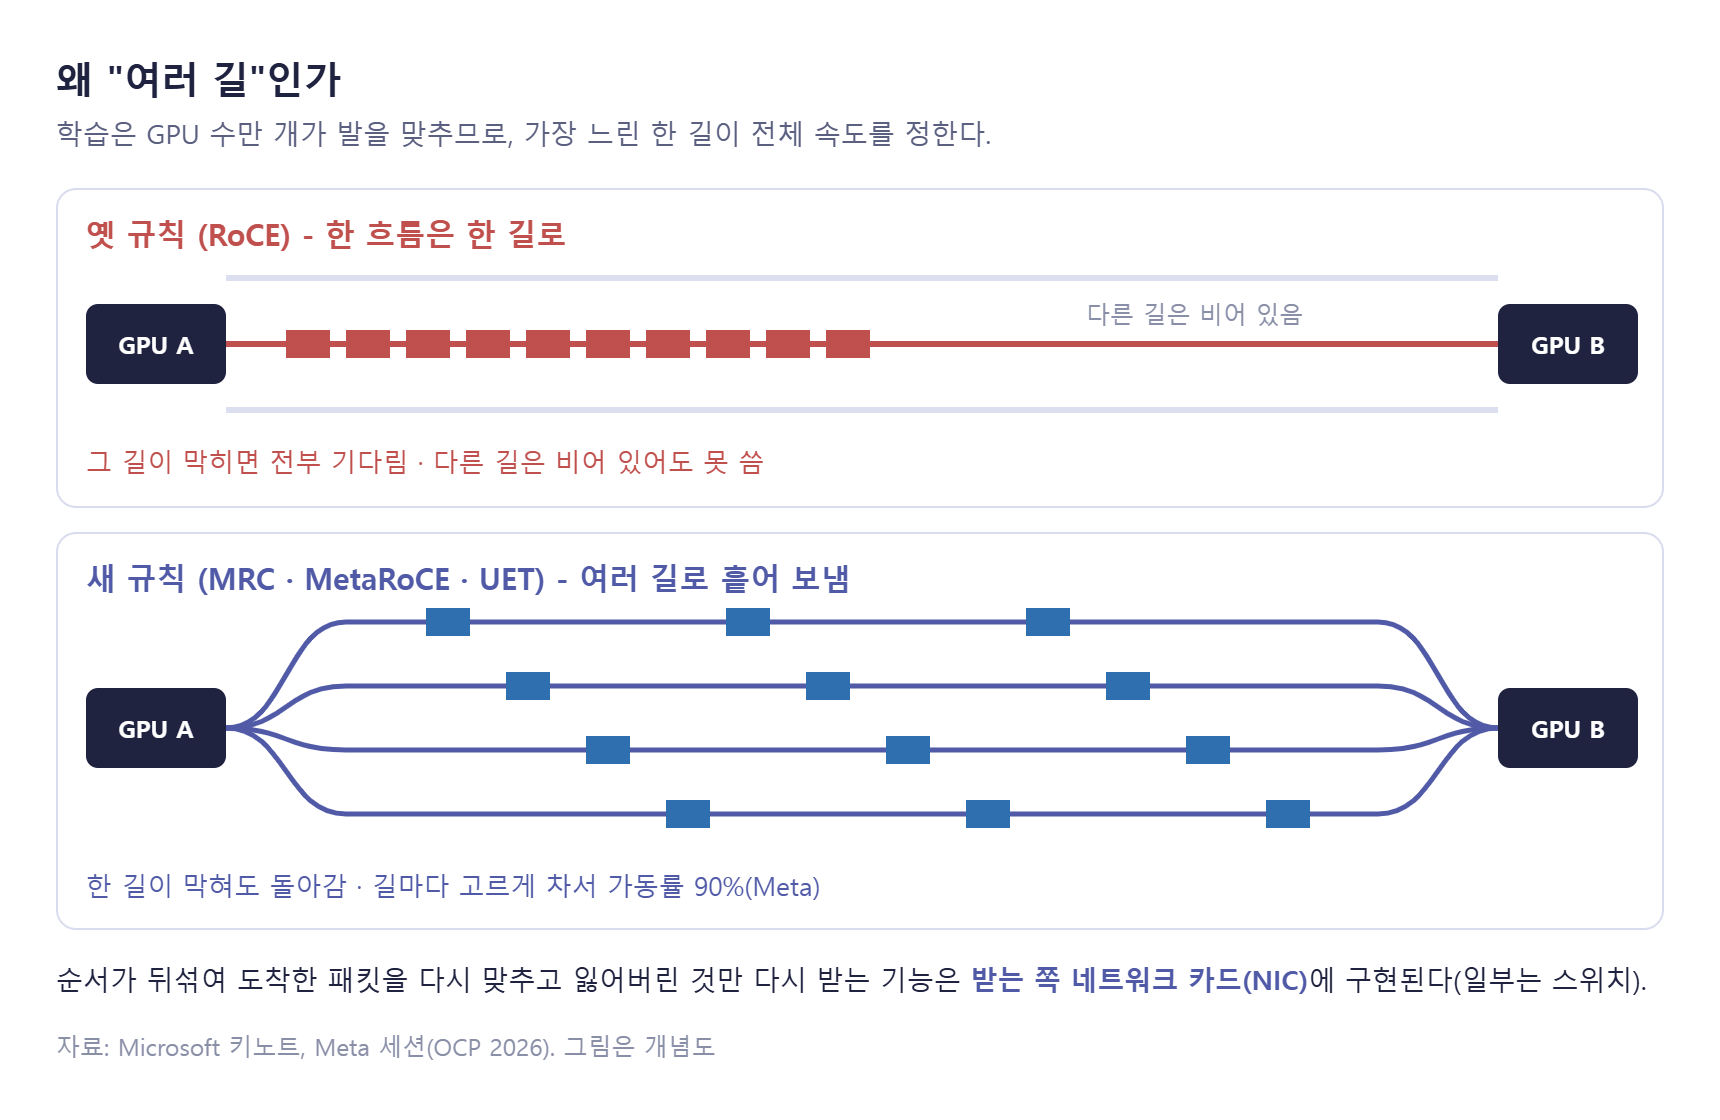
그림 12. 왜 "여러 길"인가 - 한 길이 막혀도 돌아가고, 길마다 고르게 차서 가동률 90%
- OpenAI·Microsoft - MRC: 망을 8겹(평면)으로 나누고 데이터를 여러 길로 흩어 보내, 스위치 2단만으로 GPU 10만 개를 묶는다. OpenAI 주도로 AMD·Broadcom·Intel·MS·NVIDIA와 개발했고, AMD·Broadcom·NVIDIA NIC에 구현됐다[1][19].
- Meta - MetaRoCE: 패킷을 여러 경로로 뿌리는 전송 방식으로 가동률 90%를 냈고, AMD Pensando 프로그래머블 NIC에서 구현한다[20].
- UET - 업계 공통 규칙: AMD·Broadcom·Meta·MS 등 컨소시엄의 AI용 이더넷 규칙(2025년 1.0)이다. MRC·MetaRoCE가 회사별 구현이라면 UET는 공통 규격이고, Meta는 1.1에 기여하고 있다.
순서가 뒤섞여 도착한 패킷을 다시 맞추고 잃어버린 것만 골라 다시 받는 기능은 받는 쪽 네트워크 카드(NIC)에 구현된다. 결국 모든 NIC가 새 규칙을 지원하게 될 것이고, 차이는 하이퍼스케일러 인증에 먼저 드는 시점과 대규모 혼잡·고장 때의 실제 성능에서 남는다.
6. 800V·SST - 전력은 "바꾸기"보다 "끄기"와 "인증"이 어렵다
랙 전력이 커지면 전류도 커져 구리선이 너무 많이 필요하다. 800V 직류는 같은 전력을 더 작은 전류로 보내(P=VI) 구리를 줄인다. 전기는 전력망에서 칩까지 오면서 전압과 교류·직류를 여러 번 바꾸는데, 바꿀 때마다 장비·공간·손실이 든다. NVIDIA는 이 변환을 7단계에서 4단계로 줄이는 것을 목표로, 기존 건물과 새 건물에 다른 배치 방식을 내놓았다[22].
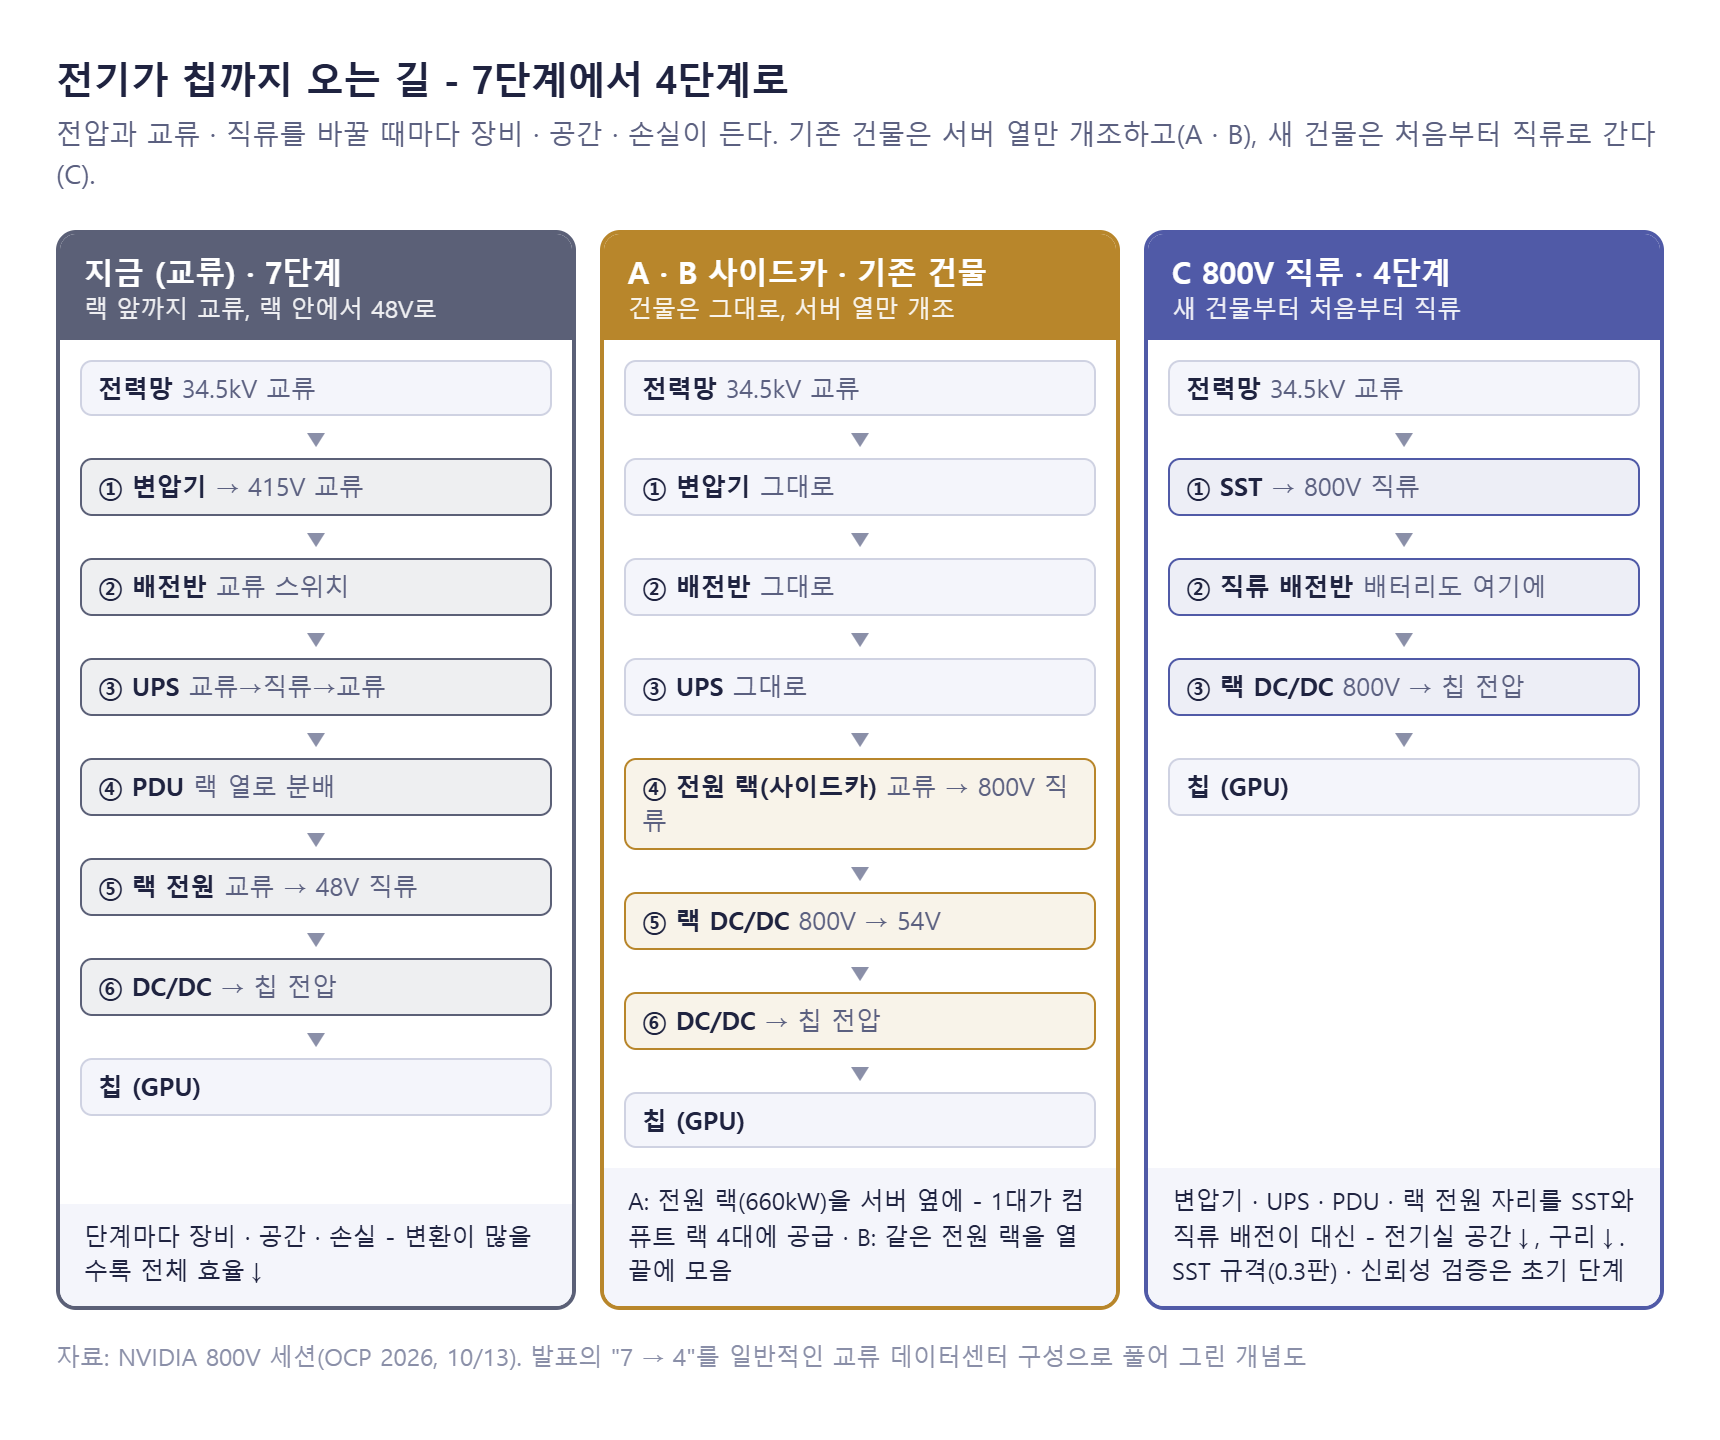
그림 13. 전기가 칩까지 오는 길 - 지금(교류) · 기존 건물 개조(A · B) · 새 건물(C)
- A. 사이드카: 교류를 800V 직류로 바꾸는 전원 랙(660kW)을 컴퓨트 랙 바로 옆에 끼운다. 전원 랙 1대가 컴퓨트 랙 4대에 직류를 준다. 건물의 변압기·UPS 등 교류 설비는 그대로 두고 서버 열만 개조하므로 기존 건물에 바로 적용할 수 있지만, 열마다 전원 랙이 서버 자리를 차지한다.
- B. 파워 센터: A와 같은 전원 랙을 열 맨 끝 한곳에 모아 열 전체에 800V를 나눠 준다. 열 안에는 컴퓨트 랙만 남아 기존 서버 배치를 유지할 수 있다. A와 B는 같은 제품이고 놓는 자리만 다르다.
- C. SST: 34.5kV 중압을 SST(반도체 변압기)가 바로 800V 직류로 바꿔, 전력망에서 랙까지 처음부터 직류로 보낸다. 공간·손실 절감이 가장 크지만 새 건물에만 가능하고, SST 규격(0.3판)과 신뢰성 검증은 아직 초기 단계다.
<SST 규격 - 상자 안은 업체 자유, 경계의 숫자만 하나로>
SST는 반도체 스위치로 중압 교류를 바로 800V 직류로 바꾸는 5~10MW급 전원 상자다. Google·MS·NVIDIA는 상자 안 설계는 업체에 맡기고, 전력망·랙·배터리와 만나는 경계의 숫자만 하나로 맞췄다(OCP SST 규격 0.3판)[23].
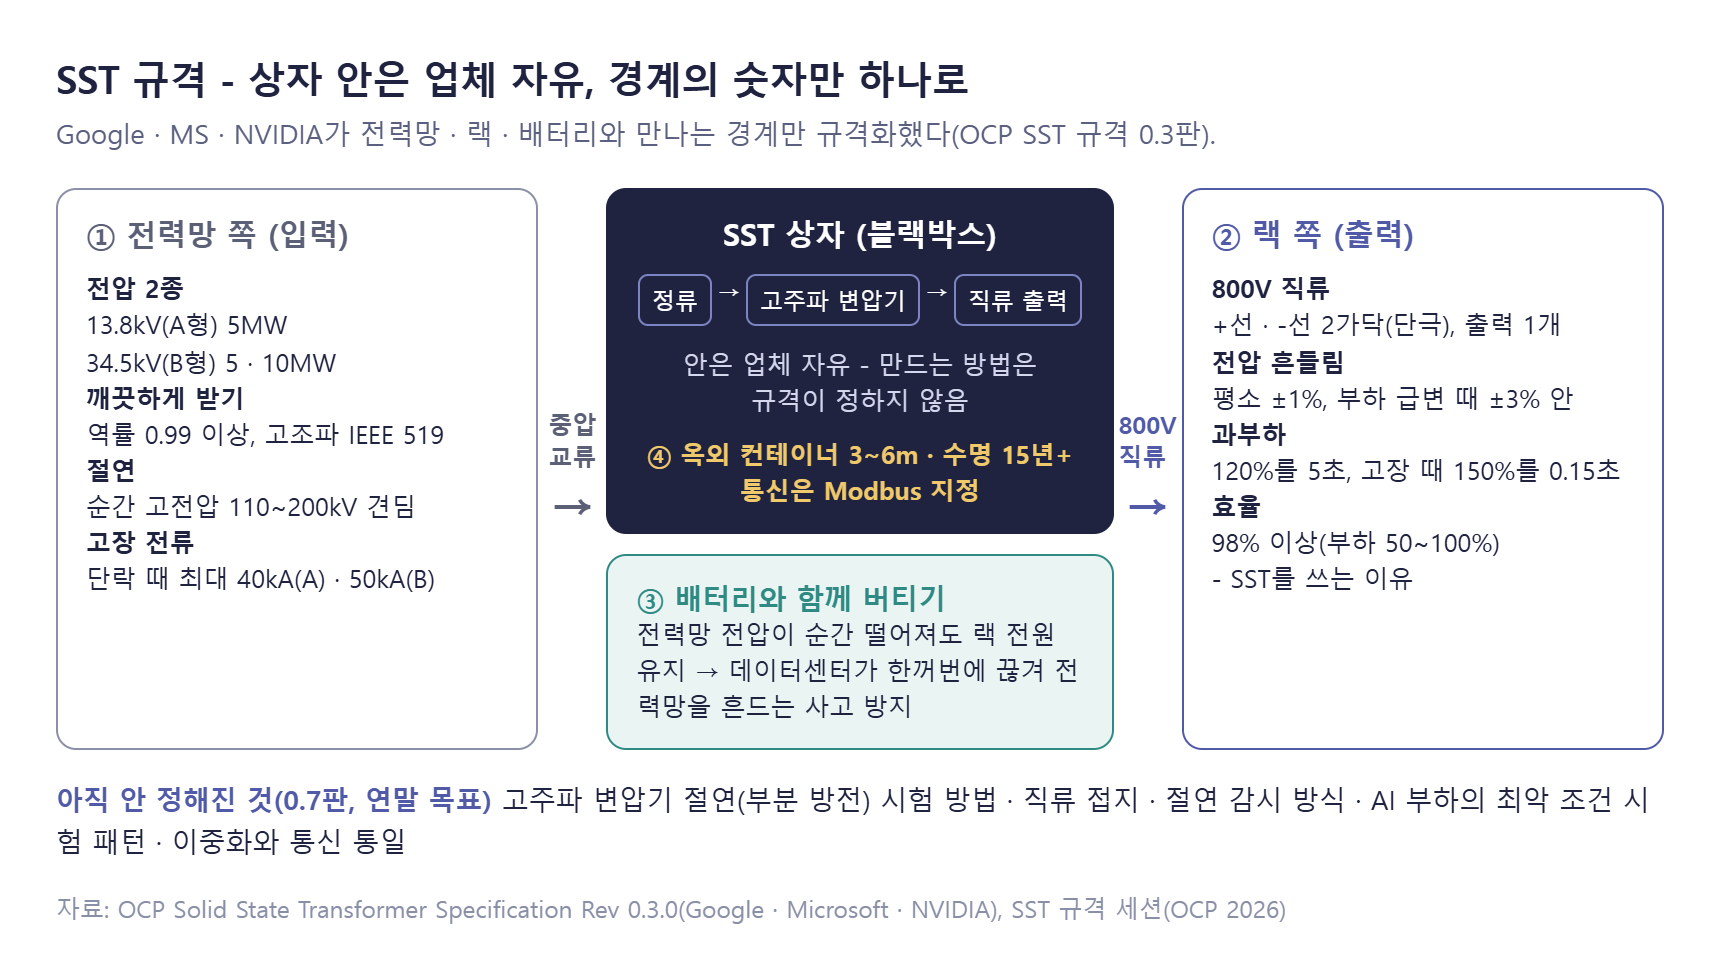
그림 14. 규격은 SST를 "블랙박스"로 본다 - 입력과 출력만 규격화
- 입력: 13.8kV(A형) 5MW, 34.5kV(B형) 5·10MW. 역률 0.99 이상, 고조파 기준(IEEE 519) 준수, 번개 같은 순간 고전압(110~200kV)과 전력망 단락 때 최대 40kA(A형)·50kA(B형)를 견뎌야 한다.
- 출력: 800V 직류 +선·-선 2가닥(단극). 전압 흔들림은 평소 ±1%, 부하 급변 때 ±3% 안. 효율은 98% 이상(부하 50~100%)으로, 이것이 SST를 쓰는 이유다.
- 배터리와 함께 버티기: 전력망 전압이 순간 떨어져도 랙 전원을 유지해, 데이터센터가 한꺼번에 끊겨 전력망을 흔드는 사고를 막는다.
SST 회사를 비교할 때는 네 가지를 보면 된다. 34.5kV(B형)는 2세대 고주파 변압기가 필요해 B형을 먼저 내면 한발 앞선 것이고, 반도체(SiC)는 성숙했지만 약점은 고주파 변압기의 절연이며, SST와 배터리를 한 제품(중압 UPS)으로 내는지, 효율 98%·옥외 15년을 현장 운전 이력과 인증(UL·IEEE)으로 보였는지다. 다음 판(0.7판, 연말 목표)에서는 고주파 변압기 절연(부분 방전) 시험 방법, 직류 접지·절연 감시 방식, AI 부하의 최악 조건 시험 패턴, 이중화·통신 통일이 정해진다.
큰 고객 3곳이 같은 숫자를 요구하므로 한 제품으로 세 곳에 납품할 수 있다. 대신 인터페이스가 같기 때문에 차별화는 상자 안(변압기·제어)에서만 가능하다. Heron Power·DG Matrix 같은 스타트업, Resilient Power를 인수한 Eaton, Vertiv, 국내의 효성중공업·LS일렉트릭이 이 자리를 노리고 있고, 규격 적합이 편입 조건이다.
<직류는 "끄기"가 어렵다 - Vertiv와 Infineon>
교류는 전류가 1초에 120번 0을 지나므로, 기계식 차단기가 접점을 떼면 그 순간 불꽃(아크)이 저절로 꺼진다. 직류는 0이 없어 불꽃이 계속 타고, 전력전자 회로라 고장 전류가 μs 안에 치솟아 기계식으로는 늦다. Vertiv는 반도체 차단기(SSCB)로 40μs 안에 강제로 끊고, 남은 에너지는 클램프 소자가 흡수하며, 감지·차단·흡수·격리를 함께 설계하는 "고장 관리기"를 제안했다. "보호는 장치가 아니라 시스템의 기능"이라는 것이다[24].
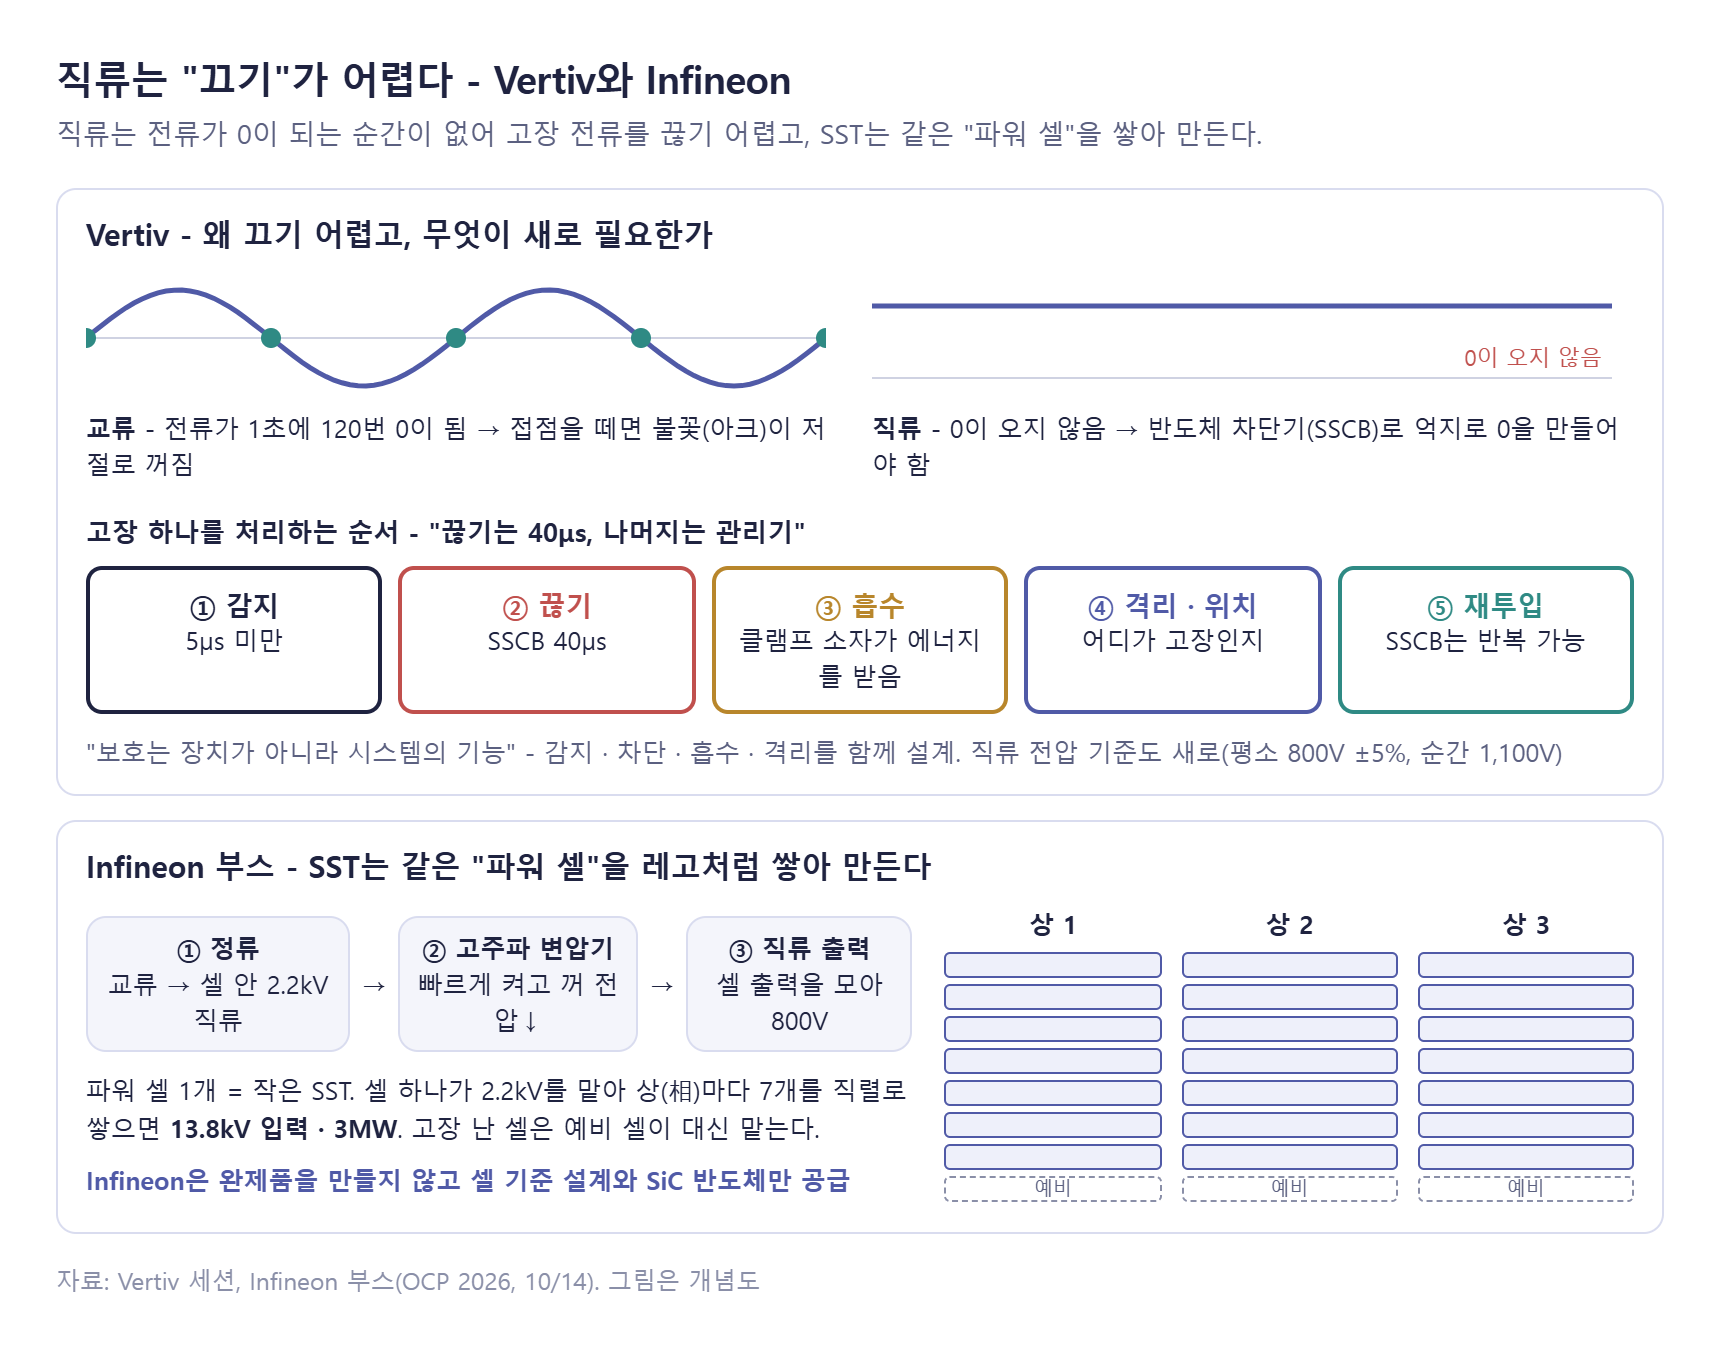
그림 15. Vertiv - 직류 고장 처리 순서 / Infineon 부스 - SST는 "파워 셀"을 레고처럼 쌓아 만든다
Infineon 부스에서는 SST의 속을 볼 수 있었다. 파워 셀 1개가 작은 SST이고, 셀 하나가 2.2kV를 맡아 상(相)마다 7개를 직렬로 쌓으면 13.8kV 입력·3MW가 된다. 고장 난 셀은 예비 셀이 대신 맡는다. 눈에 띈 것은 Infineon이 SST 완제품을 만들지 않고 파워 셀의 기준 설계와 SiC 반도체만 판다는 점이다. 스타트업 몫으로 보였던 자리에 대기업이 이미 부품 공급자로 들어와 있는 셈이다.
여기서 세 가지가 보인다. 첫째, 교류용 차단기로는 직류를 못 끊으므로 반도체 차단기·고장 감지 센서·에너지 흡수 소자가 새 시장이 된다. 둘째, SST 1대(13.8kV·3MW)에 같은 셀이 약 20개 들어가므로 SiC 반도체·고주파 변압기·커패시터 수요가 셀 수만큼 곱해진다. 셋째, 셀이 표준 부품이 되면 SST 조립 회사의 마진은 얇아질 수 있다. 스타트업은 셀을 직접 설계하는지가 핵심이다.
<전력망 유연성 - 1년에 하루치만 줄여도>
NVIDIA는 세션에서 Duke대 연구를 인용하며 AI 데이터센터의 수요반응이 필요하다고 주장했다[25]. 전력망은 1년 중 가장 덥거나 추운 날 몇 시간의 최대 수요에 맞춰 지어져 있어서 나머지 시간에는 설비가 남는다. 새 데이터센터가 그 몇 시간에만 사용을 줄이기로 약속하면 새 발전소·송전망 없이 남는 설비를 쓸 수 있다는 것이다.
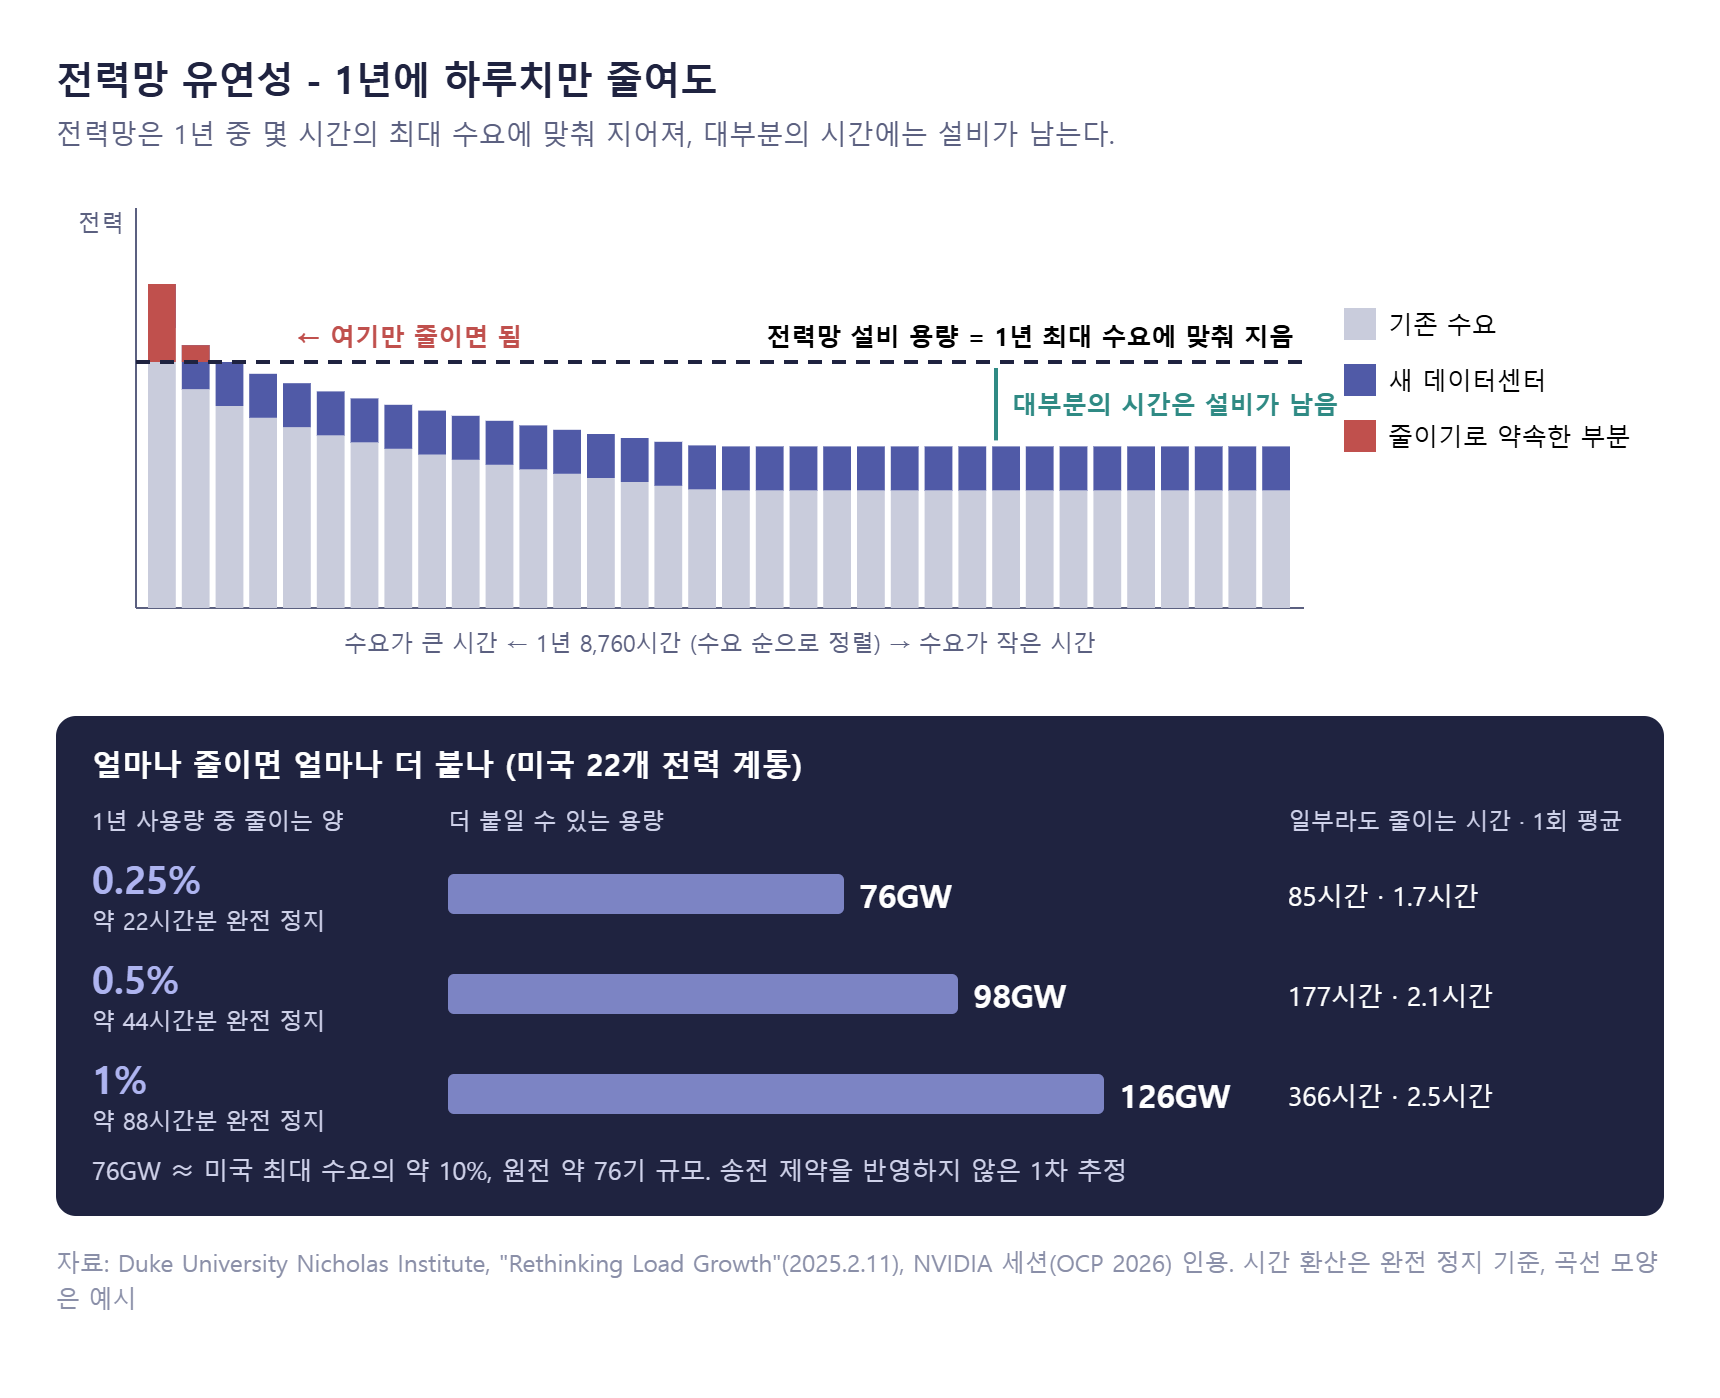
그림 16. 1년 8,760시간을 수요 순으로 세우면 - 줄이는 양별로 더 붙일 수 있는 용량
1년 사용량의 0.25%(약 하루치)만 줄여도 미국 전력망에 76GW를 더 붙일 수 있다는 계산이다. 미국 최대 수요의 약 10%, 원전 약 76기 규모다. 다만 주의할 점이 있다. 송전선 여유를 따지지 않은 미국 전체 합산의 1차 추정이라 특정 부지에서 바로 쓸 수 있는 용량은 아니다. 또 0.5%만 줄여도 연 177시간은 일부를 줄여야 해서 고객과 약속한 가동률(SLA)과 충돌할 수 있고, NVIDIA도 "SLA를 깨지 않는 범위에서"를 조건으로 뒀다. 그래서 꺼지지 않고 줄이는 수단(급하지 않은 학습 미루기, 배터리·현장 발전으로 대신하기, GPU 전력 상한)이 핵심이다. NVIDIA 입장에서는 GPU 가동률과 무관하게 AI 데이터센터가 많이 생길수록 유리하다는 점도 함께 봐야 한다.
<전력 기술 지도 - 스타트업은 단계별로 나뉜다>
전력망 전기는 수만~수십만 V 교류로 들어오고, GPU 칩은 1V 안팎의 직류를 쓴다. 랙 하나가 수백 kW를 쓰면서 단계마다 새 장비가 필요해졌고, 스타트업도 단계별로 나뉜다[26][27].
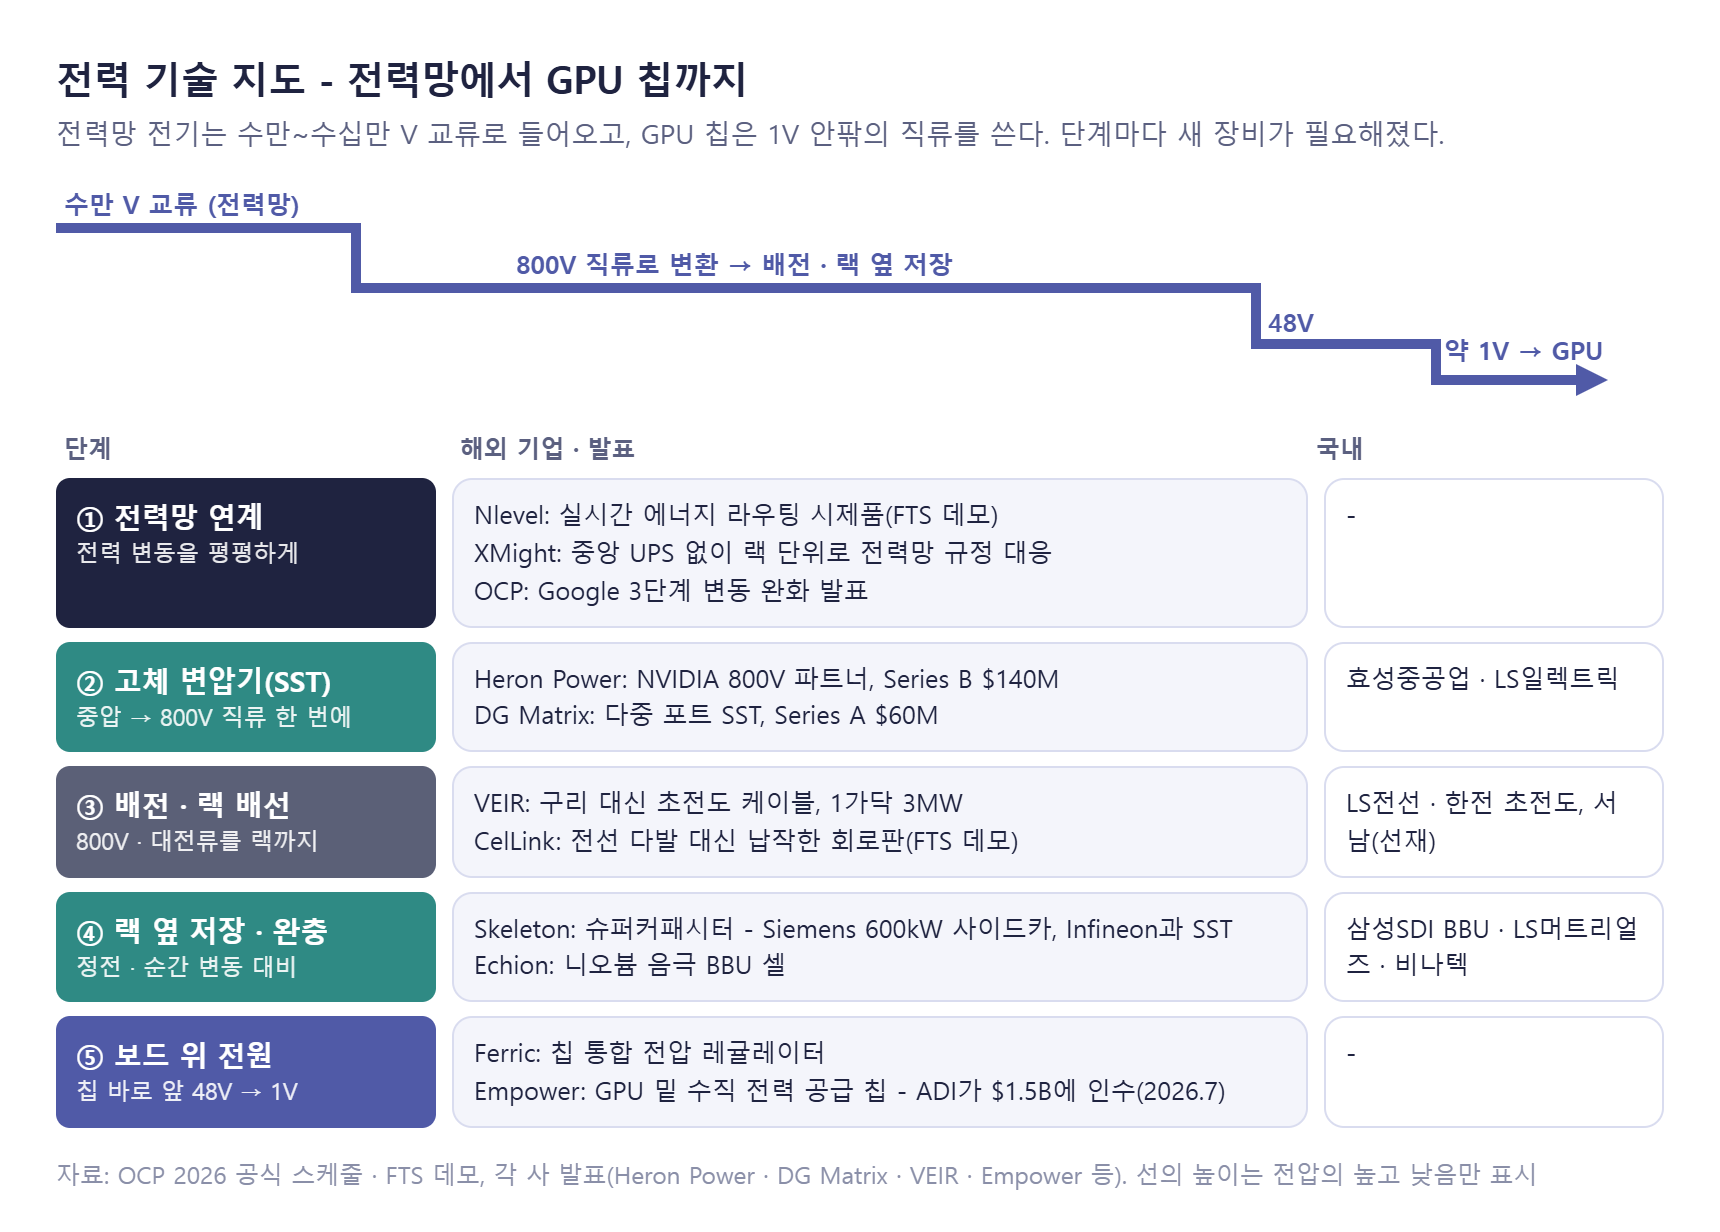
그림 17. 전력 기술 지도 - 전력망에서 GPU 칩까지, 단계별 주요 기업
해외 기업들은 주로 SST와 랙 옆 저장·완충 단계에 몰려 있었다. 앞으로의 방향은 OCP SST 규격 0.3판 → 정식판, 800V 사이드카 2026년 하반기 → 랙 직접 800V다. 규격이 공개되면(협력사 80곳 이상) 경쟁 축은 제조 원가·UL 인증·납기로 옮겨 간다. 기술만 있는 팀보다 양산·인증 경험이 있는 기업이 유리해지는 구간이다.
7. 양자컴퓨터가 데이터센터 안으로
양자컴퓨터는 실험실에서 이제 상용 데이터센터로 들어오기 위한 준비 작업 중이다. 양자컴퓨터는 GPU를 대체하는 것이 아니라 특정 계산(샘플링·최적화·분자 모사)만 맡는 GPU 옆 보조 장치(QPU)로 데이터센터에 들어온다. 실사용은 2029년 무렵부터(IDTechEx)이고, 그때까지 과제는 큐비트 오류 줄이기와 냉각·차폐·저잡음 전원 같은 인프라다[28].
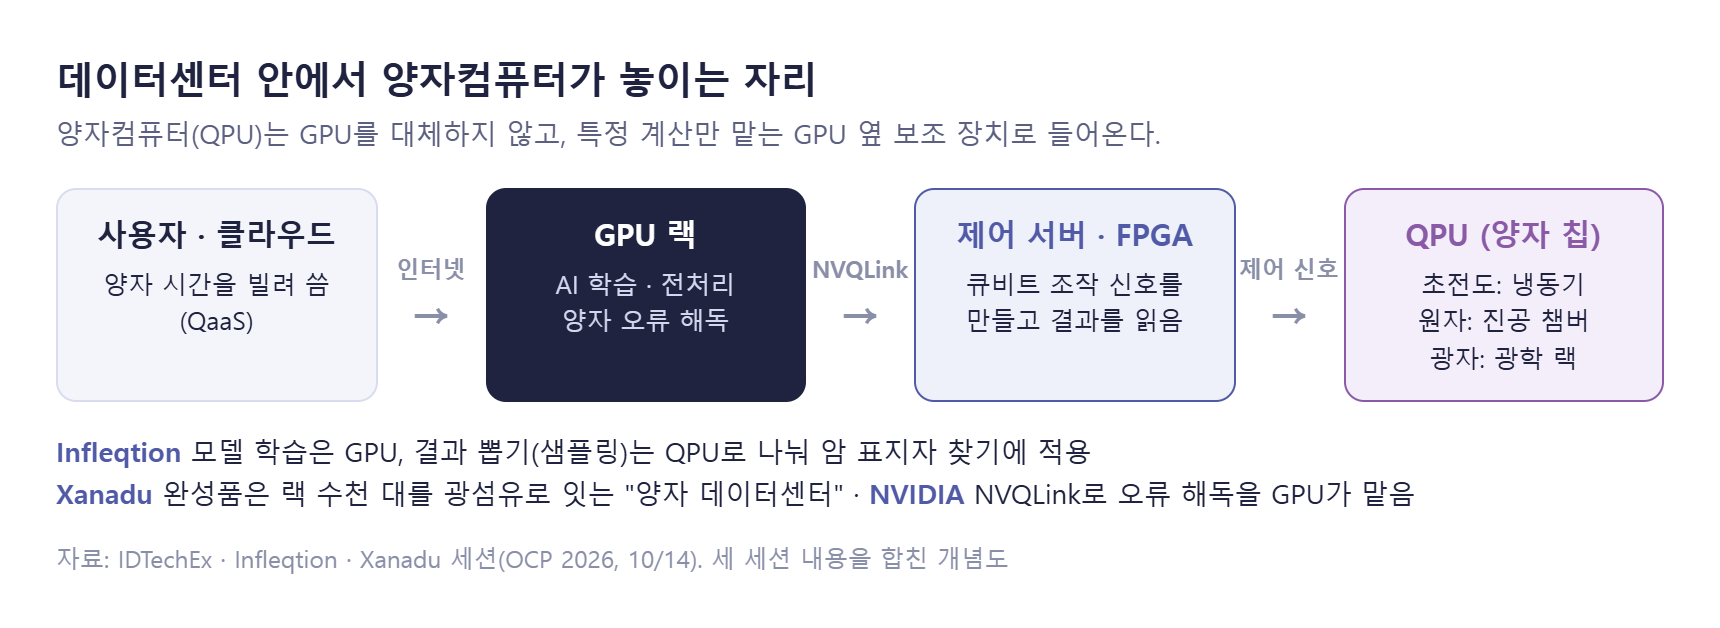
그림 18. 데이터센터 안에서 양자컴퓨터가 놓이는 자리
- IDTechEx(시장 조사): 모든 방식을 비교하며 "승자 독식은 아닐 것"이라고 했다. "2026년은 양자 기업들이 상장하는 해"로, 창업 붐에서 상장·인수 단계로 넘어갔다고 봤다. 특정 용도 실사용은 2029년, 다양한 배치는 2034년이고, 사업 모델은 클라우드 시간 대여(QaaS)다.
- Infleqtion(중성 원자): 원자 80개로 논리 큐비트 30개를 동시에 구동했다(오류 정정 단계는 아니고 오류율은 미공개). 모델 학습은 GPU, 결과 뽑기(샘플링)는 QPU로 나눠 암 표지자 찾기에 적용한 사례는 "GPU 옆 양자"의 실제 모습이다. 논리 큐비트 100개(2028) → 1,000개(2030)가 목표다.
- Xanadu(광자): 상온 광 칩을 실리콘 공정으로 만든다. 지금은 물리 큐비트 12개 시스템(Aurora)이고, 빛 손실이 오류 정정 문턱보다 훨씬 높아 당장의 관건은 큐비트 수보다 빛 손실이다. 완성품은 랙 수천 대를 광섬유로 잇는 "양자 데이터센터"다.
IDTechEx가 꼽은 인프라 과제는 네 가지다. 절대영도 가까이(mK) 식히는 냉각, 전파·자기장을 막는 여러 겹 차폐, 고전 컴퓨터와 계속 대화하기 위한 신호 변환기·서버의 통합, 큐비트 상태를 지키는 일정하고 잡음 없는 전원이다. 양자가 데이터센터에 들어오면 필요한 것은 큐비트 본체보다 이런 주변 장비이고, 공급망이 좁다는 말은 부품 회사에 진입 기회가 될 수 있다는 뜻이다. 아직 확실한 승자가 없다는 점에서 양자 기술 그 자체도 여전히 열려 있는 영역이다.
8. 메모리 - HBM 밖에 새 층이 생긴다 (HBF와 CXL)
에이전트 AI는 대화 기억(KV 캐시, AI가 앞 대화를 다시 계산하지 않으려고 저장해 둔 중간값)을 끝없이 쌓아, GPU 옆 HBM만으로는 다 못 담는다. 삼성전자·SK하이닉스의 공통 메시지는 HBM 밖에 "조금 느리지만 훨씬 큰" 층을 새로 만들자는 것이었고, 그 자리에 HBF(낸드)와 CXL D램이 나란히 놓인다[29].
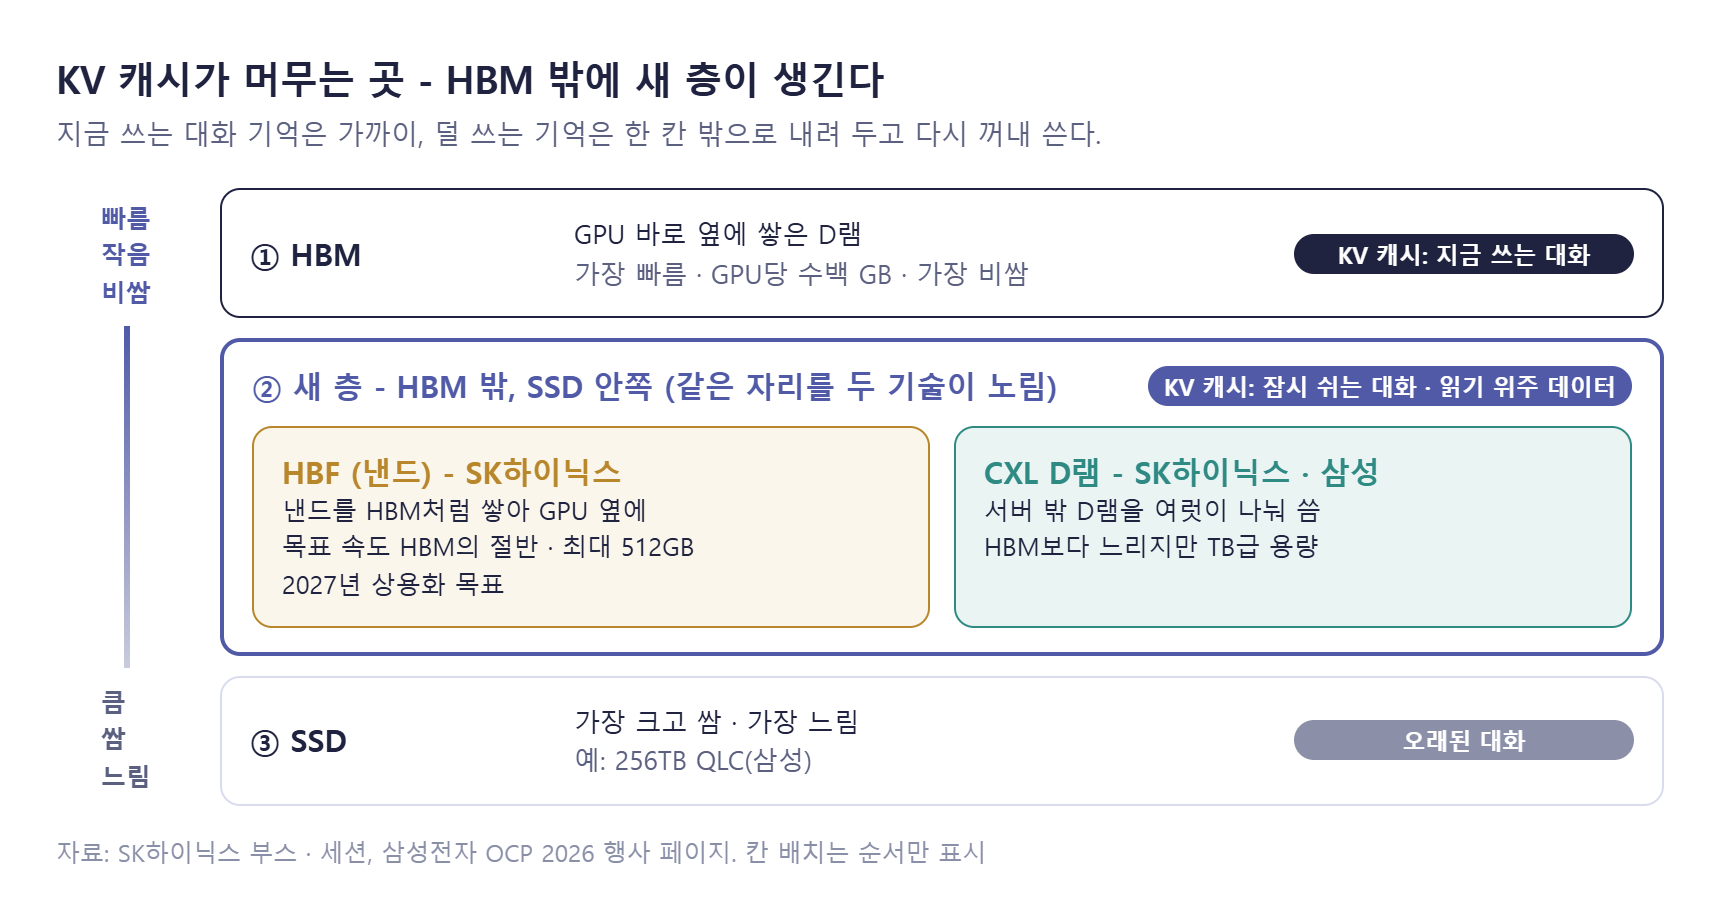
그림 19. KV 캐시가 머무는 곳 - 지금 쓰는 기억은 가까이, 덜 쓰는 기억은 한 칸 밖으로
- 바뀌는 것: 예전에는 HBM에 두다 넘치면 버리고 다시 계산했다. 이제는 층을 나눠 내려 두고 다시 꺼내 쓴다(NVIDIA Dynamo 같은 소프트웨어가 자동으로 옮긴다).
- CXL: KV 캐시는 크고 순서대로 읽는 데이터라 CXL의 약점(긴 지연)이 덜 문제가 된다. 에이전트 AI가 CXL의 첫 대량 수요처가 될 수 있다.
- HBF: 낸드 다이를 8·16층으로 쌓아 GPU 옆에 붙이고 넓은 통로로 연결한 메모리다. SK하이닉스·Sandisk가 8월 첫 규격을 공개했다(최대 512GB, 2027년 상용화 목표). SK하이닉스 부스 엔지니어는 "목표는 HBM의 절반, D램 수준"이라고 설명했다. HBM을 대체하기보다 그 옆의 큰 저장소이고, PCIe 기반 CXL보다는 다소 빠를 전망이다. 부스 카드에는 HBM과 같은 TSV·MR-MUF 공정이 표기돼 있어, 적층·본딩·검사 장비와 패키징 라인이 HBM과 많이 겹칠 것으로 보인다. 관건은 2027년 상용화와 GPU 회사의 채택이다.
메모리가 병목이 되면서 AI 가속기 쪽에도 변화가 보인다. 연산보다 메모리가 병목이 되자, 답을 한 글자씩 만들어 내는 디코딩을 빠르게 처리하려고 칩 안의 SRAM을 키운 추론 칩이 늘고 있다. (SRAM은 그대로고 칩을 늘리든, 칩의 SRAM을 늘리든) Groq(NVIDIA LPX), Cerebras, d-Matrix 등이 그 예다. 특히, Nvidia가 Groq의 LPX를 디코딩 용으로 사용하는 것에서 볼 수 있듯이 이쪽 제품의 시장성에 대해서는 검증 진행중이라고 보면 될 것 같다.
<삼성 vs SK하이닉스 부스 - 삼성은 CXL, SK하이닉스는 CXL과 HBF>
두 회사 모두 HBM 밖에 새 메모리 층을 보였다. 삼성은 서버 밖 CXL D램 풀(CMM-D)과 대용량 SSD로 답했고, SK하이닉스는 CXL 메모리 랙·풀과 더불어 GPU 옆에 낸드를 쌓는 HBF도 제시했다.
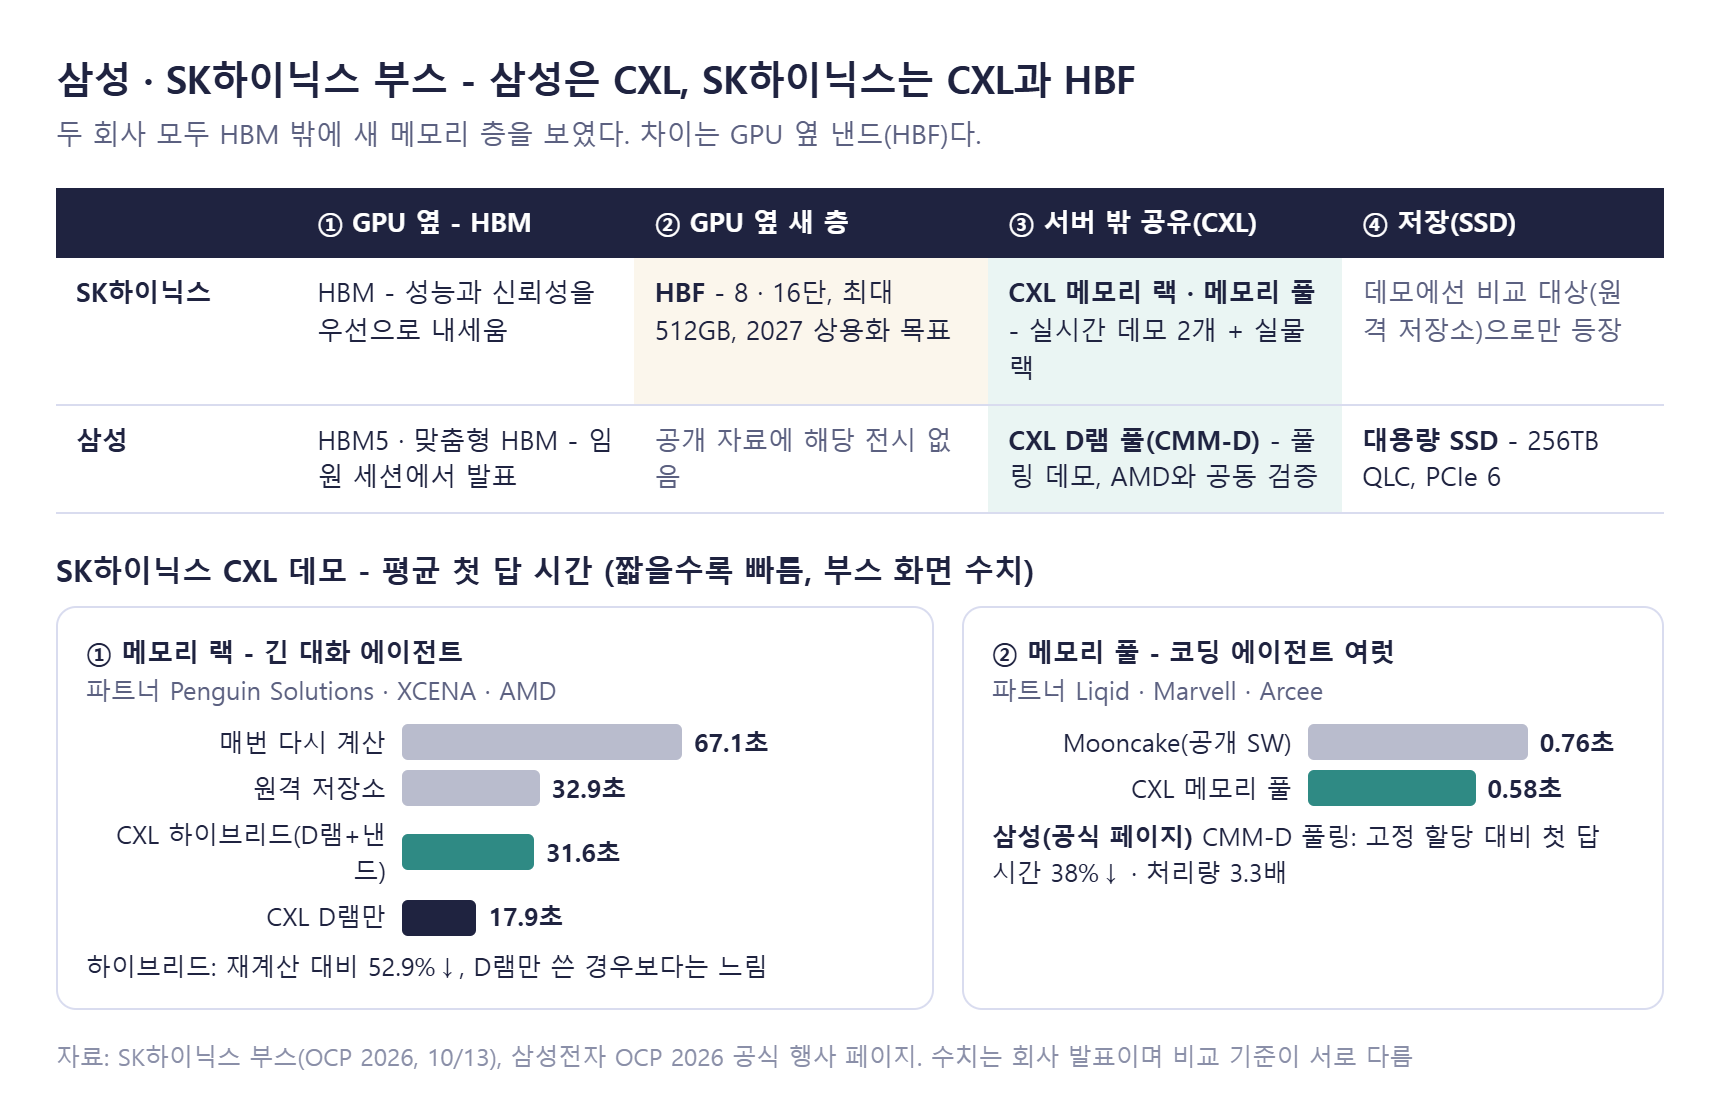
그림 20. 두 회사가 보인 메모리 층별 전시와 SK하이닉스 CXL 데모 2개
- SK하이닉스 메모리 랙 데모(긴 대화 에이전트): 평균 첫 답 시간이 매번 다시 계산하면 67.1초, 원격 저장소 32.9초, CXL 하이브리드(D램+낸드) 31.6초, CXL D램만 쓰면 17.9초였다. 하이브리드는 재계산 대비 52.9% 줄었지만 D램만 쓴 경우보다는 느렸다.
- SK하이닉스 메모리 풀 데모(코딩 에이전트 여럿): 공개 SW(Mooncake) 0.76초 대비 CXL 메모리 풀 0.58초였다.
- 삼성(공식 행사 페이지 기준): CMM-D 풀링으로 고정 할당 대비 첫 답 시간 38%↓·처리량 3.3배, AMD와 공동 데모, 사내 코딩 에이전트에서 KV 캐시 활용 5~7배, SSD 안 벡터 검색으로 호스트로 오가는 데이터 22배↓를 제시했다.
공통점은 CXL D램이고, 첫 대량 수요처는 에이전트 추론이다. 차이는 GPU 옆 낸드(HBF)로, SK하이닉스만 내세웠다. 수치는 모두 회사 발표이고 비교 기준이 서로 달라 직접 비교는 어렵다.
CXL - 서버 밖 메모리를 늘리고 나눠 쓰는 세 가지 방법
CXL은 주로 CPU에 바깥 메모리를 붙이는 PCIe 기반 표준 연결이고, GPU가 쓰는 KV 캐시도 HBM이 차면 이 메모리에 맡겼다가 다시 가져온다. 이번에 눈에 띈 세 회사는 같은 문제를 다르게 풀었다[30].
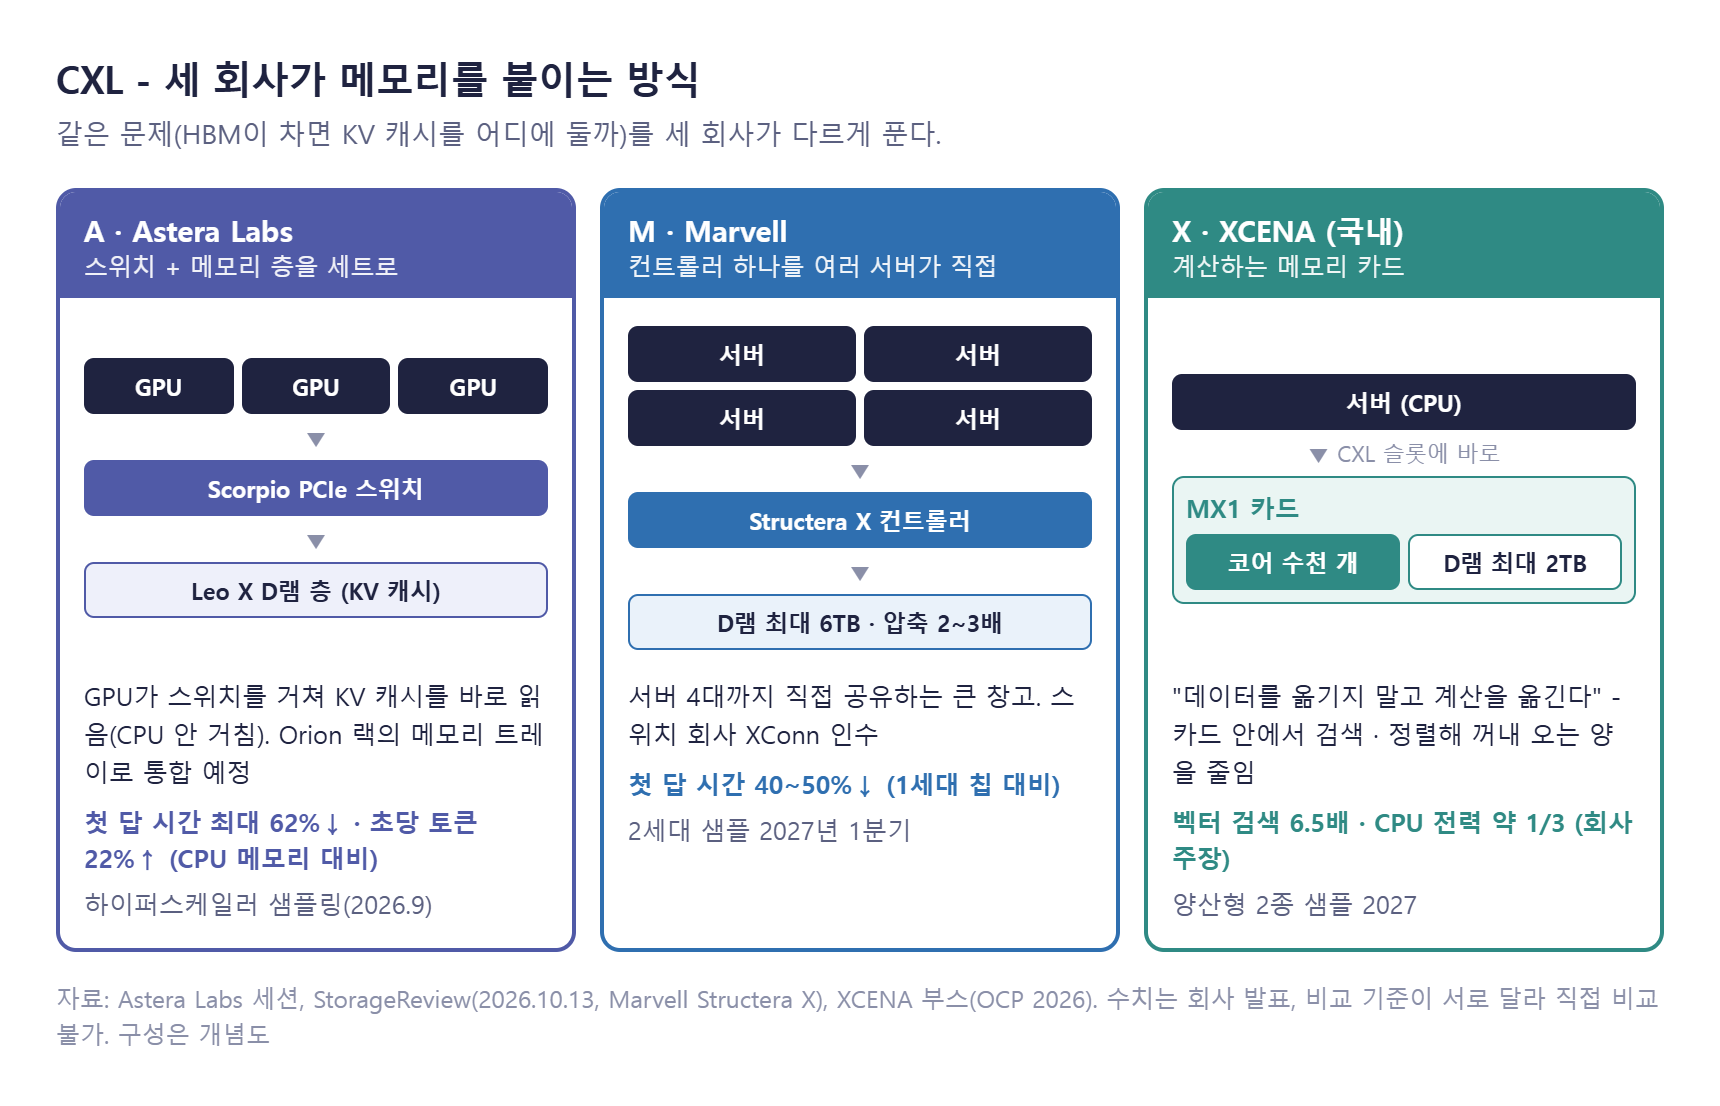
그림 21. 세 회사가 메모리를 붙이는 방식 - Astera Labs · Marvell · XCENA
- Astera Labs - 스위치 + 메모리 층을 세트로: GPU가 자사 PCIe 스위치를 거쳐 Leo X 메모리 층의 KV 캐시를 CPU를 거치지 않고 바로 읽는다. CPU 메모리에 KV 캐시를 둔 경우보다 첫 답 시간 최대 62%↓, 초당 토큰 22%↑라고 발표했고, 하이퍼스케일러 샘플링(2026.9)에 들어갔다.
- Marvell - 컨트롤러 하나를 여러 서버가 직접: Structera X 2세대는 D램 최대 6TB(DDR5)를 서버 4대가 직접 공유하고, 압축으로 실효 용량을 2~3배 늘린다. 1세대 대비 첫 답 시간 40~50%↓, 2세대 샘플은 2027년 1분기다.
- XCENA(국내 스타트업) - 계산하는 메모리 카드: "데이터를 옮기지 말고 계산을 옮긴다"는 접근이다. 서버 CXL 슬롯에 꽂는 MX1 카드 안의 코어 수천 개가 검색·정렬을 해서, CPU로 꺼내 오는 양을 줄인다. 단순 메모리 확장 대비 벡터 검색 6.5배, 같은 일에 CPU 전력 약 1/3이라고 발표했다. SK하이닉스 랙 데모의 파트너이자 삼성과 공동 세션도 했다.
9. 결론 - 병목은 칩 밖으로, 그리고 "good enough"의 시간
AI데이터센터를 짓는 병목이 GPU 칩에서 연결·전력·메모리로 옮겨 갔고, 그 세 곳 모두에서 공개 규격의 제품화가 진행 중이다. 투자 기회도 칩 자체보다 그 주변 부품과, 규격에 맞춰 고객 랙에 들어가는 회사로 넓어진다.
주제 이번 OCP에서 본 것 현장 숫자 통합 설계 · 키노트 하이퍼스케일러가 칩·랙·전력을 세트로 설계하고 부품은 규격으로 산다. 에이전트가 CPU 랙(AMD Helion·NVIDIA Vera·Arm)까지 키운다 Helios 9월 출하, CPU 시장 2030년 약 $220B(AMD) 광통신 스위치는 CPO 양산, GPU 옆은 XPO·NPO가 먼저, 랙 안은 구리가 한 세대 더 포트 전력 30W → 9W(CPO), LPO 장애 2.6배↓(Meta) 네트워크 스케일업은 NVLink 옆에 공개 규격 제품, 스케일아웃은 "여러 길" 전송 규칙 ESUN 1.0 참여 175개사+, MetaRoCE 가동률 90% 800V · SST 기존 건물은 사이드카, 새 건물은 SST로 처음부터 직류. Google·MS·NVIDIA가 SST 규격을 맞춤 SST 5MW·효율 98%, 직류 차단 40μs(Vertiv) 양자 GPU 옆 보조 칩(QPU)으로 들어오고, 사업은 클라우드 시간 대여 실사용 2029년 무렵(IDTechEx), 논리 큐비트 30개(Infleqtion) 메모리 KV 캐시가 HBM을 넘쳐 HBM 밖 새 층(HBF·CXL D램)이 생긴다 삼성은 CXL, SK하이닉스는 CXL과 HBF 모두 오픈 생태계는 "good enough" 단계인가
크리스텐슨의 「혁신의 딜레마」에 따르면 기술이 널리 퍼지는 때는 1등의 성능이 더 오를 때가 아니라, 2~3위 제품이 대부분의 고객에게 "충분한(good enough)" 수준에 올라올 때다. 성능이 모자랄 때는 한 회사가 다 묶은 통합형이 유리하고, 충분해진 뒤에는 표준 연결로 조립하는 모듈형이 퍼진다[31].
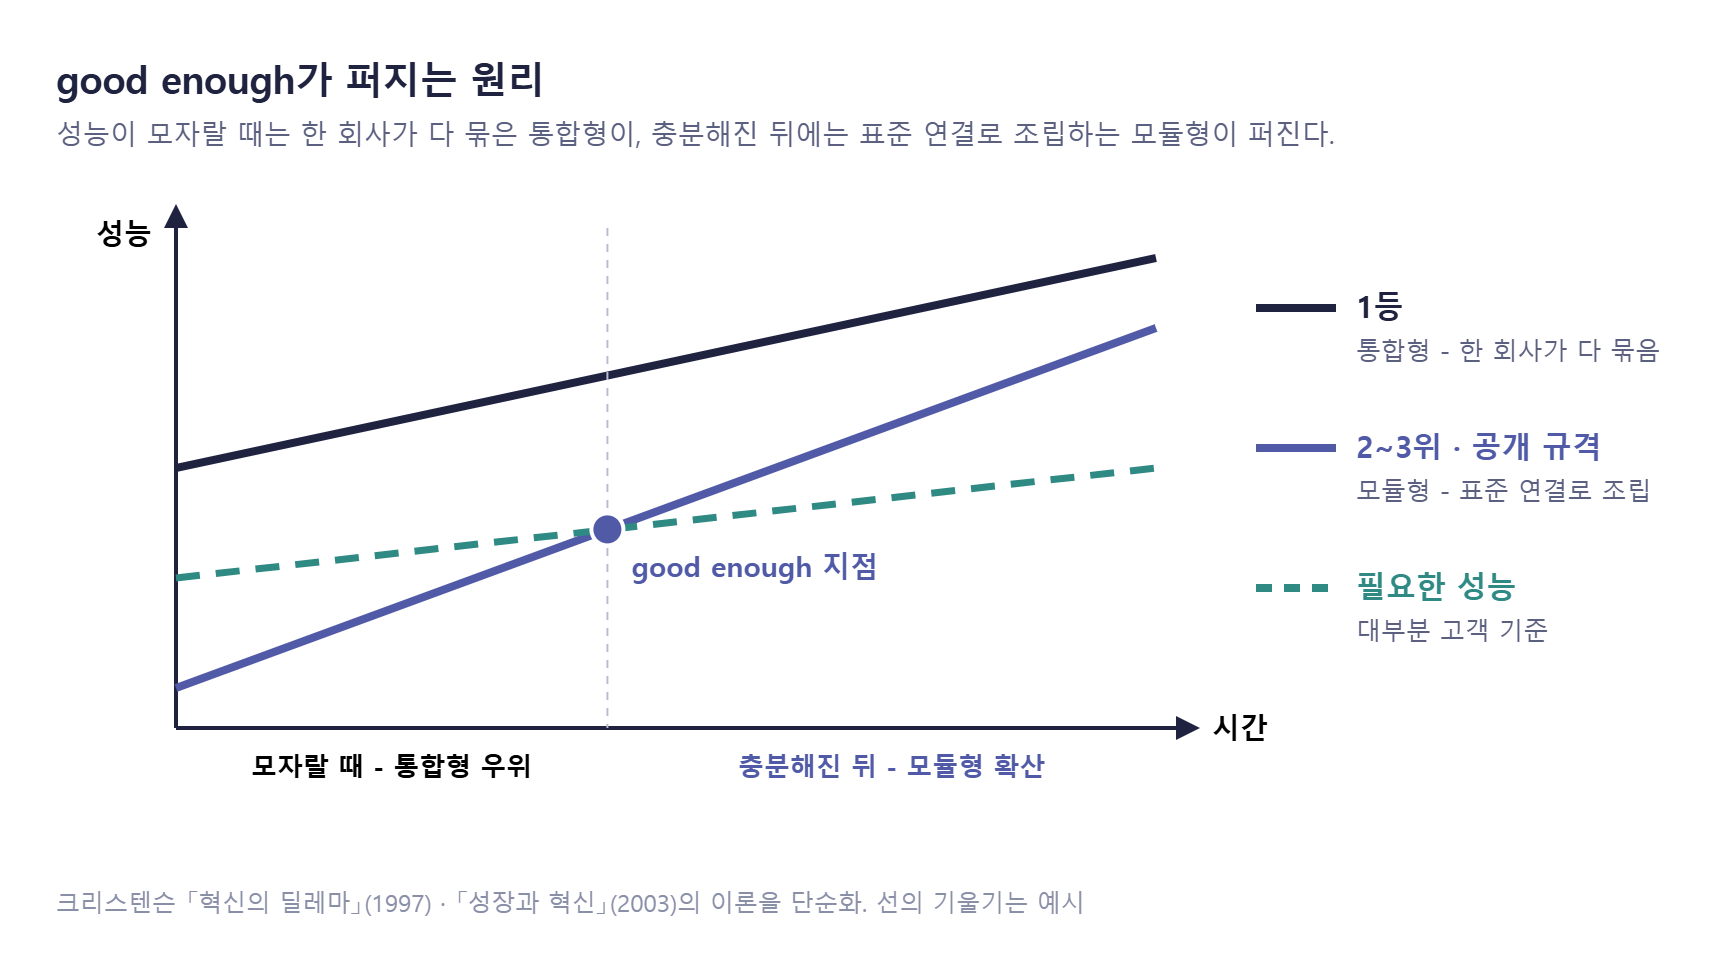
그림 22. good enough가 퍼지는 원리
AI 랙도 최신 모델 학습은 당분간 NVIDIA가 지키겠지만, 추론처럼 물량이 큰 곳에는 NVIDIA가 아닌 공개 규격 랙이 깔릴 여지가 커지고 있다고 본다. 근거는 세 가지다.
- 추론이 커진다: 추론은 최고 성능과 함께 토큰당 비용도 중요한 기준이다. 기존에 시장에 들어가지 못했던 랙도 충분한 기회가 생긴다(AMD는 Helios가 Vera Rubin보다 달러당 토큰이 최대 30% 낫다고 주장)[35].
- 연결 규격이 정해졌다: 공개 규격 ESUN 1.0(2026.3), ORW 1.0(2026.4), UALink가 정해져 여러 회사의 칩·스위치·랙을 조립해 쓸 수 있게 됐다. 즉, 최고로 꼽히던 Nvidia 이외의 선택지가 조금 더 유기적으로 깔릴 판이 만들어졌따.
- 공급·전력 제약: 1등 제품을 원하는 만큼 살 수 없어 두 번째 공급처가 필요하다. Meta는 NVIDIA·AMD·자체 칩을 함께 쓰고, OpenAI·Anthropic도 AMD와 계약했다.
일부 영역에서는 이미 "good enough"가 퍼진 사례가 있다[32][33].
영역 1등 기준 good enough 쪽 결과 AI 모델 Claude Opus 5.5, 지능 지수 58(Artificial Analysis, 2026.10) Meta Muse Spark 1.3, 지수 48로 선두(Opus·Sonnet 5.5)보다 낮음 Meta AI를 매일 쓰는 사람 60%↑(2026.2Q), Muse 앱 미국 1위(2026.9) AI 네트워크 NVIDIA InfiniBand, 2023년 말 AI 백엔드 망의 80% 이상(Dell'Oro) 이더넷(RoCE·UET), NVIDIA도 Spectrum-X로 판매 2026년 1분기 AI 스케일아웃 스위치 매출의 약 2/3가 이더넷(Dell'Oro) 광 연결 CPO, 포트당 전력 30W → 9W(NVIDIA) 랙 안은 구리, GPU 옆은 플러거블(XPO·LPO) 랙 안 구리 한 세대 더(AMD·Broadcom), 추론은 1~2세대 XPO로 충분(MS·Arista) 앞으로 확인할 지표는 NVIDIA 외 AI 서버 비중(2026년 ASIC 27.8% 전망의 변화)[34], 이더넷 스케일업 제품 출하, Helios 가동 결과(2026년 4분기~), 그리고 OCP 기반 랙이 늘면서 어떤 공급사가 선정되는지다.
10. 마치며 - 최종 기술과 중간 기술을 함께 본다
이번 OCP에서 가장 크게 남은 생각은 "최종 도착점과 그 사이를 메우는 중간 기술을 함께 봐야 한다"는 것이다. 최종 도착점이 스케일업의 광통신 적용일 수 있으나, 하이퍼스케일러 입장에서 당장은 구리선으로 충분하다고 생각할 수 있다. 최종 도착점은 CPO여도, 지금 기술 단계에서는 하이퍼스케일러가 "플러거블·XPO로 충분하다"고 판단할 수 있다. 결국 최종 고객의 니즈가 공급 업체들의 수주로 이어지기 위해서는 최종 목표만이 아니라 중간 단계의 기술 트렌드도 함께 따라가야 한다.
긴 호흡의 투자라면 최종 도착점을 향해 가는 회사가 필요하지만, 그 회사가 개발 마일스톤과 주요 트렌드 변화(규격·고객·양산)를 제대로 잡고 가는지 주기적으로 확인해야 한다. 반대로 1~2년 안에 올 시장(Time-to-Market)을 보는 투자라면, 장기 연구개발을 이어 가면서도 단기 수요(수주 가능성)를 맞출 수 있는 기업을 찾는 것이 더 중요할 수 있다. 어느 쪽이든 해외 기업과 최신 기술을 꾸준히 공부하며 판단의 근거를 넓혀 가는 수밖에 없다는 것을 다시 느낀 출장이었다.
Reference
- Microsoft 키노트, OCP Global Summit 2026 (2026.10.13) - Maia 300·Cobalt 200, MRC, Mt Diablo, Mt. Atlas, Tessera
- Oracle 키노트, OCP Global Summit 2026 (2026.10.13) - 신뢰성·광모듈 감시 규격, Tessera
- Meta 세션, OCP Global Summit 2026 (2026.10.12) - Tahan, ESUN, ORW, MetaRoCE
- Meta, Open Rack Wide(ORW) Design Specification v1.0.0 (OCP, 2026.4) / AMD 블로그 (2025.10.14)
- NVIDIA, MGX Accelerated Computing Rack and Trays Specification Rev 1.1 / OCP, Open Rack V3 Base Specification Rev 1.0 (2022.8)
- AMD, Lisa Su 키노트 "Building the Next Era of AI Infrastructure" (2026.10.12) / AMD 보도자료 Helion (2026.10.12)
- Arm, Mohamed Awad 키노트 "The agentic decade starts with open infrastructure" (2026.10.12) / 백서 "How to Define CPU and Software Stack Performance for Agentic AI"
- The Register, NVIDIA Vera CPU 랙 (2026.3.16)
- TrendForce, 에이전트 AI와 CPU:GPU 비율 전망 (2026.4.14)
- Meta 세션 "Operating Linear Pluggable Optics at Hyperscale", OCP Global Summit 2026 (2026.10.13)
- Microsoft·Arista XPO 세션, OCP Global Summit 2026 (2026.10.14) / Arista XPO 보도자료 (2026.3.12) / Futuriom (2026.3.12)
- NVIDIA 기술 블로그, CPO 포트 전력 (2025.8.18)
- Marvell 블로그, Open CPX MSA (2026.5.28, LightCounting 인용) / Open CPX MSA 규격 공개 (BusinessWire, 2026.9.17)
- Broadcom, Tomahawk 6 Davisson CPO (2025.10.8) / Lightwave, OCI MSA (2026.3.20)
- Lumentum 세션, OCP Global Summit 2026 (2026.10.14) / NVIDIA 보도자료, Lumentum·Coherent 투자 (2026.3.2)
- Celestica·Amphenol·Astera Labs·AMD 세션, OCP Global Summit 2026 (2026.10.12~14)
- OCP FTI 워크숍 "Short Reach Optical Interconnects" (2026.10.14) / HPCwire, Avicena (2026.8.18) / Semiconductor Today, Quintessent (2026.8.24)
- microled-info, Microsoft·MediaTek 마이크로LED 광케이블 (2026.3.18)
- OpenAI, MRC (2026.5.5) / AMD, MRC NIC 지원 (2026.5.6)
- Meta Engineering, MetaRoCE (2026.8.24)
- Blocks & Files, UALink 1.0 (2025.4.9) / Converge Digest, OCP ESUN 출범 (2025.10.13)
- NVIDIA 800V 세션, OCP Global Summit 2026 (2026.10.13) - 배치 방식 A·B·C
- OCP, Solid State Transformer (SST) Specification Rev 0.3.0 (Google·Microsoft·NVIDIA)
- Vertiv 세션, OCP Global Summit 2026 (2026.10.14) / Infineon 부스 (2026.10.14)
- Duke University Nicholas Institute, "Rethinking Load Growth: Assessing the Potential for Integration of Large Flexible Loads in US Power Systems" (2025.2.11)
- NVIDIA 블로그, 800V 직류·SST 규격, 협력사 80곳 이상 (2026.8.11) / Vertiv 블로그 (2026.7.17)
- Heron Power Series B (GlobeNewswire, 2026.2.18) / DG Matrix Series A (TechCrunch, 2026.2.18) / VEIR (TechCrunch, 2025.11.12) / ADI의 Empower 인수 (2026.7)
- IDTechEx·Infleqtion·Xanadu 세션, OCP Global Summit 2026 (2026.10.14)
- SK하이닉스 부스·세션, OCP Global Summit 2026 (2026.10.13) / 삼성전자 OCP 2026 공식 행사 페이지 (2026.10)
- StorageReview, Marvell Structera X (2026.10.13) / Astera Labs 세션 (2026.10) / XCENA 부스·세션 (2026.10)
- Clayton Christensen, The Innovator's Dilemma (1997) / Christensen·Raynor, The Innovator's Solution (2003)
- Artificial Analysis Intelligence Index (2026.10.18 조회) / Meta 2026년 2분기 실적 발표 (2026.7.29)
- Dell'Oro Group, AI 백엔드 네트워크 (2025.7.15) / AI 클러스터 스위치 (2026.6.2)
- TrendForce, 2026년 AI 서버 출하 중 ASIC 비중 (2026.1.20)
- AMD, Helios 양산·달러당 토큰 (2026.7.23)
※ 이 글은 공개 자료와 현장 참관 내용을 바탕으로 한 개인 정리이며 투자 권유가 아닙니다.
반응형'최신 기술동향' 카테고리의 다른 글
Computex 2026 Review (3) 2026.06.07 GTC 2026과 AI 팩토리의 부상 (0) 2026.03.28 CPO 기술 동향 및 국내외 기업 분석 (1) 2026.01.10 관심있는 주요 학회 (AI, 반도체)의 2025년 테마 정리 (1) 2025.12.26 기판 시리즈 (PCB vs Si vs Glass; PCB편 w/ CCL) (0) 2025.07.07