-
[AI 데이터센터 반도체 1부] 칩이 아니라 랙을 판다 (GPU)최신 기술동향/2차전지 & 반도체 2026. 9. 21. 13:00
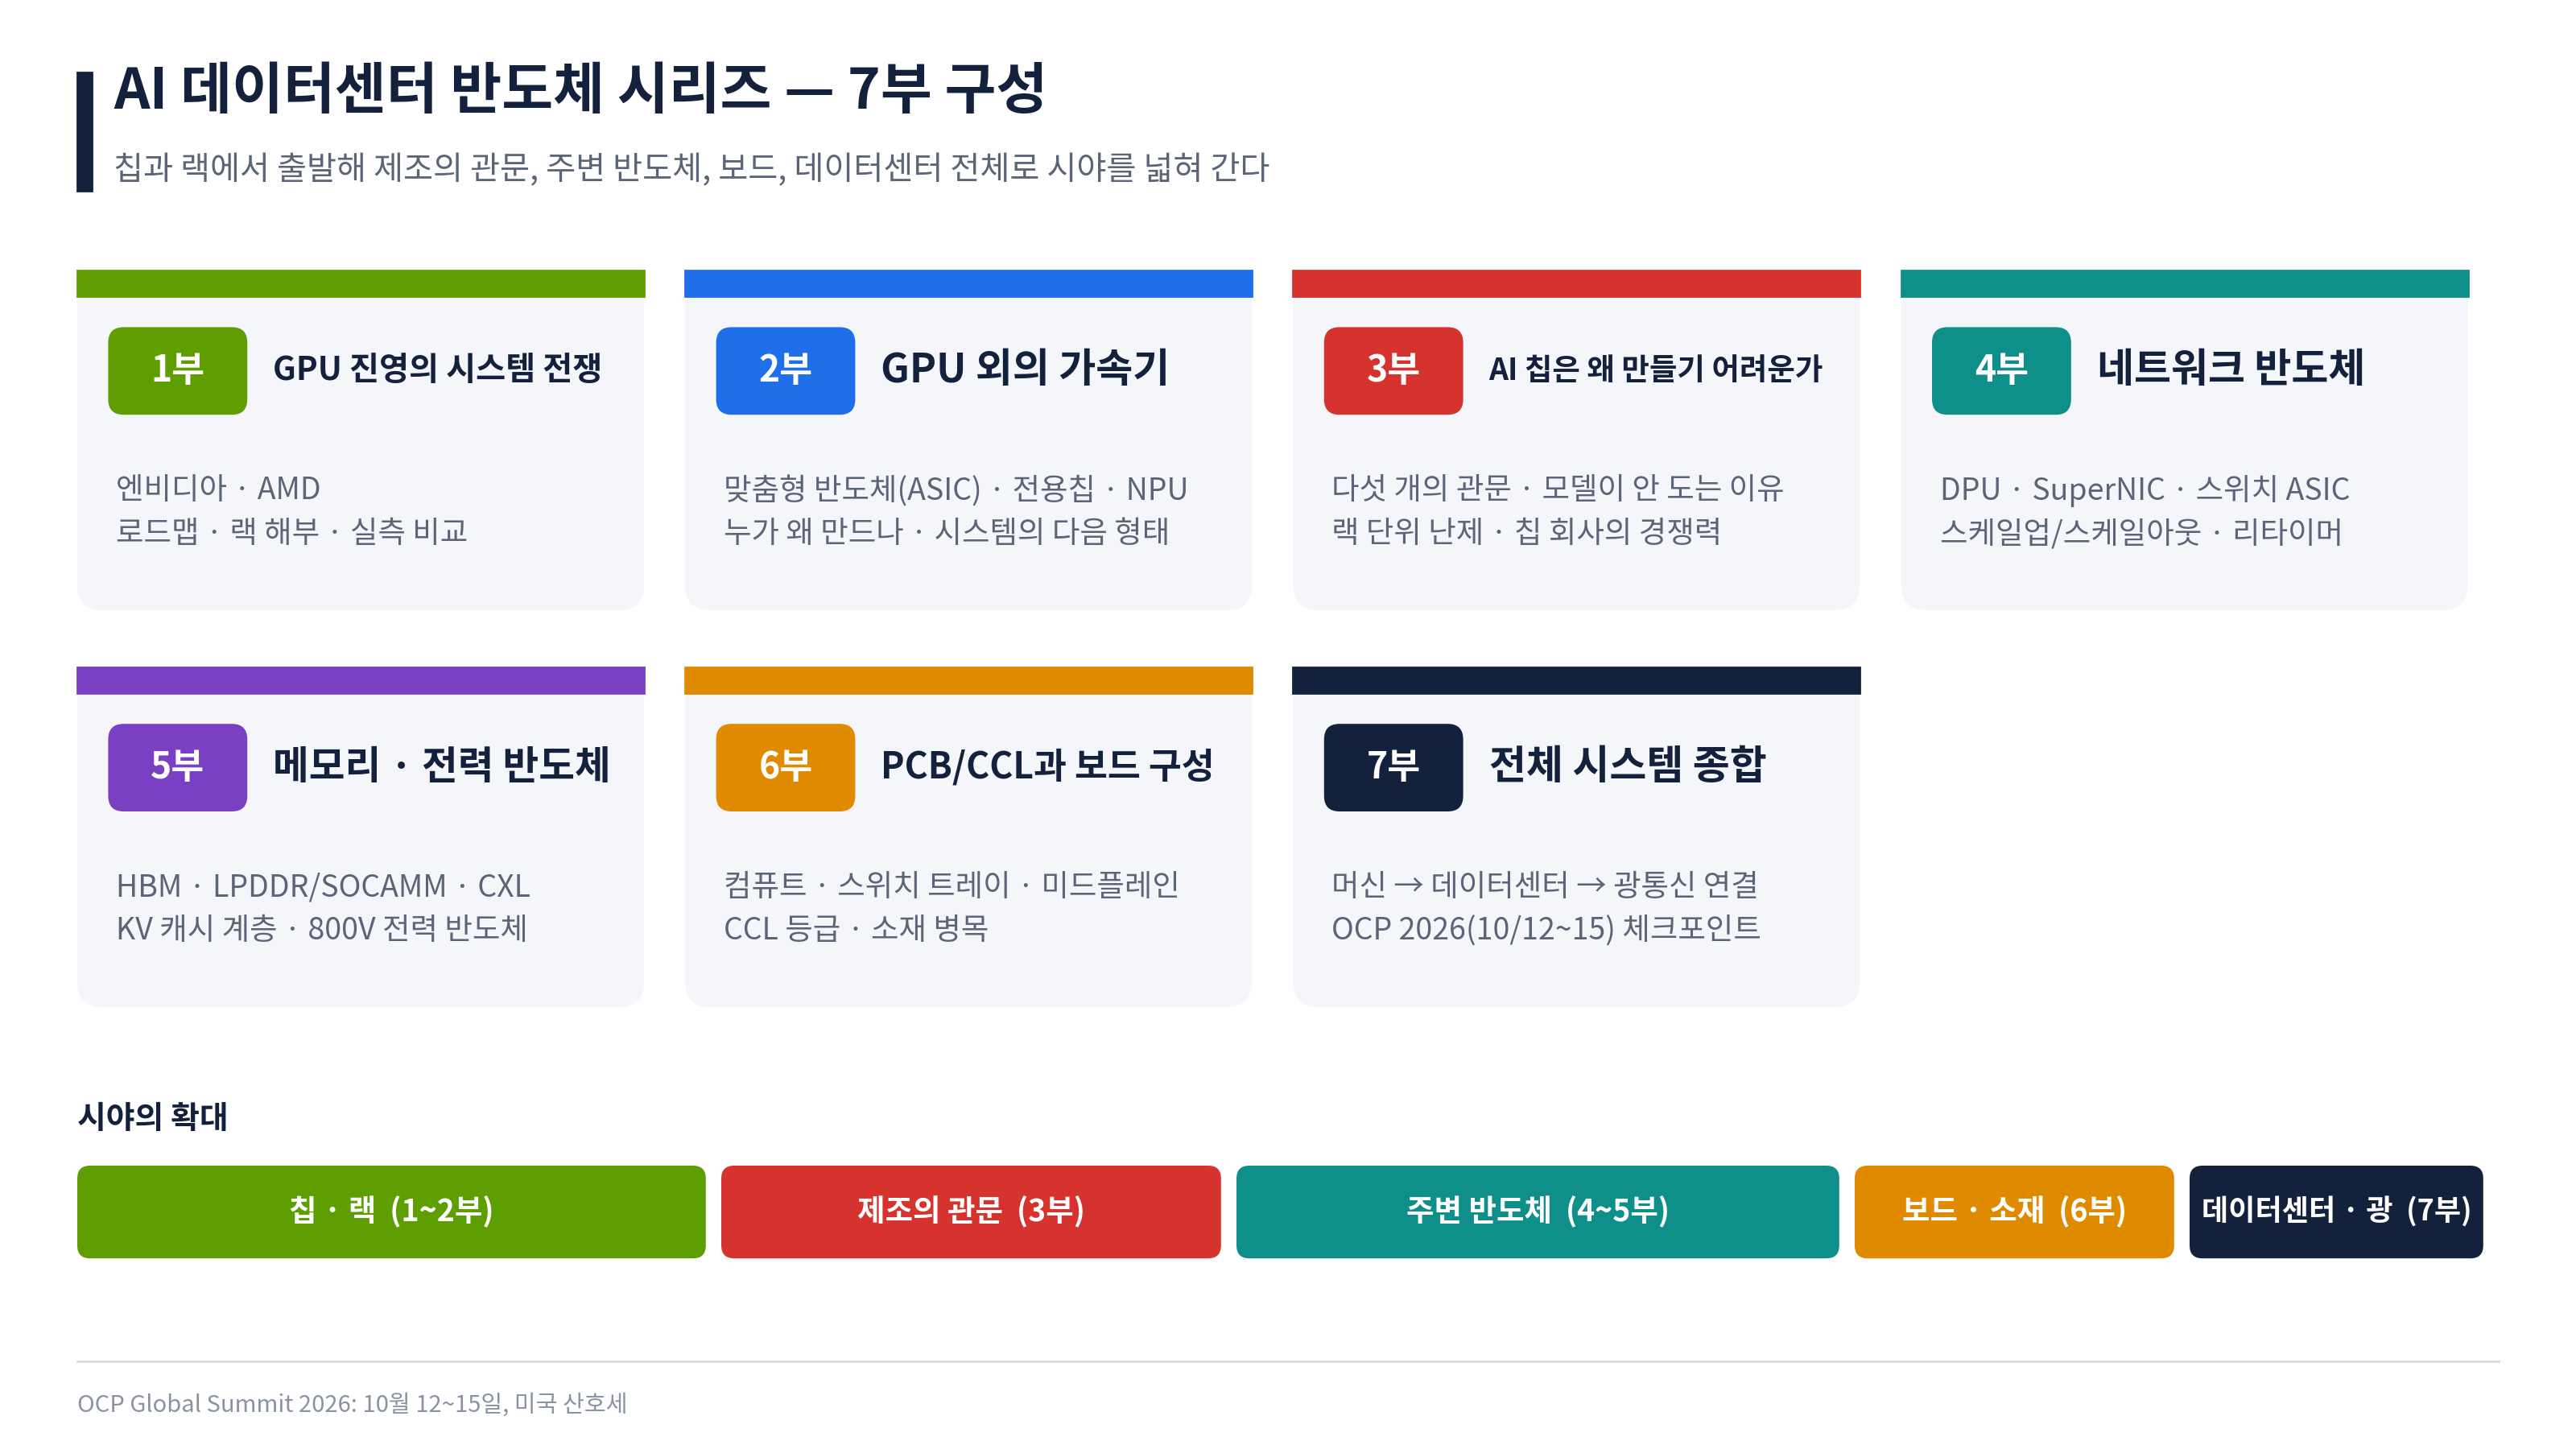
AI 가속기 경쟁의 단위는 칩에서 랙으로, 다시 GPU와 SRAM 칩을 섞어 쓰는 '이기종 추론 공장'으로 넘어갔다. 이 경쟁에서 승부를 가르는 기준은 FLOPS가 아니라, 하나의 저지연 도메인 안에 넣을 수 있는 메모리 대역폭과 토큰 생산 비용/속도다. 광통신 3부작에서는 AI 데이터센터를 "어떻게 묶는가"를 다뤘다. 이번 시리즈는 그 안에 들어가는 "무엇을 묶는가", 즉 반도체를 다룬다. 전체는 7부로 구성한다.
1~2부는 가속기다. 1부에서 GPU 진영(엔비디아, AMD)을, 2부에서 GPU 외의 가속기(브로드컴을 통로로 한 자체 칩, 세레브라스 같은 전용 칩, 화웨이와 국내 NPU)를 비교하고 시스템이 어떤 형태로 구성될지 전망한다. 3부에서는 잠시 방향을 바꿔, 이 칩들을 만드는 일 자체가 왜 어려운지를 본다. AI 칩 회사가 통과해야 하는 다섯 개의 관문과 팹리스의 경쟁력이 주제다. 4~5부는 가속기 주변의 반도체다. DPU와 스위치 ASIC 같은 네트워크 반도체, HBM·CXL·전력 반도체 같은 메모리·전력 계층을 정리한다. 6부는 이 칩들을 하나의 머신으로 묶는 PCB/CCL과 보드 구성이다. 7부에서는 이렇게 만들어진 머신 하나가 데이터센터의 한 요소가 되고, 그 요소들이 광통신으로 묶이는 전체 그림을 정리한다. 10월 12~15일 산호세에서 열리는 OCP Global Summit에서 무엇을 확인할지도 7부에서 다룬다.
1. 프리필과 디코드 - 추론의 병목은 어디에 있나
몇 년 전까지만 해도 가속기 스펙표의 첫 줄은 늘 연산 성능(FLOPS)이었다. 그런데 지금 데이터센터가 돈을 버는 일, 즉 추론에서는 이 숫자가 승부를 가르지 않는다. 그 이유를 보려면 먼저 '가중치'와 'KV 캐시'라는 두 단어를 알아야 한다.
LLM은 같은 모양의 층을 수십~백여 개 쌓은 것이고, 각 층은 크게 두 부분으로 이뤄진다. 어텐션은 지금 처리하는 토큰이 앞의 토큰들을 참고하는 부분이다. 이때 읽는 것이 앞 토큰들의 계산 결과를 저장해 둔 KV 캐시다. FFN(순방향 신경망)은 그렇게 모은 정보를 토큰별로 가공하는 부분이다. 큰 행렬을 곱하는 계산이고, 이때 읽는 그 행렬이 모델의 가중치다. 모델 파라미터의 대부분은 FFN에 있다. 이제 본론이다. 추론은 성격이 다른 두 단계, 프리필과 디코드로 나뉜다.
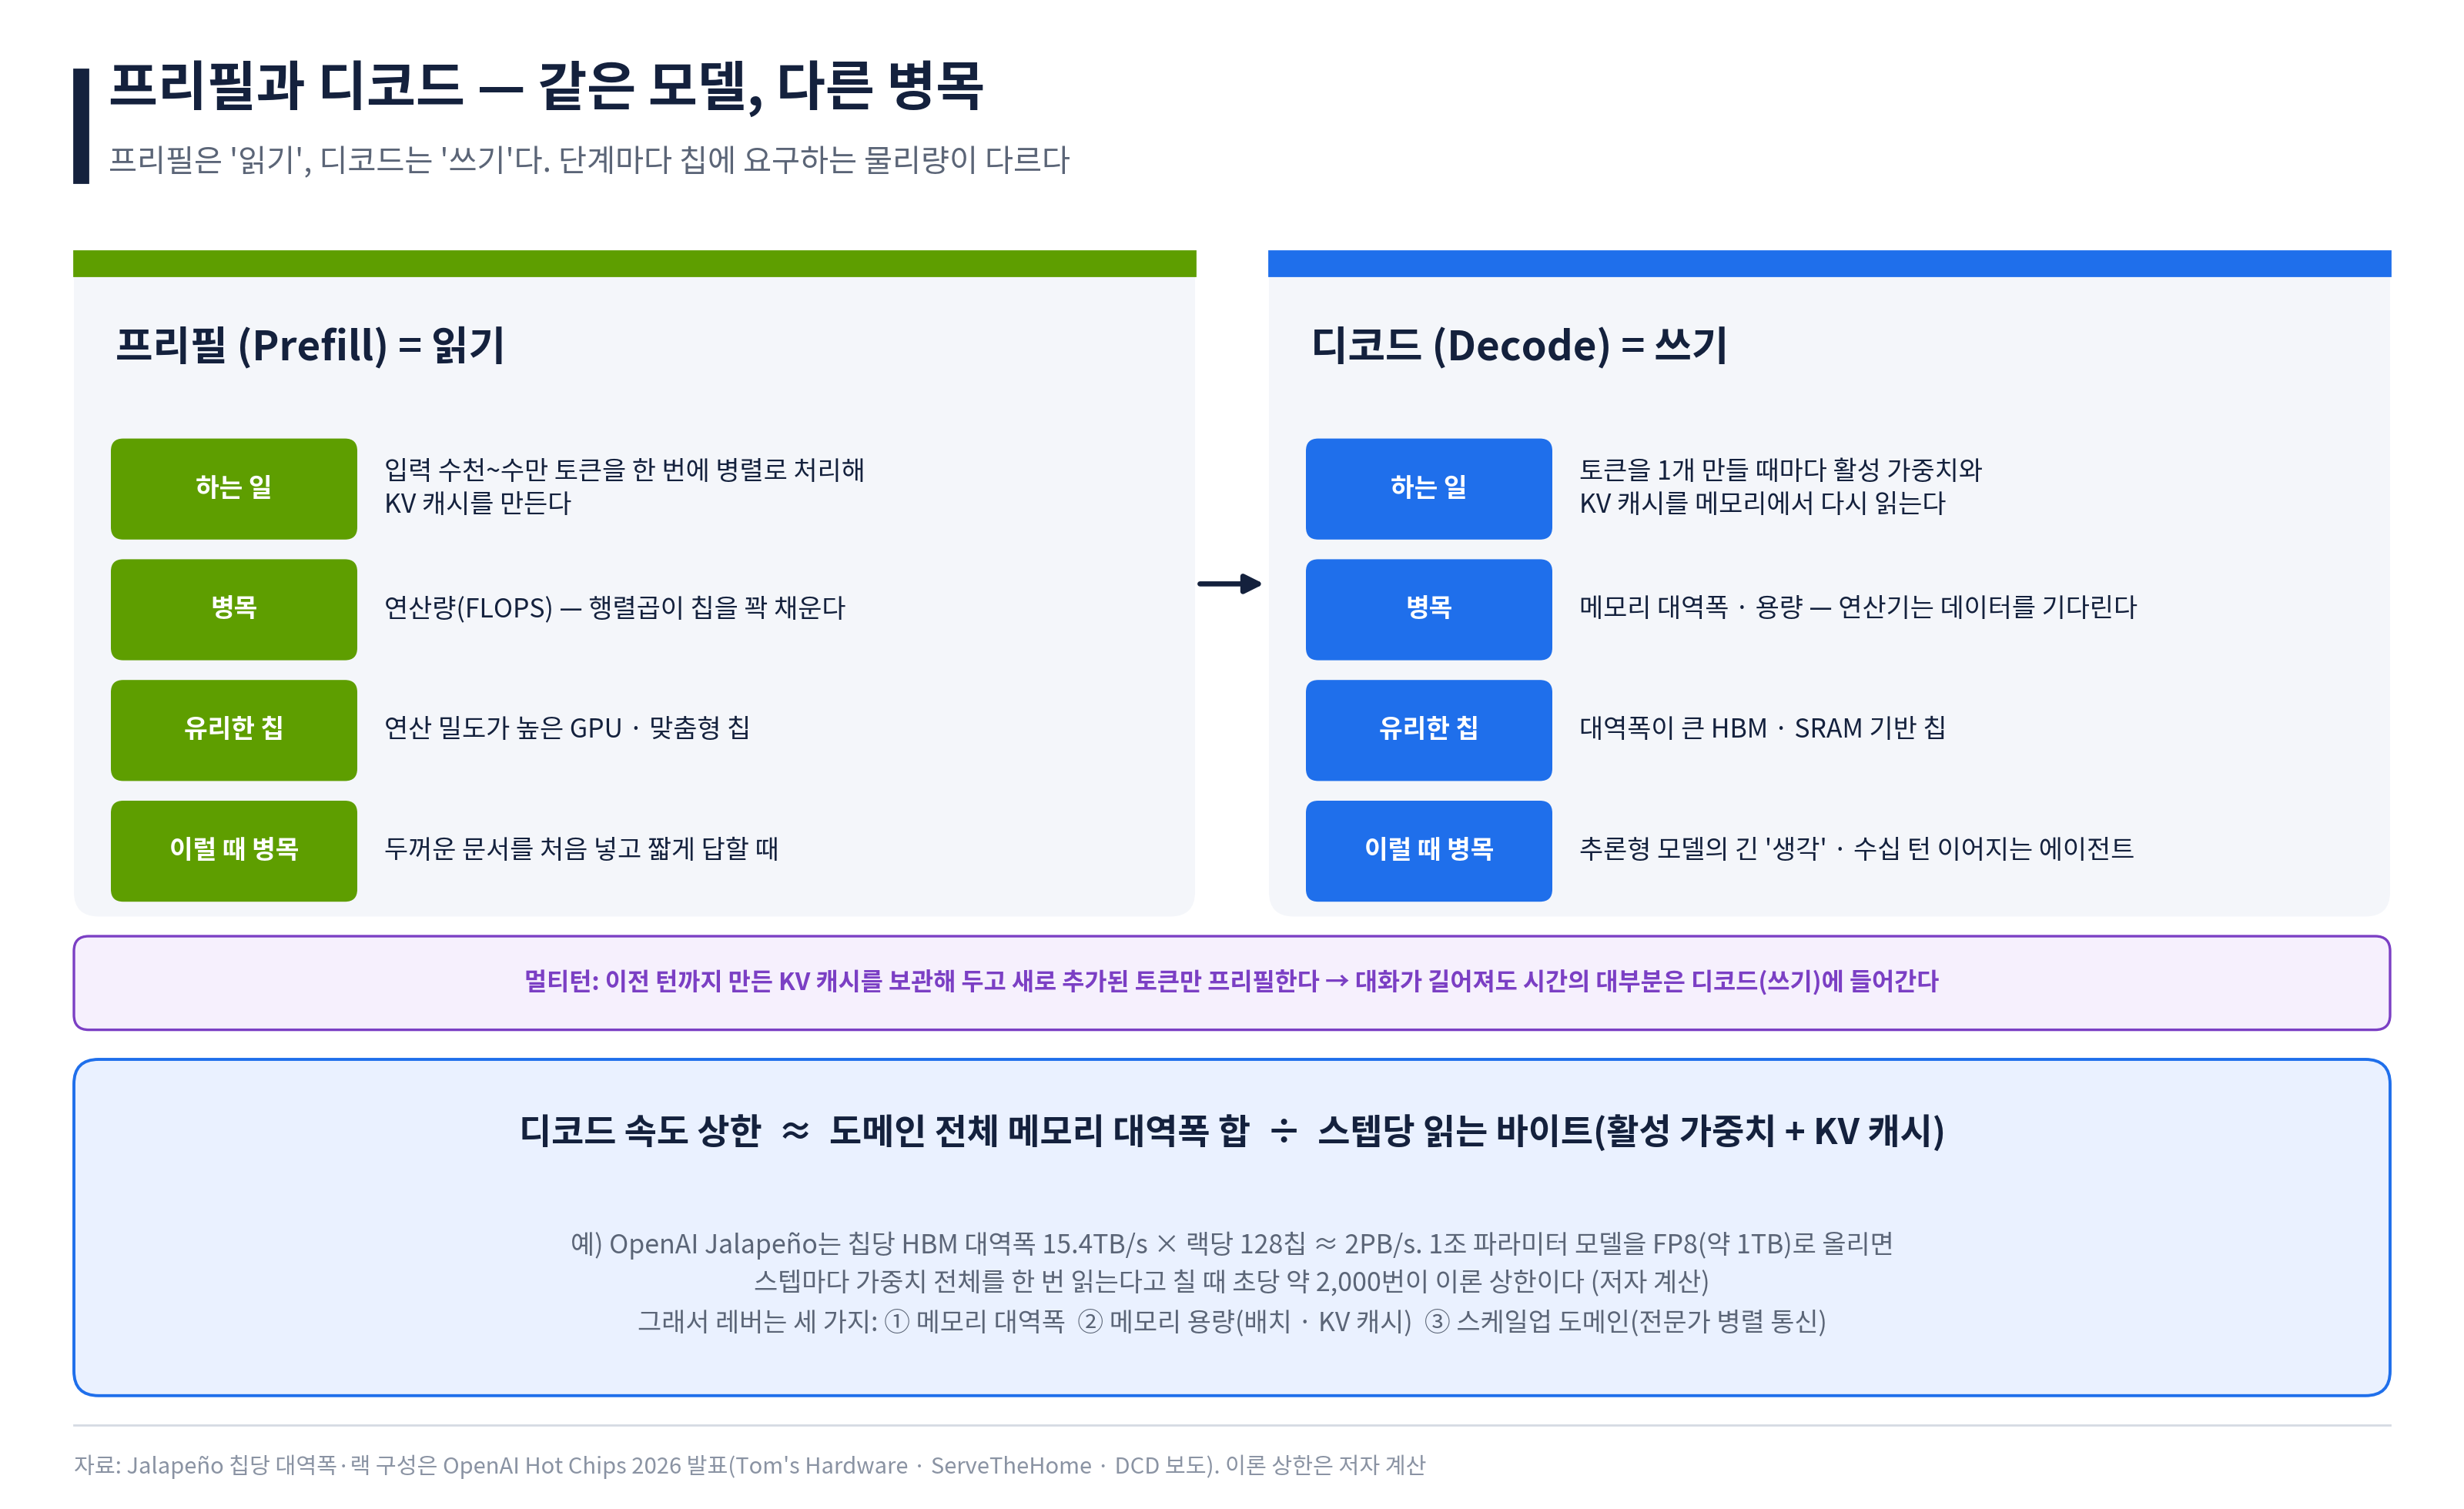
프리필(prefill)은 사용자가 넣은 입력 전체를 한 번에 병렬로 처리해 KV 캐시를 만드는 단계다. 수천~수만 토큰을 한꺼번에 행렬곱에 밀어 넣으므로 연산기가 꽉 찬다. 사용자가 질문을 거듭할수록 KV 캐시는 누적된다. 프리필의 병목은 연산량이다.
디코드(decode)는 출력 토큰을 하나씩 만드는 단계다. 토큰 하나를 만들 때마다 활성 가중치와 그 세션의 KV 캐시를 메모리에서 다시 읽어 와야 한다. 연산 자체는 가벼워서 연산기는 대부분의 시간을 데이터가 도착하기를 기다리며 보낸다. 병목은 메모리 대역폭이다.
비유하자면 프리필은 '읽기', 디코드는 '쓰기'다. 읽기는 여러 쪽을 한꺼번에 펼쳐 놓고 동시에 훑을 수 있다. 쓰기는 한 글자씩 순서대로 써 내려갈 수밖에 없다. 어느 쪽에 시간이 더 걸리는지는 일의 종류에 달려 있다. 두꺼운 자료를 처음 받아 짧게 답하는 일, 예컨대 수십만 토큰짜리 문서를 처음 넣고 요약을 시키는 경우에는 읽기(프리필)가 병목이다. 반대로 읽을 것은 적은데 길게 써야 하는 일에서는 쓰기(디코드)가 병목이다. 요즘 늘어나는 두 가지 워크로드가 여기에 해당한다. 하나는 답을 내기 전에 수천~수만 토큰의 '생각'을 먼저 써 내려가는 추론형 모델이다. 다른 하나는 같은 작업을 수십 턴씩 이어 가는 에이전트다.
에이전트는 대화가 길어서 읽을 것이 많아 보인다. 하지만 실제로는 그렇지 않다. 모델은 지난 대화를 기억하지 못하기 때문에 논리적으로는 턴마다 그때까지의 대화 전체가 다시 입력으로 들어간다. 이를 매번 처음부터 계산하면 턴이 늘수록 연산량이 제곱으로 불어난다. 그래서 실제 서빙에서는 이전 턴까지 계산해 둔 KV 캐시를 버리지 않고 보관했다가, 새로 추가된 토큰만 프리필한다. 이미 읽은 내용은 다시 읽지 않는 것이다. 그 결과 시간의 대부분은 쓰는 데 들어간다. 대신 사용자가 다음 질문을 보낼 때까지 그 KV 캐시를 어딘가에 들고 있어야 한다는 부담이 새로 생긴다. 이 문제는 5부에서 다룬다.
AI 서비스의 무게중심이 추론형 모델과 에이전트로 옮겨 가면서 지금은 디코드가 병목인 경우가 더 많다. 그리고 디코드 속도의 상한은 간단한 나눗셈이 된다.
디코드 속도 상한 ≈ 도메인 전체의 메모리 대역폭 합 ÷ 스텝당 읽는 바이트(활성 가중치 + KV 캐시)
OpenAI도 올해 8월 Hot Chips에서 첫 자체 칩 Jalapeño를 공개하며 같은 관점을 내세웠다. 좋은 추론 칩은 최대 연산 성능이 가장 높은 칩이 아니라 실제 요청을 가장 낮은 지연과 에너지로 끝내는 칩이라는 것이고, 다음 세대의 목표로도 원시 대역폭을 더 붙이는 것이 아니라 칩 전체의 HBM 대역폭 합을 끌어내 쓰는 구조를 제시했다.[1] 이 식에 실제 숫자를 넣어 보면 감이 온다. Jalapeño는 칩당 HBM 대역폭이 15.4TB/s이고 한 랙에 128개가 들어가므로 랙 전체로 약 2PB/s다.[1] 1조 파라미터 모델을 FP8(약 1TB)로 올렸다고 치고, 배치가 커서 스텝마다 거의 모든 전문가가 한 번씩 불린다고 가정하면 초당 약 2,000번 가중치 전체를 읽을 수 있다는 것이 이론 상한이다(필자 계산). 칩을 설계한 당사자가 성능의 출발점을 연산량이 아니라 대역폭으로 잡았다는 점이 중요하다.
디코드 속도 상한과 관련한 수식이 의미하는 세 가지다.
첫째는 메모리 대역폭이다. 분자를 키우는 가장 직접적인 방법이다. HBM3e에서 HBM4로 가는 이유, SRAM 기반 칩이 다시 주목받는 이유가 여기에 있다. 즉, 한 번에 가져오는 속도를 높이면, 디코드 과정의 속도도 올라간다.
둘째는 메모리 용량이다. 이를 이해하려면 '배치'를 알아야 한다. GPU는 한 번에 한 사람만 상대하지 않는다. 디코드 한 스텝을 돌 때 서로 다른 여러 사용자의 요청을 묶어, 각자의 다음 토큰 하나씩을 한꺼번에 계산한다. 이 묶음이 배치다. FFN의 가중치는 모든 사용자에게 똑같으므로 메모리에서 한 번만 읽어 배치 전체가 나눠 쓴다. 디코드의 병목은 읽기이지 곱하기가 아니어서, 한 번 읽어 64명분을 처리하는 것은 거의 공짜다. 배치를 키우면 전체 처리량이 오르는 이유다. 반면 KV 캐시는 사용자마다 다르다. 어텐션은 각자 자기 대화의 KV 캐시만 참고하므로 이 읽기는 나눠 쓸 수 없고, 사용자 수만큼 늘어난다. 그래서 배치를 키우려면 그 인원수만큼의 KV 캐시를 올려 둘 용량이 있어야 한다. 또 배치를 키울수록 한 스텝이 길어져 사용자 한 명이 체감하는 속도는 떨어진다. 추론 벤치마크가 단일 숫자가 아니라 '유저당 속도 대 처리량'의 곡선으로 그려지는 이유다.

셋째는 스케일업 도메인이다. 최신 대형 모델은 대부분 MoE(전문가 혼합) 구조다. FFN 하나를 '전문가'라고 부르는 여러 개의 FFN으로 쪼개 두고, 토큰마다 그중 몇 개만 골라 쓰는 방식이다. 전문가가 많아 한 칩에 다 들어가지 않으므로 여러 칩에 나눠 올린다. 예컨대 1조 파라미터 모델을 FP8로 올리면 가중치만 약 1TB여서, HBM 192GB짜리 GPU 8장(1.5TB)에 산술적으로는 들어간다. 다만 남는 자리가 0.5TB뿐이라 사용자들의 KV 캐시를 담을 여유가 적다. 더 많은 칩을 하나로 묶어야 하는 이유다. 이렇게 전문가를 여러 칩에 흩어 놓으면 레이어마다 칩 사이에 전대전(all-to-all) 통신이 발생한다. 이 통신이 빠르고 넓어야 수십 개 칩의 메모리가 하나의 큰 메모리처럼 움직인다. SemiAnalysis의 공개 벤치마크(InferenceX v2, 2026년 2월)에서 GB200 NVL72의 GPU 한 개는 유저당 60tok/s 조건에서 같은 세대의 8GPU 서버(B200)에 들어간 GPU 한 개보다 3배 가까운 토큰을 생산했다.[2] 칩은 같은 세대인데 랙으로 묶었다는 이유만으로 생긴 차이다.
경쟁의 단위가 칩에서 랙으로 넘어갔다는 말은 수사가 아니라 이 산수의 결론이다. 이하 두 회사를 볼 때도 칩 스펙보다 "한 도메인에 얼마나 많은 대역폭을, 어떤 방식으로 묶었는가"를 기준으로 본다.
2. 엔비디아의 공식 로드맵 - 플랫폼 전체가 1년 주기로 움직인다
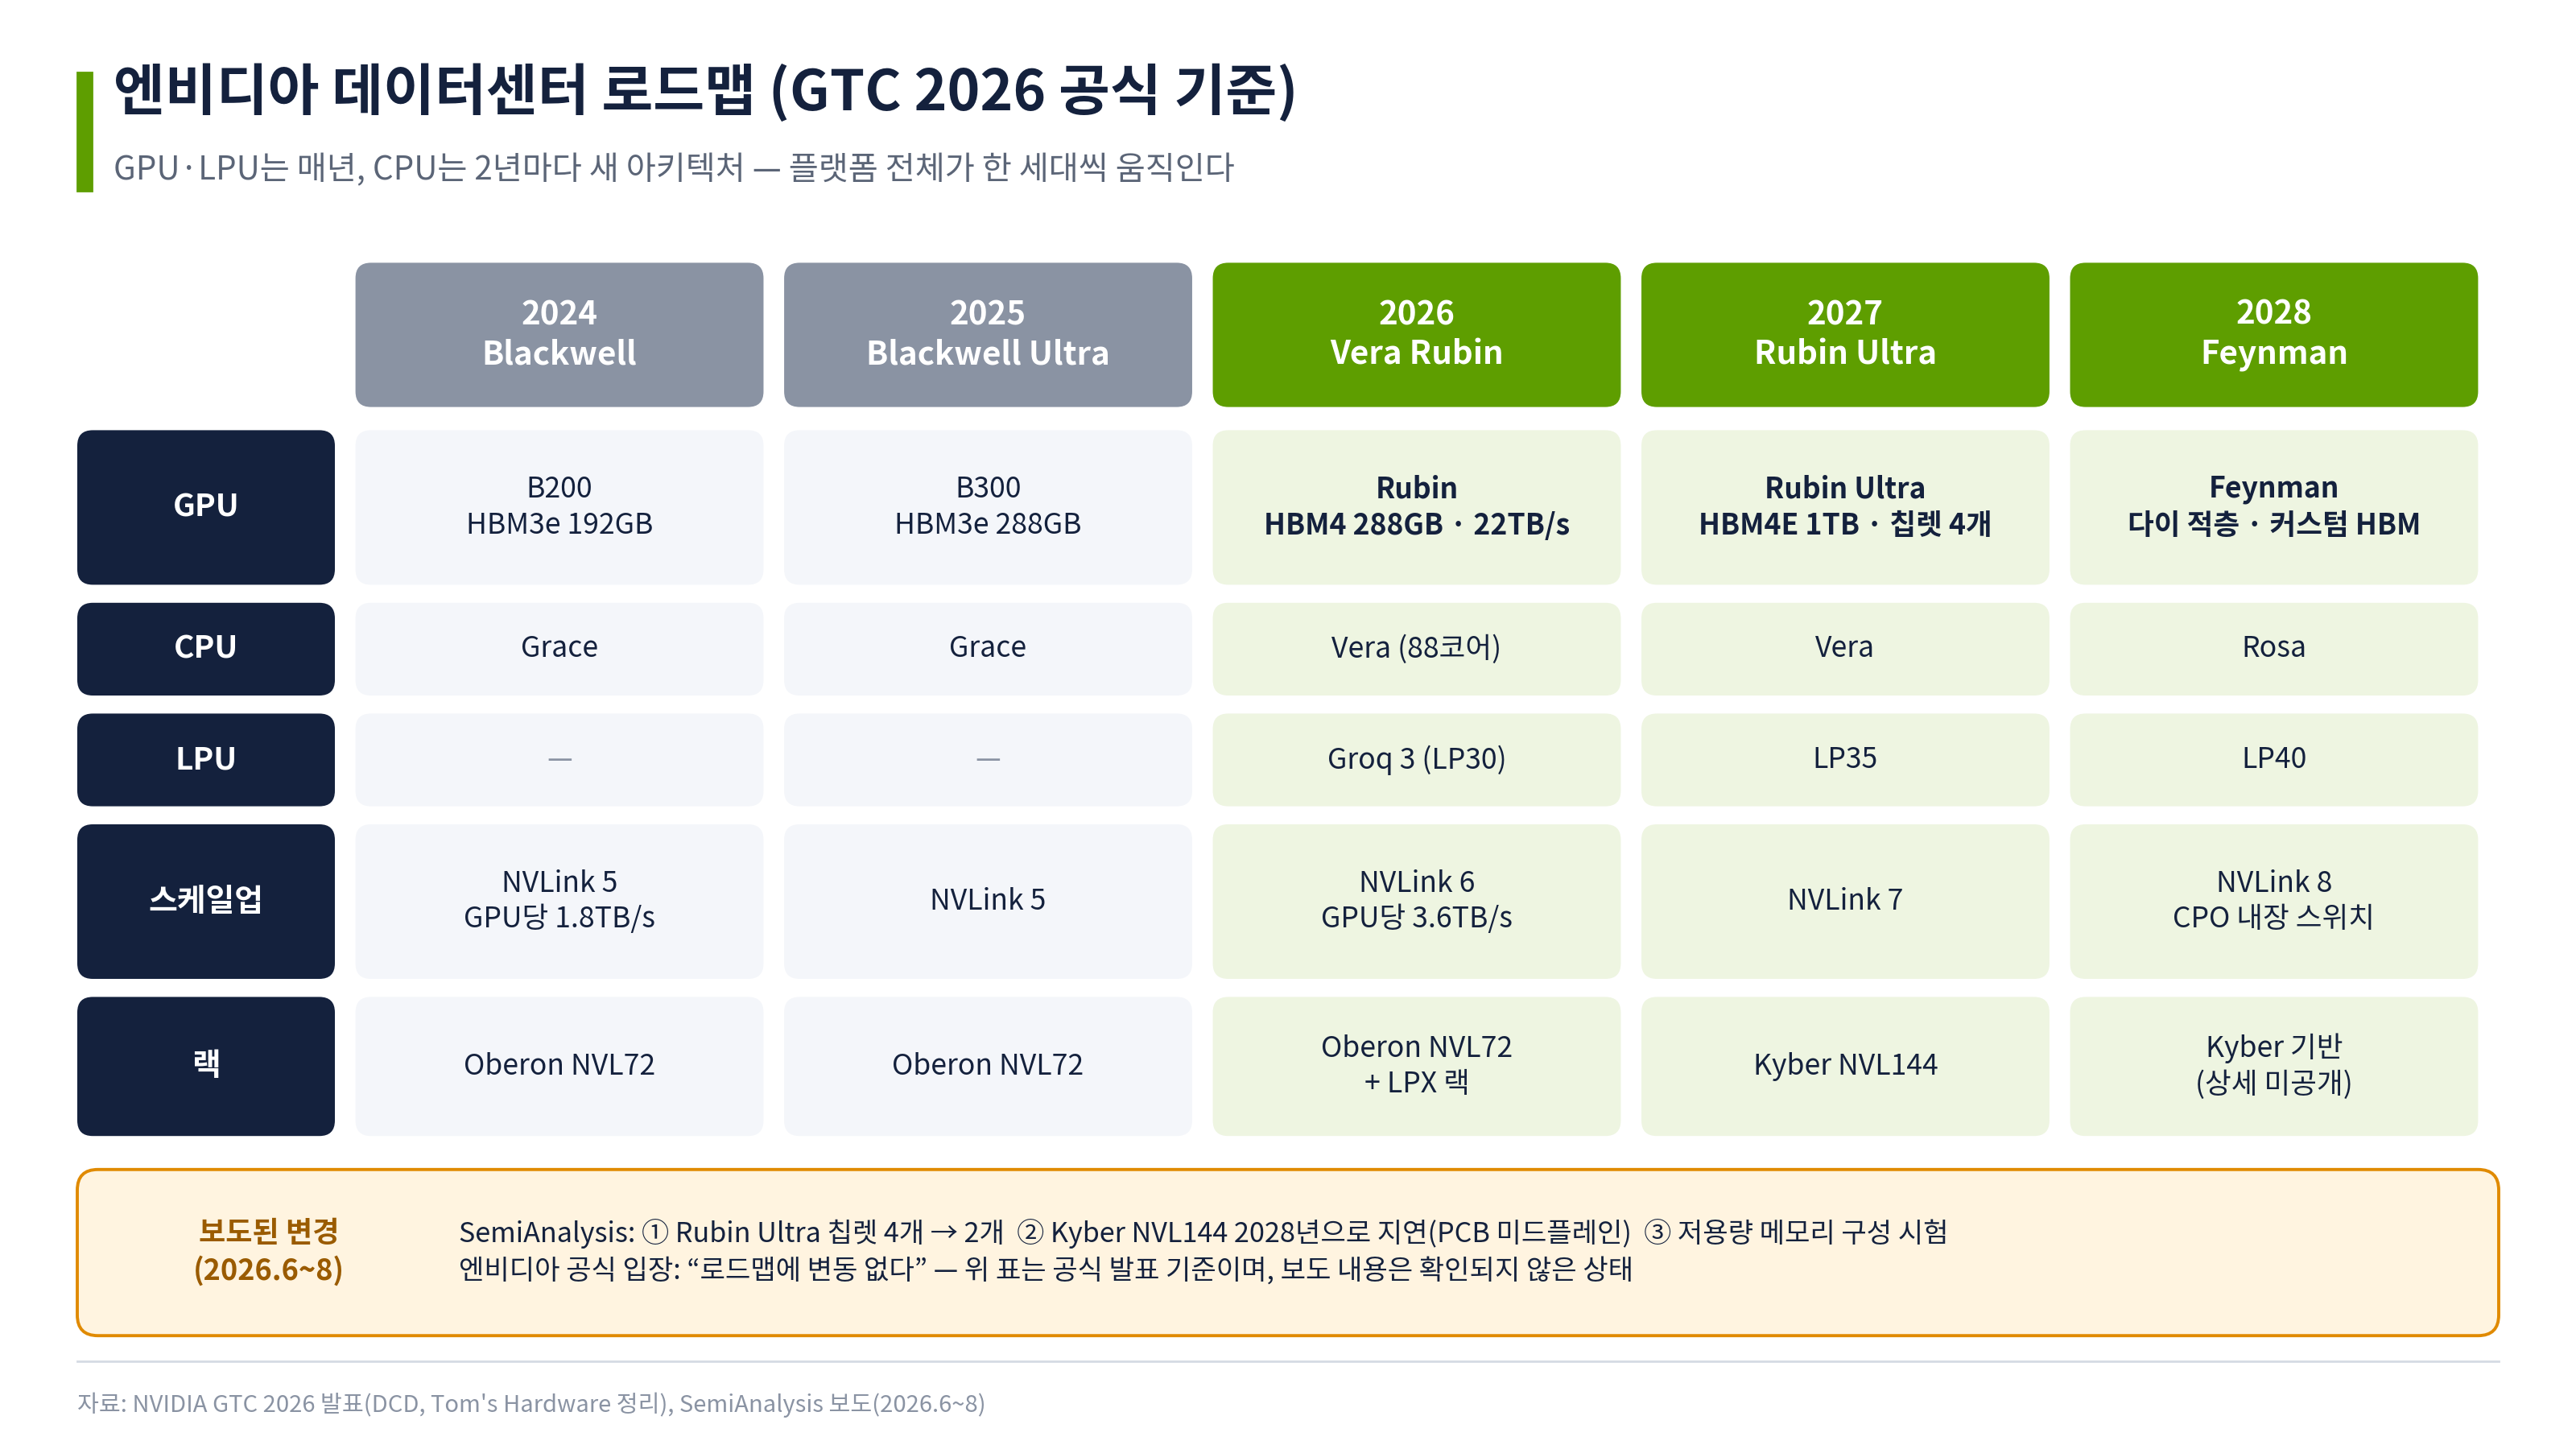
3월 GTC 2026에서 엔비디아가 제시한 로드맵은 다음과 같다. 2026년 하반기 Vera Rubin (로드맵상 본격 공급 시점), 2027년 하반기 Rubin Ultra(연산 칩렛 4개, HBM4E 1TB)와 NVLink 7 기반의 Kyber NVL144 랙, 2028년 Rosa CPU와 Feynman GPU다. Feynman은 다이 적층과 커스텀 HBM을 쓰고, 공동 패키징 광학(CPO)을 내장한 NVLink 스위치를 처음 채택한다. 같은 해 BlueField-5 DPU, CPO 기반 Spectrum-7 스위치, ConnectX-10 NIC도 예정돼 있다.[3]
눈여겨볼 변화는 LPU라는 새 줄이 생겼다는 점이다. 엔비디아는 2025년 12월 24일 추론 칩 스타트업 그록(Groq)을 인수하지 않고, 비독점 기술 라이선스 계약(약 200억 달러로 보도)을 맺고 창업자 조너선 로스를 포함한 핵심 인력을 데려왔다.[4] 회사를 사지 않고 기술과 사람만 가져온 구조여서 그록 법인은 지금도 독립 회사로 남아 있다. 그 결과물이 Groq 3 LPU(LP30)이고, 2027년 LP35, 2028년 LP40이 뒤따른다.[3] GPU와 LPU는 매년, CPU는 2년마다 새 아키텍처가 나오는 구조가 됐다.
실적은 이 로드맵을 밀어붙일 체력을 보여 준다. FY27 2분기(5~7월) 매출은 962억 달러, 그중 데이터센터가 890억 달러다. 매출총이익률은 75.0%, 3분기 매출 가이던스는 1,080억 달러다.[5] 경영진은 3분기 데이터센터 매출의 약 20%를 Vera Rubin이 차지하고, FY28 매출은 약 70% 성장할 것이라고 밝혔다.[6] 3분기 성장은 하이퍼스케일러 이외 고객군이 이끌고, 하이퍼스케일러 매출은 Vera Rubin 공급이 늘어나는 4분기 이후에 다시 가속한다고 했다. 재고는 Rubin 출하 준비로 320억 달러까지 늘었다.[6] 지금 엔비디아의 제약은 수요가 아니라 공급이다.
3. Vera Rubin NVL72 해부 - 일곱 개의 칩, 하나의 랙
엔비디아는 Vera Rubin을 GPU가 아니라 '일곱 개의 칩과 다섯 종류의 랙'으로 구성된 플랫폼이라고 부른다. Rubin GPU, Vera CPU, NVLink 6 스위치, ConnectX-9 SuperNIC, BlueField-4 DPU, Spectrum-6 이더넷 스위치, 그리고 Groq 3 LPU다. 이 가운데 DPU와 스위치는 4부에서 따로 다룬다. 이 '플랫폼화'의 재무적 의미는 엔비디아 스스로 숫자로 밝혔다. 데이터센터 1GW당 자사의 매출 기회가 Hopper 세대 약 180억 달러에서 Blackwell 250억 달러, Vera Rubin 400억 달러로 커졌다는 것이다.[6] GPU 값만 오른 것이 아니라 CPU, 스위치, NIC, LPU가 한 묶음 안으로 들어온 결과다.
핵심인 Rubin GPU는 노광기가 한 번에 찍을 수 있는 최대 크기(레티클 한계)의 다이 2개로 구성되고 트랜지스터는 3,360억 개다. HBM4 288GB를 8개 스택으로 싣고 메모리 대역폭은 최대 22TB/s다. 전 세대(8TB/s)의 2.75배다.[7] NVFP4 기준 추론 50PF, 학습 35PF이고, 양산 SKU의 TDP는 약 2.3kW다. NVLink 6는 GPU당 3.6TB/s로 전 세대의 2배다. 궈밍치에 따르면 같은 하드웨어로 저전력(Max-Q, GPU 약 1.8kW·랙 약 190kW)과 고성능(Max-P, 약 2.3kW·랙 약 230kW) 두 가지 전력 프로파일이 제공되며, 전 세대 GB300 NVL72의 랙 전력은 약 140kW였다.[8]
이 GPU 72개와 Vera CPU 36개(Arm 기반 88코어, LPDDR5X 최대 1.5TB)를 한 랙에 묶은 것이 NVL72다. 랙 전체로 HBM4 약 20.7TB, NVFP4 추론 3.6EF, NVLink 합계 260TB/s다.[7] 1장의 산수에 대입하면 이 세대의 본질이 보인다. 연산은 3~3.5배 늘었는데 메모리 대역폭도 2.75배, 스케일업 대역폭도 2배 늘렸다. 엔비디아가 말하는 '극단적 공동설계'의 실체는 세 레버를 한 세대에 같이 올렸다는 것이다.
도입 상황은 두 단계로 나눠 읽어야 한다. 상반기는 초기 물량의 단계였다. 마이크로소프트가 3월에 하이퍼스케일러 중 처음으로 Vera Rubin NVL72 시스템의 전원을 올렸다고 밝혔고, 6월 초에는 코어위브가 첫 랙을 가동했으며, 7월에는 구글 클라우드와 오라클 클라우드 등에서도 가동에 들어갔다고 보도됐다.[9] 회사가 '양산 출하'라고 부르는 단계는 8월 초에 시작됐다. 엔비디아는 8월 26일 실적 발표에서 이를 밝히며 모든 주요 하이퍼스케일러와 AI 클라우드, 시스템 업체로부터 주문을 받았다고 했다.[6] 궈밍치는 1월에 랙 조립의 양산 진입을 3분기 말로, 하반기 랙 출하량을 5,000~7,000대로 추정한 바 있다.[8]
뒤에서 볼 첫 실측은 양산 SKU의 랙을 출시 전 소프트웨어로 돌려 측정한 것이다. 9월 14일 SemiAnalysis가 자사 에이전트 추론 벤치마크(AgentX)로 측정한 첫 검증 결과를 공개했다. DeepSeek V4 Pro 1.6T 모델, 유저당 100tok/s 조건에서 Rubin NVL72는 전력 1MW당 약 5,940만 tok/s를 기록했다. 같은 조건의 GB300 NVL72(SGLang)는 2,850만으로, Rubin이 2.09배다. 엔비디아가 GTC에서 주장한 수치는 'MW당 3배'였는데, 속도 구간에 따라 최대 7배까지 측정됐다.[10] 총소유비용(TCO) 기준으로는 실제 서빙이 몰리는 유저당 60~100tok/s 구간에서 GB300의 1.4~3배다.[10]
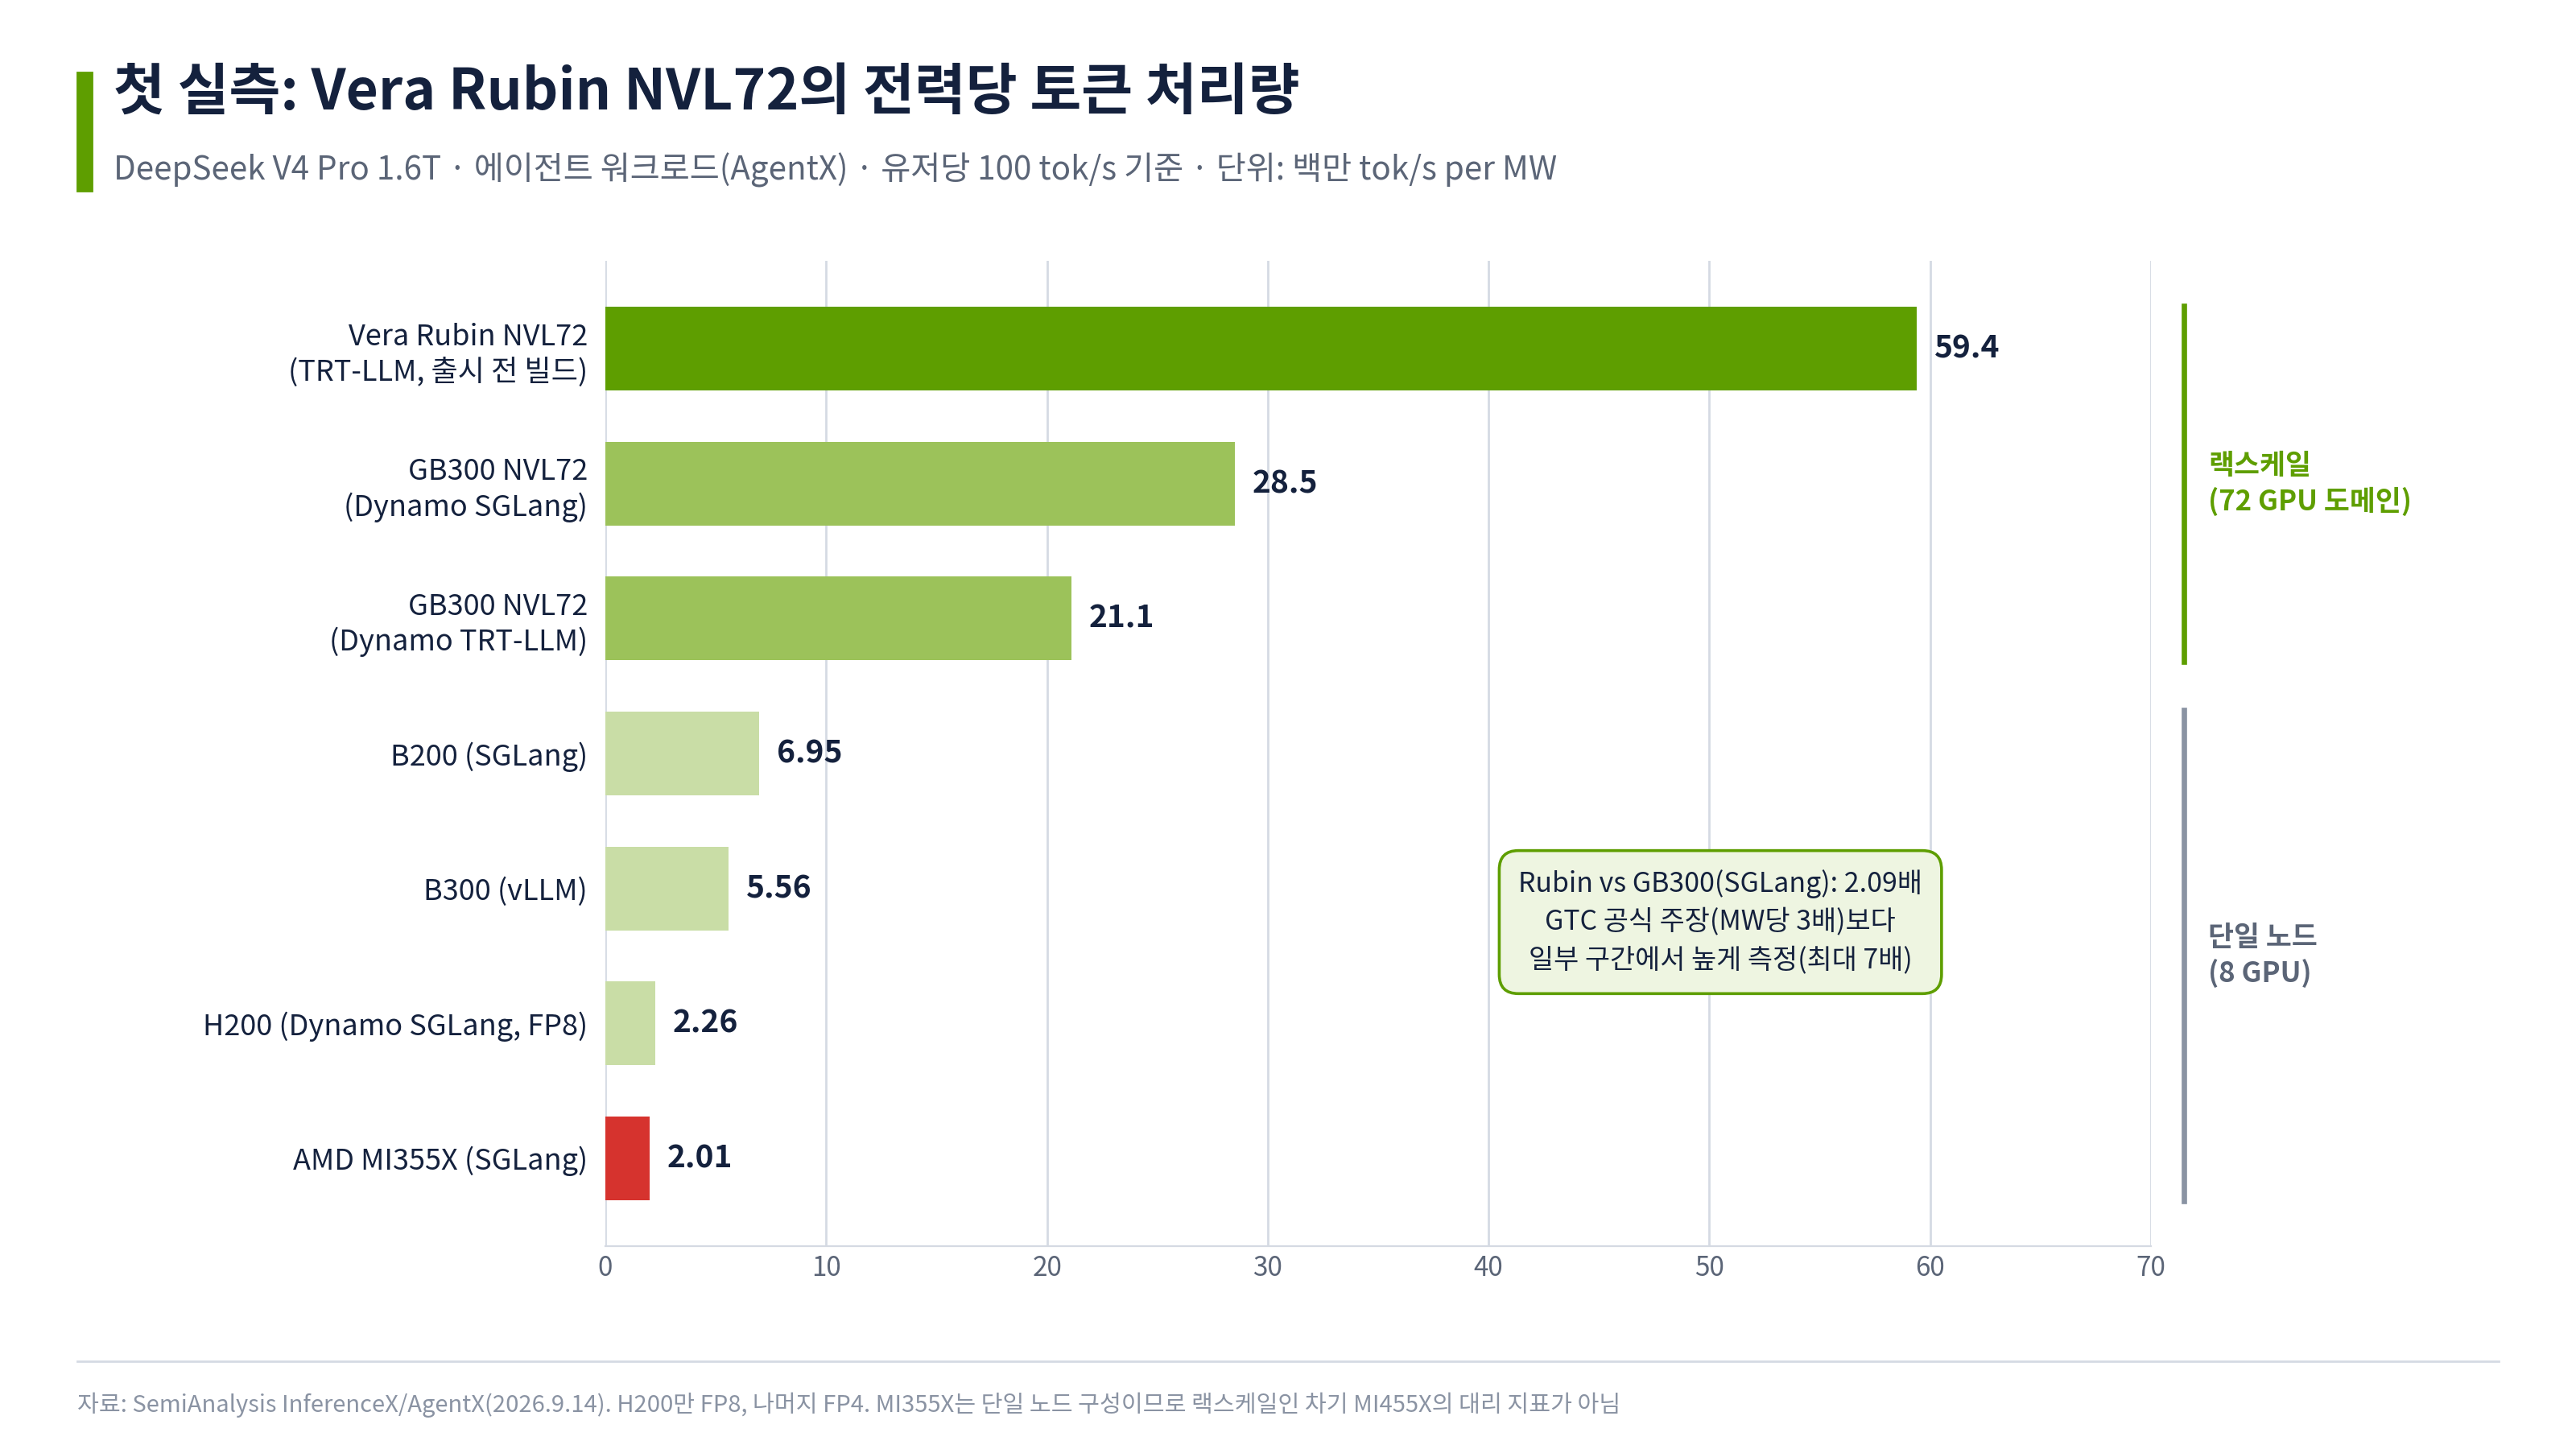
이 결과를 읽을 때 주의할 점이 세 가지 있다. 첫째, 출시 전 TRT-LLM 빌드로 측정했고 엔비디아 엔지니어들이 구동과 검증을 도왔다. 또 이 벤치마크는 하드웨어의 잠재력이 아니라 '지금 돌아가는 소프트웨어'의 실전 성능을 잰다. 분리 서빙과 신규 모델 지원이 가장 성숙한 엔비디아에 구조적으로 유리한 방식이고, 다른 진영의 수치는 소프트웨어가 다듬어지면서 올라올 여지가 있다. 둘째, 헤드라인에 쓰인 '67배'(TCO 기준)는 GB300 TRT-LLM 곡선이 끝나는 170tok/s 지점의 값이다. 같은 지점에서 GB300 SGLang과 비교하면 MW당 5.56배다.[10] 비교 대상의 소프트웨어 스택을 같이 읽어야 한다. 엔비디아가 8월 실적 발표에서 말한 'Blackwell Ultra 대비 MW당 30배' 같은 큰 배수도 마찬가지다.[6] 이런 수치는 대개 전 세대의 곡선이 끝나는 고속 구간에서 나오며, 서빙이 몰리는 구간의 배수와는 다르다. 셋째, 그림의 AMD MI355X는 8GPU 단일 노드 구성이다. Rubin과의 29.5배 차이는 칩의 차이가 아니라 대부분 '랙스케일 대 단일 노드'의 차이이며, AMD의 첫 랙스케일 제품인 MI455X의 대리 지표로 쓰면 안 된다.
가격도 봐야 한다. SemiAnalysis 조사에 따르면 7월 기준 3년 약정 임차료는 Rubin이 칩당 시간당 8.5달러 이상, Blackwell Ultra NVL72가 5달러다. 70% 비싸다. 그래도 유저당 80tok/s 조건에서 같은 임차 비용으로 토큰을 62% 더 생산한다는 것이 측정 결과다.[10] 비싸지만 더 싸게 먹히는 구조다. 다만 이 가격 프리미엄이 구매자들로 하여금 대안을 찾게 만드는 가장 큰 동기라는 점은 2부에서 다시 다룬다.
4. GPU의 약점을 다른 칩으로 메운다 - Groq 3 LPX
1장의 디코드 속도와 관련된 산식을 보면 GPU는 디코드에 최적인 칩이 아니다. 연산기는 남는데 메모리 대역폭이 모자란다. 엔비디아의 선택은 GPU를 디코드용으로 다시 설계하는 것이 아니라, 대역폭이 극단적으로 큰 다른 칩을 옆에 붙이는 것이었다.
Groq 3 LPU(LP30)는 삼성 파운드리 4nm에서 생산된다. 칩당 온칩 SRAM 약 500MB에 대역폭 150TB/s다. 용량은 Rubin의 HBM(288GB)의 수백 분의 일이지만 대역폭은 약 7배다. LPX 랙 하나에는 수랭 LPU 256개가 들어가고, 합계 SRAM 128GB, SRAM 대역폭 40PB/s, 칩 간 직결 링크로 구성한 스케일업 대역폭 640TB/s다. 큰 모델을 위해 랙당 DDR5 12TB가 보조로 붙는다.[11]
동작 방식이 흥미롭다. 프리필은 Rubin GPU가 맡고 KV 캐시를 넘긴다. 디코드에서는 매 토큰, 매 레이어마다 GPU와 LPU가 일을 나눈다. KV 캐시는 사용자마다 따로 쌓여 용량이 크다. 그래서 이것을 참조해야 하는 어텐션은 HBM을 가진 GPU가 맡고, 모두가 공유하는 가중치를 읽는 FFN(전문가) 층은 SRAM을 가진 LPU가 계산한다. LPU는 컴파일러가 256개 칩의 연산과 통신을 클록 사이클 단위로 미리 스케줄링하는 결정론적 실행 모델을 쓴다. 작업 배분은 엔비디아의 Dynamo가 맡는다. LPU는 실행 중에 순서가 바뀌는 일이 없도록, 컴파일러가 256개 칩의 연산과 통신 타이밍을 클록 단위까지 미리 정해 두는 '결정론적 실행' 방식을 쓴다. 어느 칩이 어떤 일을 맡을지는 엔비디아의 추론 서빙 소프트웨어 Dynamo가 배분한다. 표준적인 프리필-디코드 분리 구성에서는 LPX가 디코드 전체를 수행하는 모드도 있다.
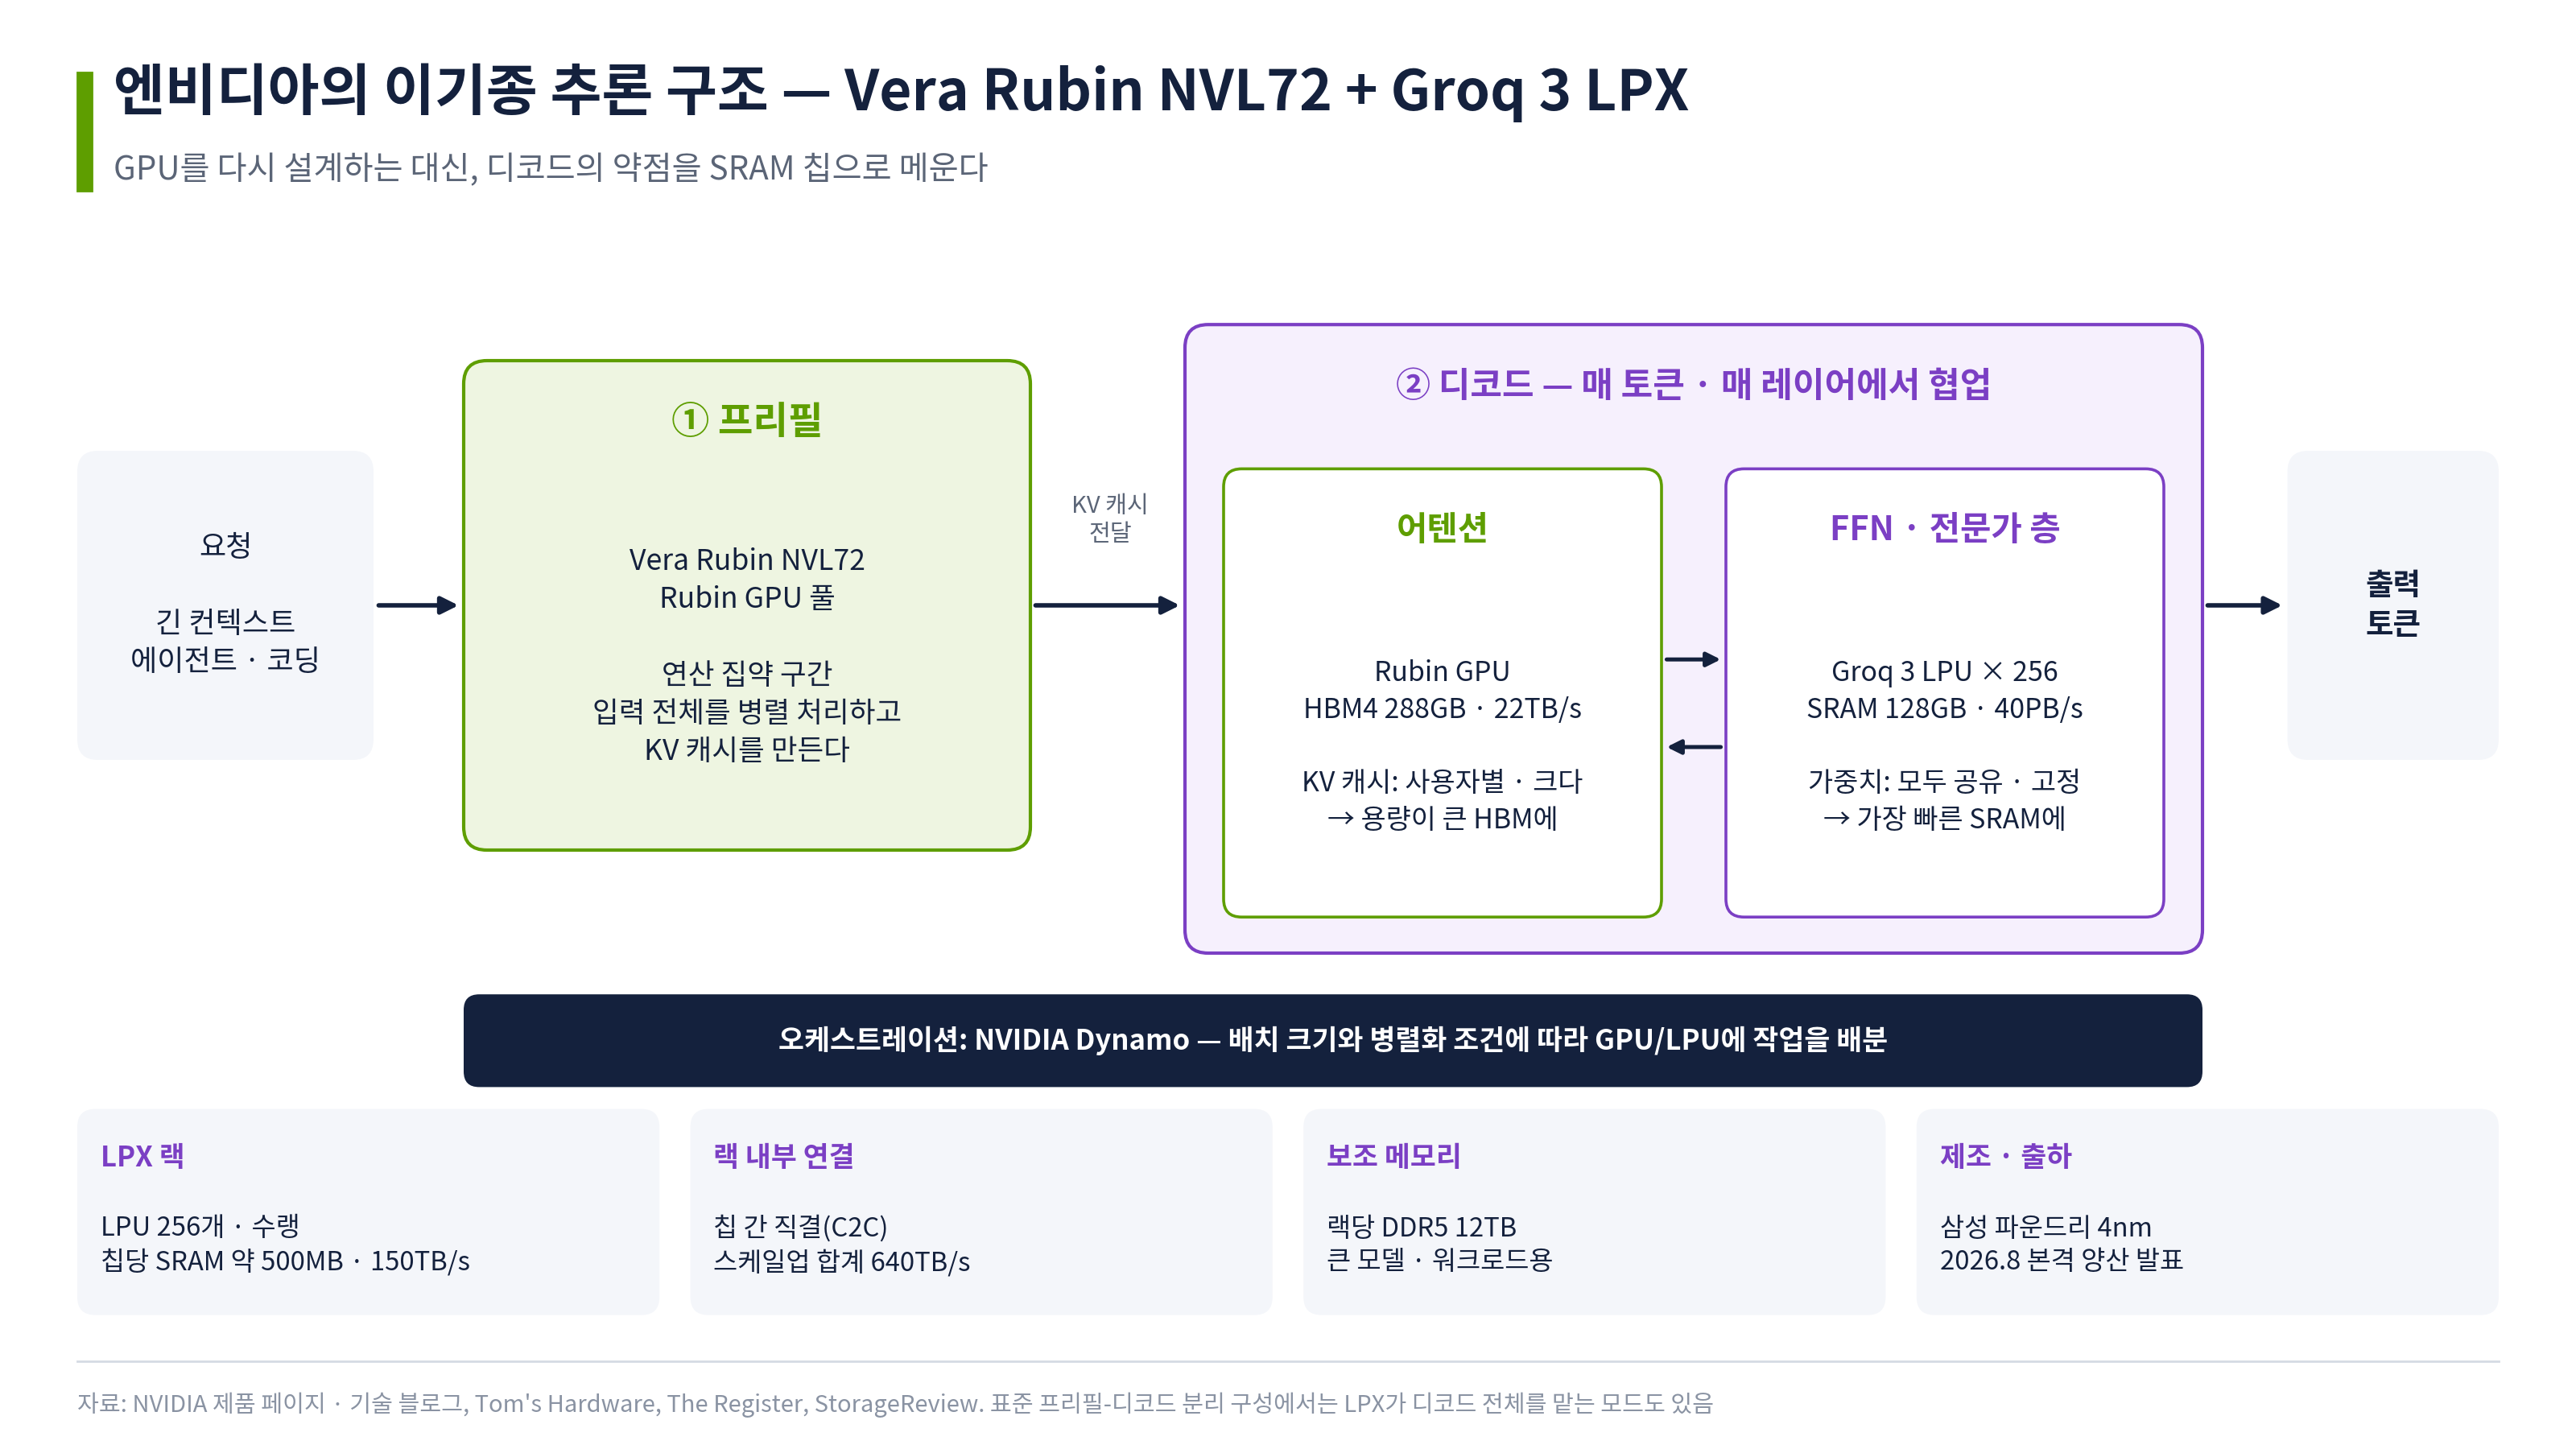
8월 24일 엔비디아는 LPX가 본격 양산에 들어갔다고 발표했다.[12] 첫 채택 클라우드는 네비우스(Nebius)이고 연내 가동 예정이다. 독립 법인으로 남은 그록도 델과 함께 LPX와 NVL72를 자사 추론 클라우드에 도입한다. 제3자 측정으로는 Artificial Analysis가 Gemma 4 31B, 10만 토큰 컨텍스트 조건에서 초당 3,431토큰을 기록했다고 밝혔다.[12] 젠슨 황은 GTC에서 코딩용 데이터센터 공간의 4분의 1을 Groq 칩에 배정하겠다고 말했다. 다만 8월 실적 발표에서는 LPX가 고속 응답이 필요한 서비스용이고 데이터센터의 대다수는 Vera Rubin NVL72를 쓸 것이라고 선을 그었다.[6] 회사 스스로 LPX를 주력이 아니라 특정 구간의 계층으로 규정한 셈이다.
여기서 읽을 것은 두 가지다. 첫째, 공개된 측정치는 310억 파라미터급 소형 모델 기준이다. 1조 파라미터급 MoE에서의 경제성은 아직 확인되지 않았고, 하이퍼스케일러의 채택 발표도 아직 없다. LPX가 표준 계층으로 자리 잡았다고 말하기에는 이르다. 둘째, GTC 로드맵에 따르면 후속 LPU에는 NVFP4와 NVLink 지원이 예고돼 있다. 지금은 별도 랙으로 붙어 있는 LPU가 세대를 거치며 GPU 패브릭 안으로 들어오는 방향이다. 국내 관점에서는 이 칩이 삼성 파운드리 4nm 물량이라는 점도 기억해 둘 만하다.
5. 균열 - 실리콘이 아니라 시스템에서 나오는 리스크
엔비디아의 리스크는 칩이 아니라 칩을 묶는 쪽에서 나오고 있다. 6~8월 사이 SemiAnalysis발 보도가 세 건 이어졌다.
첫째, 제조 실행 우려로 Rubin Ultra가 칩렛 4개 구성에서 2개 구성으로 바뀌었다는 보도다. 사실이라면 패키지당 연산은 원래 계획의 절반이다.[14] 둘째, Kyber NVL144 랙이 12개월 이상 밀려 2028년으로 넘어갔다는 보도다. 원인은 컴퓨트 트레이와 스위치 트레이를 케이블 없이 직결하는 PCB 미드플레인의 제조 난도다. 이 보드는 M9급 CCL과 쿼츠 직물, PTFE를 섞은 소재로 26층 기판 3장을 합친 78층 구조라고 알려져 있다.[13] 대안으로 검토된 NVL72x2(Oberon 랙 2개를 등을 맞대어 연결)는 대형 고객들의 반발로 폐기됐고, CPO로 랙 8개를 묶는 NVL576도 지연되거나 소량에 그칠 가능성이 제기됐다.[13] 셋째, 메모리 부족으로 용량을 192GB로 줄이거나, HBM4E 대신 HBM4를 쓰는 저용량 구성을 시험 중이라는 보도다.[14]
엔비디아는 "로드맵에 변동이 없다"는 한 줄 입장만 냈고 세부 질문에는 답하지 않았다. 따라서 위 내용은 확인되지 않은 보도로 다뤄야 한다. 다만 보도가 맞다면 함의는 분명하다. 2027년 엔비디아의 스케일업 도메인은 72개에 머문다. 1장에서 본 세 번째 레버가 한 해 동안 멈추는 것이다. 랙 구조의 한계는 전력에서도 확인된다. 궈밍치는 랙 전력이 200kW에 가까워지면 54V 배전이 공간과 효율에서 한계에 부딪힌다며 Vera Rubin NVL72를 지금의 Oberon 랙 구조로 만드는 마지막 세대로 봤다.[8] 다음 랙은 기판(6부)과 전력(5부)을 함께 바꿔야 하는데, 그 두 가지가 모두 새 랙인 Kyber에 걸려 있다.
메모리 쪽 압박은 공식 자료에서 더 분명하게 보인다. 3분기 매출총이익률 가이던스는 74.0%로 2분기(75.0%)보다 낮고, 경영진은 4분기에 71~72%에서 바닥을 찍은 뒤 FY28에는 72~73%에서 안정될 것이라고 밝혔다.[6] CFO는 원인으로 메모리의 '극단적인 가격 상황'을 직접 지목했고, 인상 폭이 기존 예상을 넘었으며 내년에는 더 오를 것이라고 말했다. FY28 1분기부터는 엔비디아도 제품 가격 인상을 반영한다. 공급 병목은 적어도 FY28 말까지 이어진다는 것이 회사의 전망이다.[6] SemiAnalysis는 양산 SKU의 CPU 메모리가 컴퓨트 트레이당 1.5TB로 당초 계획의 절반이라고 전했다.[10] HBM과 LPDDR 모두에서 '원하는 만큼 싣지 못하는' 상황이 제품 사양에 영향을 주기 시작했다는 뜻으로 읽힌다. 미드플레인과 메모리 문제는 각각 6부와 5부에서 자세히 다룬다.
6. AMD Helios - 유일한 머천트 대안의 첫 랙
AMD는 7월 23일 Advancing AI 2026에서 첫 랙스케일 시스템 Helios를 출시했다. Instinct MI455X 72개와 EPYC Venice CPU 18개를 묶었다. MI455X는 TSMC 2nm와 3nm 칩렛 12개로 구성되고 트랜지스터 3,200억 개, HBM4 432GB, 메모리 대역폭 최대 23.3TB/s다.[15] 랙 전체로 HBM4 31TB, FP4 2.9EF, 스케일업 대역폭 260TB/s다.[15] 랙 규격은 메타와 함께 만든 OCP Open Rack Wide(폭이 두 배인 개방형 랙)다. AMD는 Rubin NVL72 대비 달러당 추론 토큰이 최대 30% 많다고 주장한다.[15]
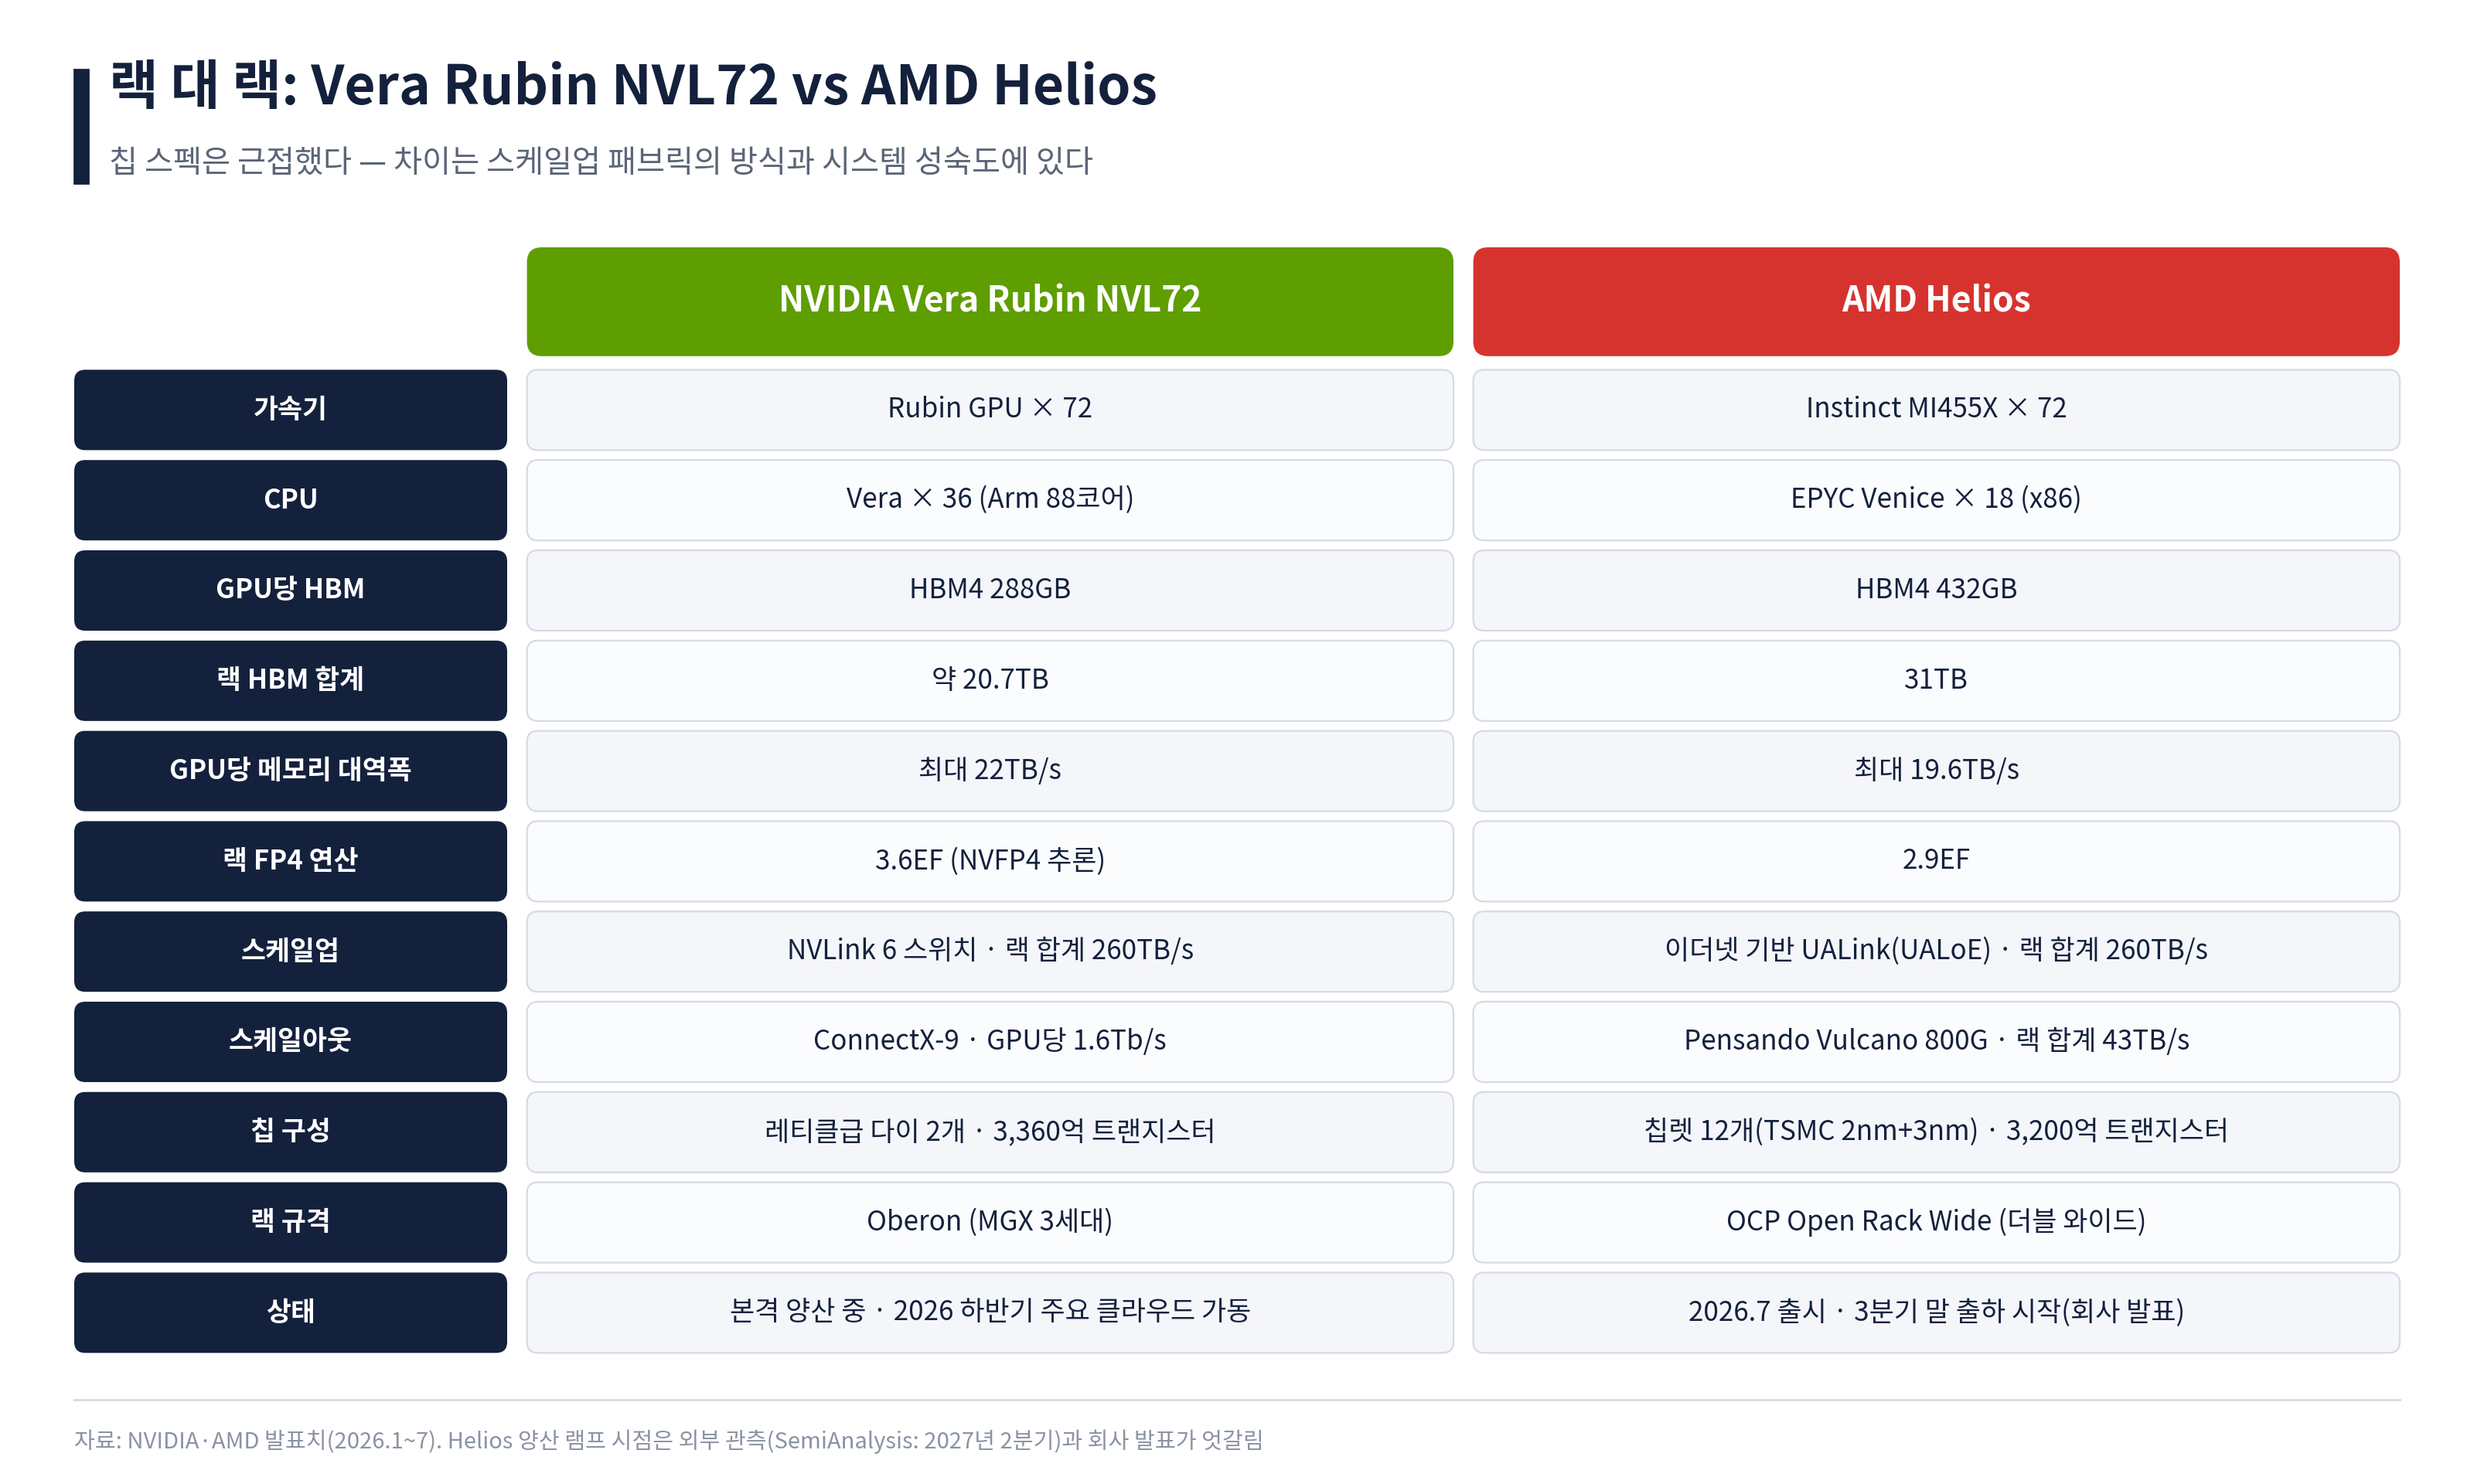
스펙표만 놓고 보면 두 랙은 놀랄 만큼 비슷하다. GPU 수가 같고, 스케일업 대역폭 합계가 같고, 연산은 Rubin이 앞서고 메모리 용량은 Helios가 50% 많다. 1장의 두 번째 레버(용량)에서 AMD가 앞선다는 점은 의미가 있다. 같은 랙에서 더 큰 배치, 더 긴 컨텍스트를 돌릴 수 있기 때문이다.
차이는 표에 드러나지 않는 곳에 있다.
첫째, 스케일업의 방식이다. 초기 Helios는 UALink 프로토콜을 이더넷 위에 올린 방식(UALoE)을 쓴다. 발표된 대역폭은 NVLink 6와 같지만, 전대전 통신의 실제 지연과 집합통신 성능은 실측이 나와야 알 수 있다. 1장에서 봤듯 MoE 추론에서 네트워크 부분이 가장 중요한 요소 중 하나다.
둘째, 일정에 대한 시각차다. AMD는 3분기 말 출하를 시작해 4분기에 램프한다고 밝혔고, OpenAI는 4분기부터 Helios를 가동한다고 했다. 반면 SemiAnalysis는 2월에 하반기에는 엔지니어링 샘플과 소량 생산에 그치고 양산 램프와 첫 프로덕션 토큰은 2027년 2분기라고 봤다.[2] 엔비디아도 첫 랙스케일 제품인 GB200 NVL72의 램프에서 여러 분기에 걸친 진통을 겪은 것으로 알려져 있다. 랙은 칩보다 훨씬 많은 것이 동시에 맞아야 하는 제품이다.
셋째, 소프트웨어의 '합성' 문제다. 직전 세대 기준으로 SemiAnalysis는 B200이 MI355X보다 전력당 토큰에서 약 20% 효율적이라고 측정했다.[2] 더 뼈아픈 지적은 "AMD의 추론 최적화는 각각은 잘 동작하지만 여러 개를 함께 켜면 기대만큼 성능이 나오지 않는다"는 것이었다. 분리 서빙, 와이드 EP, 추측 디코딩을 동시에 돌리는 것이 프런티어 연구소의 실제 운영 방식이므로 이 합성 능력이 곧 실전 성능이다. (분리 서빙은 프리필과 디코드를 다른 장비에 맡기는 것, 와이드 EP는 MoE 전문가를 아주 많은 칩에 펴 놓는 것, 추측 디코딩은 작은 모델이 먼저 지어낸 답을 큰 모델이 한꺼번에 검사하는 방식이다.) 공정하게 말하면 개선 속도는 빠르다. AMD는 동일 운용 조건에서 MI355X가 GB300과 대등하거나 앞서는 구간이 있고, 2월 이후 자사의 토큰당 비용이 크게 내려갔다고 반박했다.[17]
고객 명단은 화려하다. OpenAI와 메타가 각각 6GW, Anthropic이 2027년 상반기부터 최대 2GW(AMD는 Anthropic에 최대 50억 달러를 투자한다), 마이크로소프트가 애저에 대규모 도입, 오라클이 3분기부터 MI450 시리즈 5만 개를 도입한다.[16] 2분기 데이터센터 매출은 67억 달러(+107%)였고, AMD는 2027년 데이터센터 AI 매출이 수백억 달러에 이를 것이라고 말한다.[16] 다음 세대는 2027년 MI500(TSMC 2nm, HBM4E)과 Verano CPU이며, 구리와 광 인터커넥트를 함께 쓰고 스케일업 도메인을 넓힌다. AMD는 매년 새 랙스케일 플랫폼을 내겠다고 했고 [15] 로드맵은 2030년 MI600까지 제시돼 있다. 다만 "MI300X 대비 1,000배"라는 MI500의 성능 주장은 8GPU 노드와 GPU 수를 밝히지 않은 랙을 비교한 수치라서 그대로 받아들이기 어렵다.[18]
7. 엔비디아는 무엇으로 이기고, AMD는 무엇을 증명해야 하나
엔비디아의 해자는 이동했다. 과거의 해자가 CUDA라는 프로그래밍 생태계였다면, 지금의 해자는 '랙 단위 공동설계'와 '분리 서빙 소프트웨어'다. 3장의 실측에서 Rubin이 GB300을 2~7배 앞선 것은 칩 하나가 빨라서가 아니라 메모리, 스케일업, 소프트웨어가 한 세대에 같이 움직였기 때문이다. 여기에 LPX로 초저지연 계층까지 붙였다. 학습, 프리필, 디코드, 그리고 CUDA가 필요한 롱테일 고객까지 한 플랫폼으로 담당할 수 있는 회사는 여전히 엔비디아뿐이다.
약점도 분명하다. 패키지당 2.3kW까지 올라간 전력, 보도대로라면 2027년에 72개에서 멈추는 스케일업 도메인, HBM과 LPDDR 수급에 묶인 사양과 마진, 그리고 70%의 가격 프리미엄이다. 앞의 셋은 경쟁자에게 기술적 틈을 열어 주고, 마지막은 구매자에게 그 틈을 이용할 동기를 준다.
AMD의 기회는 기술 추월에 있지 않다. 스펙은 이미 동급이다. 기회는 엔비디아의 시스템 실행 공백과 구매자의 다변화 욕구가 겹치는 자리에 있다. 그 자리를 차지하려면 네 가지를 증명해야 한다. ① 연내에 대규모 고객 환경에서 프로덕션 토큰이 실제로 나오는 것, ② UALoE의 전대전 통신 성능이 실측으로 확인되는 것, ③ 최적화들을 함께 켰을 때 성능이 유지되는 것, ④ 도메인을 넓힌 MI500이 Kyber 공백기에 맞춰 나오는 것이다. 넷 중 ①이 가장 먼저 판가름 난다. 10~11월 실적 발표에서 OpenAI의 가동 여부가 첫 판정 지점이다.
시나리오로 정리하면 이렇다. Helios가 4분기에 안정적으로 가동되면 AMD는 '두 번째 머천트 공급자'로 굳어지고, 2027년 MI500으로 도메인 크기에서 엔비디아를 앞서는 구간이 생길 수 있다. 반대로 램프가 2027년 2분기로 밀리면 6GW, 2GW 같은 숫자는 계약이 아니라 옵션에 가까워지고, 그 사이 구매자의 다변화 예산은 2부에서 볼 자체 칩 쪽으로 흘러간다. 필자는 현시점에서 후자 쪽에 조금 더 무게를 둔다. 첫 랙스케일 제품의 램프는 엔비디아에게도 여러 분기가 걸린 일이었기 때문이다.
<투자 관점 체크포인트>
- 가속기의 경쟁력은 칩 스펙이 아니라 '유저당 속도 구간별 MW당 토큰'과 'TCO당 토큰' 곡선으로 확인해야 한다. 공개 벤치마크에 MI455X와 TPU 계열이 올라오는 시점이 비교의 분기점이다.
- 엔비디아는 점유율보다 공급 제약(HBM, 패키징, 랙 부품)이 실적 변수다. 매출총이익률이 회사가 제시한 경로(3분기 74% → 4분기 71~72% → FY28 72~73%)를 따라가는지와 재고 추이가 선행 지표다.
- LPX의 의미는 부착률에 달려 있다. 하이퍼스케일러 채택 발표와 대형 MoE에서의 실측이 나오기 전까지는 옵션 가치로 본다.
- AMD는 주문이 아니라 가동이 지표다. 4분기 OpenAI의 Helios 가동 여부와, 다른 대형 고객의 실제 배치 발표를 확인한다.
- Kyber 관련 보도의 진위는 GTC 2027 전후의 양산 일정 발표에서 드러난다. 이는 6부에서 다룰 PCB/CCL 밸류체인의 시점 변수이기도 하다.
<Conclusion>
추론의 산수는 단순하다. 디코드 속도는 한 도메인에 묶인 메모리 대역폭의 합이 정하고, 그 합을 키우는 레버는 대역폭, 용량, 스케일업 세 가지다. 엔비디아는 Vera Rubin에서 세 레버를 한 세대에 같이 올렸고 첫 실측으로 그 효과를 보여 줬다. GPU의 구조적 약점인 디코드는 SRAM 칩을 붙여 메웠다. 대신 리스크는 실리콘 바깥, 즉 랙과 메모리 수급으로 옮겨 갔다. AMD는 칩 스펙에서 동급에 도달했고 고객 명단도 확보했다. 남은 것은 첫 랙을 제때, 대규모로, 소프트웨어까지 맞물려 돌리는 일이다. GPU 진영의 승부는 이제 설계가 아니라 실행에서 갈린다.
<2부 예고>
2부에서는 GPU 외의 가속기를 본다. 먼저 GPU, ASIC, NPU가 무엇이 다른지 정리하고, '얼마나 좁은 일에 맞췄는가'를 기준으로 줄을 세운다. 브로드컴을 통로로 한 맞춤형 칩(구글 TPU, OpenAI Jalapeño, AWS Trainium, 마이크로소프트 Maia, 메타 MTIA), 소프트웨어로 용도를 바꿀 수 있는 Tenstorrent·SambaNova·퀄컴, 아예 회로에 새겨 버린 Etched·Taalas, 메모리 안에서 계산하는 d-Matrix, SRAM 계열의 세레브라스와 LPU, 화웨이와 국내 NPU까지 각자의 설계 철학과 최신 발표를 함께 본다. 마지막으로 구매자별 채택 현황을 정리하고, 2028년까지 AI 시스템이 어떤 형태로 구성될지 전망한다.
<Reference>
[1] [1] OpenAI Hot Chips 2026 Jalapeño 발표 - Tom's Hardware https://www.tomshardware.com/tech-industry/artificial-intelligence/hot-chips-2026-openais-jalapeno-ai-asic-unpacked-accelerator-developed-using-ai-achieves-efficiency-and-throughput-gains-against-power-hungry-blackwell https://www.trendforce.com/news/?p=63134
[2] SemiAnalysis, “InferenceX v2: NVIDIA Blackwell Vs AMD vs Hopper”, 2026.2.16. https://newsletter.semianalysis.com/p/inferencex-v2-nvidia-blackwell-vs
[3] DCD, “Nvidia updates data center product roadmap following LPU launch at GTC 2026”, 2026.3.20. https://www.datacenterdynamics.com/en/news/nvidia-updates-data-center-product-roadmap-following-lpu-launch-at-gtc-2026/
[4] 엔비디아–그록 비독점 라이선스 계약 관련 발표 및 CNBC 등 보도, 2025.12.24.
[5] NVIDIA, “NVIDIA Announces Financial Results for Second Quarter Fiscal 2027”, 2026.8.26. https://nvidianews.nvidia.com/news/nvidia-announces-financial-results-for-second-quarter-fiscal-2027
[6] NVIDIA FY27 2분기 컨퍼런스콜 트랜스크립트(The Motley Fool), 2026.8.26. https://www.fool.com/earnings/call-transcripts/2026/08/31/nvidia-nvda-q2-2027-earnings-call-transcript/
[7] NVIDIA 기술 블로그, “NVIDIA Vera Rubin POD: Seven Chips, Five Rack-Scale Systems, One AI Supercomputer”, 2026.3.16. https://developer.nvidia.com/blog/nvidia-vera-rubin-pod-seven-chips-five-rack-scale-systems-one-ai-supercomputer/ — Rubin GPU·NVL72 사양은 NVIDIA 제품 자료와 Tom's Hardware 정리(2026.1~3) 기준.
[8] 궈밍치(Ming-Chi Kuo), Vera Rubin/VR200 NVL72 공급망 점검(X 게시글), 2026.1.6. https://x.com/mingchikuo/status/2008439734536986852
[9] Vera Rubin 초기 가동 관련 보도: DCD(2026.3.20, 마이크로소프트) 및 업계 보도(2026.6~7, 코어위브·구글 클라우드·오라클 클라우드).
[10] SemiAnalysis, “Vera Rubin NVL72 Agentic Inference: 67x better Performance per Dollar”, 2026.9.14. https://newsletter.semianalysis.com/p/vera-rubin-nvl72-agentic-inference
[11] NVIDIA Groq 3 LPX 제품 페이지·기술 블로그, Tom's Hardware(삼성 4nm 생산), StorageReview, The Register, 2026.3~8.
[12] CNBC, Groq 3 LPX 본격 양산 및 네비우스 채택 보도(Artificial Analysis 측정치 포함), 2026.8.24.
[13] Tom's Hardware, “Nvidia's Kyber rack for Rubin Ultra reportedly delayed to 2028 …”(SemiAnalysis 인용), 2026.7.6. https://www.tomshardware.com/pc-components/gpus/nvidias-kyber-rack-for-rubin-ultra-slips-to-2028
[14] Tom's Hardware, Rubin Ultra 듀얼 칩렛 전환 보도(2026.6) 및 저용량 메모리 구성 시험 보도(2026.8) — 모두 SemiAnalysis 인용.
[15] AMD, Helios 제품 페이지 https://www.amd.com/en/products/rackscale-solutions/helios.html 및 Advancing AI 2026 발표(2026.7.23, Converge Digest·Fierce Network 정리).
[16] AMD 2026년 2분기 실적 발표(2026.8) 및 고객 발표 관련 보도(OpenAI·메타·Anthropic·마이크로소프트·오라클; DCD·Fierce Network 등).
[17] AMD 기술 블로그, InferenceX 결과에 대한 설명, 2026.3.
[18] Tom's Hardware, AMD MI500 ‘1,000배’ 성능 주장 분석, 2026.1.이 글은 공개 자료를 바탕으로 한 개인적인 공부 기록이며 투자 권유가 아닙니다. 투자 판단과 책임은 본인에게 있습니다.
반응형'최신 기술동향 > 2차전지 & 반도체' 카테고리의 다른 글
[AI 데이터센터 반도체 3부] AI 칩은 왜 만들기 어려운가 (0) 2026.09.25 [AI 데이터센터 반도체 2부] AI 가속기 (ASIC, NPU) (0) 2026.09.24 AI 전력 병목의 단기 해법, ESS와 LFP - 비중국 밸류체인은 가능한가 (1) 2026.08.08 2차전지의 무게중심 이동 - EV 캐즘, AI 전력난, 그리고 ESS의 시간 (1) 2026.08.01 유리기판 생태계와 기술적 허들 (1) 2026.07.14