-
[AI 데이터센터 반도체 3부] AI 칩은 왜 만들기 어려운가최신 기술동향/2차전지 & 반도체 2026. 9. 25. 08:00
AI 칩 회사가 넘어야 하는 허들 (e.g., 공급망, 랙 단위 검증)이 여러 개 있는데, RTL 설계는 그중 하나일 뿐이다. 뒤로 갈수록 돈이나 기술로 푸는 문제가 아니라 남이 허락해야 넘을 수 있는 관문이 나온다. 그래서 팹리스의 경쟁력은 단일 칩의 성능이 아니라 '어느 관문을 넘어섰는가'로 매겨진다.
1. 1~2부 요약, 그리고 3부의 질문
1부와 2부에서는 완성된 제품을 비교했다. Rubin과 Helios의 랙, TPU와 Jalapeño의 전력 예산 배분, 세레브라스와 LPU의 메모리 선택을 나란히 놓고 누가 무엇을 잘하는지 봤다. 3부는 그 앞 단계를 본다. 많은 업체들이 빠르게 성장하는 시장에서 제품을 출시하고 있지만, 성공하는 업체들은 극소수다. 그렇다면, 그 제품을 만들어 내는 일 자체가 왜 어려운가, 그리고 그 어려움을 넘는 능력을 무엇이라고 부를 수 있는가.
이 질문이 필요한 이유는 두 가지다. 하나는 1~2부에서 본 실패와 지연의 지점이 대부분 '칩 설계'가 아니었다는 것이다. 다른 하나는 투자 관점에서 IR 자료의 성능 수치가 무엇을 증명하고 무엇을 증명하지 않는지 구분해야 하기 때문이다. 참고로 이 글에 자주 나오는 팹리스는 공장 없이 설계만 하는 반도체 회사를 뜻한다. 엔비디아도, 국내 NPU 회사들도 모두 팹리스이고, 제조는 TSMC 같은 파운드리에 맡긴다.
2. AI 칩 회사가 넘어야 할 허들
"AI 칩을 만들기 어려운 이유"를 물으면 대개 설계 이야기가 나온다. 그런데 이 시리즈에서 본 사례들을 다시 보면 실패한 지점은 설계가 아닌 경우가 더 많았다. 1부의 Kyber는 칩이 아니라 기판에서 막혔고, AMD는 칩 사양이 아니라 소프트웨어를 함께 켰을 때의 성능에서 지적받았으며, 2부의 독립 NPU들은 칩 효율은 확보했지만 도메인을 묶지 못해 시장이 제한됐다. 그래서 질문을 이렇게 바꾸는 편이 낫다. AI 칩 회사가 제품을 팔기까지 통과해야 하는 관문은 무엇이고, 각 관문은 누가 통제하는가.
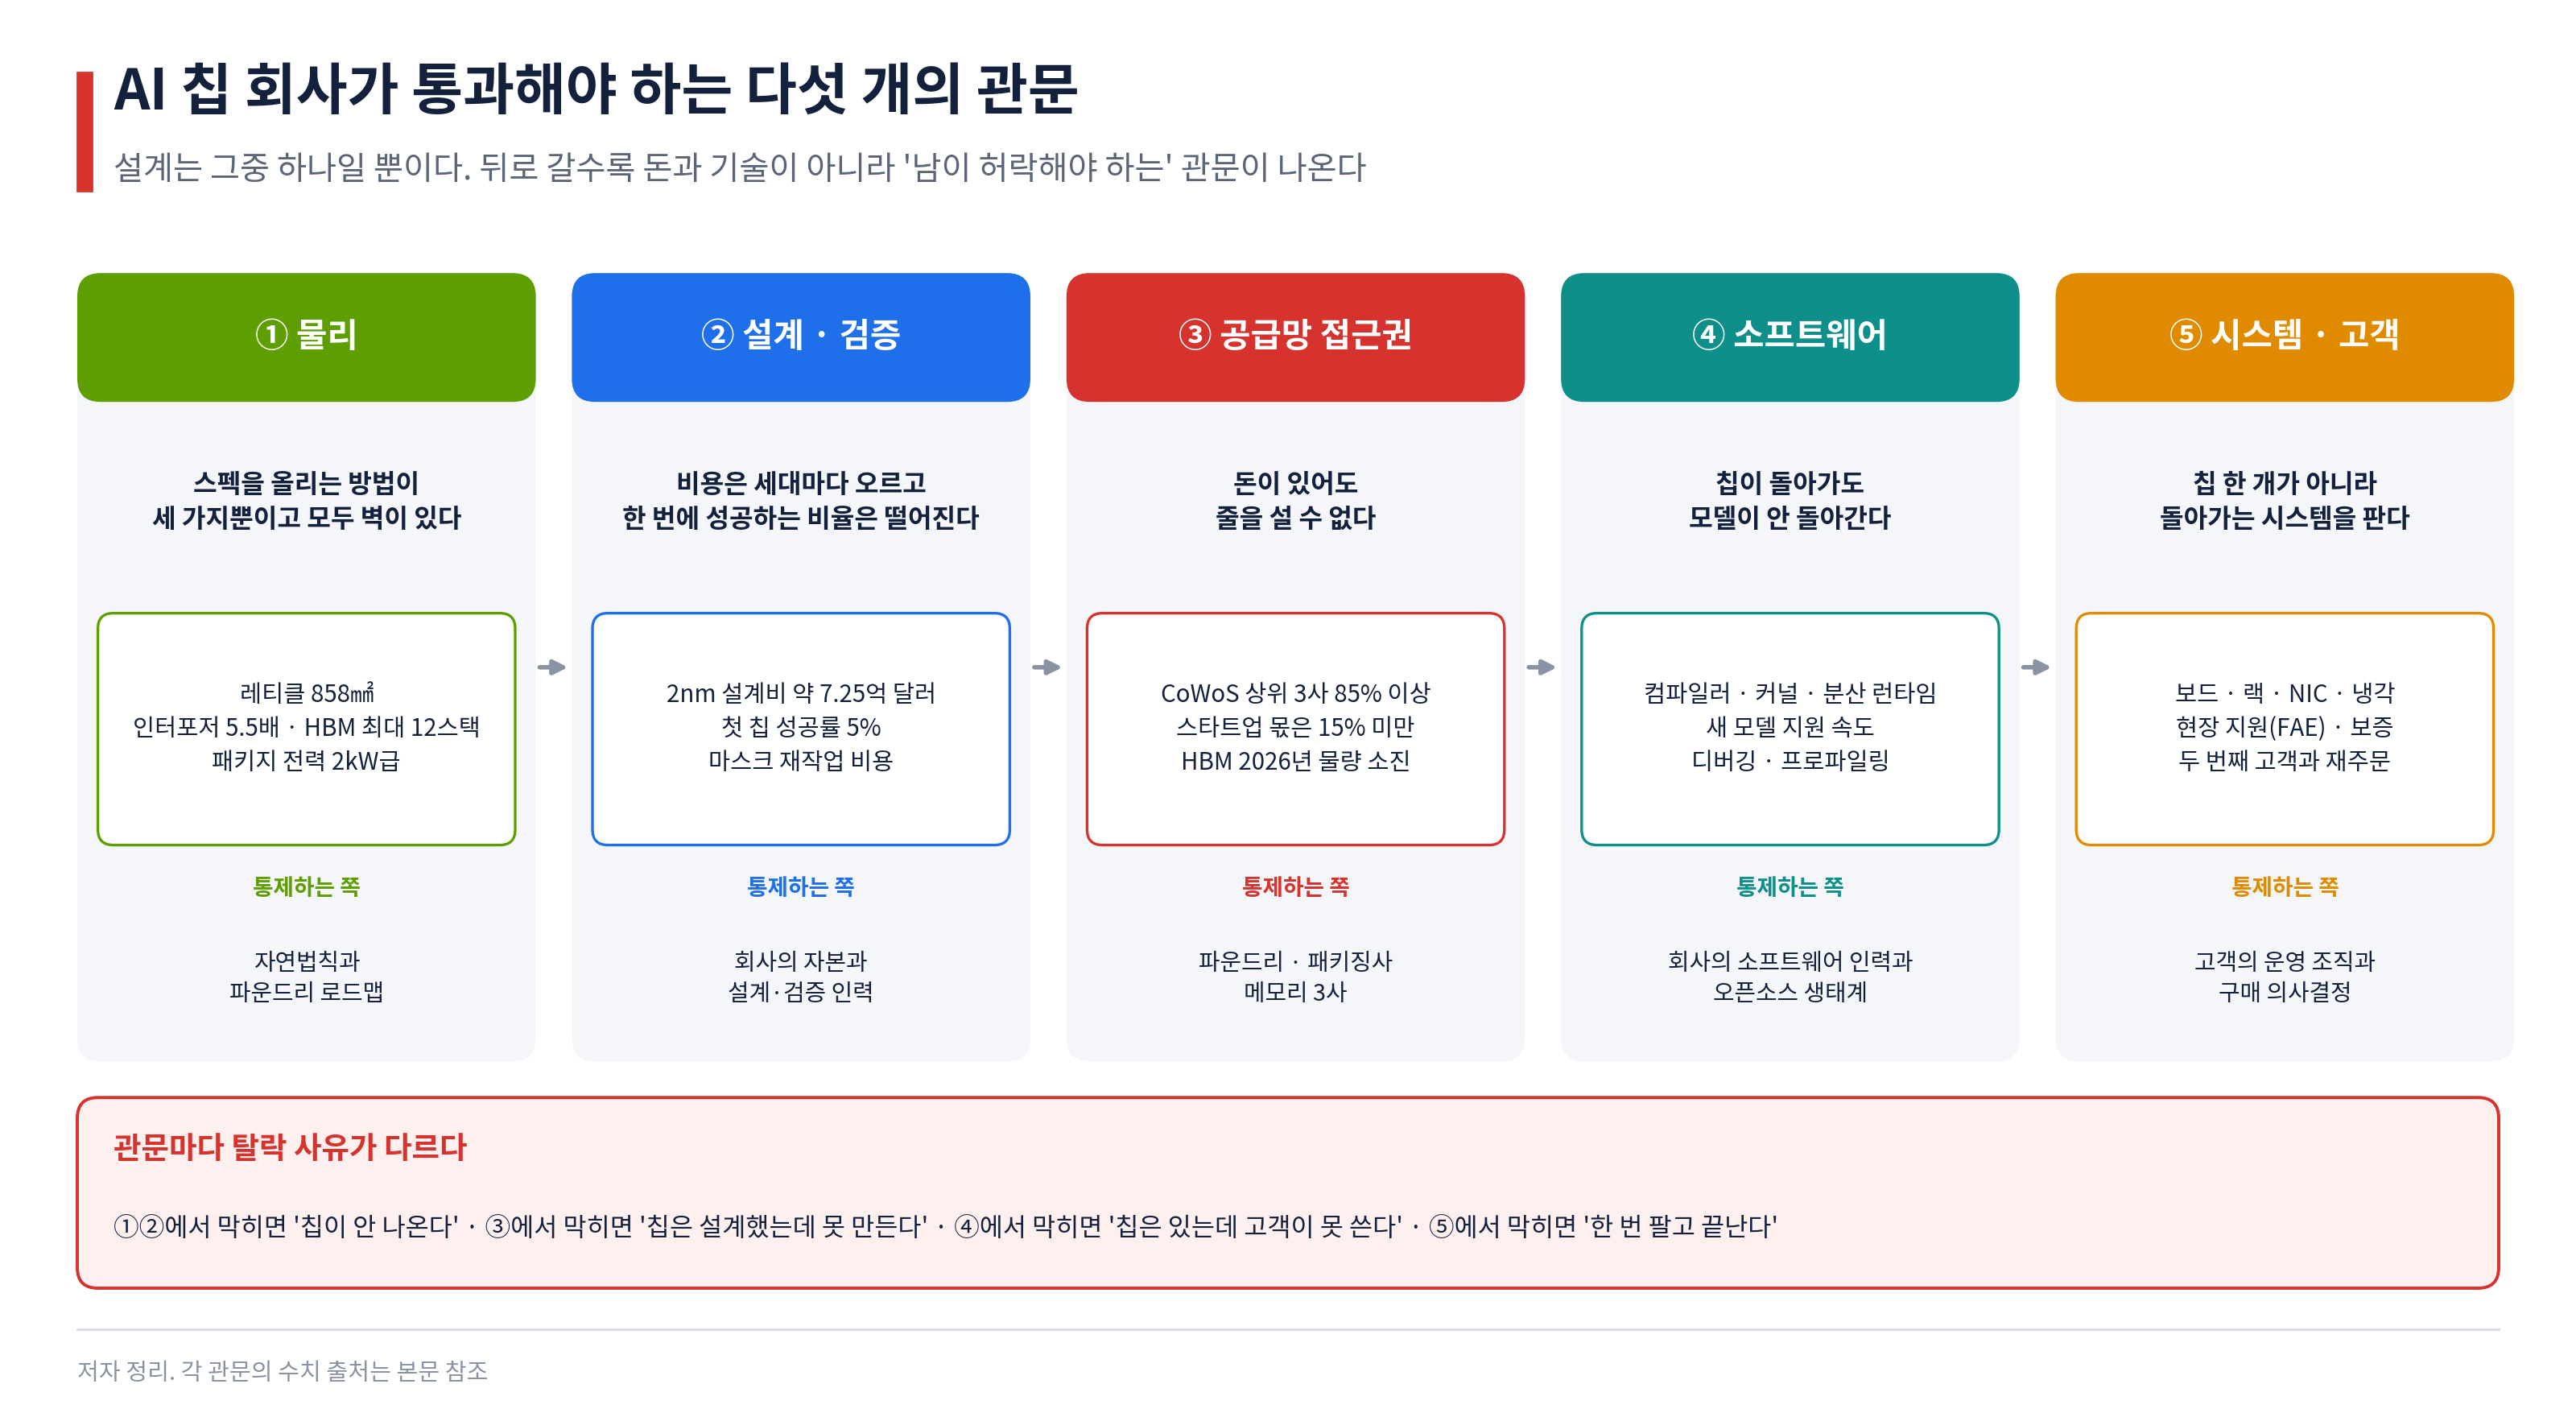
다섯개의 허들은 물리, 설계·검증, 공급망 접근권, 소프트웨어, 시스템·고객이다. 앞의 둘은 자본과 인력으로 푸는 문제다. 세 번째부터는 다르다. 공급망 접근권은 파운드리와 메모리 회사가, 시스템과 고객은 구매자의 운영 조직이 쥐고 있다. 돈이 있어도 줄을 설 수 없고, 칩이 좋아도 고객의 운영 조직이 받아 주지 않으면 팔리지 않는다.
허들마다 탈락하는 모양도 다르다. ①②에서 막히면 칩이 안 나온다. ③에서 막히면 칩은 설계했는데 못 만든다. ④에서 막히면 칩은 있는데 고객이 못 쓴다. ⑤에서 막히면 한 번 팔고 끝난다. 뒤의 세 가지는 투자 판단에서 자주 간과되는데, 앞의 두 관문을 통과한 회사에만 닥치는 문제라서 겉으로는 '기술이 검증된 회사'처럼 보이기 때문이다.
3. 허들 ① 물리 - 스펙을 올리는 방법은 세 가지뿐이다
1부에서 가속기의 성능이 연산, 메모리 대역폭, 스케일업으로 정해진다고 했다. 그 숫자를 올리려면 물리적으로 할 수 있는 일이 세 가지뿐이고, 셋 다 이미 벽에 닿아 있다.
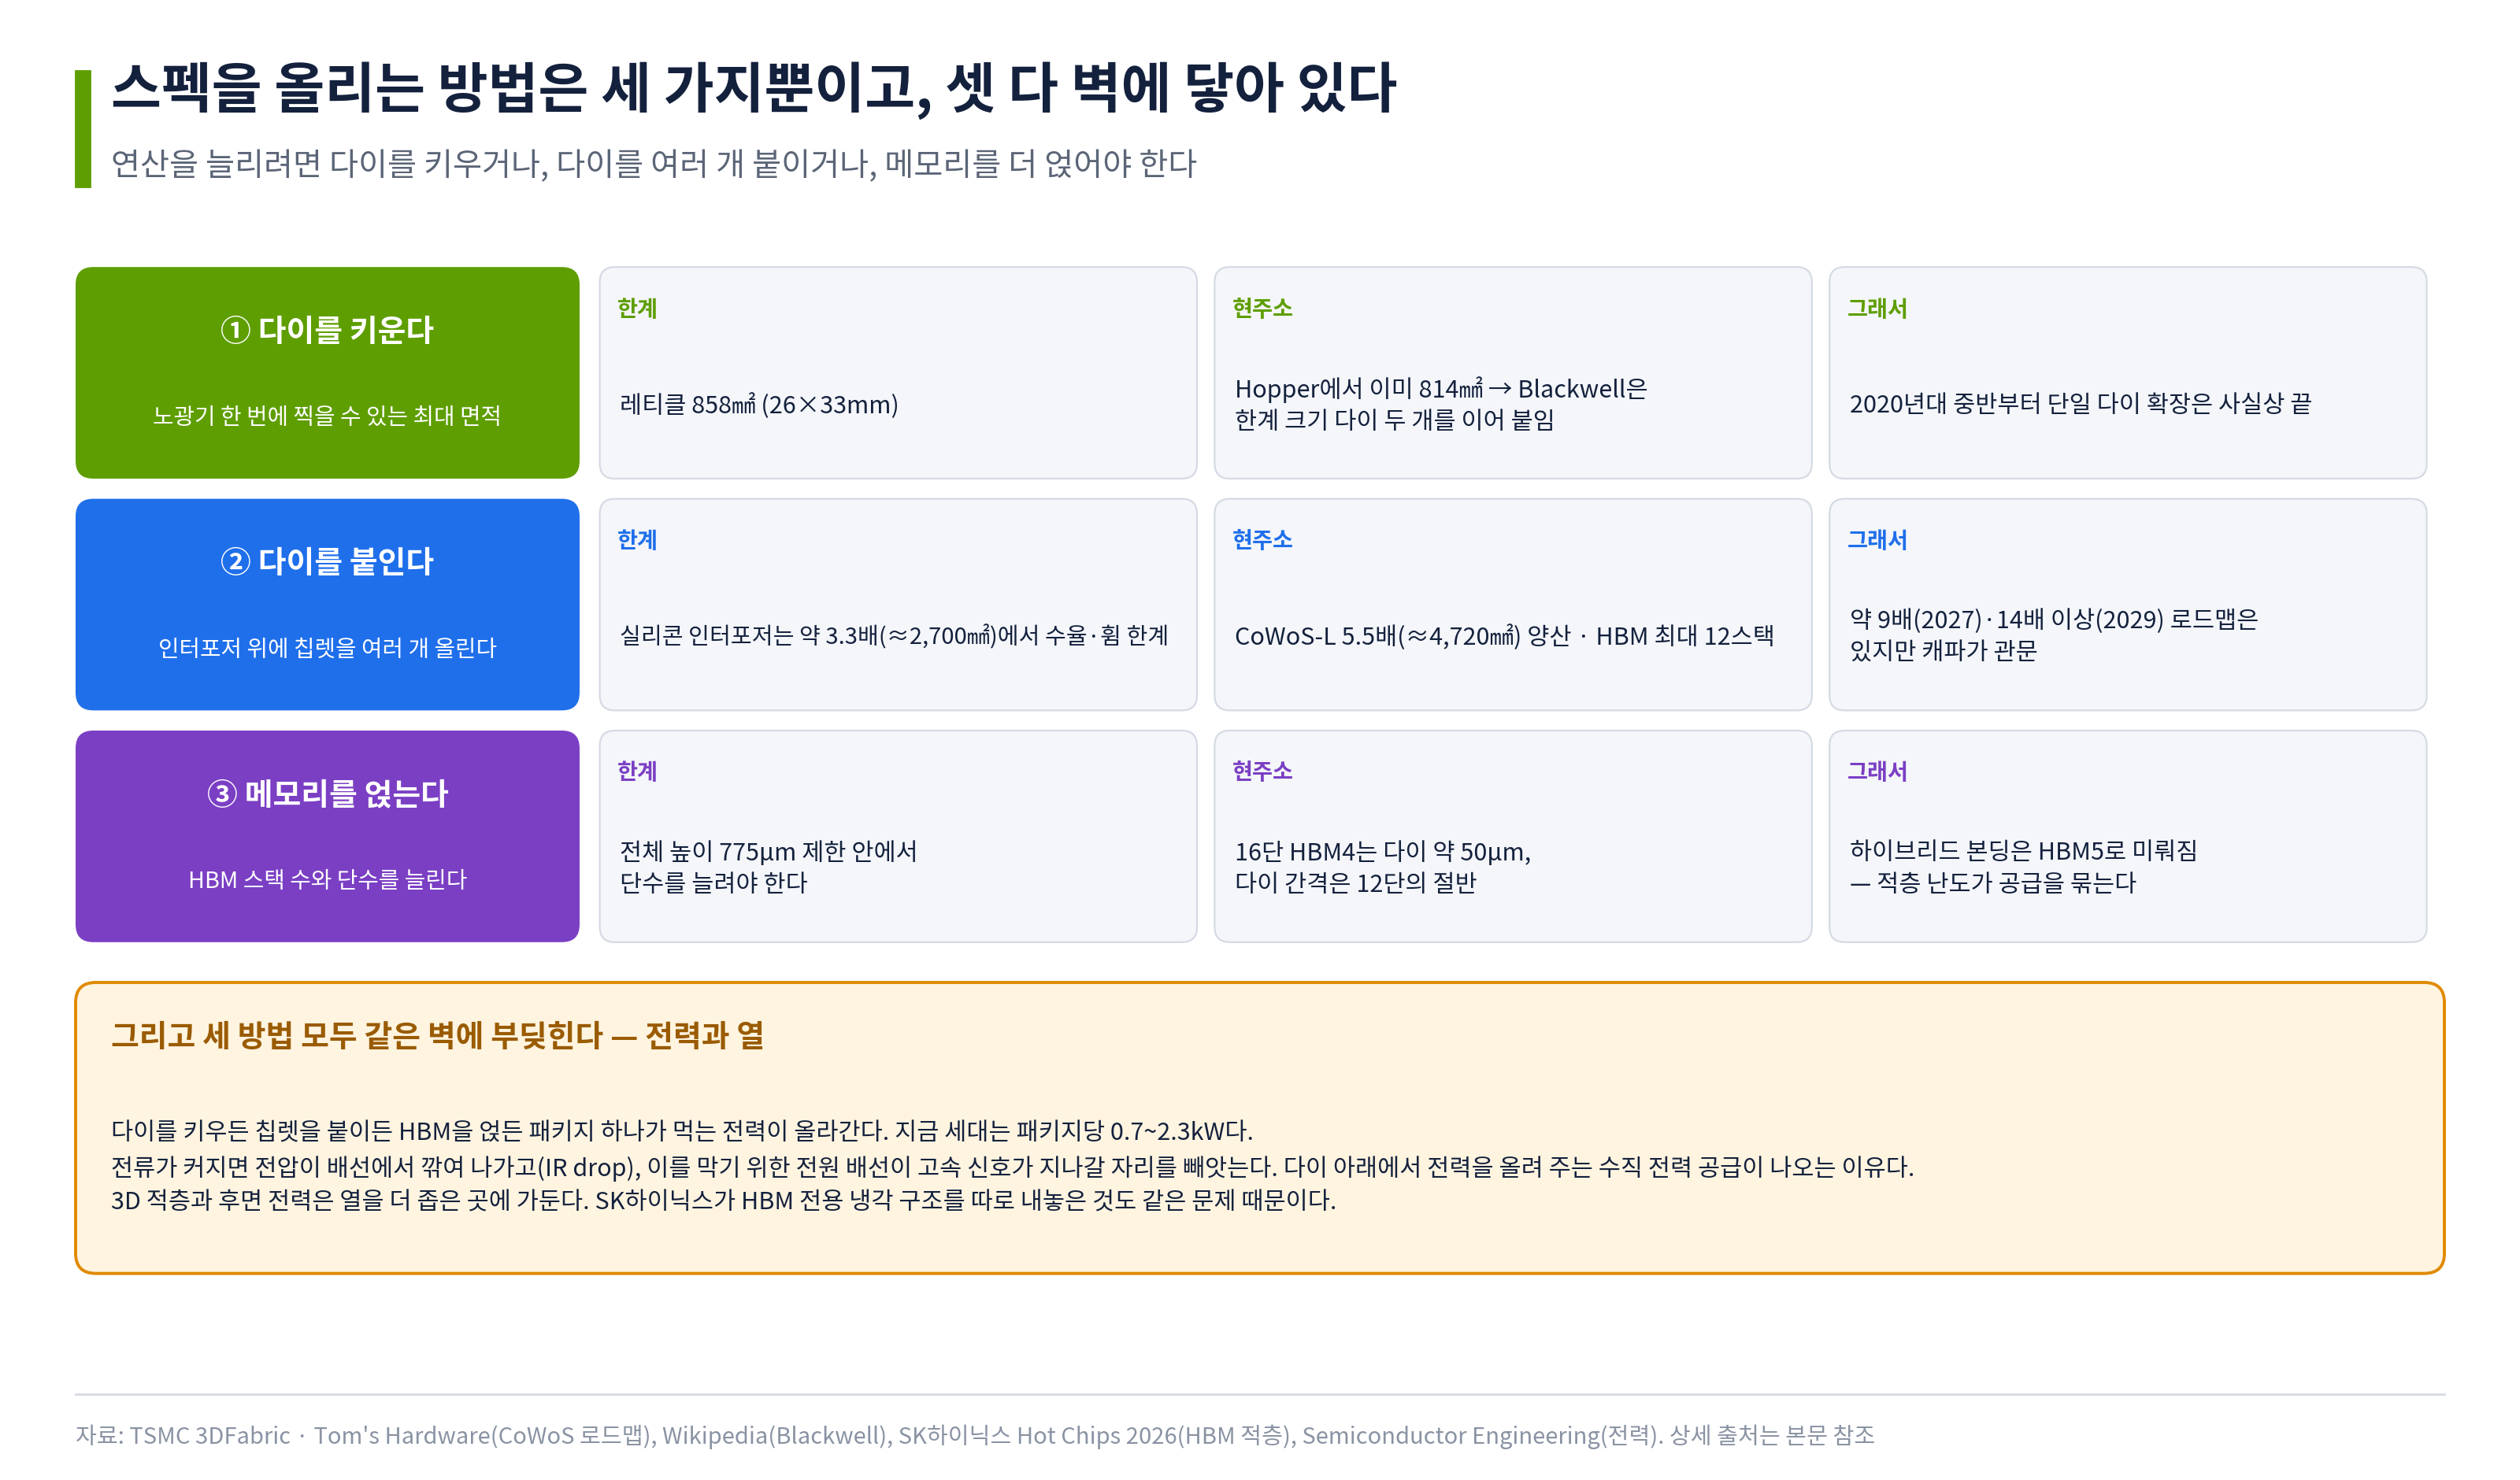
첫째, 다이를 키운다. 칩은 원판(웨이퍼) 위에 회로를 찍어 낸 뒤 네모나게 잘라 내는데, 그 한 조각을 다이라고 한다. 회로를 찍는 장비(노광기)가 한 번에 찍을 수 있는 최대 면적이 정해져 있고 이것을 레티클 한계라고 부른다. 약 858㎟(26×33mm)다.[1] 엔비디아의 데이터센터 GPU는 이미 여러 세대 전부터 이 한계에 붙어 있었다. Hopper(GH100) 다이가 814㎟였고, Blackwell에서는 한계 크기의 다이 두 개를 이어 붙여 하나처럼 쓰는 쪽으로 넘어갔다.[1] 단일 다이를 키우는 방식은 사실상 끝났다. 게다가 다이가 커질수록 그 안에 결함이 하나라도 들어갈 확률이 올라간다. 웨이퍼에서 건진 정상품의 비율을 수율이라고 하는데, 큰 칩일수록 수율이 떨어지고 버리는 값도 비싸진다.
둘째, 다이를 여러 개 붙인다. 큰 칩 하나 대신 작은 칩 여럿으로 나눈 것이 칩렛이고, 그 칩렛들을 얹어 서로 이어 주는 받침판이 인터포저다. 인터포저 위에 연산 칩과 HBM을 함께 올려 붙이는 TSMC의 방식이 CoWoS다. 여기에도 한계가 있다. TSMC는 통짜 실리콘 인터포저(CoWoS-S)를 레티클의 약 3.3배(약 2,700㎟)까지로 안내하고, 그보다 크면 실리콘 브리지를 섞는 CoWoS-L을 권한다.[1] 받침판이 커질수록 결함이 들어갈 확률이 높아지고, 커다란 판이 열을 받으면 휘어서 위에 붙인 칩들의 접점이 어긋나기 때문이다. 소재마다 열에 늘어나는 정도가 달라 패키지가 휘는 이 현상을 휨(워피지)이라고 부른다. 현재 CoWoS-L은 레티클의 5.5배에 HBM4를 최대 12스택까지 얹고, TSMC는 2027년 약 9배, 2029년 14배 이상의 로드맵을 내놨다.[1] 다만 뒤에서 볼 캐파 문제 때문에 로드맵이 곧 접근권은 아니다.
셋째, 메모리를 더 얹는다. HBM은 D램을 여러 층으로 쌓아 한 덩어리로 만든 메모리다. 패키지에 붙이는 덩어리 수(스택 수)와 한 덩어리의 층수(단수)를 늘리는 것이 방법이다. 한국반도체산업협회 안기현 전무는 "12단에서 16단으로 가는 것이 8단에서 12단으로 가는 것보다 기술적으로 훨씬 어렵다"고 말했다.[2] 이유는 높이 제한이다. HBM 한 덩어리의 전체 높이는 775μm(300mm 로직 웨이퍼 두께)로 묶여 있어서, 층을 늘리려면 다이를 더 얇게 깎고 다이 사이 간격을 줄여야 한다.[2] SK하이닉스는 8월 Hot Chips에서 16단 HBM4가 코어 다이를 약 50μm로 깎고 다이 간격을 12단의 절반으로 줄인다고 설명했다. 이 제약을 풀어 줄 하이브리드 본딩(접착제 없이 금속면끼리 직접 붙이는 공정)은 HBM4E에 맞추지 못해 HBM5로 미뤘다.[2]
그리고 세 방법 모두 같은 벽에 부딪힌다. 전력과 열이다. 지금 세대의 패키지 하나는 0.7~2.3kW를 먹는다(1~2부). 전류가 커지면 전압이 목적지에 닿기 전에 배선에서 깎여 나가는데(전압 강하, IR drop), 이를 막으려면 전원 배선을 굵고 많이 깔아야 하고 그 배선이 고속 신호가 지나갈 자리를 빼앗는다. 업계가 다이 아래에서 전압을 조정해 올려 주는 수직 전력 공급 구조를 찾는 이유다.[3] 후면 전력 공급과 3D 적층은 열을 더 좁은 곳에 가두고, 전자이동 같은 신뢰성 문제를 키운다.[3] SK하이닉스가 HBM 전용 냉각 구조를 따로 내놓은 것도 같은 문제 때문이다.[2]
여기서 두 가지를 읽어야 한다. 첫째, 스펙 경쟁은 설계 역량 경쟁이 아니라 패키징 접근권 경쟁이 됐다. 세 방법 중 둘이 패키징 기술과 캐파에 묶여 있기 때문이다. 둘째, 이 물리는 엔비디아에게도 똑같이 적용된다. 1부에서 본 Rubin Ultra의 칩렛 축소나 저용량 메모리 구성 시험 보도가 사실이라면, 세계 최대 구매력을 가진 회사도 같은 벽 앞에서 사양을 조정하고 있다는 뜻이다.
4. 허들 ② 설계와 검증 - 설계비보다 무서운 것은 실패 확률이다
칩 설계가 어떤 일인지부터 짚고 가자. 먼저 칩이 무슨 일을 할지를 코드로 적는다. 이것을 RTL이라고 부른다. 그 코드를 실제 회로 배치로 바꿔 주는 소프트웨어가 EDA다. 통신 규격처럼 이미 검증된 회로 블록은 직접 만들지 않고 사 오는데 그것이 IP다. 설계의 본질은 성능·전력·면적 셋을 맞바꾸는 일이고(업계에서는 앞글자를 따 PPA라고 한다), 셋을 동시에 좋게 만들 수는 없다.
다 그렸다고 끝이 아니다. 칩은 한 번 만들면 고칠 수 없으므로 만들기 전에 '이 설계가 맞나'를 컴퓨터로 시험해야 한다. 이것이 검증이다. 전용 장비에 설계를 얹어 실제처럼 돌려 보는 에뮬레이션도 쓴다. 자금이 부족한 회사는 여러 회사가 웨이퍼 한 장을 나눠 써 시제품을 싸게 만드는 MPW로 먼저 확인한다. 모든 검증이 끝나 설계를 확정하고 공장에 넘기는 순간을 테이프아웃이라고 한다. 여기서부터는 되돌릴 수 없다.
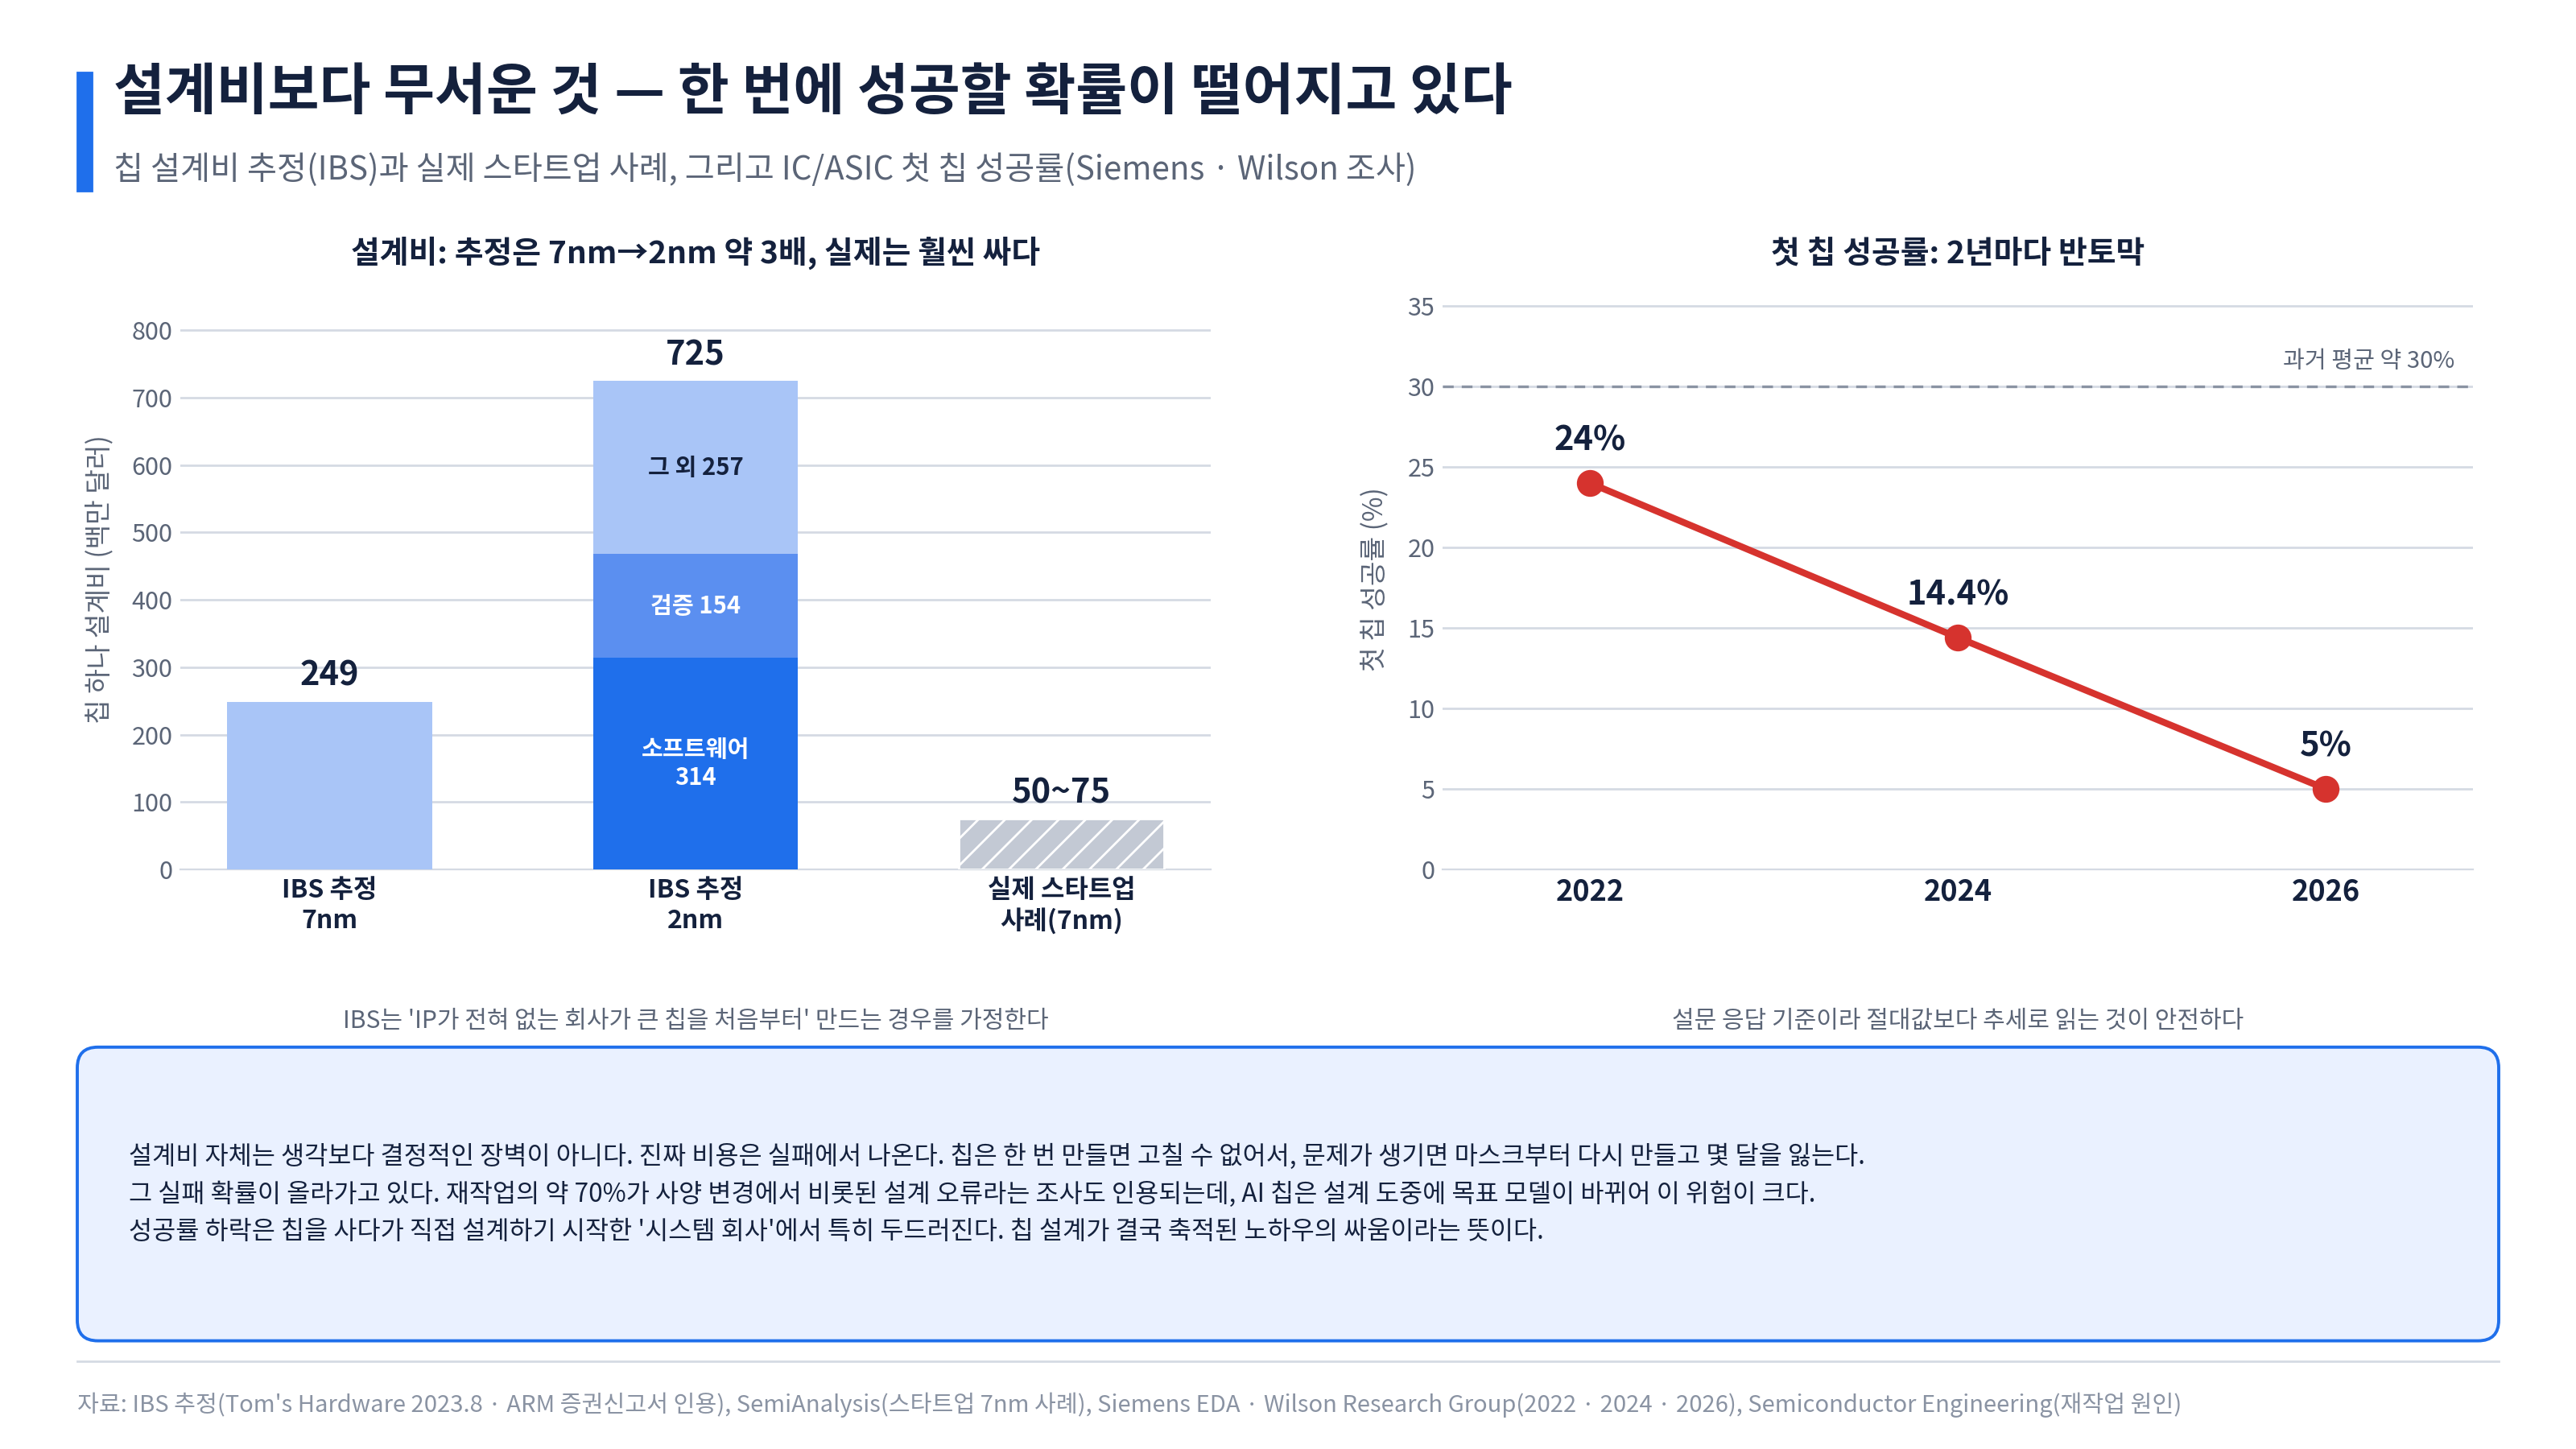
설계비부터 보자. 조사기관 IBS는 칩 하나의 설계비를 7nm 약 2.49억 달러, 2nm 약 7.25억 달러로 추정했다. 7nm에서 2nm로 오며 약 3배가 된 셈이다. 2nm의 내역을 보면 소프트웨어가 약 3.14억 달러, 검증이 약 1.54억 달러로, 회로를 그리는 일보다 그것이 맞는지 확인하고 돌아가게 만드는 일에 돈이 더 든다.[4] 다만 이 수치에는 중요한 전제가 있다. IP가 하나도 없는 회사가 큰 칩을 처음부터 다 만든다고 가정한 값이다.[4] 실제는 훨씬 싸다. SemiAnalysis는 소프트웨어·설계·테이프아웃을 모두 포함해 TSMC 7nm 첨단 칩을 5,000만~7,500만 달러로 만든 스타트업 사례들을 제시했다.[5] 설계비 자체는 생각만큼 결정적인 장벽이 아니다.
진짜 비용은 실패에서 나온다. Siemens EDA와 Wilson Research Group의 기능검증 조사에서 IC/ASIC의 첫 칩 성공률은 2022년 24%, 2024년 14.4%, 2026년 5%로 떨어졌다. 과거 평균은 약 30%였다.[6] 설문 응답 기준이라 절대값보다는 추세로 읽어야 하지만 방향은 일관된다. 2024년 조사에서는 일정이 밀린 프로젝트도 75%로 늘었다.[6] 칩에 문제가 발견되면 회로를 웨이퍼에 찍는 원판, 즉 마스크부터 다시 만들어야 하는데 이것을 재작업(리스핀)이라고 한다. 같은 조사를 인용한 업계 논평에 따르면 재작업의 약 70%는 사양 변경에서 비롯된 설계 오류다.[7] 2026년 조사에서는 논리 오류 외에도 펌웨어, 보안, 전력, 클럭, 타이밍 같은 시스템 수준의 원인이 늘었다.[6]
이 대목이 AI 칩에 특히 아픈 이유가 있다. 설계에서 양산까지 2~3년이 걸리는데 그 사이에 모델 구조가 바뀐다. 트랜스포머에서 MoE로, 다시 긴 컨텍스트와 에이전트로 넘어오는 동안 필요한 연산과 메모리 접근 패턴이 달라졌다. 목표가 움직이는 상태에서 사양을 확정해야 하므로 사양 변경으로 인한 재작업 위험이 크다.
더 흥미로운 것은 누가 가장 많이 실패하는가다. 조사를 설계한 Siemens의 해리 포스터는 성공률 하락이 칩을 사다가 직접 설계하기 시작한 '시스템 회사', 즉 하이퍼스케일러와 자동차 회사, 소비자 브랜드에서 특히 두드러진다고 썼다. 뛰어난 인재를 뽑아도 반도체 회사가 수십 년 쌓은 설계 흐름과 검증 기준의 노하우가 없다는 것이다.[6] 2부에서 본 맞춤형 칩 진영이 물리 설계와 검증을 브로드컴 같은 파트너에게 맡기는 이유가 여기에 있다. 스타트업에게는 더 냉정한 이야기다. 재작업을 예산에 넣고 설계하는 회사가 있고, 첫 칩이 곧 회사의 운명인 회사가 있다. 후자는 실패하면 마스크를 새로 만들 돈과 몇 달의 시간을 잃고, 그 사이 경쟁 제품은 한 세대 더 간다. 우리나라 스타트업 투자에도 연결되는 얘기지만, 여러 번 실수할 수 있는 기회가 자본과 인력이 충분한 해외 기업에 비해서 상대적으로 떨어지고, 설계도 해외 기업들과 테스트할 기회가 적기 때문에 시행착오가 많을 수 밖에 없다.
5. 허들 ③ 공급망 접근권 - 진짜 진입장벽
여기가 가장 덜 알려졌지만 가장 강력한 관문이다.
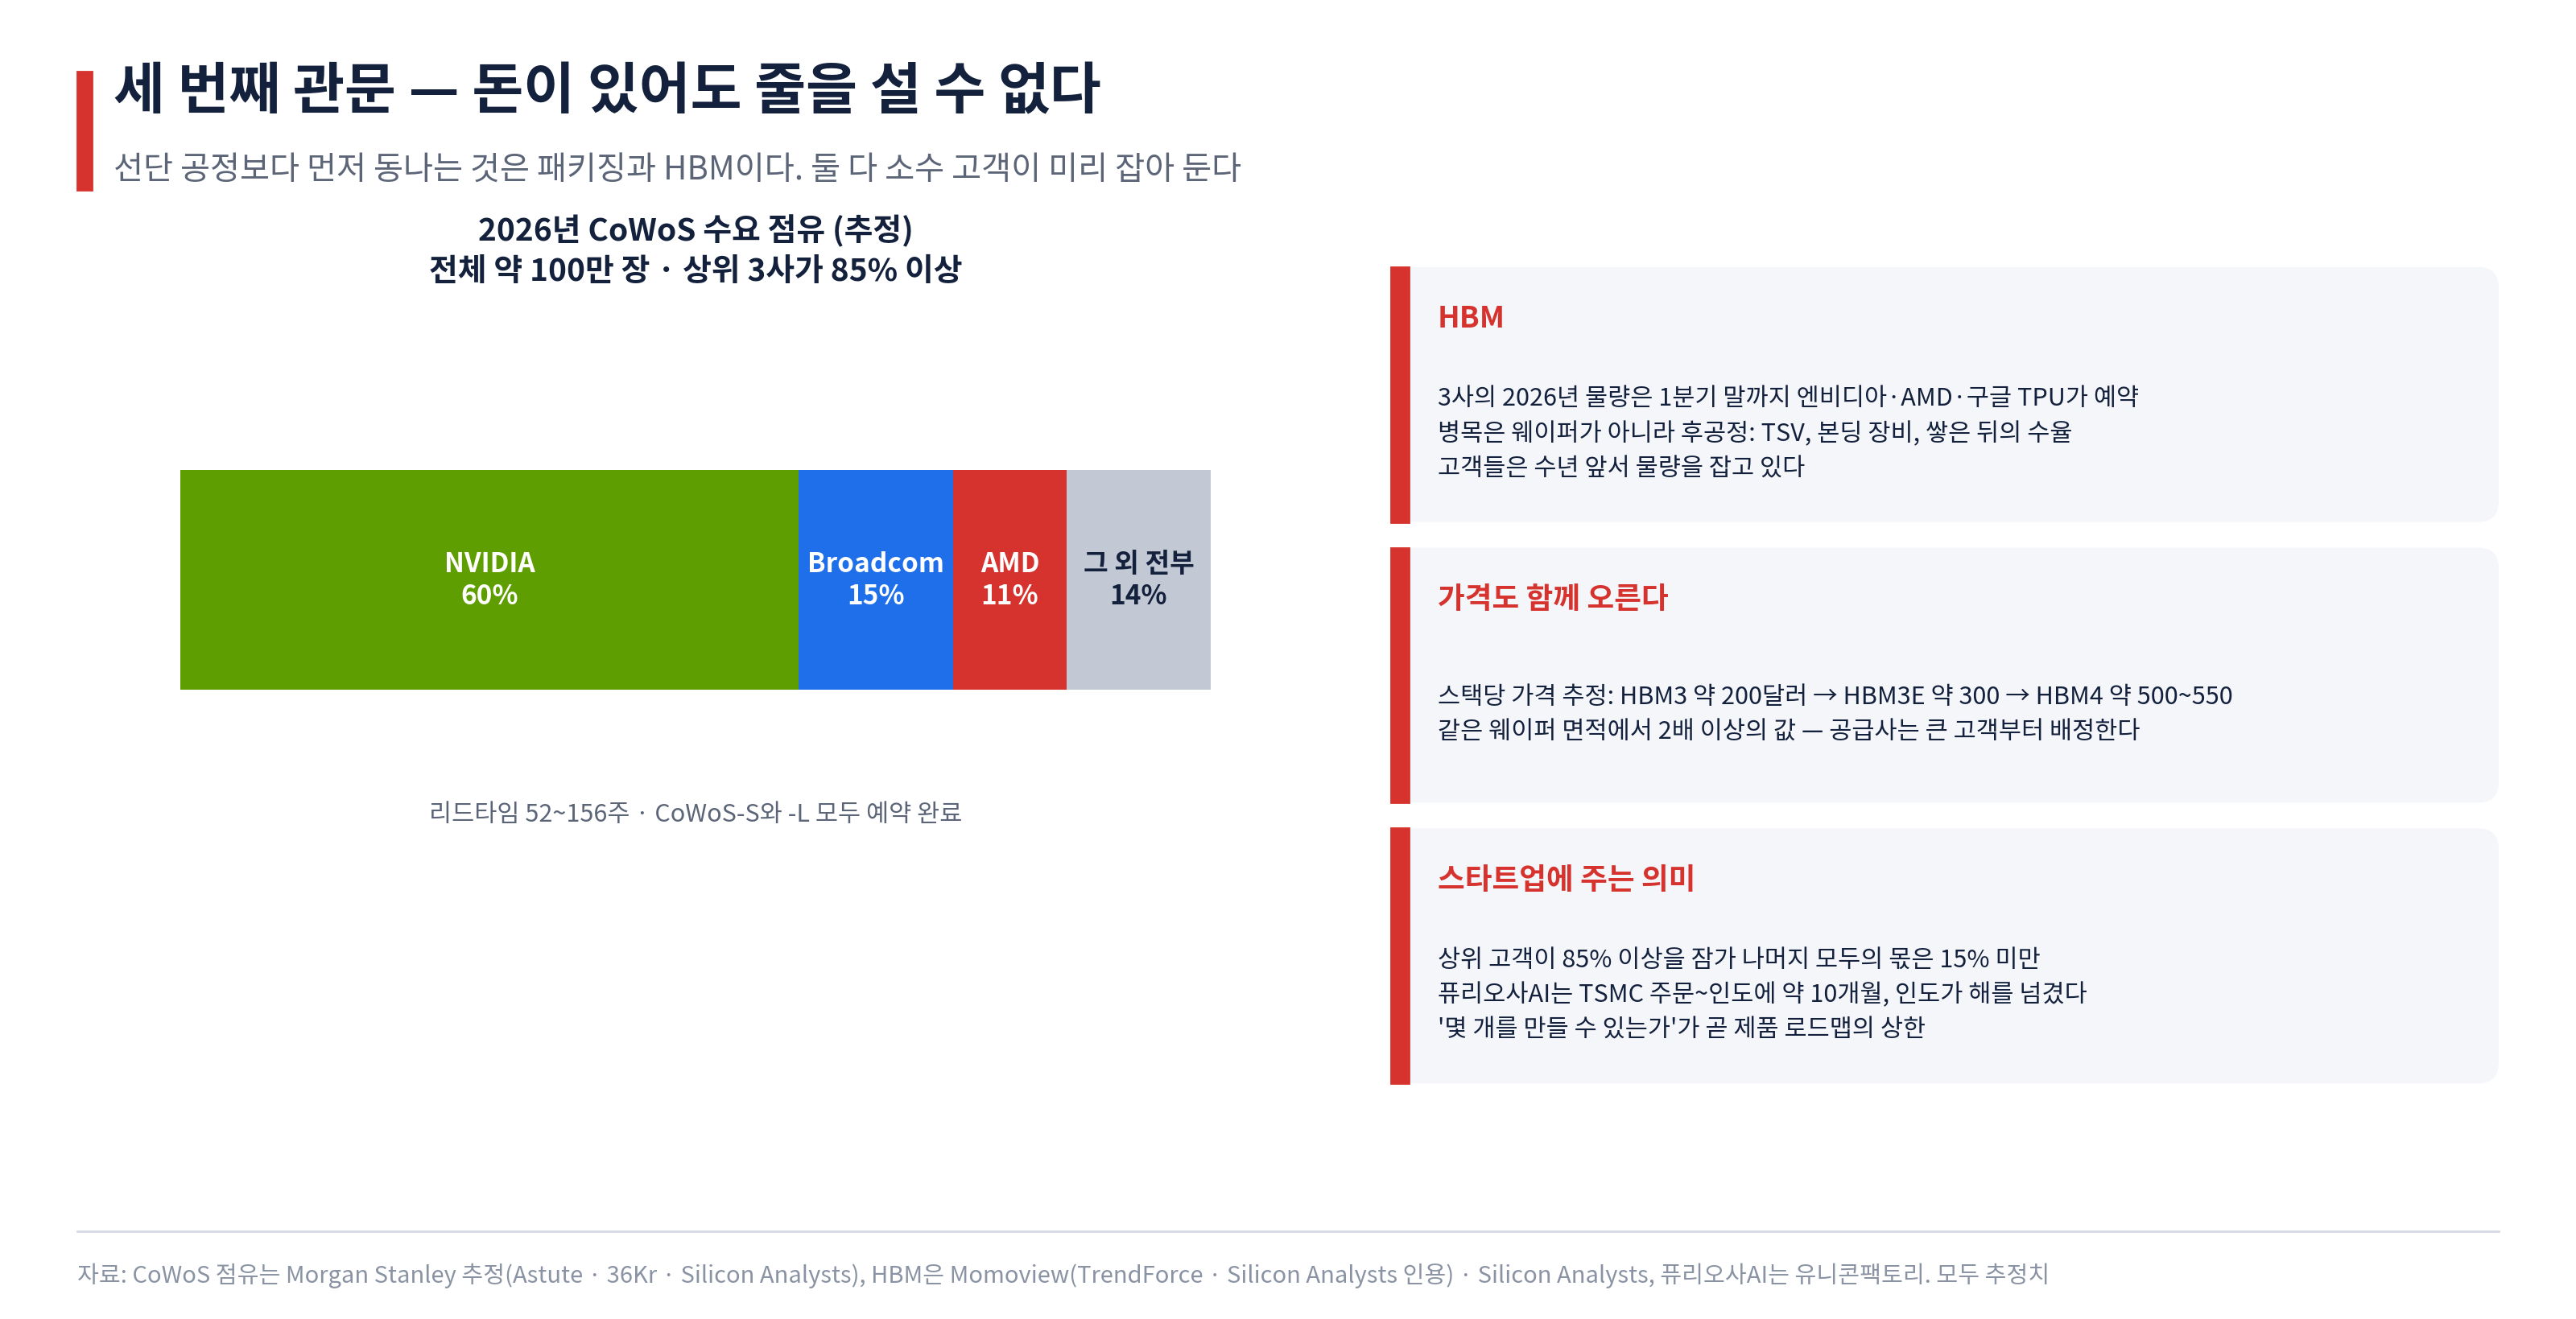
모건스탠리는 2026년 CoWoS 수요를 약 100만 장으로 추정했다. 엔비디아 한 곳이 약 59.5만 장(약 60%)을 가져가고, 브로드컴이 15만 장(15%, 그중 구글 TPU 9만·메타 5만·OpenAI 1만), AMD가 10.5만 장(11%)이다.[8] 상위 고객들이 85% 이상을 잠가 두면서 2차 AI 칩 회사, ASIC 전문 회사, 스타트업에 남는 몫은 15% 미만이다.[8] 리드타임은 52~156주로 집계된다.[8] 개별 회사의 웨이퍼 수는 출처마다 조금씩 다르지만 상위 몇 곳이 대부분을 가져간다는 집중도는 일관되게 확인된다.
HBM도 같다. 3사의 2026년 HBM 물량은 1분기 말까지 엔비디아, AMD, 구글 TPU가 예약을 마쳤고, 증권가 다수는 부족이 2028년까지 이어질 것으로 본다.[9] 고객들은 수년 앞서 물량을 잡고 있다.[9] 병목의 원인은 웨이퍼가 아니다. D램을 몇 장 더 만드는 것이 아니라 그것을 수직으로 쌓아 붙이는 일에서 막힌다. 층마다 통로를 뚫는 TSV 가공 처리량, 층을 붙이는 본딩 장비의 대수, 쌓고 나서 정상품이 나오는 비율이 모두 제약이다.[9] 증설 발표가 곧 공급이 아니라는 뜻이다. 가격도 오른다. 스택당 가격은 HBM3 약 200달러, HBM3E 약 300달러, HBM4 약 500~550달러로 추정된다.[9] 같은 웨이퍼 면적에서 두 배 이상의 값이 나오므로 공급사는 큰 고객부터 배정할 유인이 있다.
스타트업에 이것이 무엇을 뜻하는지가 중요하다. 연간 수천~수만 개를 사는 회사는 배정 우선순위에서 뒤로 밀린다. 국내 사례가 있다. 퓨리오사AI는 원래 작년에 양산 물량을 받을 예정이었지만, 설계 보완과 TSMC의 대기 기간이 겹쳐 인도가 해를 넘겼다. 보도에 따르면 최근 TSMC의 양산 주문에서 인도까지는 약 10개월이 걸린다.[10] 이 단계에서는 "얼마나 좋은 칩을 설계했는가"가 아니라 "몇 개를 언제 만들 수 있는가"가 제품 로드맵의 상한이 된다.
이 허들이 더 크리티컬한 것은 자본으로도 풀리지 않는 경우가 있다는 점이다. 파운드리와 메모리 회사 입장에서 배정의 기준은 단가만이 아니라 물량의 예측 가능성과 다년 지속성이다. 한 번 크게 사는 고객보다 수년간 꾸준히 살 고객이 우선한다. 스타트업이 대규모 투자를 유치해도 그 돈으로 살 수 있는 것은 '물량'이지 '순번'이 아니다. 2부에서 본 브로드컴이 고객의 캐파를 대신 확보하고 자금 조달까지 설계하는 이유도, 이 순번이 그 자체로 경쟁력이기 때문이다.
6. 허들 ④ 소프트웨어 - 모델은 왜 안 도는가
"소프트웨어가 약하다"는 말은 너무 뭉뚱그려져 있다. 구체적으로 무슨 일이 일어나는지를 보자. 새로 나온 모델 하나를 새 칩에 올릴 때 넘어야 하는 절차는 일곱개다.
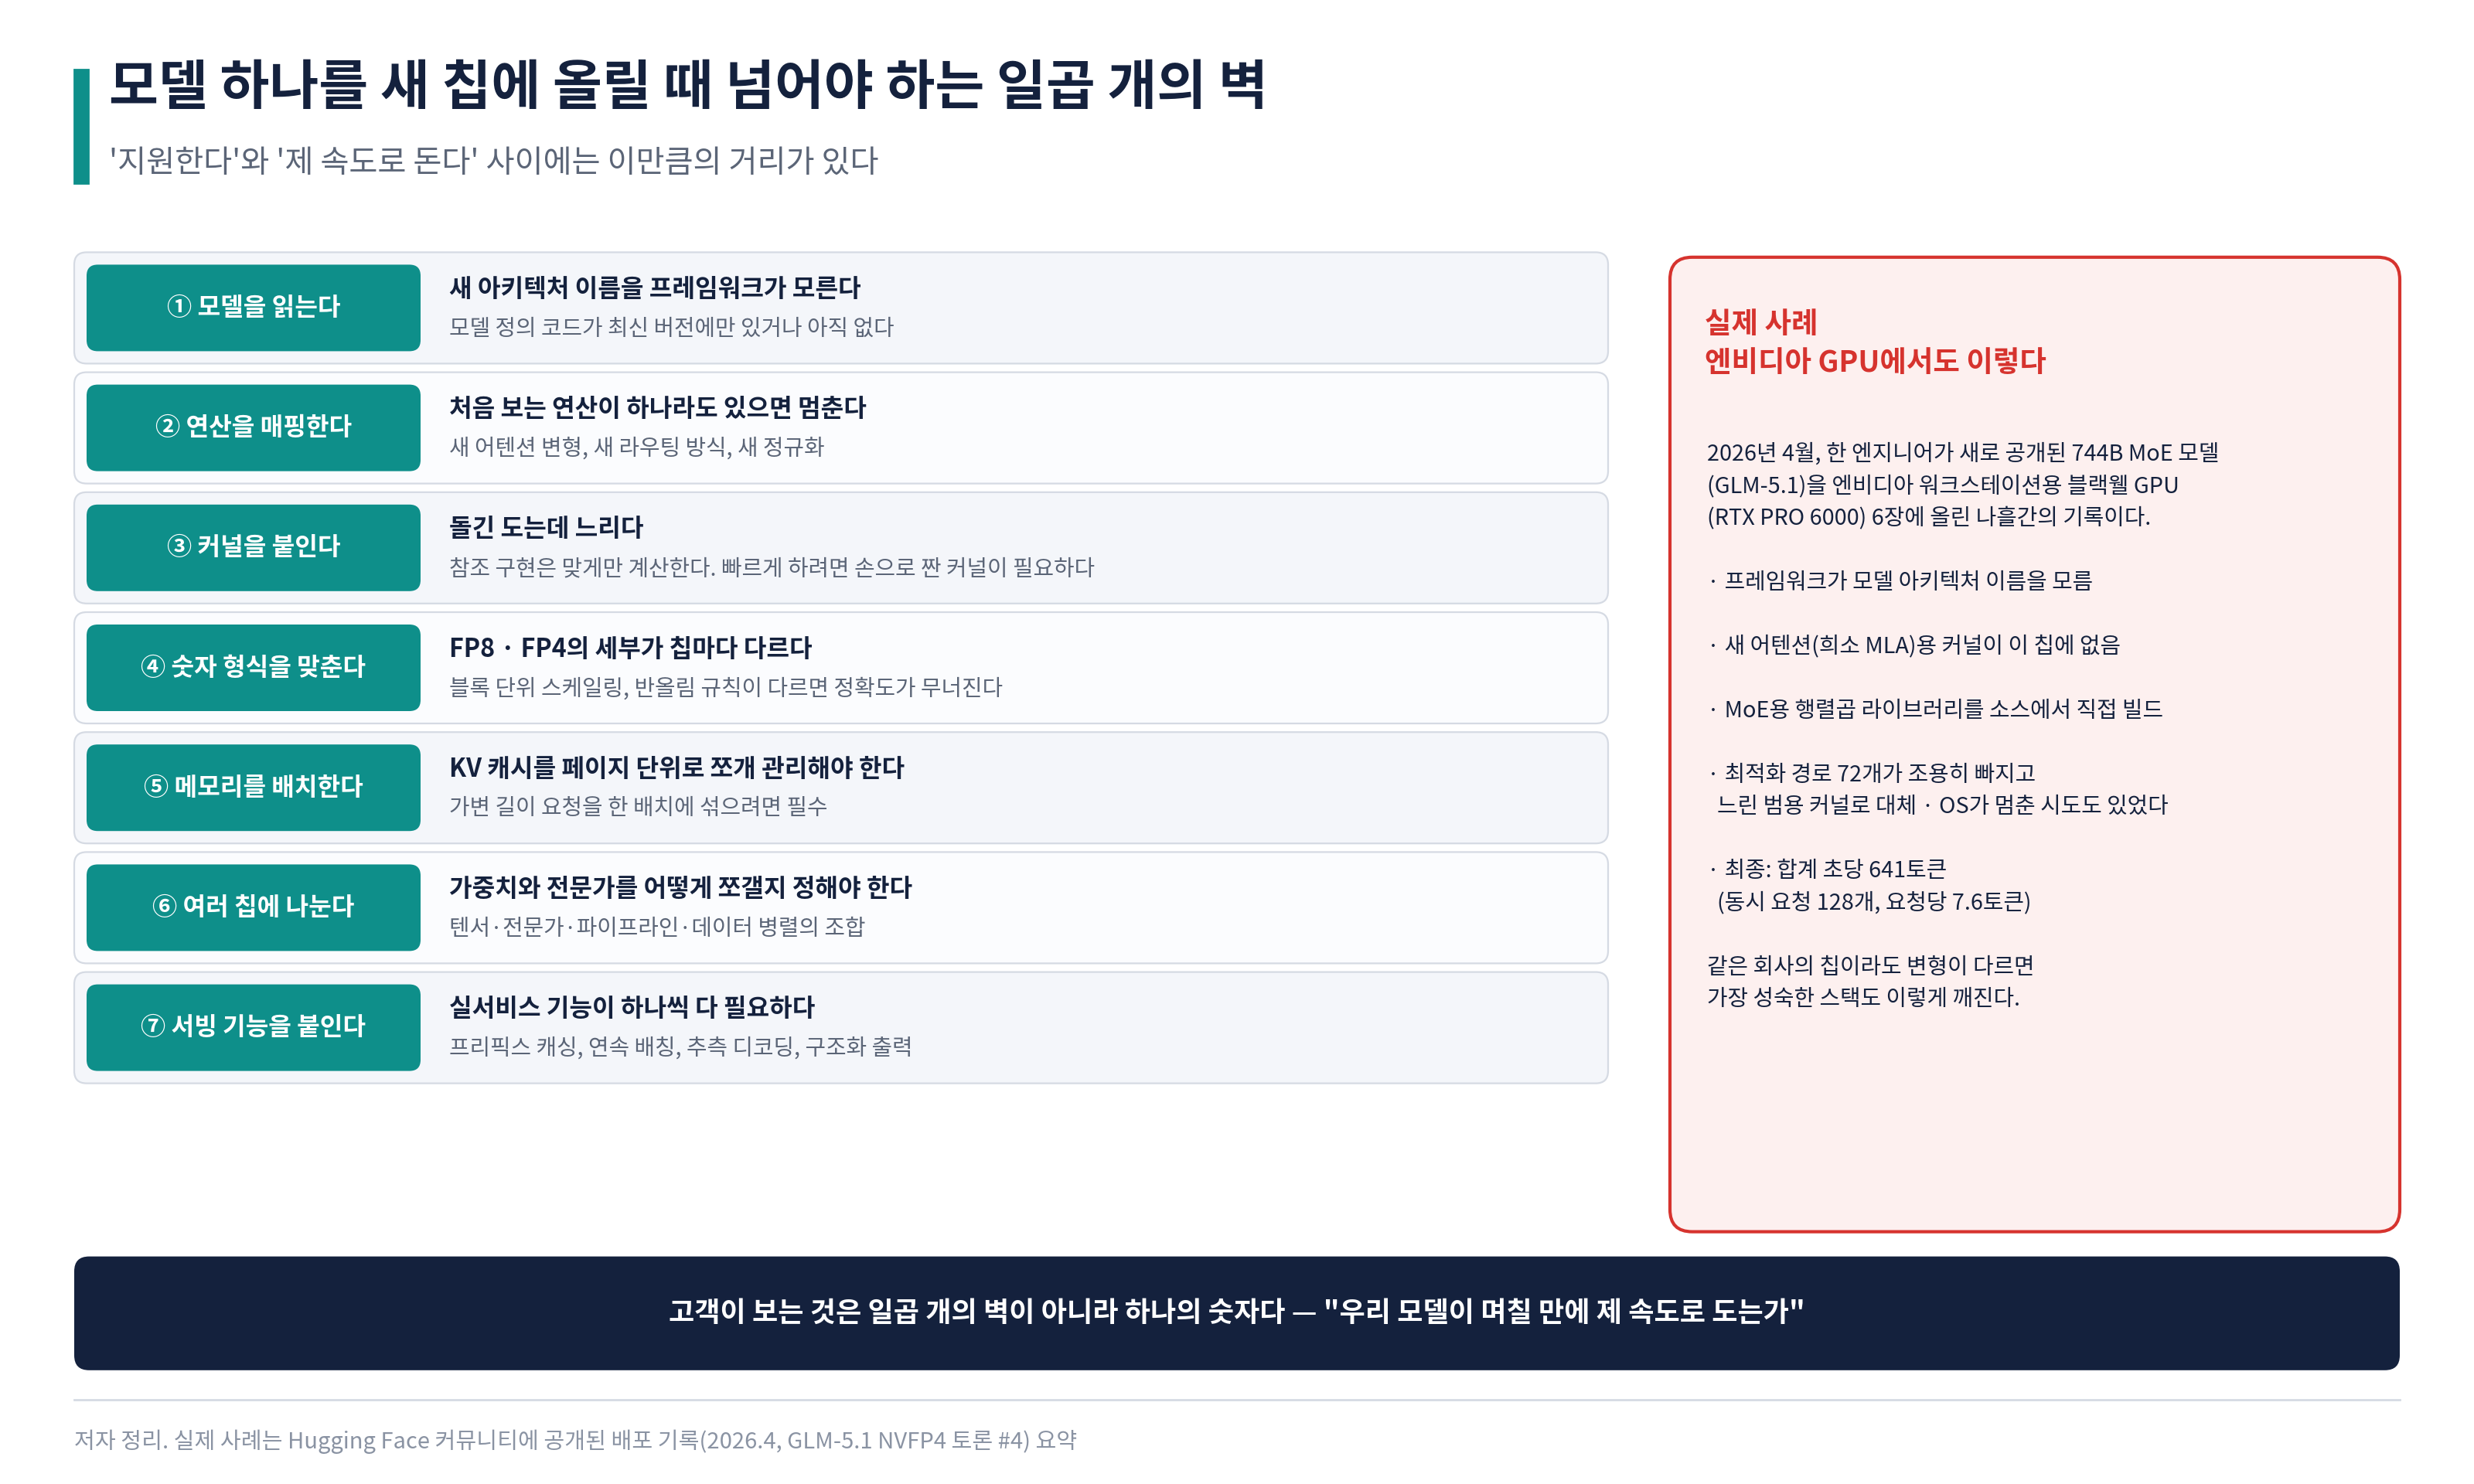
① 모델을 읽는 단계. 서빙 프레임워크가 그 모델의 아키텍처 이름을 알아야 한다. 새 모델은 정의 코드가 프레임워크의 최신 개발 버전에만 있거나 아직 없는 경우가 많다. 이름을 모르면 로딩 자체가 실패한다.
② 연산을 매핑하는 단계. 모델을 칩이 이해하는 명령으로 바꿔 주는 번역기를 컴파일러라고 한다. 모델은 수십 가지 연산의 조합인데, 이 연산 하나하나를 오퍼레이터라고 부른다. 그중 하나라도 지원되지 않으면 거기서 멈춘다. 최근 모델들은 어텐션 변형, MoE 라우팅 방식, 정규화 방식을 계속 바꾼다. 즉, 모든 새로운 연산들이 구현이 되어있어야 한다. 기존 연산 99개를 지원해도 새 연산 1개가 없으면 그 모델은 안 돈다. 소프트웨어 지원이 '비율'이 아니라 '전부 아니면 전무'로 작동하는 이유다.
③ 커널을 붙이는 단계. ②를 통과하면 일단 돌기는 한다. 그런데 느리다. 교과서대로 만든 구현은 '맞게' 계산할 뿐 '빠르게' 계산하지 않는다. 자주 쓰는 연산은 사람이 그 칩에 맞춰 손으로 최적화해 둔 코드 조각이 있어야 제 속도가 나는데, 이것을 커널이라고 부른다. 엔비디아가 20년간 쌓아 온 것이 바로 이 커널이다. 조직 구조도 다르다. 엔비디아의 이안 벅 부사장은 칩을 만드는 팀과 같은 조직에 소프트웨어·커널 엔지니어 수천 명이 있고, 칩이 나온 뒤에도 OpenAI·Anthropic·마이크로소프트와 함께 커널 성능을 계속 끌어올린다고 설명한다. 그가 든 예가 인상적이다. 엔비디아 소프트웨어 엔지니어 400명이 넉 달 동안 오픈 모델 DeepSeek-R1 하나를 최적화했다.[11] 세계에서 가장 성숙한 스택을 가진 회사도 모델 하나에 이만큼을 쓴다.
④ 숫자 형식을 맞추는 단계. 모델을 빠르게 돌리려면 숫자의 정밀도를 낮춰 쓴다. 이것을 양자화라고 한다. FP8이나 FP4가 그것인데, 이름만 같을 뿐 칩마다 세부가 다르다. 어느 단위로 스케일을 잡는지, 반올림을 어떻게 하는지가 다르면 속도는 나오는데 출력 품질이 무너진다.
⑤ 메모리를 배치하는 단계. 1부에서 본 KV 캐시를 페이지 단위로 쪼개 관리해야 길이가 제각각인 요청을 한 배치에 섞을 수 있다. 이 구조가 없으면 배치를 키울 수 없고, 배치를 못 키우면 처리량이 나오지 않는다.
⑥ 여러 칩에 나누는 단계. 가중치와 전문가를 어떻게 쪼갤지 정해야 한다. 다음 장에서 이어진다.
⑦ 서빙 기능을 붙이는 단계. 프리픽스 캐싱, 연속 배칭, 추측 디코딩, 구조화 출력 같은 기능이 하나씩 다 필요하다. 이것들이 없으면 벤치마크 숫자는 나와도 실서비스 비용이 몇 배가 된다.
이 일곱 개가 얼마나 무거운지는 엔비디아 칩에서도 확인된다. 올해 4월 한 엔지니어가 새로 공개된 744B MoE 모델(GLM-5.1)을 엔비디아의 워크스테이션용 블랙웰 GPU(RTX PRO 6000) 6장에 올린 나흘간의 기록을 공개했다. 프레임워크가 모델의 아키텍처 이름을 몰랐고, 새 어텐션 방식(희소 MLA)용 커널이 이 칩에는 없었으며, MoE에 필요한 행렬곱 라이브러리는 소스에서 직접 빌드해야 했다. 최적화 경로 72개가 조용히 빠지면서 느린 범용 커널로 대체됐고, 운영체제가 멈춘 시도도 있었다. 최종적으로 안착한 성능은 동시 요청 128개에서 합계 초당 641토큰, 요청당 7.6토큰이었다.[12] 데이터센터용과 설계 변형이 다른 칩이었다는 점이 원인이다. 같은 회사의 칩이라도 변형이 다르면 가장 성숙한 스택이 이렇게 깨진다. 새 칩을 만든 회사는 이 일곱 개의 벽을 전부 자기 힘으로, 그것도 모델이 나올 때마다 다시 넘어야 한다.
여기서 나오는 개념이 소프트웨어 세금이다. 칩이 30% 싸도 고객이 엔지니어를 더 투입해야 한다면 그 인건비가 절감분을 먹는다. 역사적 사례가 있다. 그래프코어는 2021년 MLPerf 학습 부문에서 결과를 몇 개만 제출했고, 당시 SemiAnalysis는 소프트웨어 스택이 빈약해 숙련된 엔지니어의 수작업 튜닝이 많이 필요하다는 업계의 이야기와 일치한다고 적었다.[13] 그래프코어는 2022년 매출 270만 달러에 순손실 2.05억 달러를 기록했고, 2024년 소프트뱅크에 인수됐다.[13]
올해 사례도 있다. 엣지 AI 칩 1위였던 이스라엘 헤일로는 누적 3.4억 달러를 투자받았지만 결국 마이크로칩에 인수됐다. 새 모델이 나올 때마다 SDK를 고쳐야 해서 하드웨어보다 소프트웨어 인력이 훨씬 많이 필요했다는 것이 업계의 설명이다. 헤일로 관계자는 "직원 350명 중 대부분이 SDK 인력이었는데도 결국 인수됐다"고 말했다.[14]
그래서 소프트웨어 허들의 실사 질문은 "지원하는가"가 아니라 "며칠 만에 지원했는가"다. 최근 나온 모델 서너 개를 짚어 공개일과 자사 스택에서 제 속도로 돌기 시작한 날의 간격을 물으면, 위 일곱 벽을 실제로 몇 번 넘어 봤는지가 드러난다.
7. 왜 랙 단위 최적화가 중요하고, 왜 어려운가
1부에서 경쟁의 단위가 칩에서 랙으로 넘어갔다고 했다. 이유는 간단하다. 1조 파라미터급 모델은 칩 하나에 들어가지 않는다. 수십 개 칩의 메모리를 합쳐야 모델이 올라가고, 그 칩들이 매 토큰·매 레이어마다 발을 맞춰야 답이 나온다. 그러니 랙은 '칩 72개'가 아니라 '한 대의 컴퓨터'다. 문제는 이 컴퓨터를 제대로 돌리는 일이 칩을 만드는 일과 완전히 다른 종류의 난제라는 점이다.
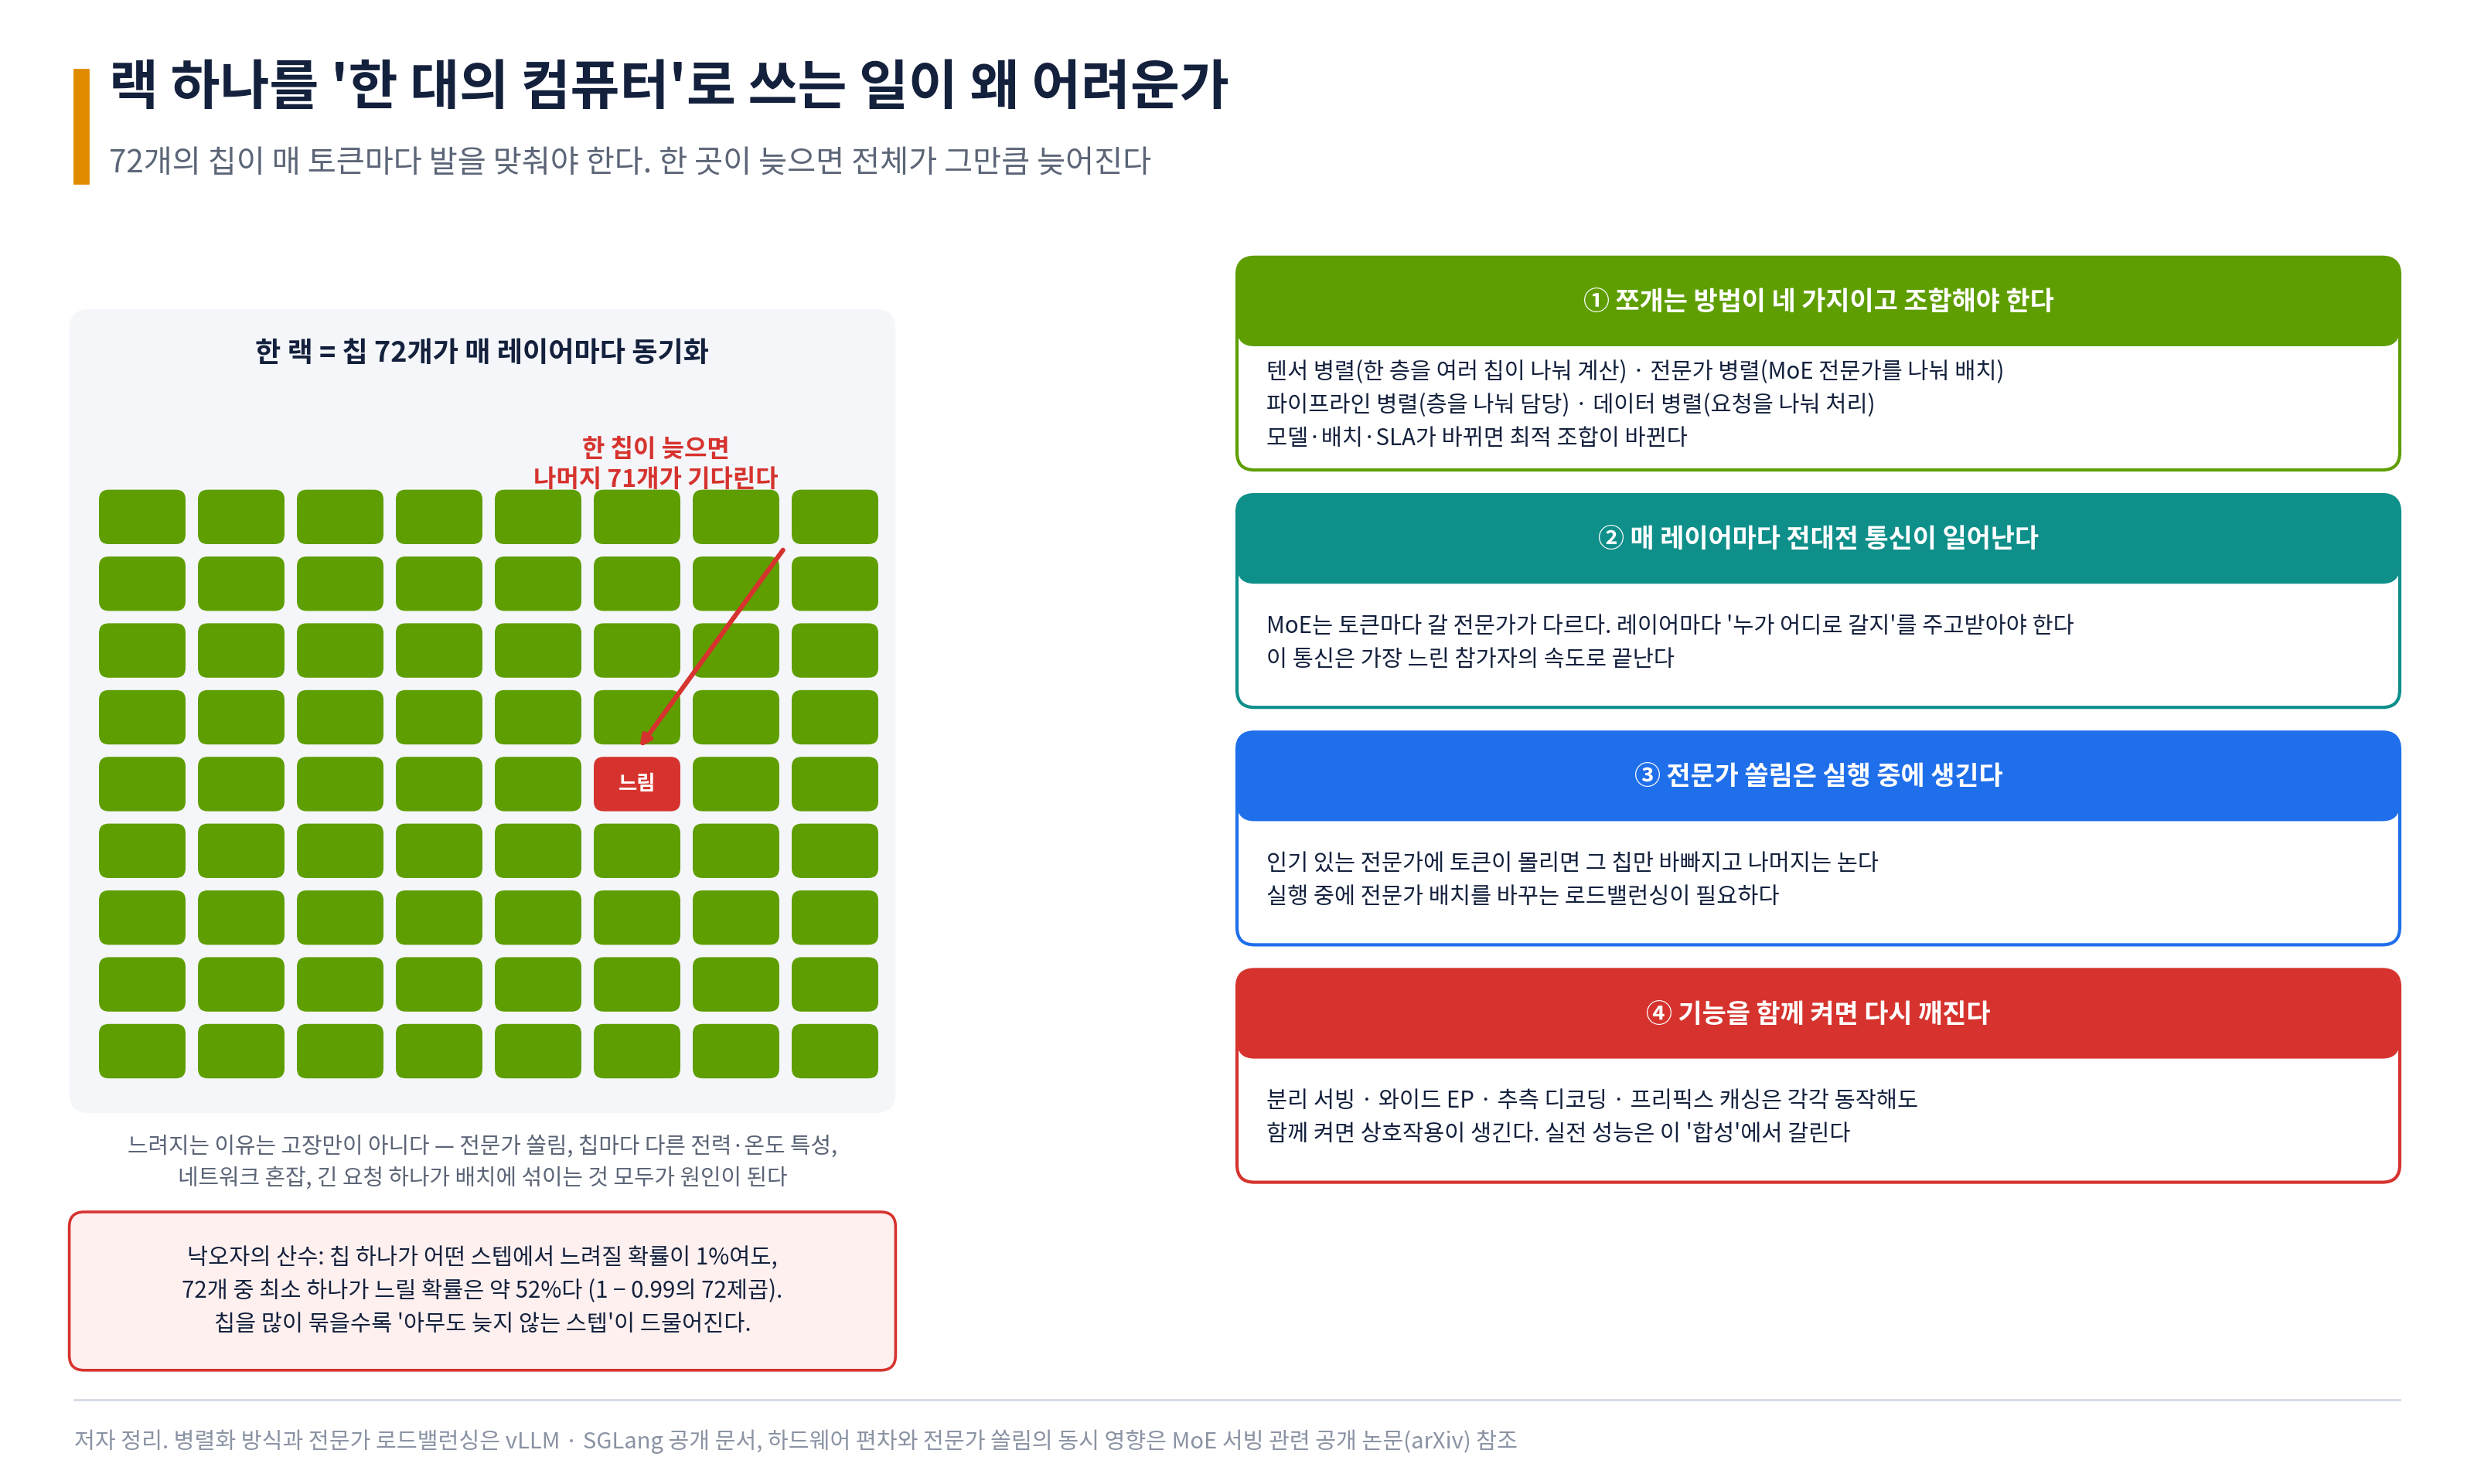
① 쪼개는 방법이 네 가지이고, 조합해야 한다. 한 층의 행렬 연산을 여러 칩이 나눠 계산하면 텐서 병렬, MoE 전문가를 칩마다 나눠 배치하면 전문가 병렬, 층을 나눠 담당하면 파이프라인 병렬, 요청 자체를 나눠 처리하면 데이터 병렬이다. 앞의 셋은 모델을 쪼개는 방식이고 마지막 하나는 일감을 쪼개는 방식이다. 실제 서빙에서는 이것들을 섞어 쓰는데, 최적 조합은 모델 구조와 배치 크기, 목표 지연 시간이 바뀔 때마다 달라진다. 한 번 튜닝해서 끝나는 작업이 아니다.
② 매 레이어마다 전대전 통신이 일어난다. 여러 칩이 서로 모두에게 데이터를 보내는 통신을 전대전(all-to-all)이라고 한다. MoE에서는 토큰마다 갈 전문가가 다르고, 그 전문가는 다른 칩에 있다. 그래서 레이어를 지날 때마다 "이 토큰은 저 칩으로"를 모두가 주고받아야 한다. 이 통신의 성격이 중요하다. 가장 느린 참가자가 끝나야 끝난다.
③ 그런데 '느려지는 일'은 생각보다 자주 일어난다. 원인은 고장만이 아니다. 인기 있는 전문가에 토큰이 몰리면 그 칩만 바빠지고 나머지는 논다. 같은 모델의 칩이라도 성능 편차가 있어 실행 속도가 다르다. 올해 공개된 한 연구는 토큰 수를 고르게 나눠도 성능은 고르게 나뉘지 않는다고 지적했다. 라우팅 쏠림과 GPU 간 성능 편차가 겹치고, 전문가 병렬에서는 각 층이 가장 느린 장치의 속도로 끝나기 때문에 지속적인 낙오자가 생겨 꼬리 지연과 가동률, 처리량을 모두 해친다는 것이다.[15] 간단한 산수를 해 보면 심각성이 보인다. 칩 하나가 어떤 스텝에서 느려질 확률이 1%에 불과해도, 72개 중 최소 하나가 느릴 확률은 약 52%다. 칩을 많이 묶을수록 '아무도 늦지 않는 스텝'이 드물어진다.
그래서 서빙 소프트웨어에는 실행 중에 전문가 배치를 바꾸는 로드밸런서가 들어간다. SGLang의 방식은 인기 있는 전문가를 복제하는 것이다. 예컨대 전문가가 256개인 모델에 중복 전문가 32개를 더해 288개로 만들고 칩들에 다시 나눠 싣는다.[16] 대가도 있다. 복제한 만큼 메모리를 더 쓰고, 실행 중에 전문가를 옮기는 작업은 전체를 잠시 멈추게 해 지연을 키울 수 있다.[16] 낙오자를 줄이는 일조차 공짜가 아니다.
④ 기능을 함께 켜면 다시 깨진다. 분리 서빙, 와이드 EP, 추측 디코딩, 프리픽스 캐싱은 각각 동작해도 함께 켜면 서로 간섭한다. 1부에서 AMD가 받은 지적이 정확히 이것이었다. "각각은 잘 동작하지만 여러 개를 함께 켜면 기대만큼 성능이 나오지 않는다." 그런데 프런티어 연구소의 실제 운영은 이 기능들을 동시에 켠 상태다. 실전 성능은 개별 기능이 아니라 '합성'에서 갈린다.
여기에 운영의 문제가 더해진다. 칩 하나가 고장 나면 그 도메인 전체의 작업이 멈춘다. 72개를 하나의 도메인으로 묶었다는 말은 장애 단위도 72개가 묶였다는 뜻이다. 2부에서 본 구글이 광 회로 스위치로 고장 난 큐브를 건너뛰게 만든 것도 이 문제 때문이다. 랙 단위 제품에는 빠른 진단, 자동 격리, 부품 교체, 재시작 절차가 함께 있어야 한다. 이것은 칩 설계 팀이 아니라 시스템 엔지니어링과 현장 조직의 일이다.
8. 허들 ⑤ 시스템과 두 번째 고객
마지막 관문은 칩 바깥이다. 고객이 사는 것은 다이가 아니라 돌아가는 시스템이다. 보드, 랙, NIC, 스위치, 냉각, 스케줄러, 그리고 고장 났을 때 와 주는 사람까지가 제품이다. 4부에서 볼 네트워크 반도체, 5부의 전력과 냉각, 6부의 기판이 전부 여기에 들어간다. 빠른 다이 하나로는 이 목록을 채울 수 없다.
그리고 첫 고객과 두 번째 고객 사이에 큰 간격이 있다. 첫 고객은 계열사, 정부, 전략적 투자자인 경우가 많다. 이들은 실험 데이터와 첫 운영 인력을 만들어 주므로 초기에는 분명한 자산이다. 문제는 그 관계가 길어질 때다. 한 고객의 요구가 엔지니어링 로드맵을 지배하면 두 번째 고객은 더 늦고 비싸게 지원받는다. 2부에서 본 세레브라스가 좋은 예다. 2분기 매출의 약 32%가 OpenAI에서 나왔고, 주요 고객으로 OpenAI와 UAE의 두 기관, AWS를 꼽는다.
작동하는 첫 칩까지 온 회사는 양산 마스크, 웨이퍼, HBM, 패키징, 재고, 현장 인력, 보증, 그리고 두 번째 칩을 동시에 조달해야 하는 구간에 들어간다. 이 구간에서 자본이 끊기는 경우가 많다. 첫 칩은 물리를 증명하고, 두 번째 칩과 재주문이 회사를 증명한다.
9. 그래서 경쟁력은 무엇인가
시장이 실제로 값을 매기는 항목은 인수 사례에서 드러난다.
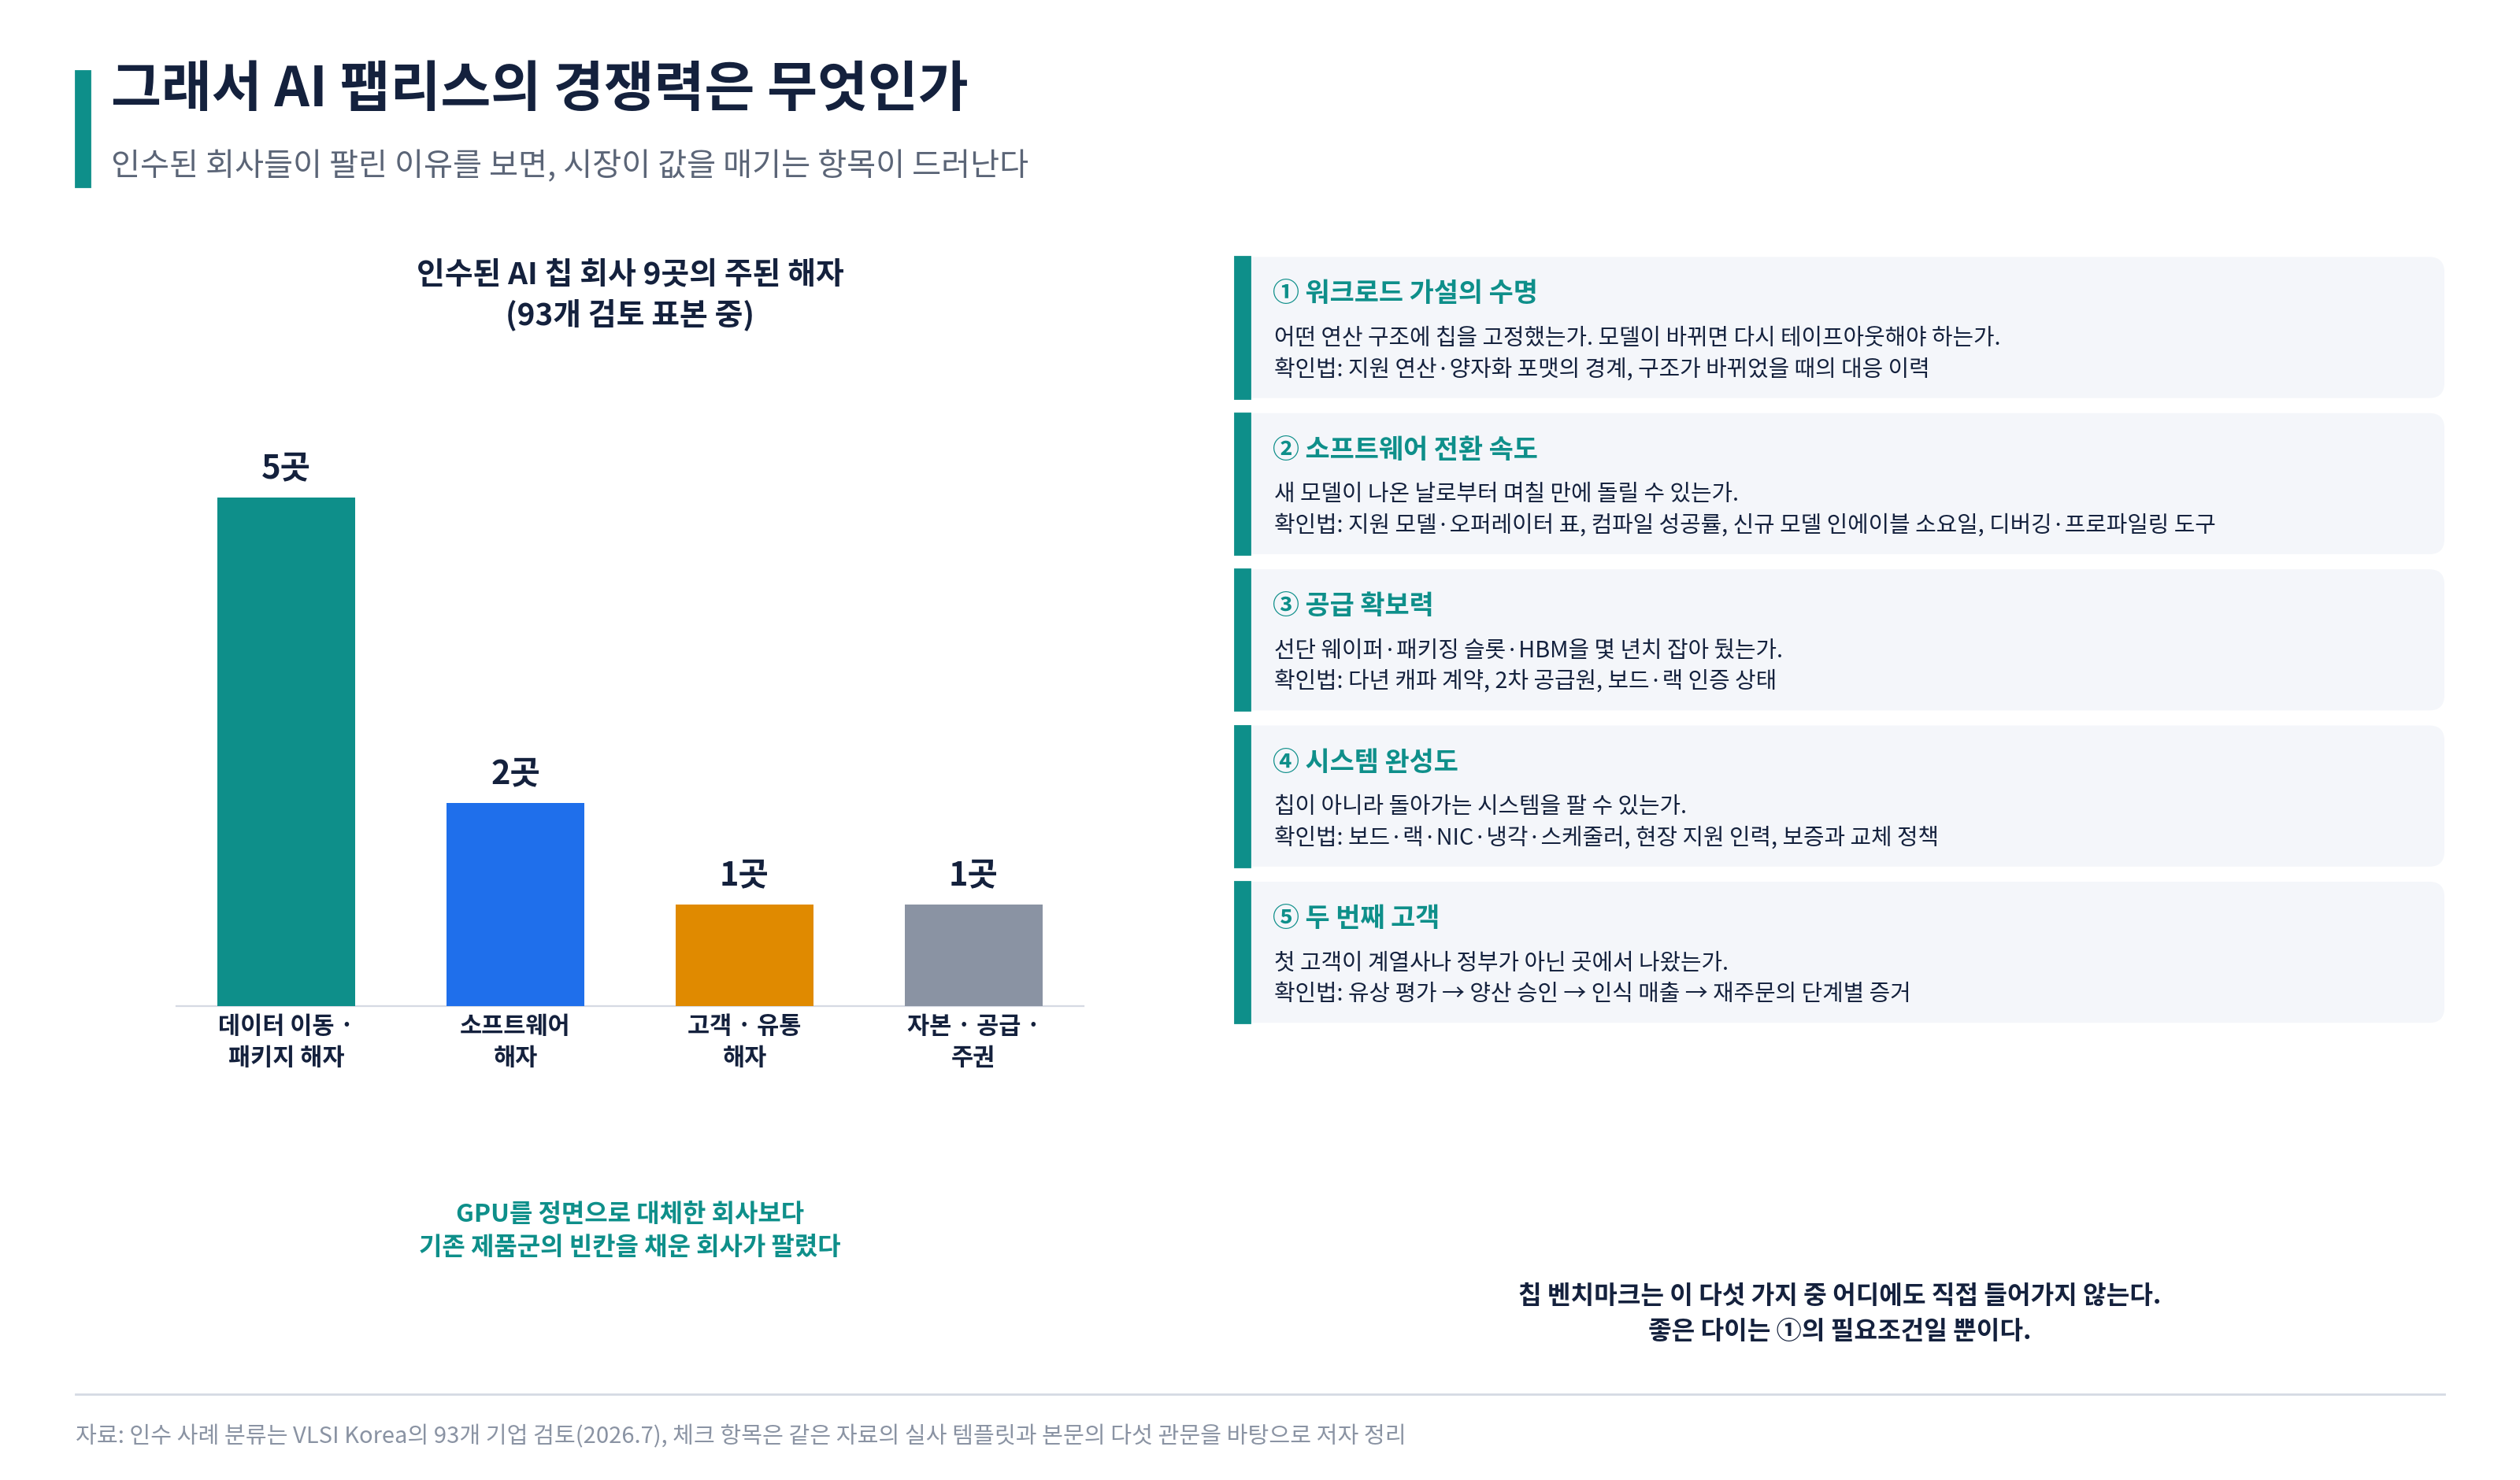
국내 반도체 매체 VLSI Korea가 AI 칩 스타트업 93곳을 검토한 결과, 인수 9곳, 영업 종료 3곳, 운영 중 79곳이었다. 인수된 9곳 가운데 주된 해자가 데이터 이동·패키지였던 곳이 5곳, 소프트웨어가 2곳이었다.[17] GPU를 정면으로 대체하려던 회사보다 기존 제품군의 빈칸을 채우는 회사가 팔렸다는 뜻이다.
최근의 굵직한 거래들이 이 패턴을 그대로 보여 준다.
1) 마벨 → 셀레스티얼 AI(약 32.5억 달러, 실적 조건 충족 시 최대 55억 달러): 스케일업용 광 인터커넥트 회사다. 마벨은 FY28 하반기부터 매출이 나오기 시작해 FY29 4분기에 연 10억 달러 규모가 될 것으로 제시했고, 아마존에는 이 제품 구매에 연동된 워런트를 줬다.[18]
2) 퀄컴 → 알파웨이브(기업가치 약 24억 달러): 고속 유선 연결(SerDes)과 칩렛 IP 회사다. 작년 12월 예정보다 한 분기 빨리 인수를 끝냈고, 알파웨이브 CEO가 퀄컴의 데이터센터 사업 전체를 맡았다.[19]
3) AMD → Taalas, 엔비디아 → 그록 기술 라이선스·인력(2부): 둘 다 추론의 특정 구간을 빠르게 만드는 기술을 사들였다.
인수자가 산 것은 멋진 벤치마크가 아니라 자기 제품군에서 직접 만들면 늦어지는 빈칸이었다. 4부에서 볼 "새 시장은 스케일업 스위치와 신호 연결에서 열린다"는 관찰과 같은 이야기다.
여기서 AI 팹리스의 경쟁력을 다섯 항목으로 정리할 수 있다. 각 항목에는 확인 방법을 붙인다.
① 워크로드 가설의 수명. 어떤 연산 구조에 칩을 고정했는가. 모델 구조가 바뀌면 다시 테이프아웃해야 하는가. 확인할 것은 지원 연산과 숫자 형식의 경계, 그리고 과거에 모델 구조가 바뀌었을 때의 대응 이력이다.
② 소프트웨어 전환 속도. 새 모델이 나온 날로부터 며칠 만에 제 속도로 돌릴 수 있는가. 지원 모델·오퍼레이터 표, 컴파일 성공률, 신규 모델 인에이블 소요일, 디버깅과 프로파일링 도구, 그리고 전체 인력 중 소프트웨어 인력의 비중을 본다.
③ 공급 확보력. 선단 웨이퍼, 패키징 슬롯, HBM을 몇 년 치 잡아 뒀는가. 고객사가 들어올 경우 생산하는지, 캐파 계약, 2차 공급원, 주문에서 인도까지의 실제 소요 기간을 본다.
④ 시스템 완성도. 칩이 아니라 돌아가는 시스템 (랙)을 팔 수 있는가. 보드, 랙, NIC, 냉각, 스케줄러, 하나의 도메인으로 묶어 본 최대 칩 수, 현장 지원 인력, 보증과 교체 정책을 본다.
⑤ 두 번째 고객. 첫 고객이 계열사나 국내 정부가 아닌 곳에서 나왔는가. 유상 평가 → 양산 승인 → 인식 매출 → 재주문의 단계를 구분해서 본다.
칩 벤치마크는 이 다섯 가지 어디에도 직접 들어가지 않는다. 좋은 다이는 ①의 필요조건일 뿐이다. IR 자료 첫 장의 TOPS나 TOPS/W는 다섯 관문 가운데 가장 앞쪽 하나를 통과했다는 증거에 지나지 않는다.
10. 같은 관문, 다른 해법 - 진영별 돌파 전략
관문은 모두에게 같지만 가진 자원이 다르면 해법도 달라진다.
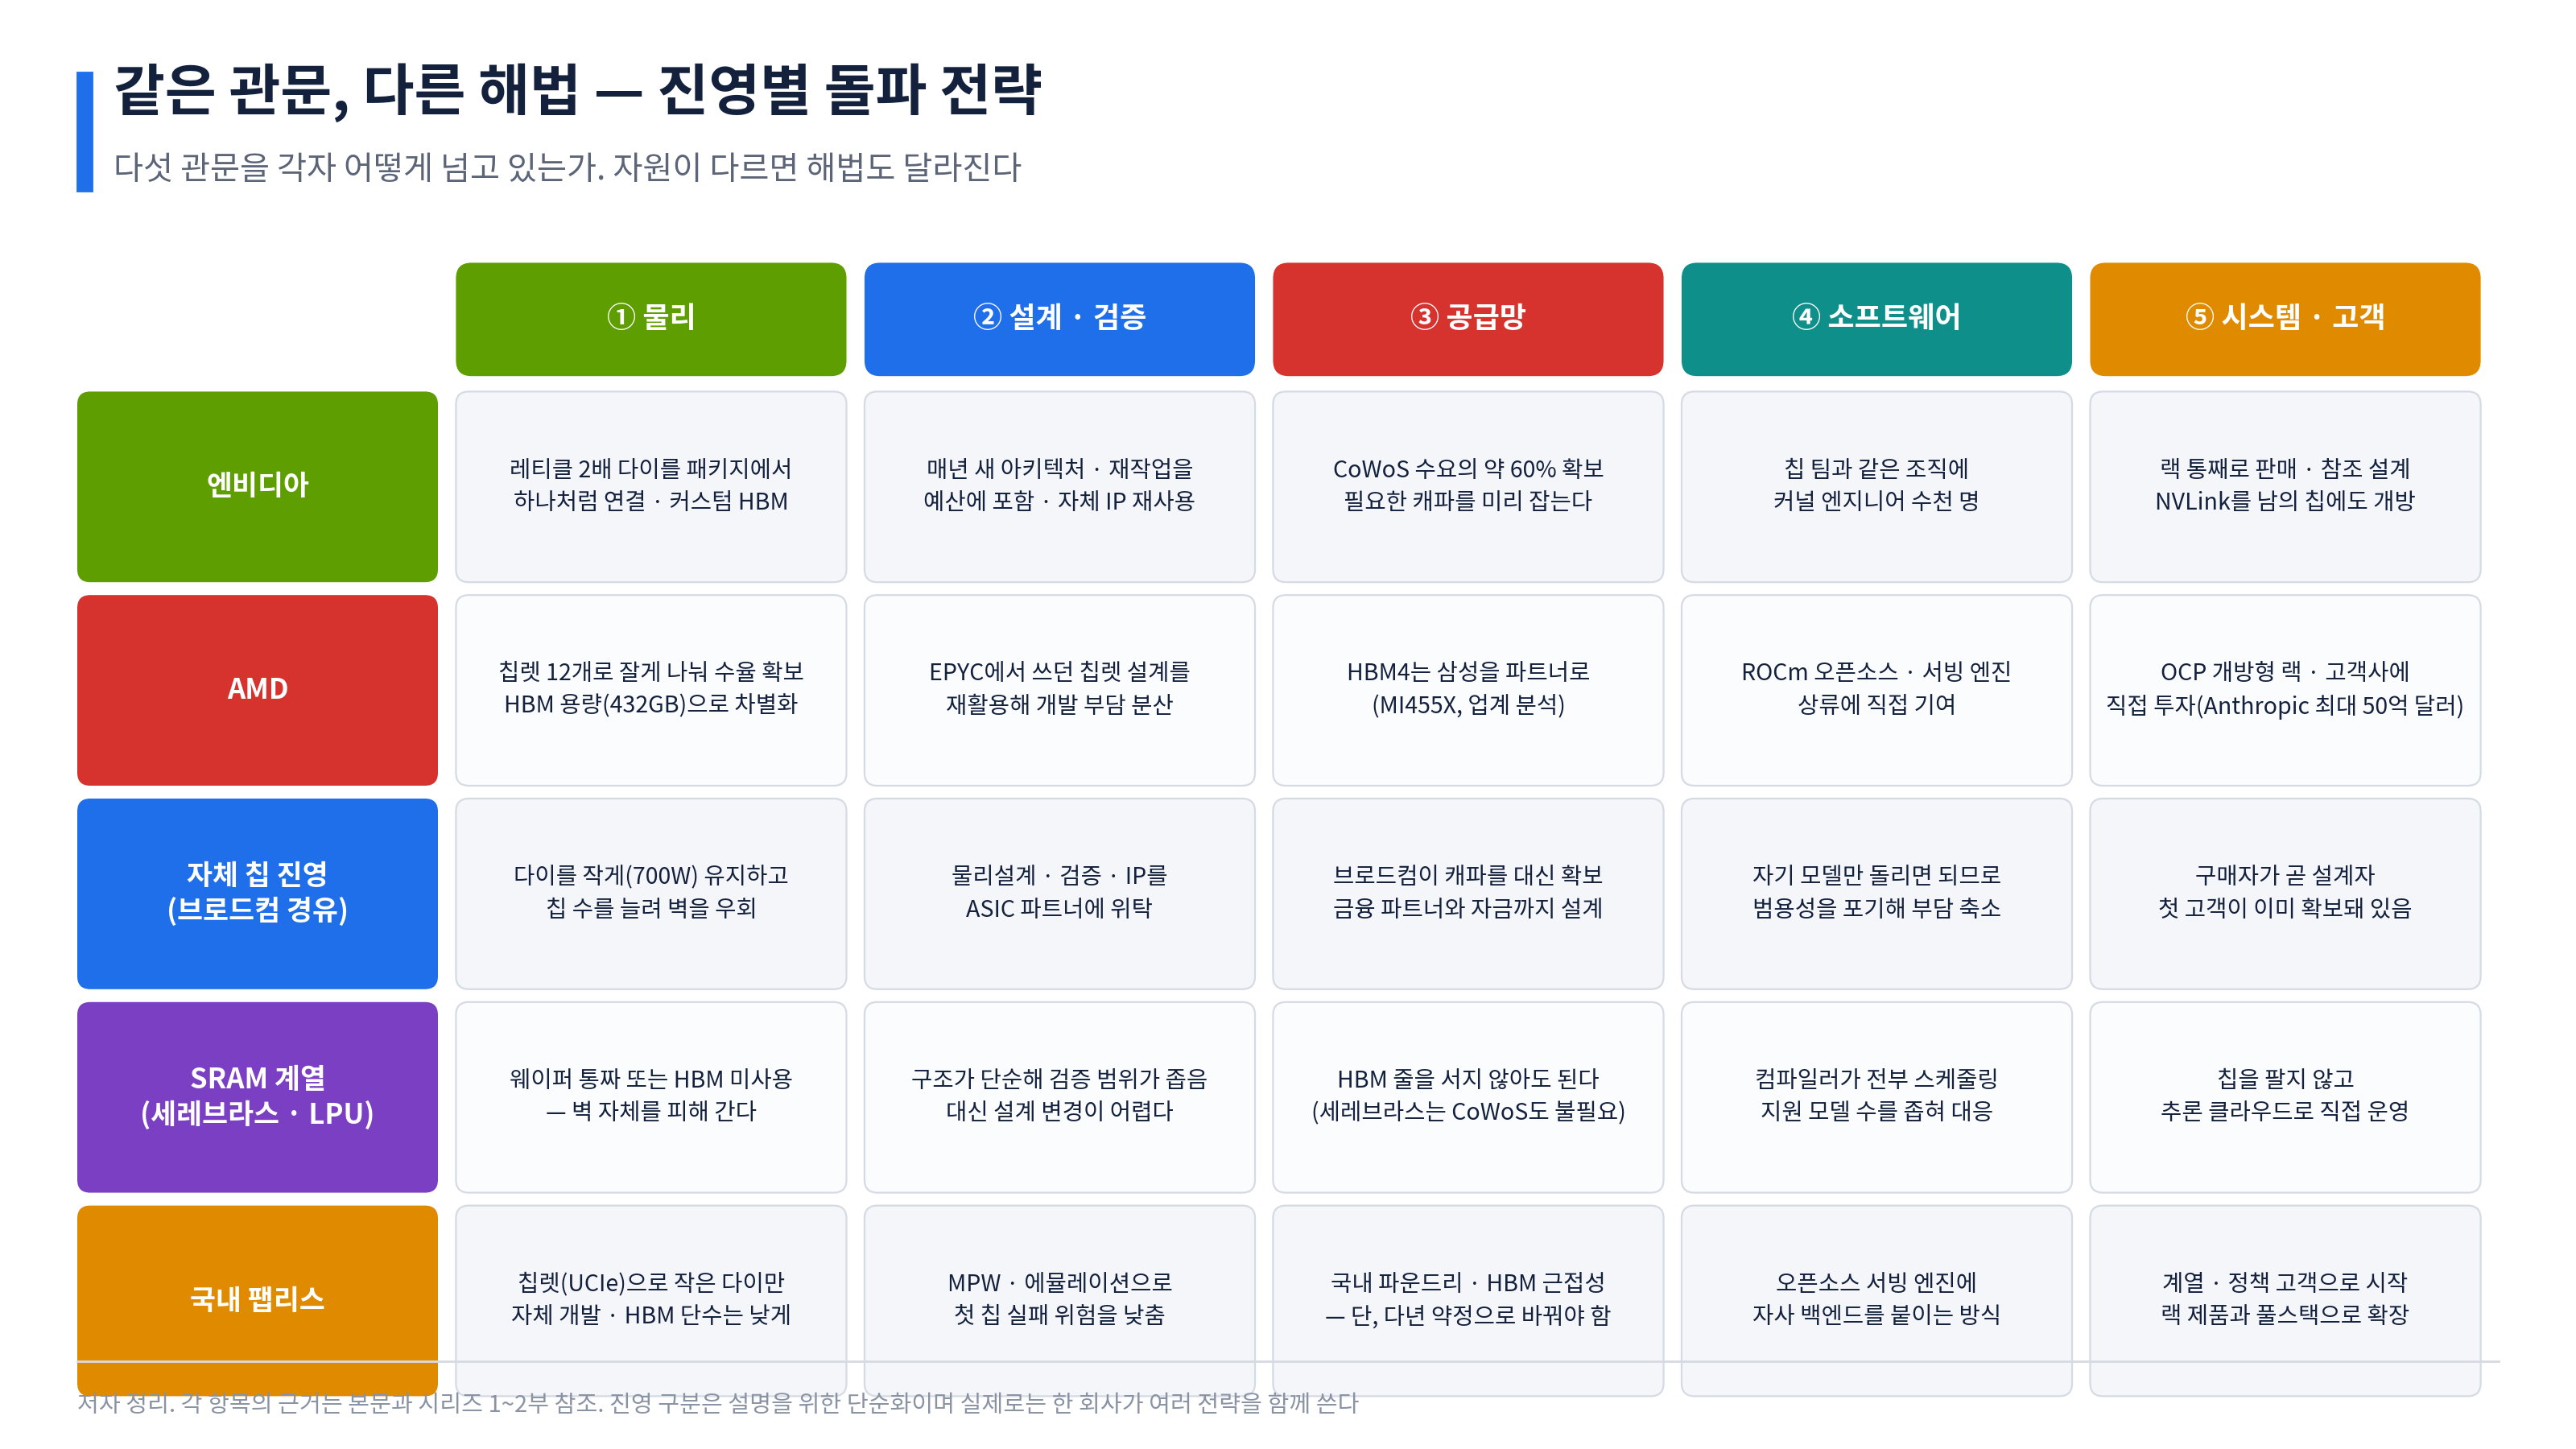
엔비디아 - 관문을 정면으로 돌파하고, 안 되면 사 온다. 물리에서는 레티클 한계 크기의 다이 두 개를 패키지 안에서 하나처럼 동작하게 붙였다. 메모리는 자체 사양 HBM으로 가고 있고, AWS와의 확대 계약에는 이 메모리를 쓰는 NVLink Fusion이 들어갔다(2부). 설계에서는 매년 새 아키텍처를 내며 핵심 회로를 자체 IP로 재사용하고, 공급망에서는 CoWoS의 약 60%를 잡았다. 소프트웨어에서는 칩 팀과 커널 팀을 한 조직에 두고 칩이 나온 뒤에도 성능을 끌어올린다. 시스템에서는 랙을 통째로 판다. 그리고 GPU로 안 되는 디코드 구간은 그록의 기술을 라이선스해 옆에 붙였다. 못 만들면 사 오는 것도 전략이라는 점을 보여 준 사례다.
AMD - 잘게 나누고, 표준에 올라타고, 고객을 붙든다. 물리에서는 반대 전략을 택했다. 큰 다이 대신 칩렛 12개로 잘게 나눠 수율을 확보하고, HBM 용량(432GB)을 엔비디아보다 50% 많이 실었다(1부). HBM4는 삼성전자와 손잡은 것으로 알려졌다.[9] 소프트웨어는 가장 약한 고리인데 오픈소스 ROCm과 서빙 엔진 기여로 메우려 한다. 시스템에서는 OCP 개방형 랙 규격을 쓰고 고객사에 직접 투자한다(1부). 엔비디아가 닫힌 수직계열이라면 AMD는 개방 표준 진영의 대표 선수로 서는 전략이다.
맞춤형 칩 진영(브로드컴 경유) - 어려운 허들을 남에게 맡긴다. 물리에서는 다이를 키우지 않는다. Jalapeño는 700W로 Rubin(약 2.3kW)의 3분의 1 수준이고, 대신 칩 수를 늘려 성능을 만든다. 설계·검증에서는 물리 설계와 IP를 브로드컴 같은 파트너에게 맡기고 자신은 아키텍처만 정한다. OpenAI가 Jalapeño를 설계 코드 작성부터 테이프아웃까지 9개월 만에 끝낸 배경이다(2부). 공급망은 브로드컴이 CoWoS의 15%를 잡아 대신 확보해 주고 자금까지 설계한다. 소프트웨어는 범용성을 포기해서 푼다. 남의 모델을 돌릴 필요가 없으니 지원해야 할 오퍼레이터 목록이 짧다. 시스템과 고객은 애초에 문제가 아니다. 구매자가 곧 설계자이기 때문이다. 다섯 허들 중 셋을 구조적으로 우회한 셈이다.
SRAM 계열(세레브라스·LPU) - 벽이 있는 길을 아예 가지 않는다. 세레브라스는 웨이퍼 한 장을 통째로 칩으로 쓰니 인터포저 패키징 경쟁에 참여하지 않는다. LPU는 HBM을 쓰지 않아 HBM 배정 경쟁에서 빠진다. 공급망 관문을 통째로 건너뛰는 것이다. 대신 구조가 특수해 설계를 바꾸기 어렵고 메모리 용량이 작다. 소프트웨어는 컴파일러가 전부 스케줄링하는 방식으로 풀고, 시스템에서는 칩을 파는 대신 추론 클라우드를 직접 운영하는 쪽으로 옮겨 갔다(2부). 관문을 통과하는 대신 관문이 없는 길을 찾은 사례다.
국내 팹리스 - 남의 힘을 빌릴 수 있는 관문부터 넘는다. 물리에서는 칩렛으로 작은 다이만 자체 개발하고 나머지는 표준에 맡긴다. 칩렛끼리 대화하는 업계 표준 규격이 UCIe인데, 리벨리온은 이 규격으로 칩렛 네 개를 이었다(2부). 설계·검증에서는 MPW와 에뮬레이션으로 첫 칩 실패 위험을 낮춘다. 공급망은 국내에 파운드리와 HBM이 있다는 근접성이 강점이지만, 퓨리오사AI의 인도 지연이 보여 주듯 근접성이 곧 순번은 아니다. 소프트웨어는 처음부터 자체 스택을 만들기보다 오픈소스 서빙 엔진에 자사 백엔드를 붙이는 방식이 효율적이다. 시스템에서는 계열·정책 고객으로 시작해 랙 제품과 해외 데이터센터로 넓히는 경로가 보인다.
다섯 해법을 비교하면 하나의 원칙이 보인다. 자원이 압도적인 회사는 관문을 정면으로 돌파하고, 모델을 가진 회사는 관문을 우회하며, 자원이 부족한 회사는 관문을 피하거나 남의 힘을 빌린다. 어느 쪽도 틀리지 않았다. 다만 어떤 전략을 택했는지에 따라 그 회사가 감당해야 할 다음 위험이 달라진다. 정면 돌파는 실행 위험을, 우회는 범용성 상실을, 회피는 확장성의 한계를, 차용은 통제권 부족을 남긴다.
11. 한국 팹리스의 자리
국내 상황을 이 틀에 대보면 강점과 약점이 선명하다.
가장 먼저 봐야 할 숫자는 이 대비다. 2024년 국가별 점유율에서 한국은 메모리 반도체 시장의 63%를 차지하지만, 비메모리에서는 3%다.[20] 팹리스만 떼어 보면 더 작다. IC인사이츠 기준 2022년 글로벌 팹리스 시장에서 한국 기업의 점유율은 1%로, 미국 68%, 대만 21%, 중국 9%와 큰 차이가 난다.[20] 한국팹리스산업협회장은 점유율 1~2%대의 정체를 벗어나 '3%의 벽'을 깨는 것을 목표로 제시하며 MPW 확대와 수요 기업 인센티브를 요구했다.[20]
강점은 ③에 있다. 삼성 파운드리와 첨단 패키징, SK하이닉스와 삼성전자의 HBM이 국내에 있다. 세계 어느 스타트업도 갖지 못한 조건이다. 1부에서 본 Groq 3 LPU가 삼성 파운드리 4nm에서 생산되고, 리벨리온의 리벨쿼드도 삼성 4nm와 HBM3E를 쓴다. 다만 근접성이 곧 접근권은 아니다. 다년 캐파 약정, 수율 학습, 보드·랙 인증으로 바뀌어야 실제 해자가 된다.
약점은 ②와 ④에 걸쳐 있다. 메모리 강국이라는 사실이 비메모리 설계의 노하우로 이어지지 않았다. 첫 칩 성공률이 노하우의 싸움이라는 4장의 결론을 떠올리면, 이 점이 가장 큰 제약이다. 소프트웨어 인력의 절대 규모가 헤일로의 사례처럼 모델이 나올 때마다 SDK를 고쳐야 하는 부담을 감당할 만한지도 따져 봐야 한다.
⑤는 아직 열려 있는 질문이다. 자본은 모였다. 리벨리온은 3월에 국민성장펀드 2,500억원을 포함한 6,400억원의 프리IPO 투자를 마쳐 누적 1조 3,000억원, 기업가치 3조 4,000억원이 됐다.[21] 퓨리오사AI는 기업가치 3조원을 제시하며 프리IPO를 진행 중이다.[21] 반면 매출은 아직 작다. 리벨리온의 2024년 매출은 103억원에 순손실 2,338억원이었고, 2025년 매출은 350억원이다.[21] 제품도 나왔다. 퓨리오사AI는 1차 양산분 4,000장을 받았고 스웨덴 데이터센터에 8,800장 이상을 공급하기로 했으며, 리벨리온은 H200급을 내세운 리벨100을 하반기에 본격 양산한다(2부, [21]). 다음 증거는 계열·정책 고객 밖에서 나오는 재주문이다.
필자의 판단은 이렇다. 국내 팹리스의 현실적인 경로는 관문 ③의 강점을 지렛대 삼아 ④와 ⑤를 사는 것이다. 구체적으로는 두 가지다. 하나는 4부에서 볼 망고부스트처럼 칩 단품이 아니라 시스템으로 올라가는 길이다. 다른 하나는 인수 사례가 보여 준 길, 즉 GPU 정면 대체 대신 큰 회사의 제품군에 빈칸으로 들어가는 것이다. 어느 쪽이든 IR의 첫 장을 성능 수치로 채우는 전략과는 다른 준비가 필요하다.
투자 관점 체크포인트
1) 딜 검토에서 벤치마크는 관문 ①의 증거로만 취급한다. ②~⑤의 증거는 별도로 요구한다.
2) 설계비 추정치보다 재작업 이력을 본다. 첫 칩이 한 번에 동작했는지, 재작업이 있었다면 원인이 사양 변경이었는지가 설계 조직의 성숙도를 보여 준다.
3) 공급 확보는 MOU가 아니라 다년 캐파 약정과 2차 공급원, 그리고 주문에서 인도까지 실제로 걸린 기간으로 확인한다.
4) 소프트웨어는 "지원한다"가 아니라 "며칠 만에 지원했다"로 확인한다. 최근 모델 3~4개의 공개일과 제 속도로 돌기 시작한 날의 간격, 그리고 전체 인력 중 소프트웨어 인력의 비중을 묻는다.
5) 랙 단위 역량은 따로 묻는다. 하나의 도메인으로 묶어 본 최대 칩 수, 그 규모의 전대전 통신 실측, 전문가 쏠림 조정 기능, 기능을 동시에 켠 상태의 성능, 장기 연속 가동 기록.
6) 엑싯을 M&A로 본다면, 인수자가 사는 것은 전체 대체품이 아니라 자기 제품군의 빈칸이라는 점을 전제로 포지션을 짠다.
Conclusion
AI 칩이 어려운 이유는 설계가 어려워서가 아니다. 통과해야 할 관문이 다섯인데 뒤의 셋은 자기 힘만으로 열 수 없기 때문이다. 물리는 스펙을 올리는 방법을 세 가지로 제한하고, 그 셋 모두 전력과 열이라는 같은 벽에 닿아 있다. 설계비 자체는 생각보다 결정적이지 않지만 첫 칩이 한 번에 성공할 확률은 5%까지 떨어졌고, 칩을 직접 설계하기 시작한 회사일수록 더 자주 실패한다. 패키징과 HBM은 상위 몇 곳이 미리 잡아 두어 나머지 모두의 몫이 15% 미만이다. (TSMC 입장에서도 굳이 잘 팔리는 대형 고객들이 있는데, 굳이 작은 곳에 물량을 줄 이유가 많지는 않다.) 소프트웨어는 칩이 돌아가는 것과 고객이 쓰는 것 사이에 일곱 개의 벽을 세우고, 그 벽을 넘어도 수십 개 칩을 한 대의 컴퓨터처럼 돌리는 일이 남는다. 그래서 팹리스의 경쟁력은 다이의 성능이 아니라 이 다섯 관문 중 몇 개를 자기 힘으로 통과했는가로 매겨진다. 인수된 회사들이 무엇으로 팔렸는지가 그 값을 대신 말해 준다.
다음 부 예고
4부부터는 다시 시스템으로 돌아간다. 가속기와 가속기, 랙과 랙을 묶는 네트워크 반도체를 다룬다. DPU와 SuperNIC이 왜 서버의 필수 부품이 됐는지, 스케일업용 스위치(NVLink 스위치, UALink, 이더넷 기반 스케일업)와 스케일아웃용 스위치 ASIC이 어떻게 다른지, 리타이머와 CPO 스위치가 어디에 들어가는지를 정리한다. 2부에서 본 세 가지 스케일업 철학이 실제로 어떤 칩으로 구현되는지, 그리고 이 글에서 본 랙 단위 난제를 어떤 하드웨어가 떠받치는지가 주제다.
Reference
[1] 레티클·인터포저·CoWoS — TSMC 3DFabric CoWoS 페이지 https://3dfabric.tsmc.com/english/dedicatedFoundry/technology/cowos.htm ; Tom's Hardware(5.5배·12스택, 2024.11.27) https://www.tomshardware.com/tech-industry/tsmc-super-carrier-cowos-interposer-gets-bigger-enabling-massive-ai-chips-to-reach-9-reticle-sizes-with-12-hbm4-stacks ; Tom's Hardware(14배 이상, 2026.4.27) https://www.tomshardware.com/tech-industry/semiconductors/tsmcs-details-next-gen-cowos-roadmap-over-14-reticle-packages-and-48x-leap-in-compute-power-expected-by-2029-massive-size-enables-24-hbm5e-stacks-and-additional-memory-bandwidth-jump ; IFTLE 615(2027년 약 9배) https://www.3dincites.com/2024/12/iftle-615-tsmc-evolves-cowos-technology-promising-9x-reticle-size-by-2027/ ; Wikipedia(Hopper 814㎟, Blackwell 두 다이) https://en.wikipedia.org/wiki/Blackwell_(microarchitecture)
[2] HBM 적층 — Introl, “The AI Memory Supercycle”(안기현 전무 발언), 2026.1 https://introl.com/blog/ai-memory-supercycle-hbm-2026 ; Tom's Hardware(SK하이닉스 Hot Chips 2026: 16단 다이 약 50μm·하이브리드 본딩 HBM5로·HBM 냉각 구조) https://www.tomshardware.com/tech-industry/semiconductors/sk-hynix-says-hybrid-bonding-wont-be-ready-for-hbm4e-as-ai-memory-runs-into-a-775-micron-ceiling ; Vik's Newsletter(JEDEC 높이 한도) https://www.viksnewsletter.com/p/why-is-hbm-so-hard-to-manufacture
[3] 전력 전달 — Semiconductor Engineering, “Power Delivery Challenges For AI Chips” https://semiengineering.com/power-delivery-challenges-for-ai-chips/ ; Electronic Design(수직 전력 공급), 2024.10.22 https://electronicdesign.com/technologies/power/article/55237347/electronic-design-empowers-voltage-regulator-ic-enables-vertical-power-delivery-for-ai-chips
[4] IBS 설계비 추정 — Tom's Hardware, “Firm Estimates a 2nm Chip Now Costs $725 Million to Design”, 2023.8.31 https://www.tomshardware.com/news/firm-estimates-a-2nm-chip-now-costs-dollar725-million-to-design ; The Transcript(ARM 증권신고서 인용, 7nm 2.49억 달러) https://x.com/TheTranscript_/status/1694122303691624819
[5] SemiAnalysis, “The Dark Side Of The Semiconductor Design Renaissance” https://semianalysis.substack.com/p/the-dark-side-of-the-semiconductor ; Silicon Analysts(IBS 추정과 실제 비용 차이) https://siliconanalysts.com/market-data/nre-design-cost
[6] Siemens EDA · Wilson Research Group 기능검증 조사 — 2026년 결과(Verification Horizons, 2026.9.8) https://blogs.sw.siemens.com/verificationhorizons/2026/09/08/the-2026-functional-verification-study/ ; 2024년 백서 https://resources.sw.siemens.com/en-US/white-paper-2024-wilson-research-group-ic-asic-functional-verification-trend-report/ ; 2022년 결과(SemiWiki) https://semiwiki.com/eda/324443-the-state-of-ic-and-asic-functional-verification/ ; 해리 포스터, “Why First-Silicon Success Is Getting Harder for System Companies” https://blogs.sw.siemens.com/verificationhorizons/2025/09/03/why-first-silicon-success-is-getting-harder-for-system-companies/
[7] Semiconductor Engineering, “First-Time Silicon Success Plummets”, 2025.4.22 https://semiengineering.com/first-time-silicon-success-plummets/
[8] CoWoS 배정(모건스탠리 추정) — Astute Group, 2025.8.4 https://www.astutegroup.com/news/industrial/advanced-packaging-demand-soars-nvidia-secures-60-of-cowos-capacity/ ; 36Kr(스타트업 몫 15% 미만), 2025.12.4 https://eu.36kr.com/en/p/3580962946874242 ; Silicon Analysts(리드타임·집계 단서), 2026.6 https://siliconanalysts.com/analysis/foundry-allocation-status-q1-2026
[9] HBM — Momoview(TrendForce · Silicon Analysts 인용: 예약·후공정 병목·가격·고객 배정), 2026.5.21 https://momoview.com/blog/en/posts/hbm-industry-analysis-sk-hynix-samsung-micron-2026-ai-memory-supercycle-investment-thesis/ ; Silicon Analysts HBM 가격 https://siliconanalysts.com/data/hbm-pricing ; Tom's Hardware(고객들의 수년 앞선 예약), 2026.4.30 https://www.tomshardware.com/tech-industry/artificial-intelligence/samsung-and-sk-hynix-warn-ai-driven-memory-shortages-could-last-until-2027-and-beyond-as-hbm-demand-explodes-customers-already-reserving-supply-years-ahead-while-the-wider-dram-market-begins-to-tighten
[10] 유니콘팩토리, “퓨리오사AI, AI반도체 실적 가시화…TSMC서 4000장 인도”, 2026.1.28 https://www.unicornfactory.co.kr/article/2026012811212239774
[11] Computer Weekly, “CUDA at 20: From billion-dollar gamble to agentic AI”, 2026.3.23 https://www.computerweekly.com/news/366640614/CUDA-at-20-From-billion-dollar-gamble-to-agentic-AI
[12] Hugging Face 토론, “From 'Doesn't Work' to 641 tok/s: GLM-5.1 NVFP4 on 6× RTX PRO 6000 Blackwell”, 2026.4 https://huggingface.co/lukealonso/GLM-5.1-NVFP4/discussions/4
[13] SemiAnalysis, “Graphcore Looks Like A Complete Failure In Machine Learning Training Performance” https://newsletter.semianalysis.com/p/graphcore-looks-like-a-complete-failure ; Wikipedia(그래프코어 재무) https://en.wikipedia.org/wiki/Graphcore ; ITWorld(소프트뱅크 인수), 2024.11.4 https://www.itworld.co.kr/article/3548544/
[14] ZDNet Korea, “그록부터 헤일로까지…해외 AI 칩 스타트업 'M&A 도미노' 왜?”, 2026.7.30 https://zdnet.co.kr/view/?no=20260729162837
[15] “ViBE: Co-Optimizing Workload Skew and Hardware Variability for MoE Serving”, arXiv 2606.00735 https://arxiv.org/pdf/2606.00735
[16] SGLang EPLB 문서(NVIDIA Dynamo 문서 보관본) https://docs.nvidia.com/dynamo/archive/0.8.0/backends/sglang/expert-distribution-eplb.html ; vLLM EPLB 문서 https://docs.vllm.ai/projects/ascend/en/latest/user_guide/feature_guide/expert_parallelism_load_balancer/
[17] VLSI Korea, “Graphcore 이후: AI 칩 스타트업 실패·M&A가 보여준 것”, 2026.7.17 https://www.vlsi.kr/ko/ai-chip-startup-failures-ma-lessons-2026/
[18] 마벨, “Marvell Completes Acquisition of Celestial AI” https://investor.marvell.com/news-events/press-releases/detail/1005/marvell-completes-acquisition-of-celestial-ai ; Nasdaq(인수가·조건) https://www.nasdaq.com/articles/marvell-acquire-celestial-ai-325-bln-deal ; Yahoo Finance(아마존 워런트) https://finance.yahoo.com/news/marvell-buy-chip-startup-celestial-210837707.html
[19] 퀄컴, “Qualcomm Completes Acquisition of Alphawave Semi”, 2025.12.18 https://www.qualcomm.com/news/releases/2025/12/qualcomm-completes-acquisition-of-alphawave-semi ; 인수 발표(기업가치 약 24억 달러), 2025.6.9 https://seekingalpha.com/pr/20129696-qualcomm-to-acquire-alphawave-semi
[20] 삼일PwC, “K-팹리스” 보고서(2024년 국가별 메모리·비메모리 점유율) https://www.pwc.com/kr/ko/insights/industry-focus/samilpwc_k-fabless.pdf ; 매거진한경(IC인사이츠 2022년 팹리스 점유율), 2025.2.12 https://magazine.hankyung.com/business/article/202502121579b ; 아이뉴스24(한국팹리스산업협회장 인터뷰) https://inews24.com/view/1948944
[21] 유니콘팩토리(리벨리온 프리IPO), 2026.3.31 https://www.unicornfactory.co.kr/article/2026033111025632012 ; 혁신의숲(리벨리온 매출·손실) https://www.innoforest.co.kr/report/423/ ; 딜사이트(퓨리오사AI 프리IPO), 2026.5.14 https://dealsite.co.kr/articles/161657 ; 유니콘팩토리(리벨100 양산 시점) https://www.unicornfactory.co.kr/hashtag/%EB%A6%AC%EB%B2%A8%EB%A6%AC%EC%98%A8?page=2
이 글은 공개 자료를 바탕으로 한 개인적인 공부 기록이며 투자 권유가 아니다. 투자 판단과 책임은 본인에게 있다.
반응형'최신 기술동향 > 2차전지 & 반도체' 카테고리의 다른 글
[AI 데이터센터 반도체 5부] 메모리 반도체와 전력 반도체 (2) 2026.09.27 [AI 데이터센터 반도체 4부] 가속기를 묶는 칩 (DPU, 스위치) (0) 2026.09.26 [AI 데이터센터 반도체 2부] AI 가속기 (ASIC, NPU) (0) 2026.09.24 [AI 데이터센터 반도체 1부] 칩이 아니라 랙을 판다 (GPU) (0) 2026.09.21 AI 전력 병목의 단기 해법, ESS와 LFP - 비중국 밸류체인은 가능한가 (1) 2026.08.08