-
[AI 데이터센터 반도체 2부] AI 가속기 (ASIC, NPU)최신 기술동향/2차전지 & 반도체 2026. 9. 24. 10:00
GPU가 아닌 AI 칩은 '더 빠른 칩'이 아니라 '다르게 배분한 칩'이다. 같은 전력 예산을 연산 대신 메모리에, 범용성 대신 한 가지 일에 몰아 준다. 그 대가로 모델이 바뀔 때 버틸 여지를 잃는다. 그래서 이 칩들의 승부는 성능표가 아니라 "누가 그 대가를 감당할 수 있는가"에서 갈린다.
1. 1부 요약, 그리고 이름부터
1부의 결론은 추론의 경제성을 칩 하나가 아니라 '하나의 저지연 도메인'이 정한다는 것이었다. 디코드 속도의 상한은 도메인 전체의 메모리 대역폭 합을 스텝마다 읽는 바이트로 나눈 값이고, 그 값을 올리는 레버는 대역폭, 용량, 스케일업 세 가지다. 2부는 이 기준을 GPU 외의 가속기에 적용한다. 간단히 정리하면,
GPU는 원래 화면을 그리려고 만든 칩이다. 같은 계산을 수만 번 동시에 하는 구조가 AI와 잘 맞아 지금의 자리에 올랐다. 무엇이든 돌릴 수 있는 범용 칩이고, 그래서 덜 쓰는 회로도 함께 싣고 다닌다.
ASIC은 '특정 용도로 맞춘 반도체'다. 처음부터 할 일을 정해 두고 그 일에만 필요한 회로를 넣는다. 다양한 기능을 할 수 있는 칩이 GPU라면 ASIC은 한 가지 작업에 맞춰 짠 전용 칩다. 남는 회로가 없으니 같은 전력으로 더 많은 일을 하지만, 정해 둔 일이 바뀌면 쓸모가 줄어든다. 구글 TPU, OpenAI Jalapeño, AWS Trainium, 메타 MTIA, 마이크로소프트 Maia가 모두 ASIC이다.
NPU는 AI 연산에 맞춘 칩을 부르는 더 일반적인 말이다. 스마트폰 안에도 있고 데이터센터용도 있다. 국내의 리벨리온과 퓨리오사AI가 만드는 것이 여기에 해당한다. XPU는 브로드컴이 고객 맞춤형 칩을 부를 때 쓰는 말이다.
경계가 칼같이 나뉘지는 않는다. 중요한 것은 이름이 아니라 "얼마나 좁은 일에 맞췄는가"다.
2. 각 칩의 주요 역할들
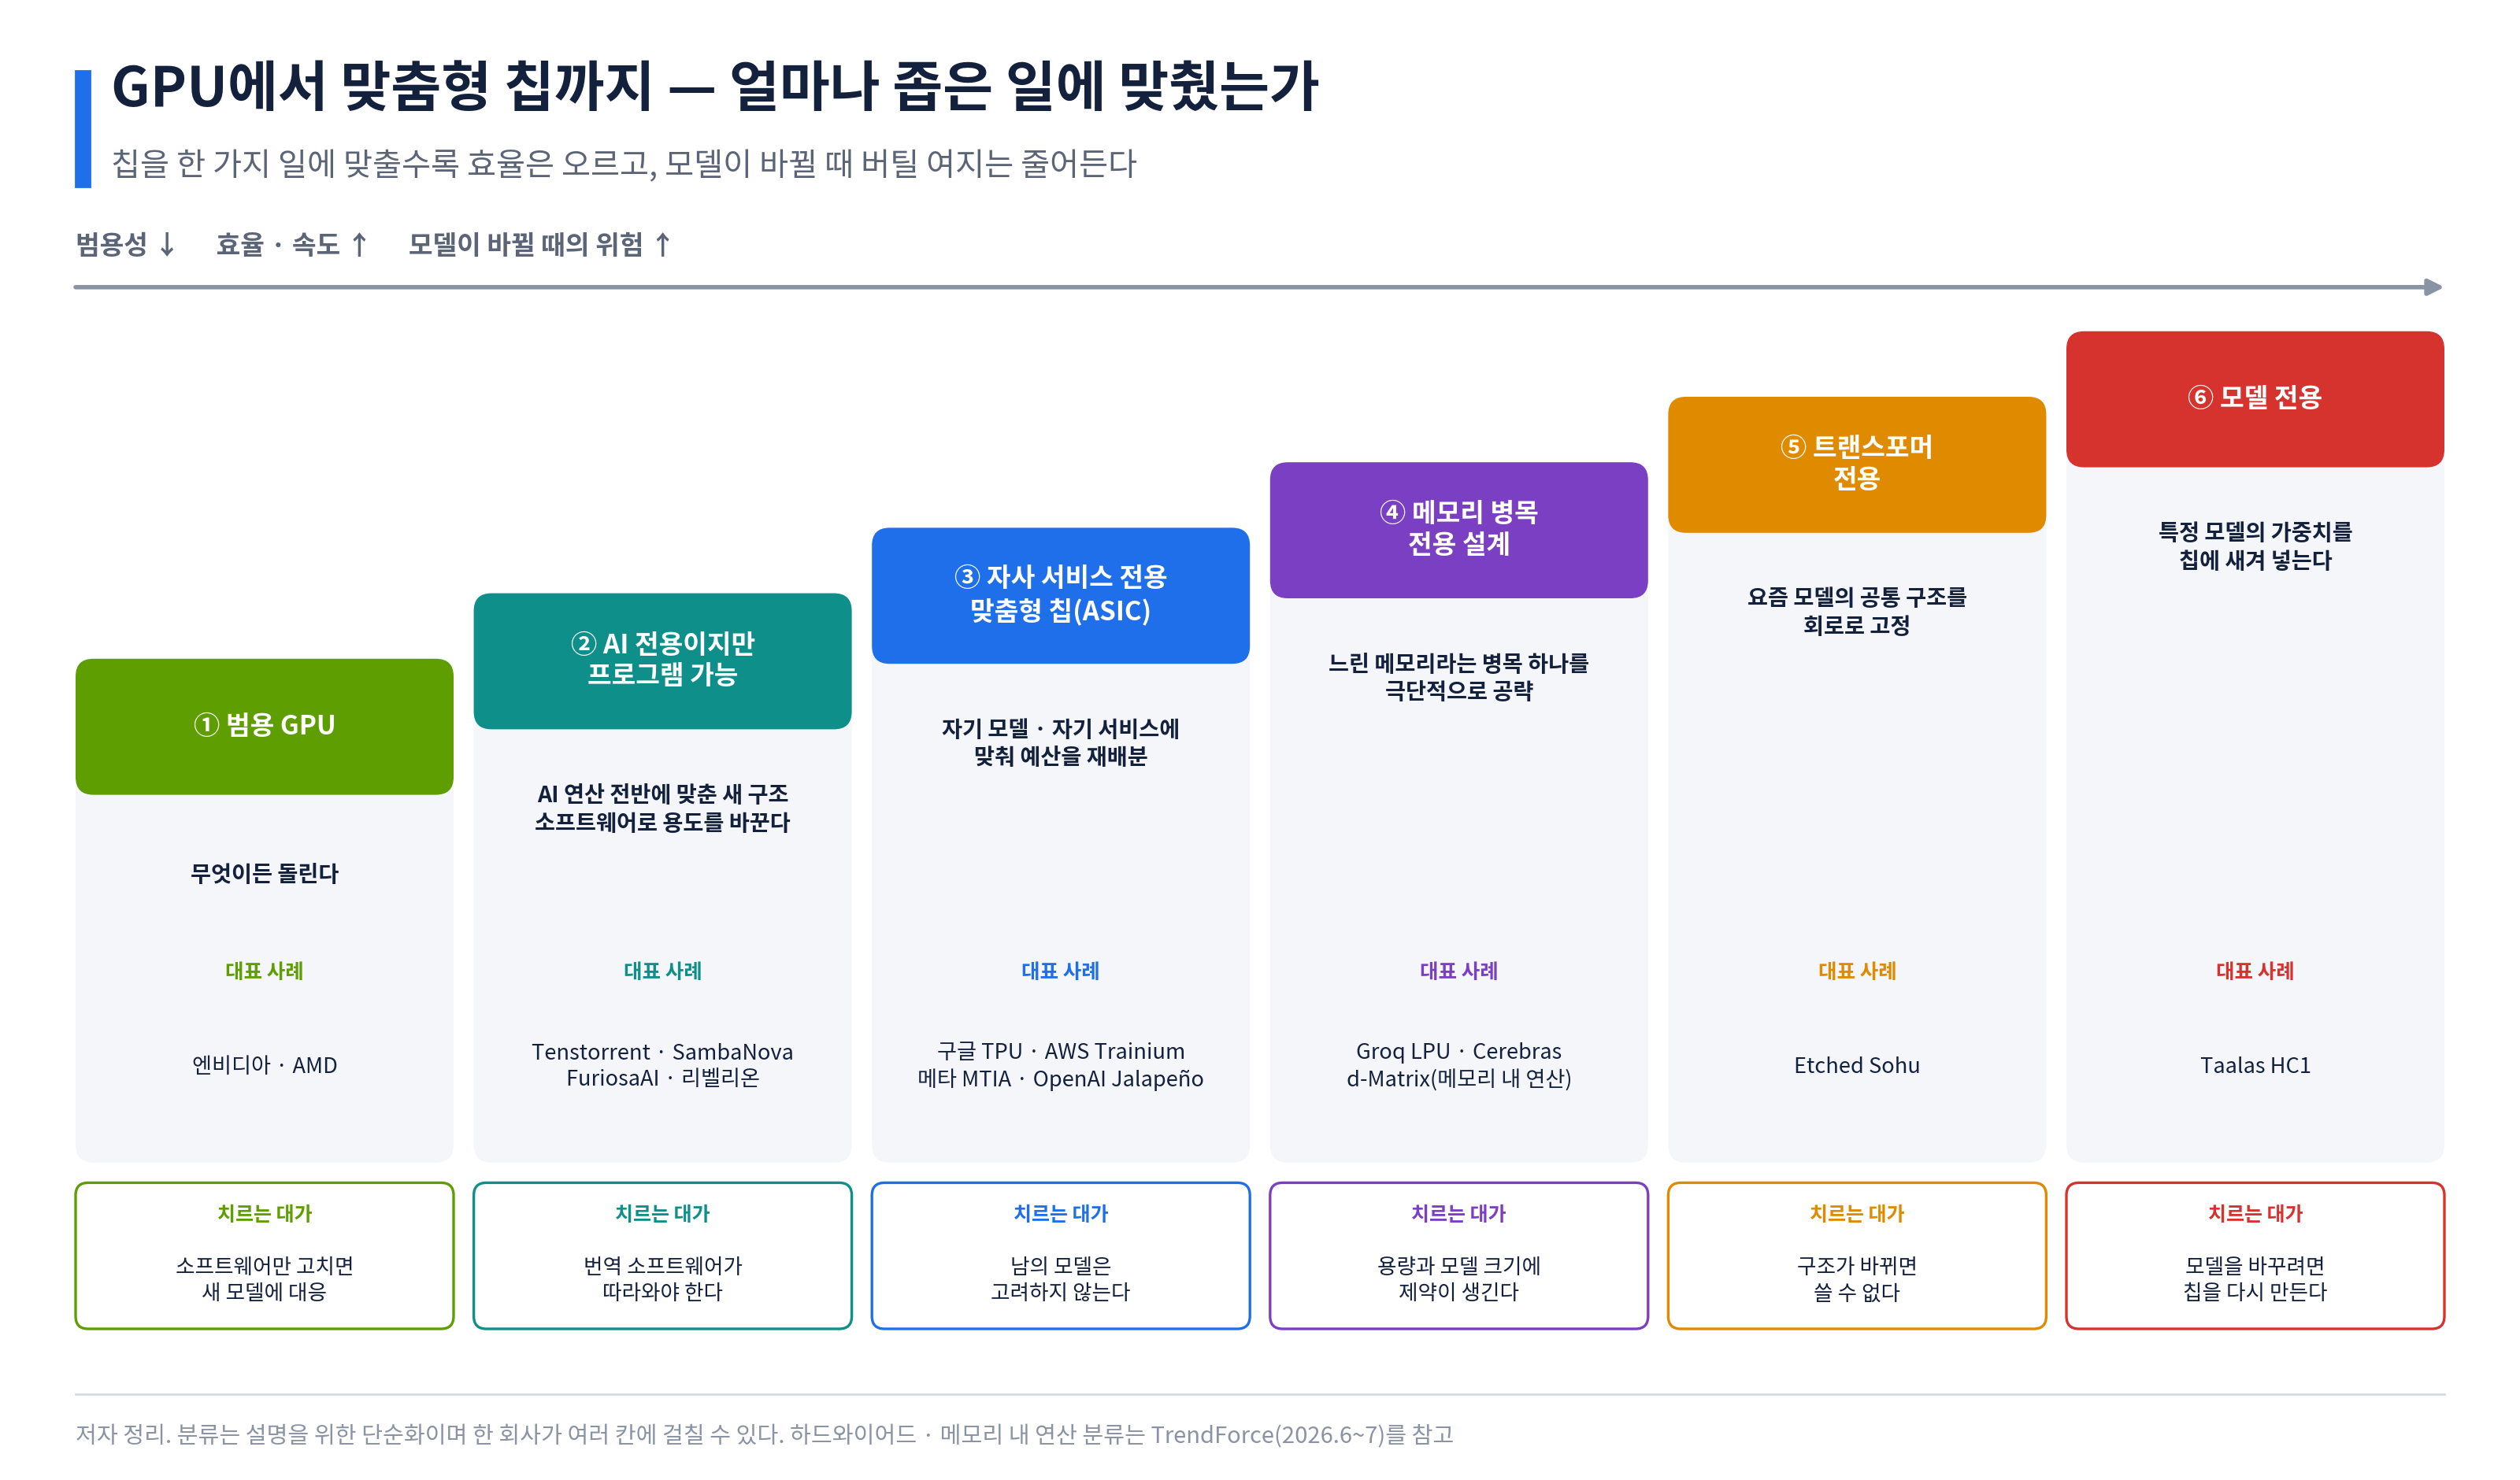
맨 아래에는 무엇이든 돌리는 범용 GPU가 있다. 한 칸 오르면 AI 연산에 맞춰 구조를 새로 짰지만 소프트웨어로 용도를 바꿀 수 있는 칩이 있고, 그 위에 자기 회사의 모델과 서비스에만 맞춘 맞춤형 칩이 있다. 더 오르면 메모리 병목 하나만 극단적으로 공략한 칩이, 그 위에 트랜스포머라는 모델 구조를 회로로 고정한 칩이, 맨 꼭대기에는 특정 모델의 값 자체를 칩에 새겨 넣은 칩이 있다.
오를수록 효율과 속도는 올라간다. 필요 없는 회로를 덜어 내고 남은 면적과 전력을 한 가지 일에 몰아 주기 때문이다. 대신 모델이 바뀌었을 때 버틸 여지가 줄어든다. 맨 아래에서는 소프트웨어만 고치면 되지만, 맨 위에서는 칩을 다시 만들어야 한다. 어느 칸을 골랐는지가 곧 그 회사가 모델의 미래에 건 내기다. 이하에서는 아래 칸부터 위 칸으로 올라가며 각 진영을 본다.
3. 브로드컴이라는 통로 - 맞춤형 칩 시장을 숫자로 보면
구글 TPU를 비롯한 주요 맞춤형 칩의 상당수가 브로드컴을 거쳐 실제 실리콘이 된다. 고객은 아키텍처를 정하고, 브로드컴은 물리 설계와 고속 통신 회로, 패키징, 제조 물량 확보를 맡는다. 그래서 이 시장의 크기는 브로드컴의 실적에서 가장 잘 보인다.
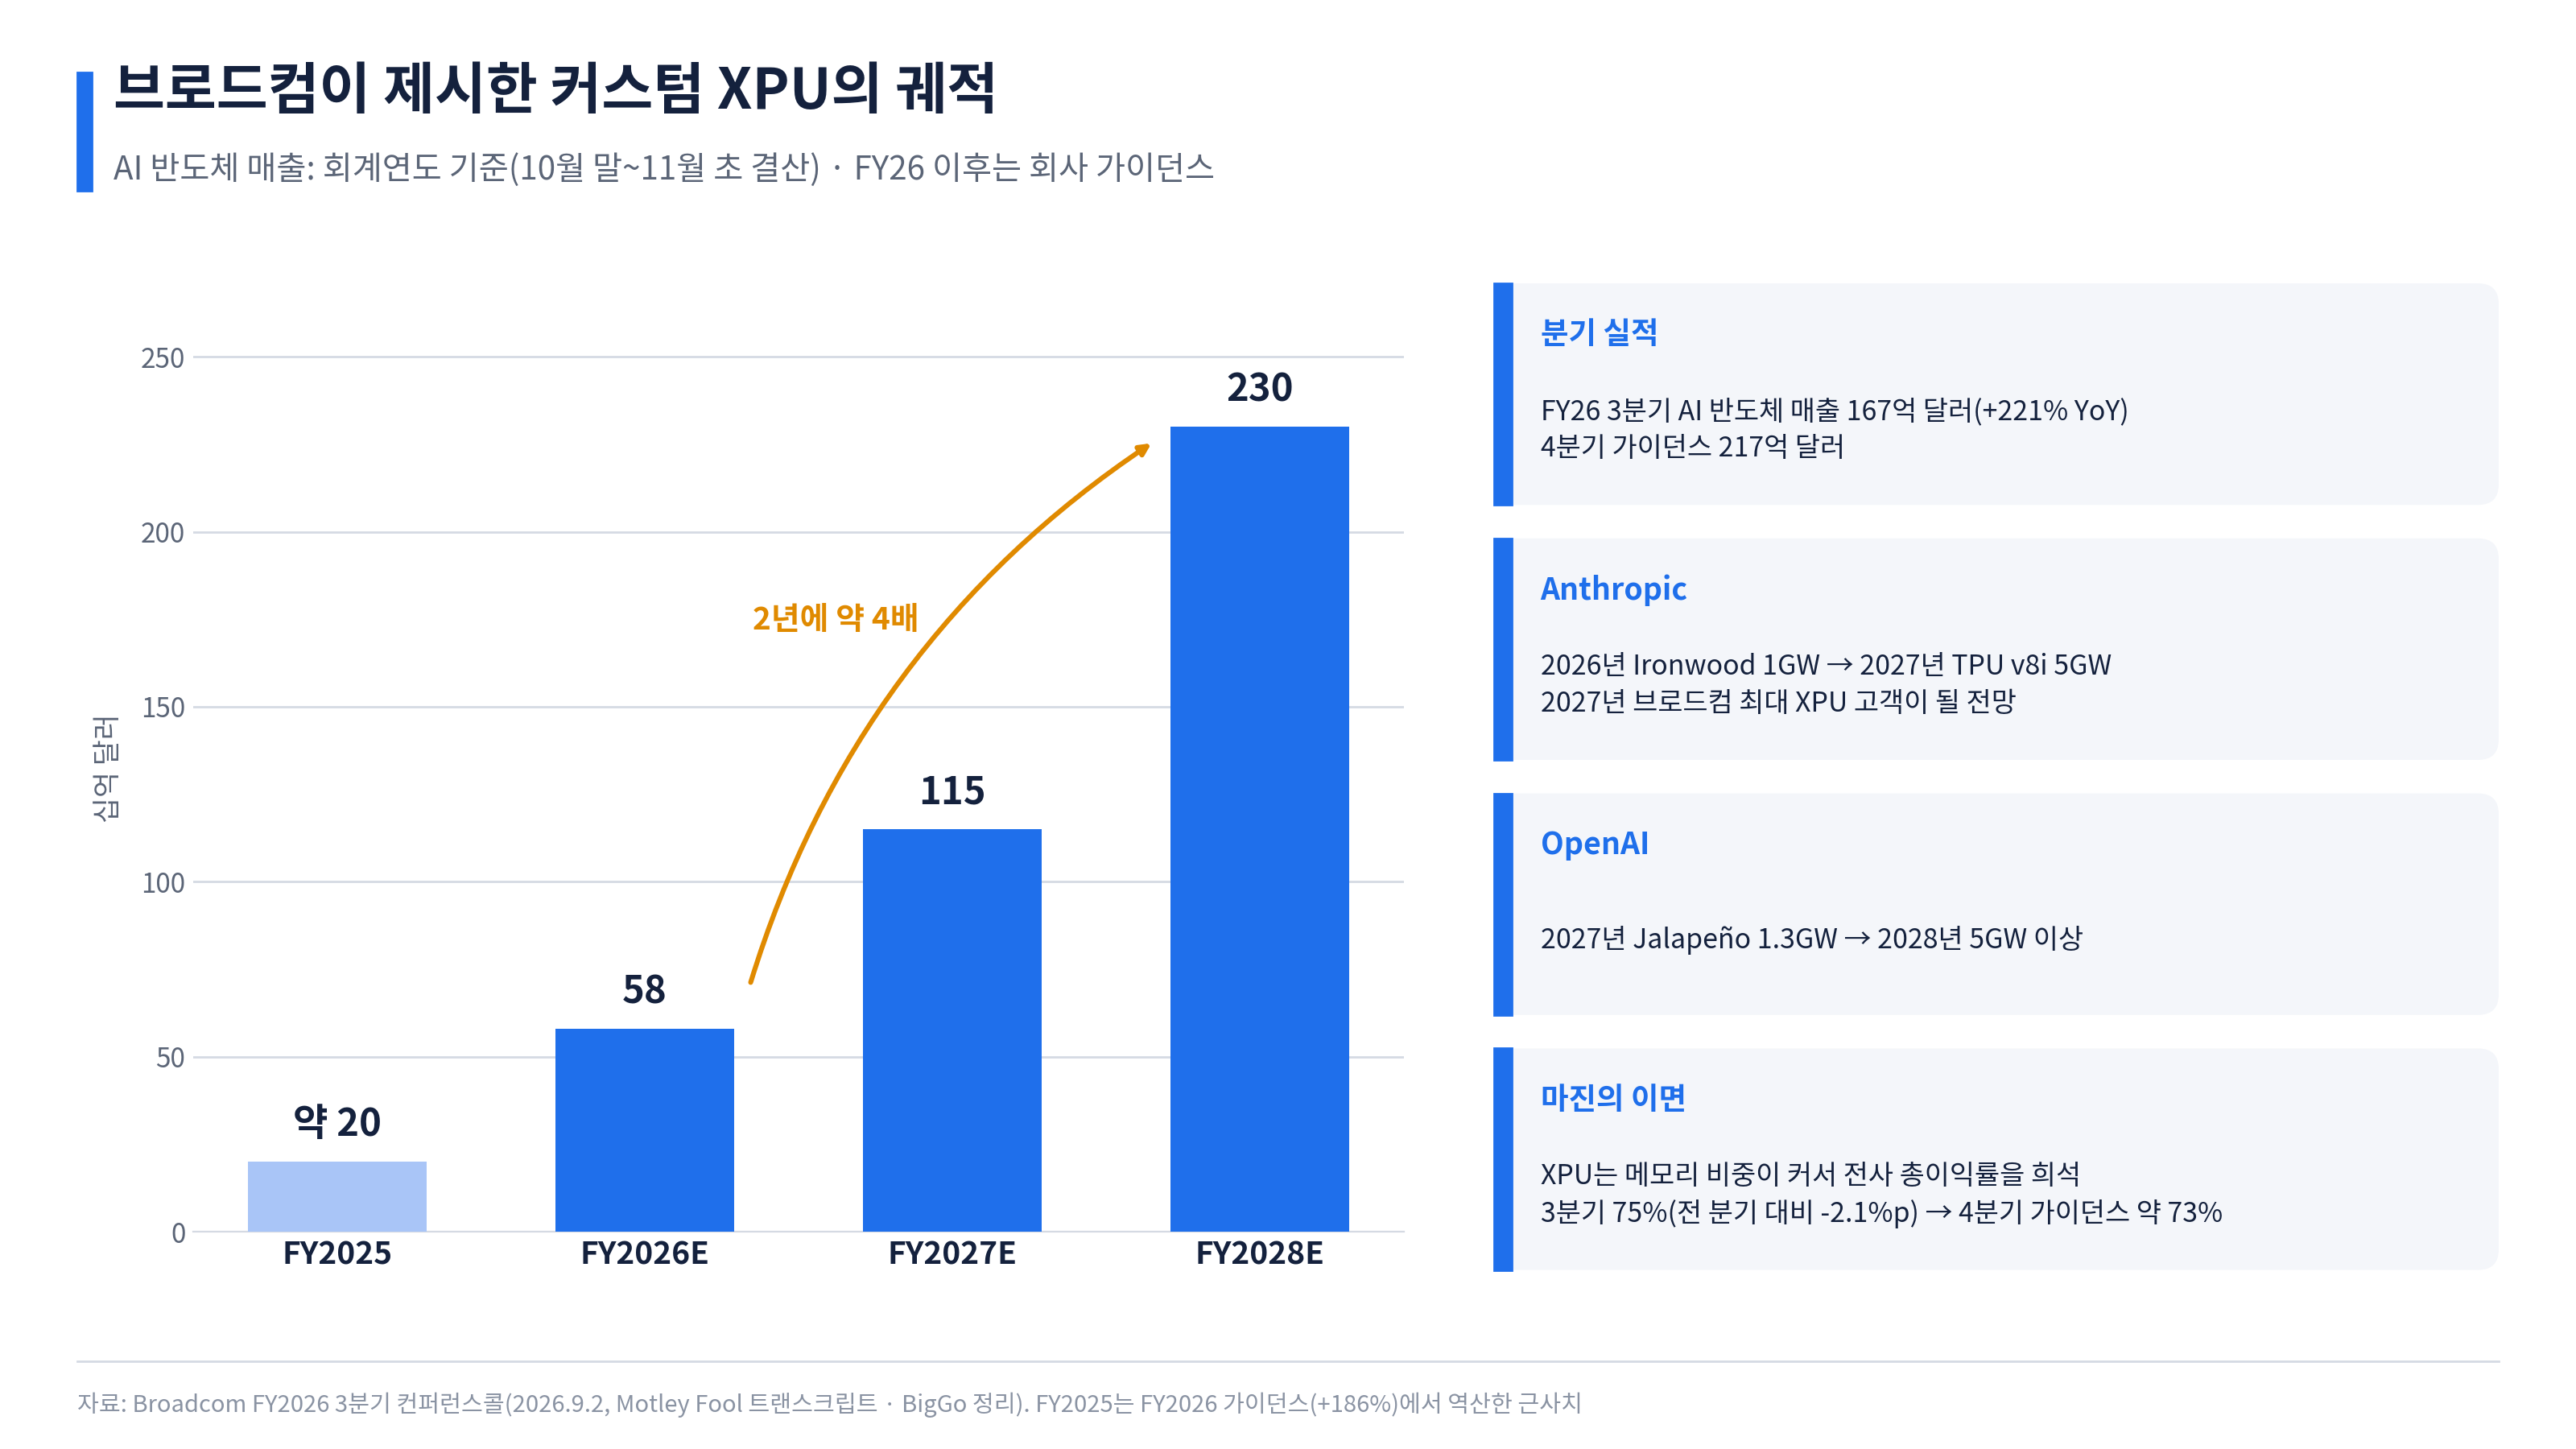
9월 2일 발표한 FY26 3분기(5~7월) AI 반도체 매출은 167억 달러로 전년보다 221% 늘었고, 4분기 가이던스는 217억 달러다. 회사는 FY26 AI 매출 전망을 580억 달러로 올리면서 이례적으로 2년 치를 더 내놨다. FY27 약 1,150억 달러, FY28 2,300억 달러이고, 확보된 공급을 근거로 한 숫자라고 설명했다.[1] AI 매출의 73%가 맞춤형 칩(XPU)에서 나오고, 그 출하량은 1년 새 3.5배 이상 늘었다. XPU 고객은 여섯 곳이다.[1]
호크 탄 CEO가 고객별로 공개한 배치 계획이 시장 지도를 그대로 보여 준다.[1]
구글: Ironwood(TPU 7세대)를 대량 출하 중이고 TPU v8i 생산을 시작했다. 탄은 v8i가 "Vera Rubin과 대등하거나 그 이상"이라고 주장했다. 수년에 걸쳐 매년 수백억 달러어치 TPU를 공급하는 장기 계약도 새로 맺었다. (공급사: 브로드컴, 수요처: 구글)
Anthropic: 2026년 Ironwood 1GW, 2027년 TPU v8i 5GW를 배치하고, 2027년에 브로드컴의 최대 XPU 고객이 된다. 2028년에는 10GW를 추가할 가시성이 있다고 했다.
OpenAI: 첫 자체 칩 Jalapeño가 3분기에 출하를 시작했다. 2027년 1.3GW, 2028년 5GW 이상이 계획인데, 아직 객관적인 실측 성능이 비교되는 단계는 아닌 것으로 보인다.
메타: 자체 칩 MTIA 3세대가 진행 중이고 2028년까지 3GW의 가시성이 있다.
여기서 핵심 숫자는 GW당 비용이다. 탄은 XPU의 GW당 비용이 200억~300억 달러 수준에서 유지된다고 했다. 칩 값은 오르지만 칩 하나가 먹는 전력도 커져서 GW당 필요한 칩 수가 줄기 때문이다. 엔비디아가 제시한 GW당 약 400억 달러와 비교하면, 같은 1GW를 짓는 데 드는 칩 값이 크게 다르다. 탄의 표현은 "XPU는 GPU 비용의 절반 이하"였다.[1][2] 구매자가 자체 칩으로 가는 가장 직접적인 이유가 이 숫자에 있다.
브로드컴은 칩만 파는 것이 아니라 자금 조달까지 설계한다. 6월에 아폴로·블랙스톤과 함께 만든 금융 플랫폼은 2028년 말까지 OpenAI와 Anthropic에 20GW 이상의 컴퓨트를 공급하는 것이 목표이고, Anthropic의 1GW 배치를 위한 첫 350억 달러를 이미 마감했다. 브로드컴은 자산을 직접 장부에 올리지 않고 제3자 금융사가 떠안는 구조라고 설명했다.[1] 칩 회사가 고객의 자금 문제까지 풀어 주는 단계로 경쟁이 넘어갔다는 뜻이다. 탄은 프런티어 연구소들이 "스스로 하이퍼스케일러가 될 것"이라고 표현했다.[1]
대가는 마진이다. XPU는 메모리 비중이 커서 매출이 늘수록 총이익률이 희석된다. 3분기 총이익률은 75%로 전 분기보다 2.1%p 내려갔고 4분기 가이던스는 약 73%다. 탄은 "총이익률 말고 영업이익률을 보라"고 답했다. 3분기 영업이익률은 67.9%였다.[1]
성장률도 비교해 볼 만하다. 엔비디아가 제시한 FY28 매출 성장률은 약 70%이고, 브로드컴의 FY27 AI 매출 성장률은 약 98%(580억→1,150억 달러)다.[1][2] 회계연도가 석 달가량 어긋나 엄밀한 비교는 아니지만, 2027년에는 맞춤형 칩 쪽이 조금 더 빠르게 크고, 시장 전체로는 여전히 엔비디아가 훨씬 크다.
4. 구글 TPU - 거대 도메인, 그리고 추론을 위해 바꾼 것
구글은 맞춤형 칩 진영의 선두주자다. 7세대 Ironwood는 칩당 FP8 4.6PF, HBM3E 192GB(7.4TB/s)이고, 9,216개를 하나의 팟으로 묶는다.[3] 엔비디아와 비교하면, NVL72 랙 하나가 구글의 팟에 해당하는 스케일업 도메인인데, 엔비디아는 이를 스위치로 72개에서 끝내고, 구글은 OCS (Optical Circuit Switch, 전기 신호로 변환하는 과정 없이 빛의 경로를 직접 제어해 데이터센터 내부 장치들을 연결하는 광회선 스위치 기술)로 수천 개까지 키운 것이다. 정리하면 큐브는 '구리로 묶는 물리 단위이자 교체 단위', 팟은 'OCS 한 층으로 묶을 수 있는 최대 스케일업 도메인'이다.
3차원 토러스. TPU 칩 하나에는 위·아래·앞·뒤·좌·우 여섯 방향으로 옆 칩과 잇는 링크가 달려 있다. 이렇게 3차원 격자를 만든 뒤 격자의 양 끝을 서로 이어 고리로 만든 것이 토러스다. 끝을 잇지 않은 격자(메시)에서는 가장자리 칩의 이웃이 둘뿐이라 링크가 놀고, 끝에서 끝까지 가려면 격자 한 변을 다 건너야 한다. 끝을 이어 두면 바깥으로 한 번 빠져 반대편으로 나오면 되므로 최대 거리가 절반으로 줄고, 모든 칩의 이웃 수가 같아져 통신이 한쪽에 몰리지 않는다.
그러면 멀리 있는 칩과 통신하려면 다 중간 칩들을 거쳐야 할까. 그렇다. 다만 중간 칩의 연산 코어는 관여하지 않고, 칩마다 달린 라우터가 데이터를 다음 링크로 넘기기만 한다. 게다가 학습의 주된 통신인 All-reduce (여러 칩의 값을 합쳐 다시 나눠 주는)는 옆 칩과 값을 주고받으며 고리를 한 바퀴 도는 방식이라, 토러스의 고리 구조와 잘 맞는다. 문제는 모든 칩이 모든 칩에게 보내는 전대전 통신이다. 이때는 데이터가 여러 칩을 거치며 지연이 쌓이고, 중간 링크가 남의 데이터까지 실어 나르느라 붐빈다. MoE 추론이 바로 이런 통신을 한다. 구글이 추론용 TPU 8i에서 토러스를 버리고 최대 홉을 16에서 7로 줄인 이유다.
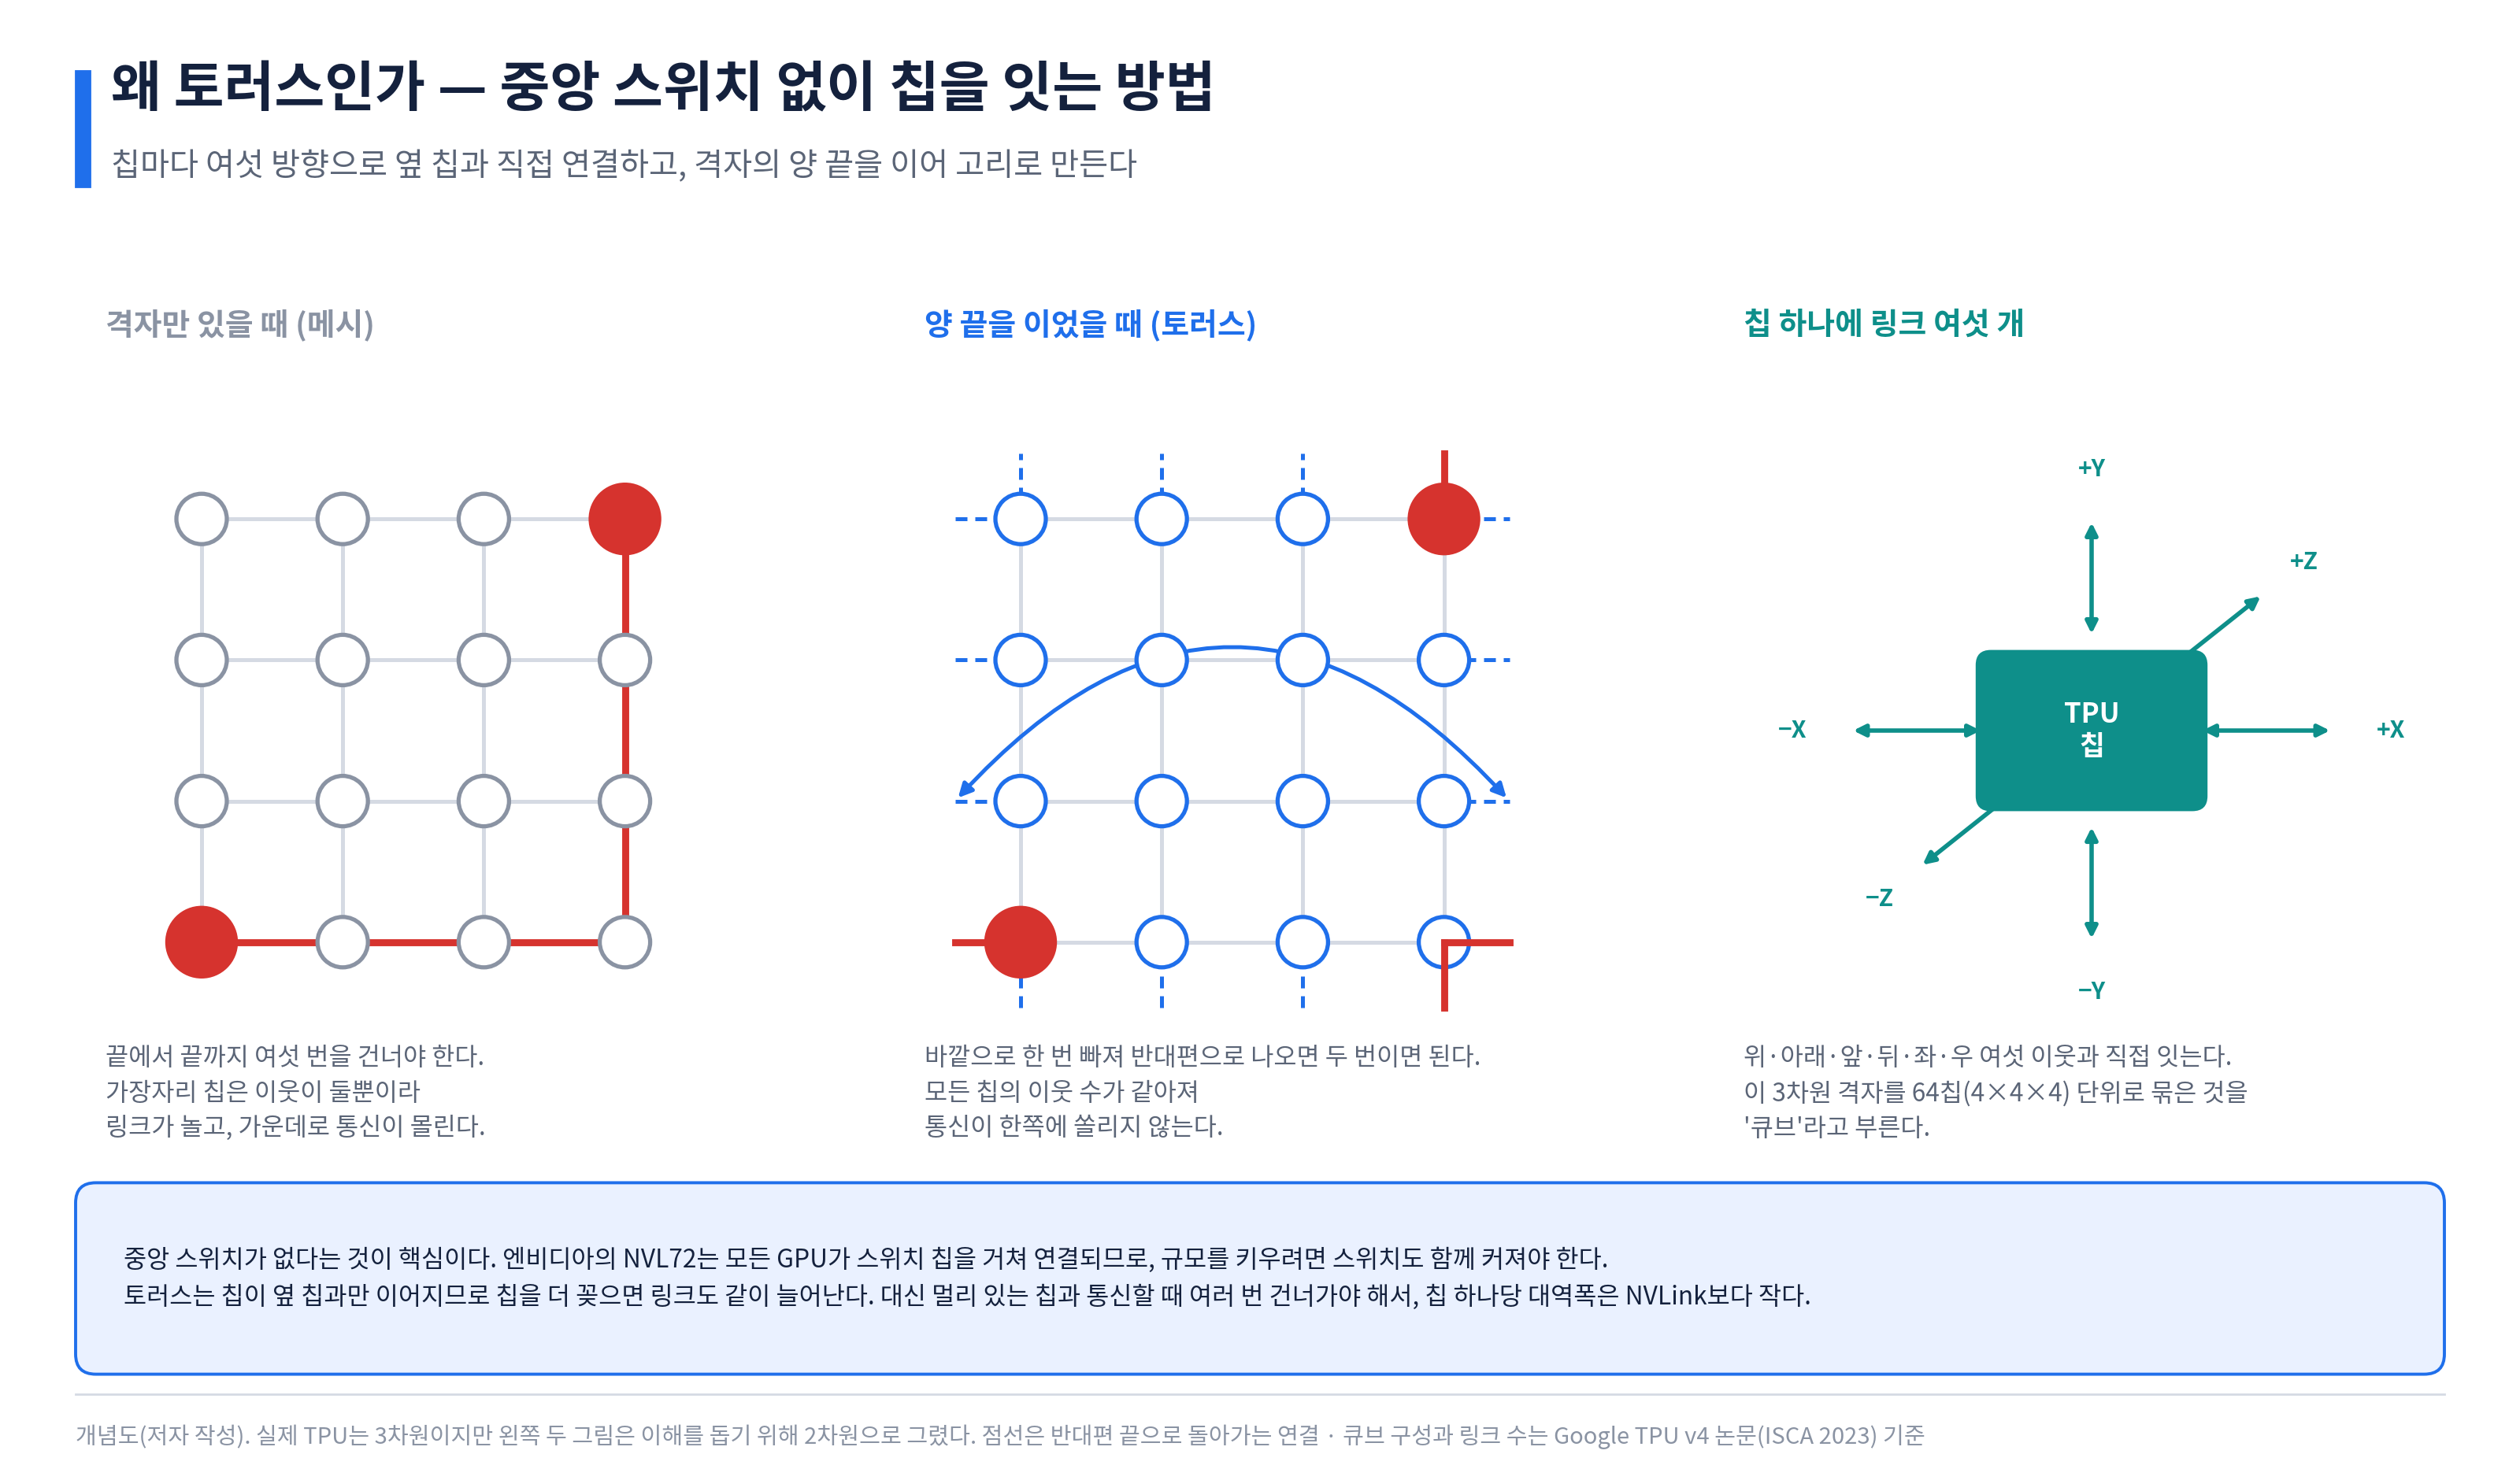
더 근본적인 차이는 중앙 스위치가 없다는 점이다. NVL72는 모든 GPU가 스위치 칩을 거쳐 연결되므로 규모를 키우려면 스위치도 함께 커져야 한다. TPU는 칩마다 라우터를 두고 옆 칩과 직접 이어지므로 칩을 더 꽂으면 링크도 같이 늘어난다.[4] 대신 멀리 있는 칩과 통신할 때는 여러 번 건너가야 해서, 칩 하나당 대역폭은 NVLink보다 작다.
광 회로 스위치(OCS). 칩 64개(4×4×4)를 묶은 단위를 큐브라고 부르는데, 큐브 안은 구리로 고정돼 있고 큐브와 큐브 사이는 빛으로 잇는다. 큐브의 여섯 면에서 면당 16개씩, 큐브 하나에서 광링크 96개가 나온다. 되돌아오는 고리를 만들기 위해 마주 보는 두 면의 링크는 같은 OCS에 연결되므로 큐브 하나가 OCS 48대에 물린다. OCS 한 대는 136×136 포트(128개와 예비 8개)이고, 이렇게 큐브 64개를 이어 4,096칩 시스템을 만든다(TPU v4 기준).[4]
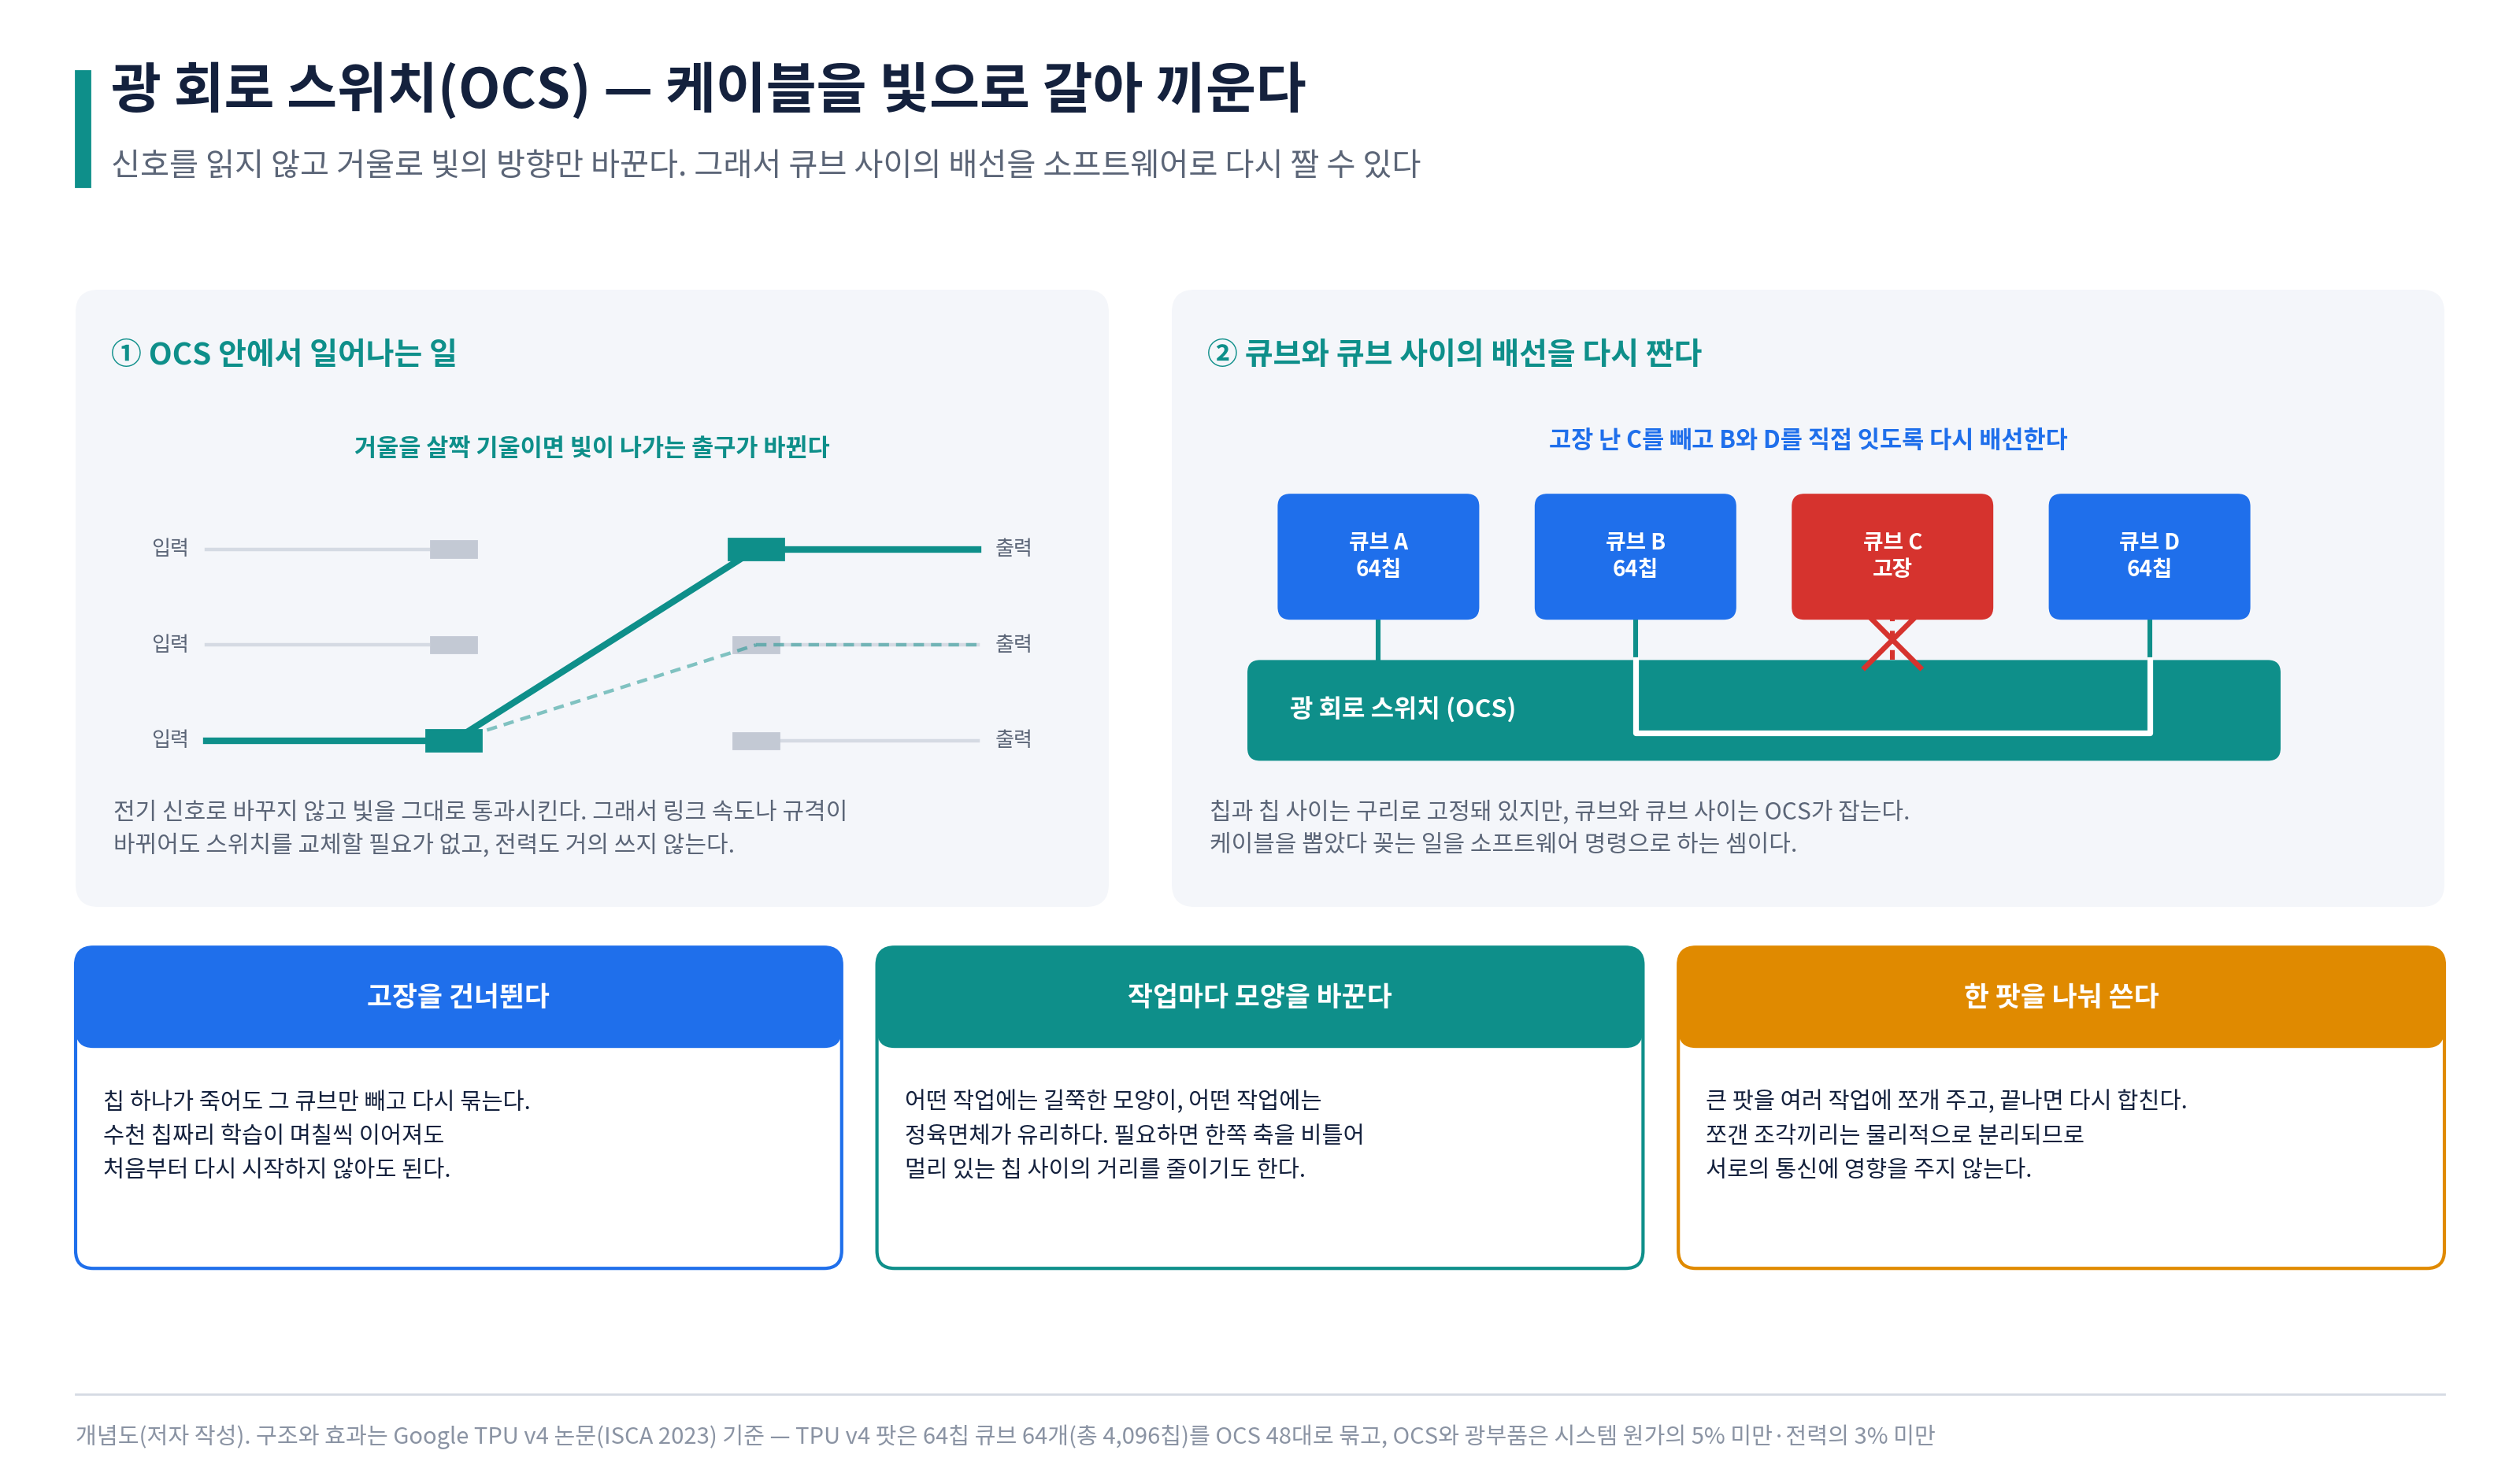
OCS는 패킷을 읽어 목적지를 판단하는 보통의 스위치가 아니다. 들어온 빛을 미세 거울로 반사해 원하는 출력 섬유로 보낼 뿐이다. 전기로 바꾸는 과정이 없으니 링크 속도가 바뀌어도 스위치를 교체할 필요가 없다. 논문에 따르면 OCS와 광부품을 합쳐도 시스템 원가의 5% 미만, 전력의 3% 미만이다.[4] 거울을 물리적으로 움직이므로 매 패킷마다 경로를 바꾸는 용도가 아니라, 작업을 배치할 때 배선을 한 번 정해 두는 용도다. (쉽게 생각하면, 작은 전송 단위인 패킷을 하나씩 열어볼 필요없이, 정해진 경로로 토스만 한다.)
이 구조의 가치는 가용성에서 나온다. 구글은 논문에서 OCS 없이 고정 배선으로 큰 작업을 돌리려면 호스트 가용성이 99.9%는 돼야 쓸 만한 실효 처리량이 나온다고 적었다.[4] 수천 개 칩 중 몇 개만 고장 나도 배선이 막히기 때문이다. OCS는 고장 난 큐브만 빼고 나머지를 다시 이어 이 문제를 푼다. 작업마다 도메인의 모양을 바꾸거나 한쪽 축을 비튼 '트위스티드 토러스'를 고를 수도 있다.[4] 올해 공개된 구글의 후속 논문에 따르면 9,216칩 Ironwood 시스템에는 CPU 호스트가 2,304대 있고, 가장 큰 가용성 문제는 칩이 아니라 이 호스트들에서 나온다.[4]
추론용 8세대에서 구글은 토러스를 버렸다. 4월 Cloud Next에서 공개한 8세대는 처음으로 학습용(TPU 8t)과 추론용(TPU 8i)으로 갈라졌다. 8t는 토러스를 유지하며 9,600개 칩을 공유 HBM 2PB로 묶고, 팟당 연산이 Ironwood의 약 3배(FP4 121EF)다.[5] 8i는 다르다. 칩 4개를 완전연결한 보드 → 보드 8개를 완전연결한 그룹 → 그룹 36개를 완전연결한 팟(1,152칩)으로 쌓는 Boardfly 구조를 새로 만들었고, 최대 홉 수를 16에서 7로 줄였다. 칩 간 대역폭은 19.2Tb/s로 두 배가 됐고, 온칩 SRAM은 384MB로 세 배가 됐다. 집합통신 전용 엔진(CAE)은 칩 안의 지연을 최대 5분의 1로 줄인다. 구글은 8i가 Ironwood 대비 달러당 성능이 80% 높다고 주장한다.[5]
이 변화가 의미하는 바가 크다. 학습에서는 도메인이 클수록 좋지만, 디코드에서는 토큰 하나를 만들 때마다 여러 칩을 건너는 시간이 쌓인다. 구글은 추론 칩에서 도메인 크기(9,216 → 1,152)를 줄이고 칩당 파이프와 홉 수를 개선했다. 13장의 지도에서 보면 구글이 엔비디아 쪽 모서리로 한 걸음 옮긴 것이다. '거대 도메인'과 '굵은 파이프' 사이의 논쟁에서, 디코드만큼은 굵은 파이프와 짧은 거리가 중요하다는 것을 구글 스스로 인정한 셈이다.
9월 7일 SemiAnalysis가 Ironwood의 첫 제3자 추론 결과를 공개했다. Qwen 3.5 397B(FP8), 유저당 100tok/s 조건에서 백만 토큰당 비용은 Ironwood 0.181달러, B200 0.222달러, B300 0.276달러였다. 같은 조건에서 TPU의 달러당 성능은 최대 50% 높았다.[6] 다만 프리필과 디코드를 분리한 서빙끼리 비교하면 지금은 GB200·GB300 NVL72가 앞선다. 구글 내부에서는 분리 서빙을 오래 써 왔지만 외부 고객용 스택에는 아직 최적화된 경로가 없기 때문이다. SemiAnalysis는 이 격차가 수개월 안에 좁혀질 것으로 봤고, Ironwood에는 네이티브 FP4 연산이 없다는 점도 짚었다.[6]
비용 구조를 보면 격차가 하드웨어가 아니라 소프트웨어에 있다는 점이 분명해진다. SemiAnalysis는 작년 말 분석에서 Ironwood의 칩당 총소유비용이 구글 내부 기준으로 GB200보다 약 44% 낮고, 구글이 마진을 붙여 외부에 빌려줘도 GB200보다 최대 30%, GB300보다 최대 41% 낮을 수 있다고 추정했다.[7]
TPU는 이제 구글 클라우드 밖으로 나간다. Anthropic은 100만 개 이상의 TPU를 약정했는데, 약 40만 개 이상은 직접 구매, 60만 개 이상은 구글 클라우드 임차다.[6] 메타는 2월에 구글과 수년·수십억 달러 규모의 TPU 임차 계약을 맺었고, 2027년부터 자체 데이터센터용 직접 구매를 검토 중이라는 보도가 나왔다.[8] 5월에는 블랙스톤이 초기 자본 50억 달러를 대고 구글이 TPU를 공급하는 TPU 전용 클라우드 회사가 출범했다. 이름은 Crux AI이고 2027년 500MW 가동이 목표다.[9] 구글은 PyTorch에서 TPU를 쓸 수 있게 하는 TorchTPU도 10월께 오픈소스로 공개할 예정이다 [6]. Anthropic은 AWS Trainium, 엔비디아 등 다른 기업의 칩도 쓰고, 심지어 메타는 자체 칩도 있는데, TPU를 추가로 사용한다는 뜻인데, 작업에 맞게 조달 포트폴리오를 늘리는 개념이다. 예를 들면, TPU 8i는 대형 MoE 모델을 낮은 지연으로 돌리는 데 맞춰 설계되었다.
5. OpenAI Jalapeño - 연산을 덜어 메모리에 실었다
OpenAI는 8월 Hot Chips에서 첫 자체 칩 Jalapeño의 구조를 공개했다. 브로드컴과 공동 개발한 추론 전용 칩이고, 칩당 HBM4 216GB(15.4TB/s), MXFP4 기준 13.4PF, 전력 700W다. 칩 안은 메모리와 코어를 묶은 64개의 조각으로 나뉜다.[10] 칩 안을 여러 구역으로 나누고 각 구역이 자기 몫의 메모리를 바로 옆에 두는 배치로, 데이터를 가까운 곳에 두는 것이 소프트웨어의 몫이 된다.
시스템 구성에 설계 의도가 드러난다. 한 랙에 128개를 넣어 칩당 600GB/s로 묶고, 16개 랙의 2,048개를 칩당 200GB/s로 하나의 팟으로 묶는다. 팟 전체는 MXFP4 27EF, HBM 432TB, 메모리 대역폭 32PB/s다. 연결에는 브로드컴 Tomahawk 6 스위치로 만든 2단 구조(Clos)를 쓰는데, 한 층의 행렬을 여러 칩이 나눠 계산하는 트래픽(텐서 병렬)에는 넓은 대역폭을, 전문가 사이의 트래픽(전문가 병렬)에는 좁은 대역폭을 배분했다.[10] Clos는 스위치를 두 층으로 쌓아 어느 칩에서 어느 칩으로든 같은 거리로 갈 수 있게 만든 구성으로, 데이터센터 네트워크의 표준 형태다. 참고로, 엔비디아는 자체 규격인 NVLink 스위치로 72개 GPU를 모두 1홉에 굵게 잇는 방식인데, All-to-All에 강하지만, 스위치와 배선이 비싸다.
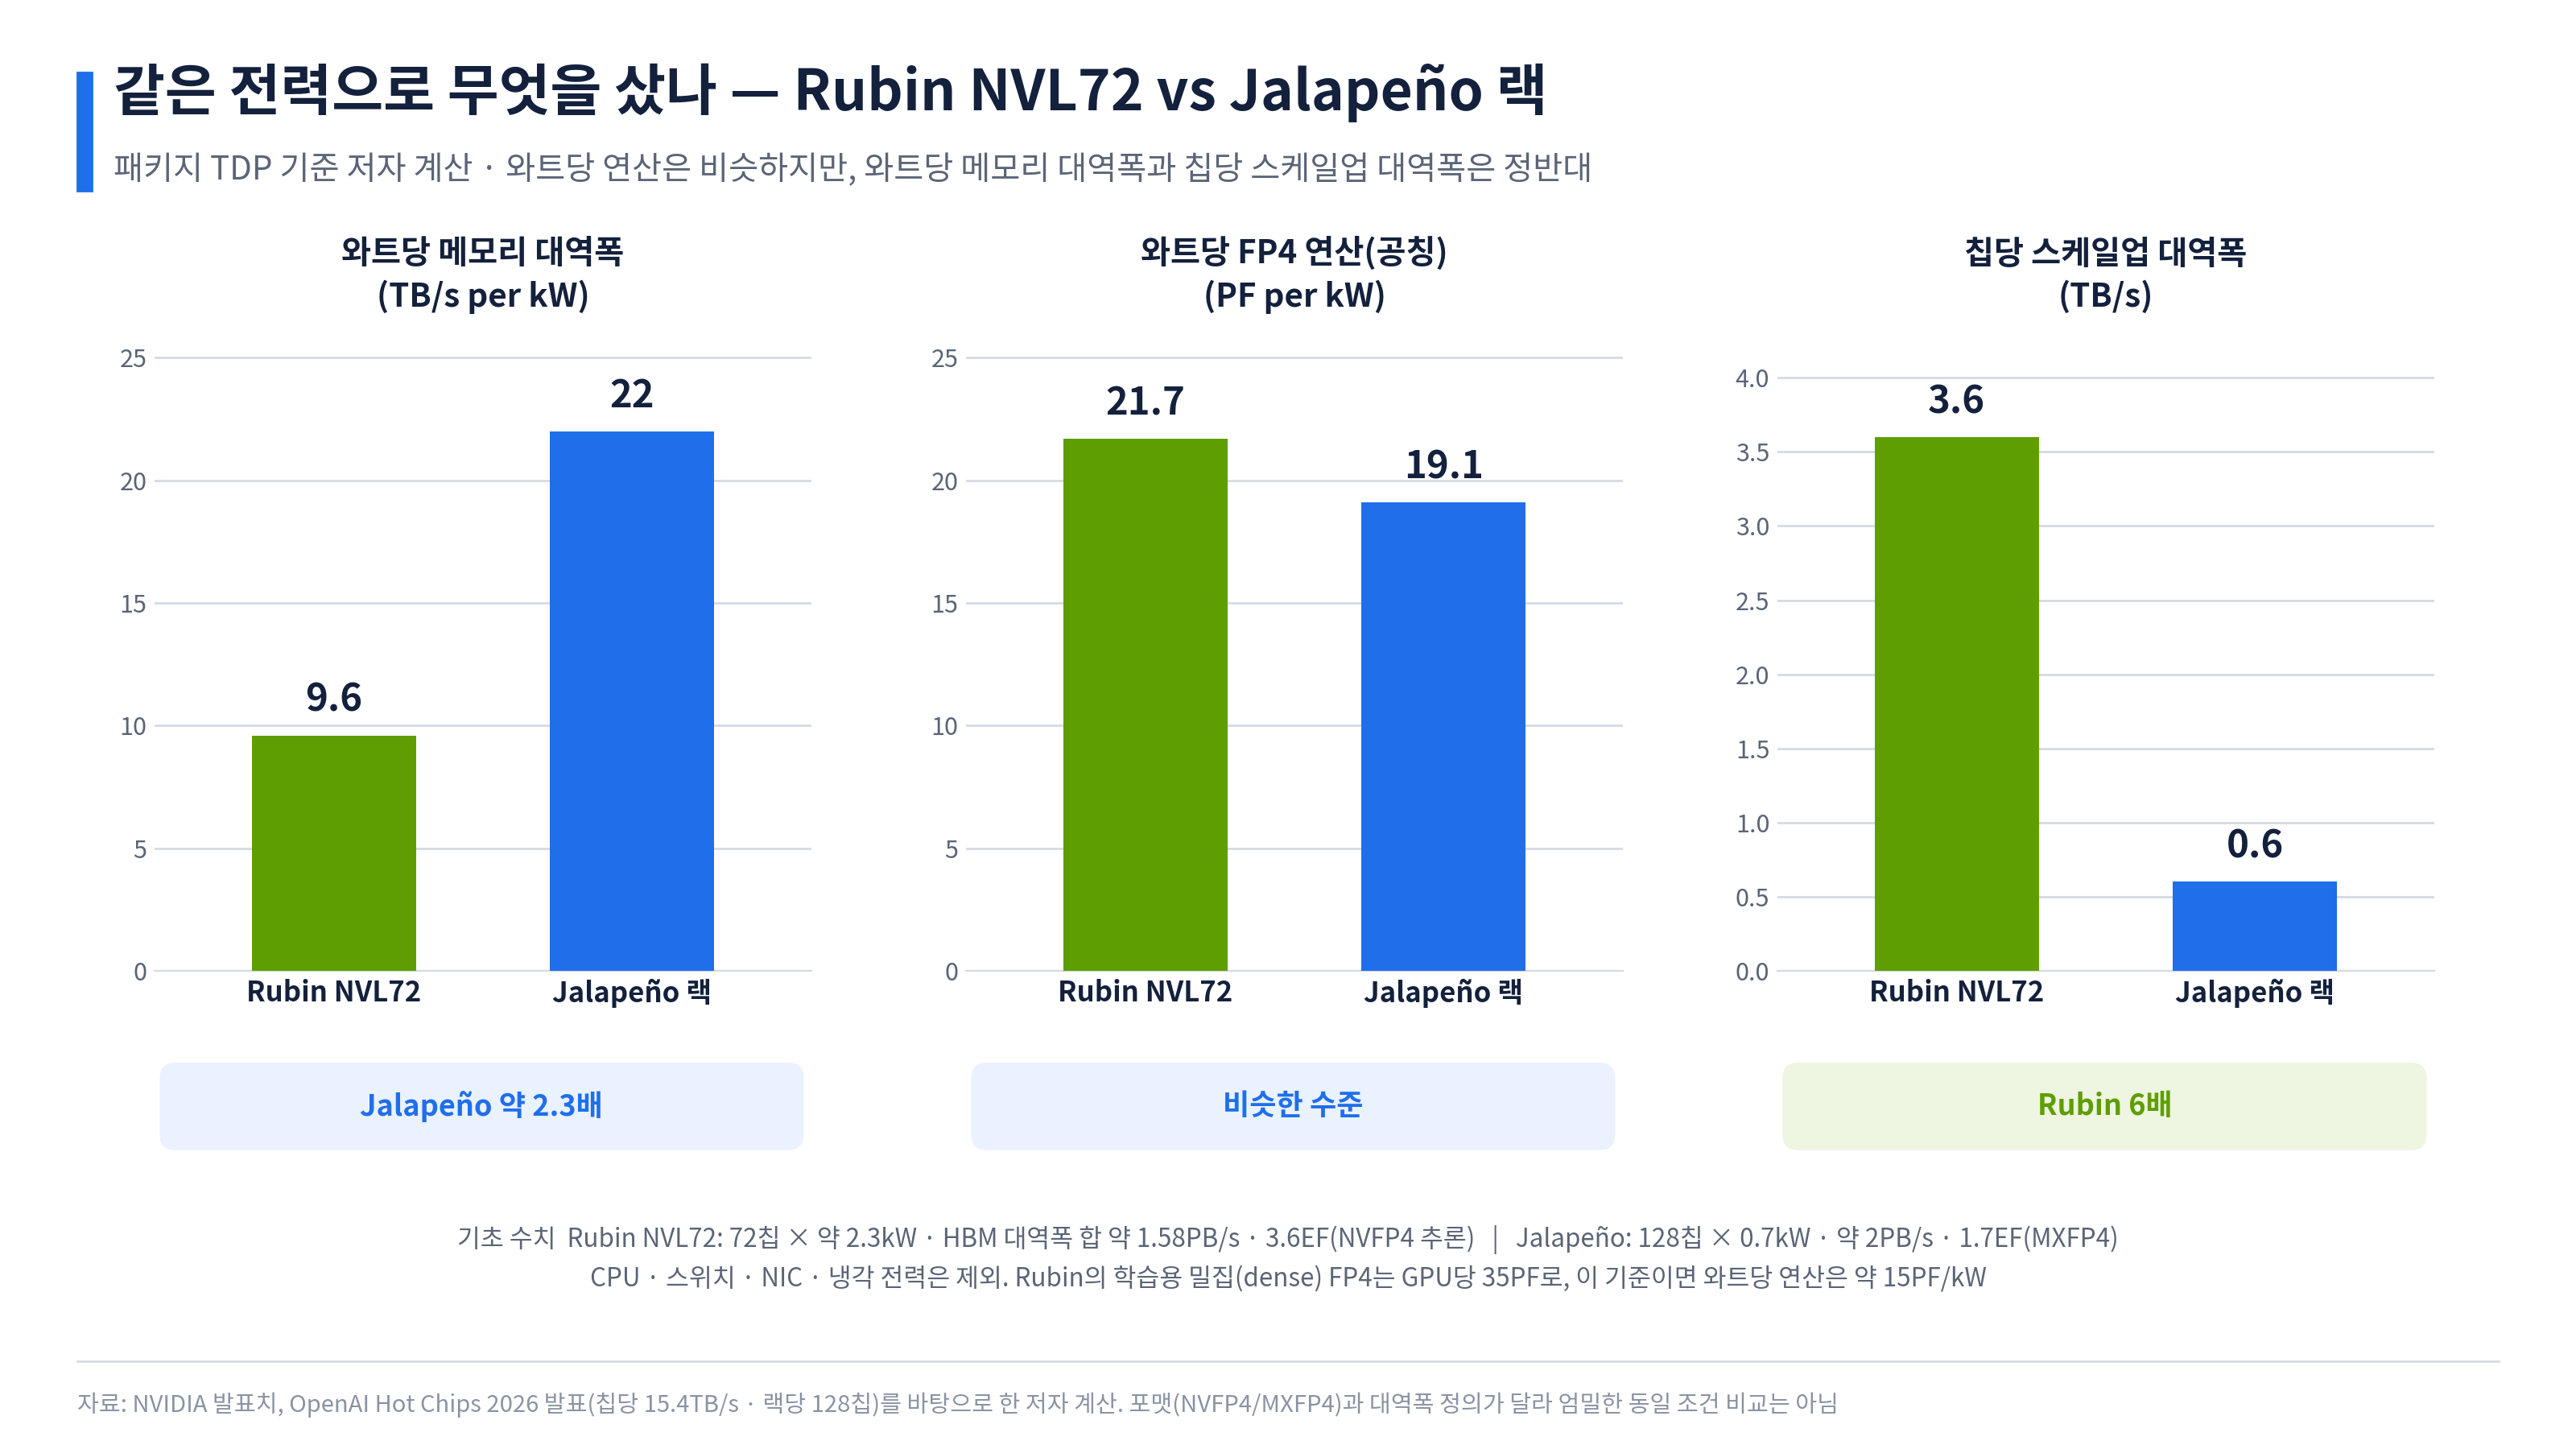
Rubin NVL72와 전력 기준으로 나란히 놓으면 차이가 선명하다. 칩의 공칭 전력으로 계산하면 와트당 FP4 연산은 비슷하다. 그런데 와트당 메모리 대역폭은 Jalapeño가 약 2.3배이고, 칩당 스케일업 대역폭은 Rubin이 6배다(필자 계산). OpenAI는 같은 전력으로 연산 대신 메모리 대역폭을 샀고, 모든 칩을 굵게 잇는 대신 자기 모델의 통신 패턴에 맞춰 파이프 굵기를 차등했다. 엔비디아는 어떤 AI 모델이 올라갈지 모르기 때문에 통신 패턴을 모르지만, OpenAI는 자신의 모델에 맞는 대역폭 설계가 가능하다. 1부의 식에서 분자인 대역폭 합을 키우는 쪽으로 예산을 옮긴 것이다. OpenAI는 좋은 추론 칩을 "최대 연산 성능이 높은 칩"이 아니라 "실제 요청을 가장 낮은 지연과 에너지로 끝내는 칩"으로 규정했다.[10]
OpenAI는 자사 GPT-OSS-120B와 DeepSeek R1, Kimi K2.5 세 모델을 공개 벤치마크(InferenceX)로 돌려 GB200·GB300 대비 와트당 작업량 1.5~1.9배, 지연 1.7~3.6배 개선이라고 발표했다. SemiAnalysis 엔지니어가 OpenAI 실험실을 방문해 측정을 검증했다.[11] 두 가지를 감안해서 읽어야 한다. 결과는 각 가속기의 공개 패키지 전력으로 나눈 값이다(측정 중 Jalapeño의 실제 소비전력은 550W 이하였다).[11] 그리고 비교 대상이 Rubin이 아니다. 1부에서 봤듯 Rubin은 Blackwell 대비 MW당 2~7배를 실측으로 보여 줬다.[12] Jalapeño가 양산되는 2027년의 상대는 Rubin이므로, 자체 칩이 효율에서 앞선다는 명제는 아직 입증되지 않았다. 개발 속도도 눈여겨볼 만하다. OpenAI는 설계 코드(RTL) 작성부터 테이프아웃까지 9개월이 걸렸다고 밝혔고, 자체 AI 모델로 설계 작업을 자동화했다.[10] 올해 말부터 소량 배치를 시작해 2027년에 양산한다.[10]
6. AWS · 마이크로소프트 · 메타 - 각자의 계산
AWS의 Trainium은 가장 큰 규모로 돌고 있는 맞춤형 칩이다. Anthropic은 4월 발표에서 Claude의 학습과 서빙에 Trainium2를 100만 개 이상 쓰고 있다고 밝히며 최대 5GW의 신규 용량 계약을 공개했다. 2026년 말까지 Trainium2와 Trainium3 합계 약 1GW가 가동된다.[13] 3nm 공정의 Trainium3(FP8 2.52PF, HBM3e 144GB, 4.9TB/s)는 작년 12월 정식 출시됐고, 144개를 전대전 스위치(NeuronSwitch)로 묶은 UltraServer로 공급된다.[14] 다음 세대 Trainium4는 Trainium3 대비 FP4 성능 6배, 메모리 대역폭 4배를 목표로 하고, 엔비디아의 NVLink Fusion을 지원한다.[14] OpenAI도 아마존의 500억 달러 투자 계약의 일부로 Trainium 2GW를 쓰기로 했다.[13]
그런데 AWS는 엔비디아의 최대 고객이기도 하다. 8월 26일 AWS는 2027~2028년에 엔비디아 GPU 200만 개를 추가로 들이는 계약을 발표했다. 3월에 약속한 2026년 100만 개 이상과는 별개다.[15] 같은 시기 아마존의 자체 칩 사업은 연 매출 환산 250억 달러를 넘었고, AI 연구소들의 약정 합계가 2,250억 달러에 이른다.[15] 한 회사가 엔비디아의 가장 큰 고객이면서 가장 적극적인 경쟁자다.
이것이 지금 시장의 실제 모습이다. 공급이 수요를 못 따라가는 동안 구매자는 살 수 있는 칩을 모두 산다. 자체 칩과 GPU가 서로의 물량을 깎는 경쟁은 공급이 풀린 뒤에야 매출에 드러난다. 엔비디아는 공급 병목이 적어도 FY28 말까지 이어진다고 본다.[2]
마이크로소프트의 Maia 200은 1월에 공개됐다. TSMC 3nm, 트랜지스터 1,400억 개 이상, FP4 10PF 이상, HBM3e 216GB(7TB/s), 온칩 SRAM 272MB, 약 750W다.[16] 흥미로운 것은 SRAM이다. 대용량 SRAM을 칩 안에 넣어 KV 캐시와 집합통신 데이터를 HBM까지 보내지 않고 처리한다. Azure 고객이 인스턴스로 빌릴 수 없는 내부 전용 칩이고, 마이크로소프트는 7월 투자자 설명에서 OpenAI와 자사 모델을 돌릴 때 엔비디아 최신 칩보다 운영비가 30~40% 낮다고 설명한 것으로 보도됐다.[16] 후속 Maia 300은 9월 출시를 추진 중이라는 보도가 있다.[16]
메타는 가장 여러 갈래로 움직인다. 엔비디아를 주력으로 쓰면서 AMD와 6GW 계약을 맺었고(1부), 구글 TPU를 임차하며, 자체 MTIA는 3월에 300부터 500까지 네 세대 로드맵을 공개했다. MTIA 300은 추천 모델용으로 양산 중이다.[17] 이 칩도 브로드컴을 거친다. 3장에서 본 대로 브로드컴은 MTIA 3세대로 2028년까지 3GW를 공급할 가시성이 있다고 밝혔다.[1] 메타의 설계 철학은 2025년 ISCA 논문 '메타의 2세대 AI 칩: 모델과 칩의 공동 설계와 양산 경험'에 담겨 있다. 범용 가속기가 아니라 자사 모델에 맞춰 칩을 설계하고 실제 서비스에 배치하면서 겪은 문제를 기록한 글이다.[18]
세 회사의 공통점은 자체 칩이 '자기 워크로드 전용'에 가깝다는 것이다. Trainium은 AWS 안에서, Maia와 MTIA는 회사 내부에서 쓴다. TPU만이 구글 클라우드 밖으로 나오기 시작했지만, 그것도 소수의 대형 구매자와 맺는 개별 거래다.
7. SRAM과 웨이퍼스케일 - 승자가 아니라 계층
1부의 식에서 분자 (대역폭)를 극단적으로 키운 칩들이 세레브라스와 LPU다. 1부에서 본 Groq 3 LPU는 칩당 온칩 SRAM이 약 0.5GB로 Rubin HBM의 수백 분의 일이지만 대역폭은 약 7배다.
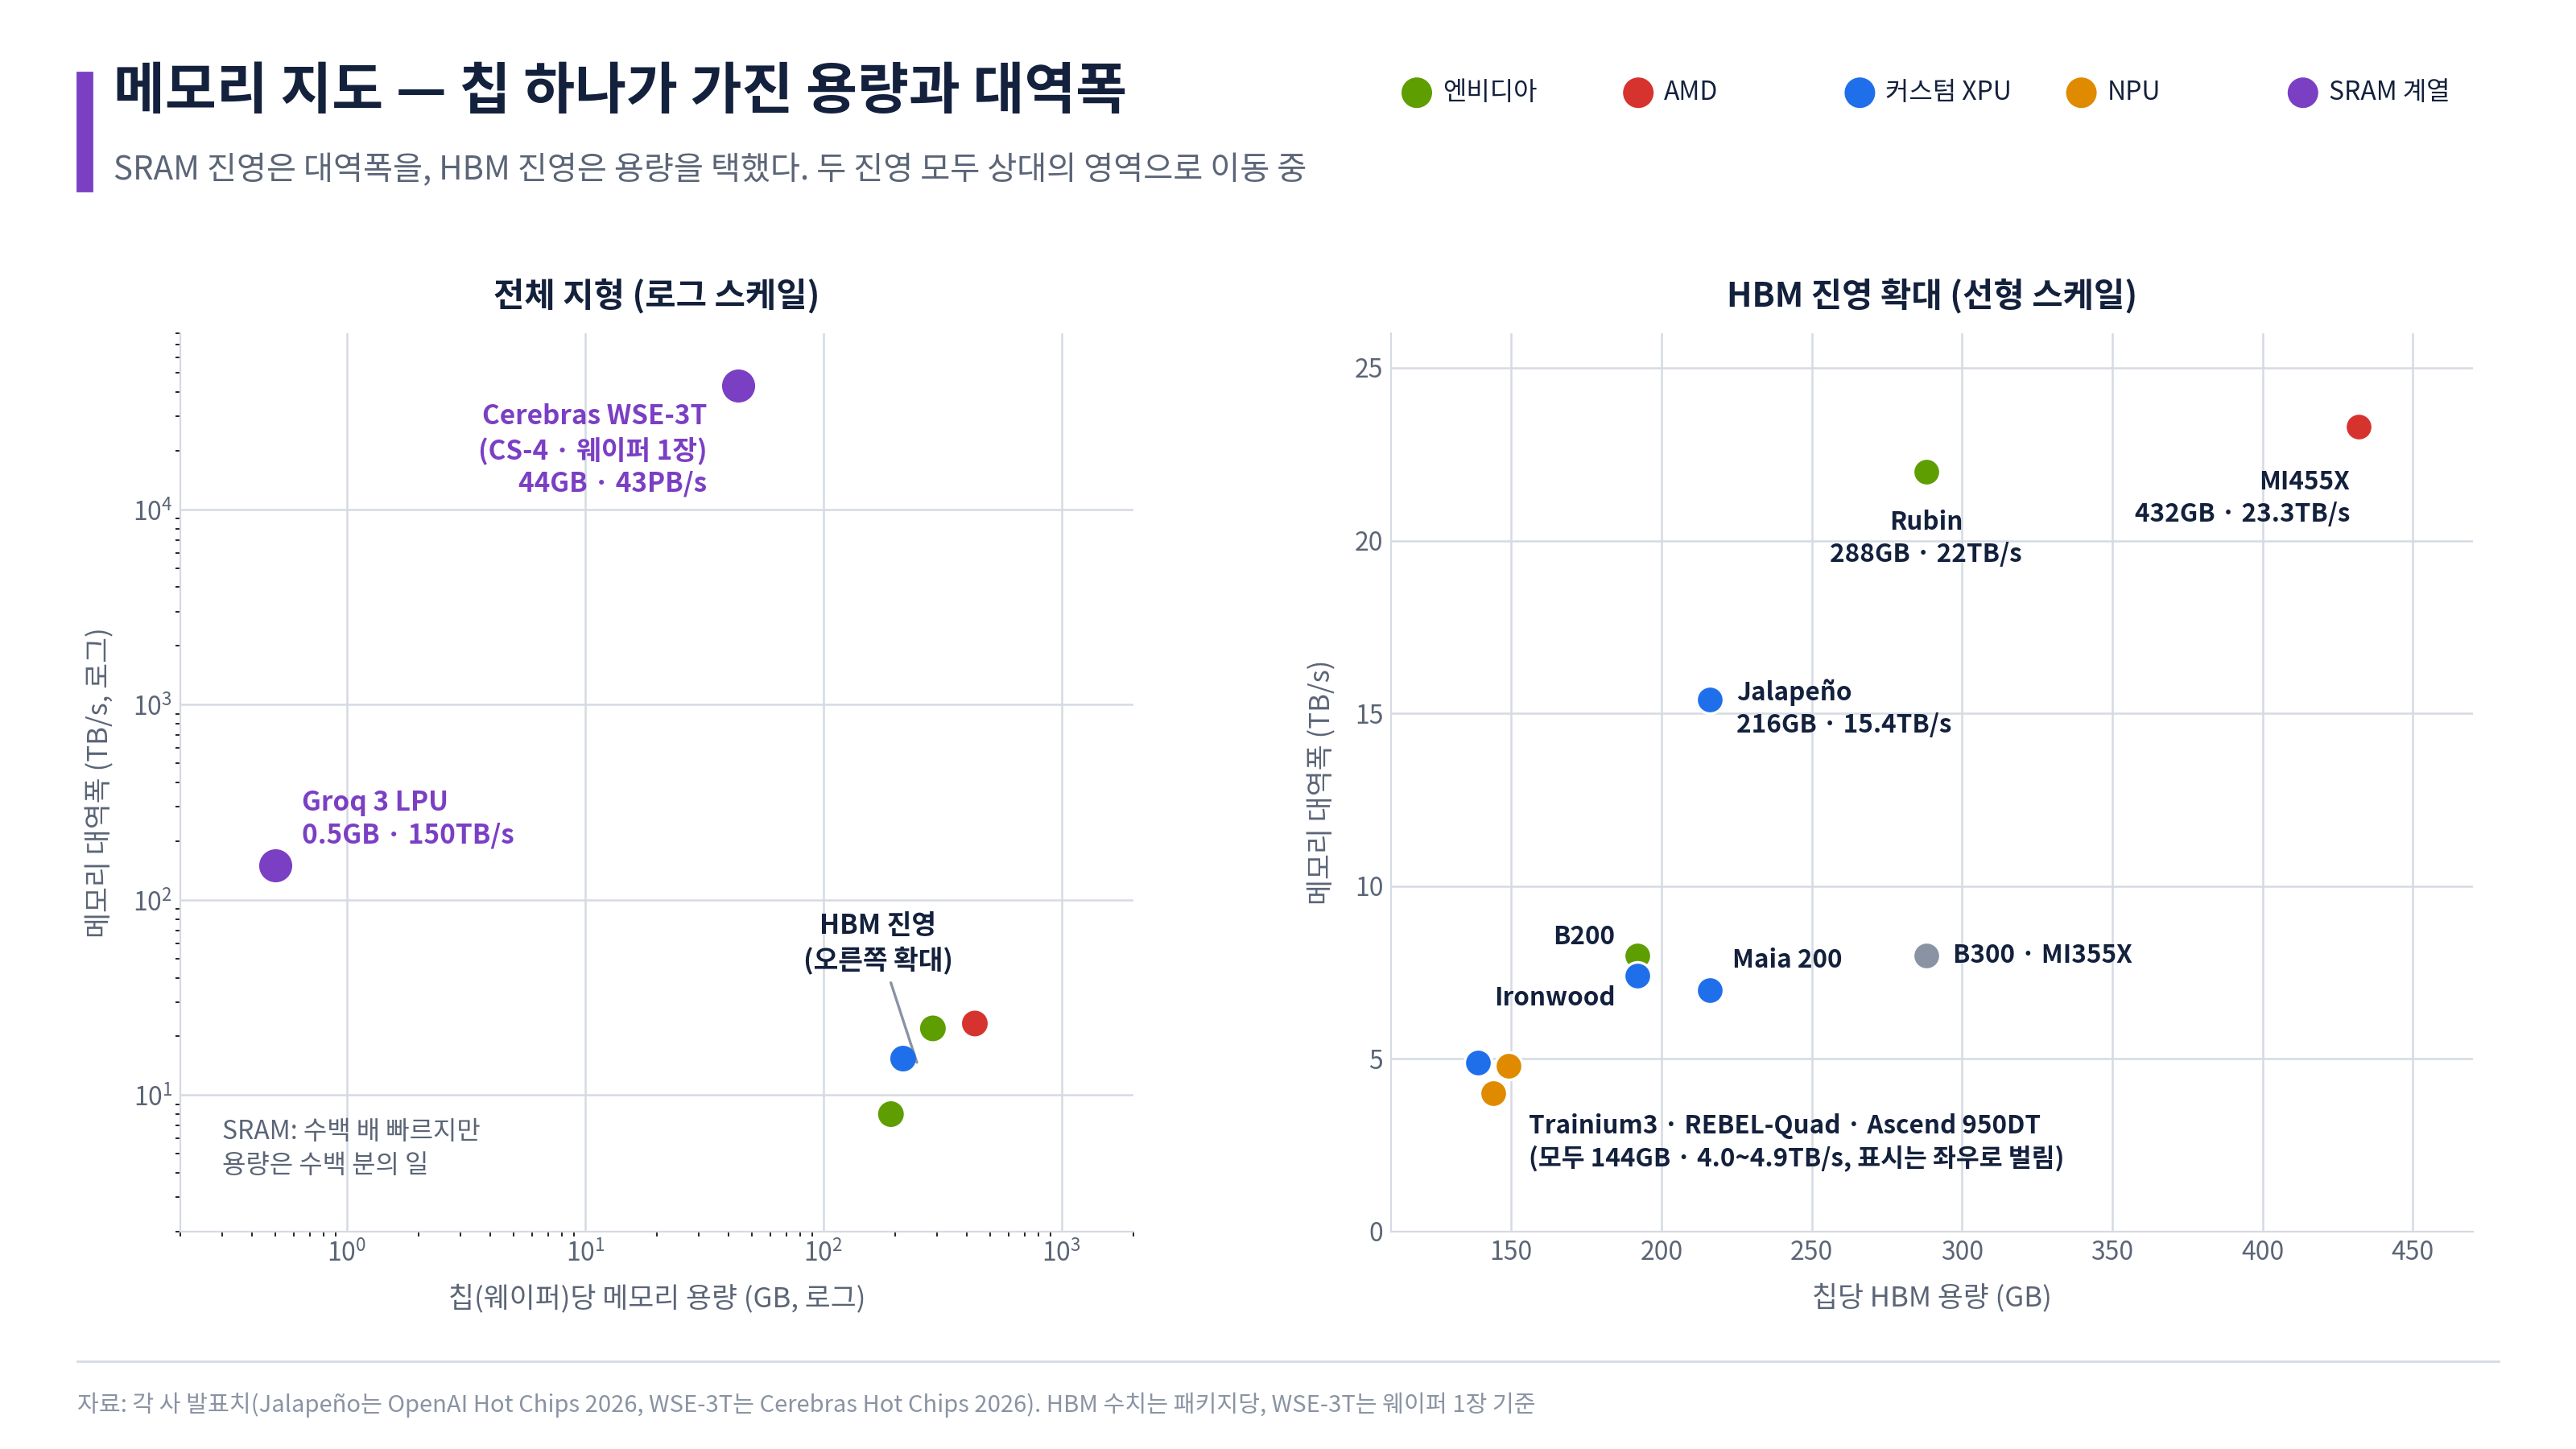
세레브라스는 웨이퍼 한 장을 통째로 칩 하나로 쓴다. 8월에 공개한 CS-4는 기존 WSE-3의 코어 90만 개와 SRAM 44GB를 유지하면서 전력 공급과 클럭을 끌어올린 WSE-3T를 쓴다. 웨이퍼 한 장의 메모리 대역폭은 43PB/s이고, 웨이퍼 3장을 한 랙에 꽂아 랙당 750PF(희소 FP16)를 낸다. 회사는 CS-3 대비 토큰 생성 속도 2배, 와트당 토큰 10배를 주장한다.[19] 2027년 CS-5는 gpt-oss-120b급 모델에서 유저당 초당 10,000토큰, 수조 파라미터 모델에서 5,000토큰이 목표이고, 그다음 CS-6는 웨이퍼 위에 D램을 3D로 쌓는다.[19]
세레브라스의 설계 철학은 단순하다. 칩을 잘라서 다시 이어 붙이느라 생기는 손실을 없애려고 애초에 자르지 않는다. 웨이퍼 위의 코어끼리는 웨이퍼 안의 배선으로 통신하고, 그 대역폭은 53.5PB/s로 NVL72 랙 전체 NVLink(260TB/s)의 200배가 넘는다. 세레브라스는 Hot Chips에서 Rubin NVL72의 약 5,000개 케이블을 두고 "엉망"이라고 표현했다.[19] 6부에서 볼 기판과 케이블의 난제를 정면으로 겨냥한 발언이다.
그런데 세레브라스는 칩 회사에서 클라우드 회사로 바뀌고 있다. 2분기 GAAP 매출은 1억 8,010만 달러(+74%)였는데, 클라우드 매출이 1억 2,600만 달러로 281% 늘어난 반면 하드웨어 매출은 5,410만 달러로 23% 줄었다.[20] OpenAI는 작년 12월 750MW (회사 평가 200억 달러 이상)를 약정했고 2030년까지 1.25GW를 추가할 옵션을 갖고 있다. 2분기 매출의 약 32%가 OpenAI에서 나왔고, 6월 말 잔여이행의무는 254억 달러다.[20] 주요 고객으로는 OpenAI와 UAE의 G42·MBZUAI, AWS를 꼽았다. 회사는 AMD, AWS와 손잡고 GPU가 프리필을, 세레브라스가 디코드를 맡는 구성을 내세운다.[20]
그록의 궤적은 더 극적이다. 작년 12월 엔비디아가 약 200억 달러에 기술 라이선스를 받고 창업자를 비롯한 핵심 인력을 데려갔다. 보도에 따르면 직원의 약 90%가 엔비디아로 옮겼다.[21] 남은 그록 법인은 LPU와 엔비디아 시스템을 섞어 쓰는 추론 클라우드로 바뀌었고, 8월 35억 달러 가치로 3.5억 달러를 조달했다. 2025년 9월 기업가치는 69억 달러였다. 현재 데이터센터 13곳에서 54MW를 운영하며, 2027년 200MW 이상이 목표다.[21] 엔비디아는 Hot Chips에서 그록의 전 수석 아키텍트가 발표자로 나서 Groq 3 LPX의 구조와 첫 제3자 측정치를 공개했다.[22]
그록의 설계 철학은 결정론적 실행이다. 일반 프로세서에는 캐시나 동적 스케줄링처럼 '실행해 봐야 아는' 요소가 많은데, 그록은 이것을 없애고 컴파일러가 모든 연산과 데이터 이동의 타이밍을 미리 확정한다. 지연의 편차가 사라지는 대신 연산의 모양이 일정해야 한다. 지연이 매우 중요한 영역에서만 다른 기능을 포기한 (e.g., 불확실성이 커지는 영역에서는 불가) 일부 영역 (e.g., 디코딩 전담)에서만 쓸 수 있는 장단이 있다. 1부에서 LPU가 FFN처럼 모양이 일정한 연산을 맡는다고 한 이유가 여기에 있다.
SRAM은 대역폭은 압도적이지만 용량이 작아 큰 모델을 담으려면 칩을 아주 많이 이어야 한다. 그래서 이들은 GPU를 대체하지 않고 GPU 옆에서 디코드를 가져가는 형태로 자리를 잡고 있다. 엔비디아의 LPX, 세레브라스와 AMD·AWS의 제휴가 모두 그 모양이다. 그리고 세레브라스와 그록 모두 칩을 파는 회사에서 칩을 돌려 토큰을 파는 회사로 옮겨 갔다. 추론 전용 스타트업의 현실적인 출구가 '독립 칩 회사'가 아니라 '기술 이전'이나 '추론 클라우드'라는 점은 이 분야 비상장 기업을 볼 때 염두에 둘 사례다.
8. 소프트웨어로 용도를 바꿀 수 있는 칩 - Tenstorrent, SambaNova, 퀄컴, 인텔
누구에게나 팔 수 있는 칩을 만들되 GPU와는 다른 구조로 승부하는 기업들이 있다.
Tenstorrent - 반(反)전문화. 반도체 설계의 전설이라 불리는 짐 켈러가 이끄는 텐스토렌트는 위의 기업들과 정반대의 철학을 내세운다. 켈러는 "CPU는 코드를 돌리고, GPU는 CPU를 가속하고, TPU는 GPU를, LPU는 TPU를 가속한다. 이런 복잡한 해법은 모델의 변화와 맞지 않는다"고 말하며, 프리필과 디코드를 같은 기계로 처리하고 칩을 따로 나누지 않는다고 설명한다.[23] 명령어 구조는 RISC-V이고 저수준 프레임워크 TT-Metal은 오픈소스다.[23]
4월 28일 일반 공급을 시작한 Galaxy Blackhole은 칩 32개를 6U 공랭 서버에 담아 11만 달러부터 판다. Block FP8 23PF, 온칩 SRAM 6.2GB(2.9PB/s), D램 1TB(16TB/s)이고, 서버 한 대에 800G 이더넷 포트가 최대 56개다.[23] 칩과 칩을 스위치 대신 이더넷으로 촘촘히 이어 규모를 키우는 방식이다. 회사는 DeepSeek-R1 671B에서 유저당 초당 350토큰 이상을 낸다고 발표했고, EE Times의 사전 시험에서는 짧은 대화 기준 255토큰이 측정됐다.[23] 약점은 소프트웨어 성숙도다. MoE 모델은 부분 지원이고, 어텐션 커널을 이 칩에 맞게 다시 써야 한다는 평가가 있다.[23]
SambaNova - 데이터가 흐르는 길을 재구성한다. 이 회사의 철학은 '명령이 아니라 데이터의 흐름을 최적화한다'이다. 머신러닝의 큰 병목은 데이터를 옮기는 일이므로, 모델의 연산 그래프를 데이터가 가장 효율적으로 흐르는 경로로 매핑하고 칩 내부를 그 경로에 맞게 재구성한다(RDU). RDU는 칩 안을 연산 유닛과 SRAM 메모리 유닛이 바둑판처럼 놓인 격자로 만들었다. 컴파일러가 모델의 연산 여러 개를 이 격자 위에 공간적으로 펼쳐 배치하고, 유닛 사이 연결을 그 순서대로 재구성한다. 한 연산이 실행되는 동안 다음 연산의 데이터를 병렬로 가져와 스트리밍 파이프라인을 만들고, 중간값은 모두 칩 안에 머문다. 그 결과 복잡한 연산 수백 개를 프로그래머가 손으로 커널을 짜지 않아도 커널 호출 한 번으로 합칠 수 있다. 2월에 공개한 5세대 SN50은 3계층 메모리(온칩 SRAM·HBM·D램)를 써서 10조 파라미터급 모델까지 지원한다고 밝혔다.[24]
제품 형태가 다른 회사들과 다르다. SambaRack SN50은 RDU 16개를 한 랙에 담는데 평균 소비전력이 약 20kW여서 공랭이다.[24] Vera Rubin NVL72가 190~230kW에 수랭인 것과 대비된다. 기존 공랭 데이터센터에 그대로 넣을 수 있다는 것이 판매 논리다. 소프트뱅크가 일본 데이터센터에 첫 배치하고, JP모건이 온프레미스 추론 파트너로 선정했다.[24]
8월 Hot Chips에서 이 회사가 내세운 개념이 흥미롭다. MBU(모델 대역폭 활용률), 즉 설치된 대역폭 가운데 실제로 가중치와 KV 캐시를 나르는 데 쓰인 비율이다. 같은 발표에서 여섯 개 프런티어 모델 구성을 분석해 보니 추론 시간의 75~97%가 디코드였고, DeepSeek V3에서는 97%였다고 밝혔다.[24] 1부의 디코드 중심 산수를 칩 회사가 같은 언어로 확인해 준 셈이다. 실제 배치도 그 방향이다. 7월 RAISE Summit에서 엔비디아 H200 4장이 프리필을, SN50 16개가 디코드를 맡는 구성을 시연했고, Artificial Analysis가 MiniMax M2.7에서 입력 1만 토큰 기준 초당 763토큰을 측정했다.[24]
이 회사의 자금 흐름은 시장의 온도를 보여 준다. 2021년 소프트뱅크 비전펀드가 주도한 6.76억 달러 투자 이후 자금난과 감원을 겪고 추론으로 방향을 틀었다. 올해 초 인텔과의 인수 협상 당시 평가는 16억 달러였는데, 7월 시리즈F 1차에서 110억 달러 가치에 10억 달러를 마감했다.[24] 몇 달 만에 약 7배다.
퀄컴 - 대역폭 대신 용량에 건다. 작년 10월 발표한 AI200은 카드당 LPDDR 768GB를 싣는다. HBM보다 훨씬 느리지만 용량이 크고 싸다. 2027년 AI250은 메모리 가까이에서 계산하는 구조로 유효 메모리 대역폭을 10배 이상 올린다고 주장하는데, 비교 기준은 밝히지 않았다. 두 제품 모두 160kW 수랭 랙으로 공급되고, 사우디 HUMAIN이 200MW 도입을 발표했다.[25] 1부의 산수로 보면 용량(두 번째 레버)을 먼저 확보하고 대역폭(첫 번째 레버)은 구조로 메우겠다는 순서다.
인텔은 Hot Chips 2026에서 차세대 GPU Crescent Island를 에이전트 추론용으로 소개했다.[26] 다만 이 시리즈에서 본 채택 현황에 인텔의 이름은 거의 나오지 않는다. 최근 인텔의 존재감은 자사 칩보다 SambaNova와의 다년 협력 쪽에서 더 크게 드러난다.[24]
이 칸의 공통점은 HBM을 피하거나 덜 쓴다는 것이다.
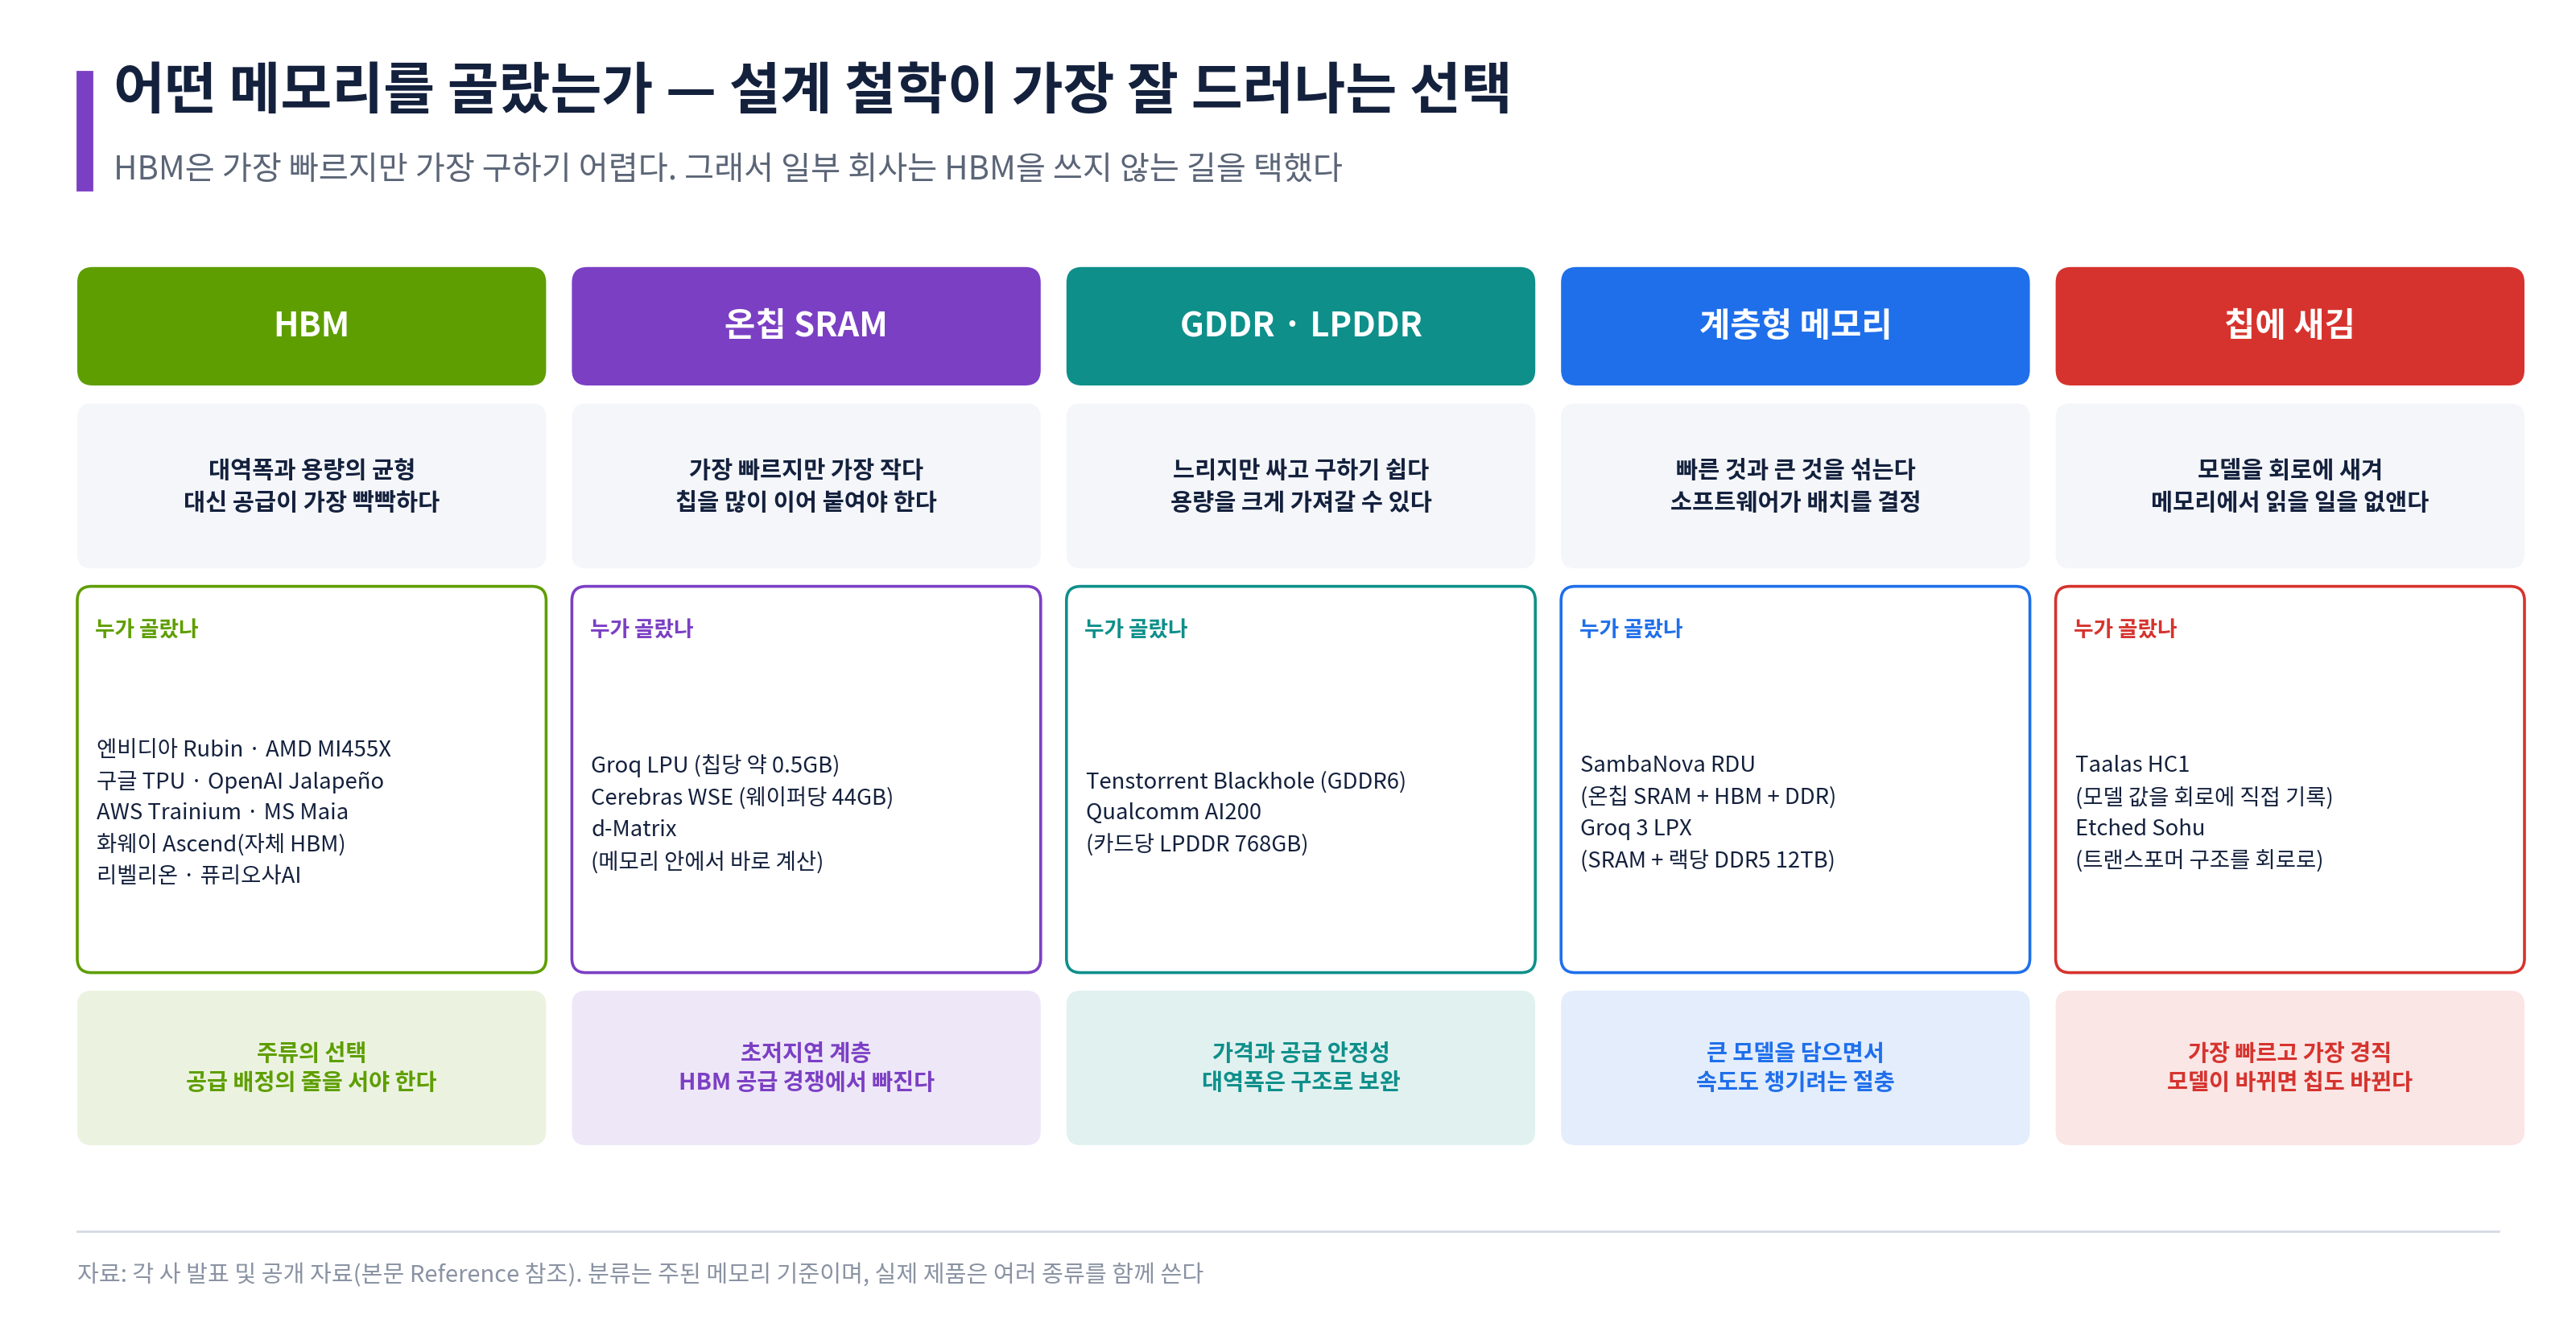
HBM은 대역폭과 용량의 균형이 가장 좋지만 3부에서 볼 것처럼 공급 배정의 줄을 서야 한다. 그 줄에 설 수 없는 회사들은 다른 길을 찾았다. SRAM으로 속도에 집중하거나, GDDR·LPDDR로 가격과 공급 안정성을 택하거나, 여러 메모리를 계층으로 쌓거나, 아예 모델을 칩에 새긴다. HBM 공급난이 길어질수록 HBM을 쓰지 않는 설계의 상대적 매력이 커진다.
9. 아예 회로에 새겨 버린 칩 - Etched, Taalas, 그리고 메모리 안에서 계산하는 d-Matrix
맨 위 칸에는 가장 과감한 내기를 한 회사들이 있다. 나중에 소프트웨어로 바꿀 수 있는 부분을 줄이고 그만큼을 속도와 효율로 바꾼 칩들이다. TrendForce는 이 칸을 '회로에 새긴 방식'과 '메모리 안에서 계산하는 방식'으로 나눠 분류한다.[27]
Etched는 트랜스포머라는 모델 구조를 회로로 고정했다. 6월 말 스텔스를 벗으며 TSMC N4P 공정에서 첫 실리콘이 동작한다고 밝혔고, 출하 전에 이미 10억 달러 이상의 고객 계약을 확보했다고 했다.[28] 회사는 Sohu 8개가 Llama-3 70B에서 초당 50만 토큰을 낸다고 주장한다(같은 조건 H100 8장 2.5만, B200 8장 4.3만). 독립 기관의 측정치는 아직 공개되지 않았다.[28]
흥미로운 것은 이 회사도 프리필과 디코드를 나눴다는 점이다. 프리필은 전압을 낮춰 돌리는 전용 칩이 맡고, 디코드는 여러 칩이 메모리를 한데 모아 쓰는 클러스터 규모의 메모리 시스템으로 처리한다.[28] 1부의 산수를 칩이 아니라 시스템 단위에서 적용했다. 자금은 7월 세쿼이아가 주도한 시리즈C에서 103억 달러 가치에 3억 달러를 조달했다. 작년 12월 50억 달러에서 7개월 만에 두 배다. 이 라운드에는 SK하이닉스가 참여했다.[28] 메모리를 쥔 회사가 '구조를 고정한 칩'에 지분을 넣었다는 점은, 이 방식이 실제로 양산될 가능성을 공급망도 보고 있다는 신호로 읽힌다.
이 내기의 전제는 하나다. 트랜스포머가 계속 주류로 남는다는 것이다. 맞으면 탁월한 선택이고, 구조가 예상보다 빨리 바뀌면 같은 집중이 약점이 된다.
Taalas는 한 걸음 더 갔다. 특정 모델의 값(가중치)을 읽기 전용 메모리(마스크 ROM)에 기록해 칩에 새긴다. 가중치를 메모리에서 읽어 오는 일 자체가 사라지므로 HBM도 필요 없다. 첫 칩 HC1은 TSMC 6nm에 트랜지스터 530억 개로 Llama 3.1 8B 전체를 담았고, 약 200W에서 유저당 초당 약 17,000토큰을 낸다고 회사는 밝혔다.[29] 80억 파라미터 모델 하나를 칩에 고정한 결과이므로 수천억 파라미터 모델을 돌리는 범용 서비스와 직접 비교할 수는 없다.
'모델을 바꾸려면 칩을 다시 만들어야 한다'는 약점에 대한 대답이 흥미롭다. 약 100개 층 가운데 금속층 두 개만 바꾸면 되고, 자체 설계 도구로 모델에서 완성 실리콘까지 약 두 달이면 간다는 것이다.[29] 사실이라면 3부에서 볼 '설계·검증 관문'을 구조적으로 짧게 만든 셈이다.
AMD는 8월 6일 이 회사를 인수하기로 했다고 발표했다. 금액은 공개하지 않았고 4분기에 거래가 끝난다. Taalas는 2023년 설립 이후 누적 2.19억 달러를 조달했다. AMD는 이 기술을 Instinct GPU, EPYC, Helios 랙, ROCm과 묶어 시스템 제품으로 만들겠다고 밝혔다.[29] 엔비디아의 그록 거래 이후 약 7개월 만이다. 3부에서 볼 인수 패턴, 즉 대형사가 자기 제품군의 빈칸을 사들인다는 흐름에 사례가 하나 더해졌다.
d-Matrix는 데이터를 메모리에서 꺼내 연산기로 옮기지 않고 메모리 안에서 직접 계산하는 방식으로 메모리 병목을 공략한다. 마이크로소프트가 투자했고, 약 20억 달러 가치에 2.75억 달러를 조달했다.[30]
이 칸에서는 회사 발표치와 검증된 수치를 특히 엄격하게 구분해야 한다. 첫 독립 벤치마크가 나오는 시점이 이 칸의 분기점이다.
10. NPU - 화웨이의 정반대 설계, 그리고 국내 NPU의 자리
화웨이는 첨단 공정과 HBM 수급이 막힌 상태에서 칩을 설계한다. 화웨이 스스로 엔비디아 GPU와 성능으로 겨룰 프로세서는 만들 수 없다고 인정하고, 칩 수를 늘리는 쪽을 택했다.[31] Ascend 950 시리즈는 용도별로 나뉜다. 950PR은 추론의 프리필과 추천 모델용으로 3월에 나왔고, 950DT는 디코드와 학습용이다. 950DT는 자체 개발 HBM 144GB(4TB/s)와 칩 간 연결 2TB/s를 갖추고, FP8 1PF다. 4분기에 출시된다.[31] 화웨이는 이 칩 8,192개를 광 인터커넥트로 묶은 Atlas 950 SuperPoD(FP8 8EF)를 발표했고, 2027년 4분기 Atlas 960은 15,488개로 늘린다.[31] 다만 현재 공개된 제품표에는 1,024카드 구성까지만 올라와 있다.[31] 첨단 공정과 HBM에서 막힌 칩의 열세를 광 스케일업과 칩 수로 메우는 구조다.
국내 NPU는 추론 효율과 국산 공급망을 앞세운다. 리벨리온의 리벨쿼드는 삼성 파운드리 4nm, HBM3E 144GB(4.8TB/s)를 탑재했다.[32] 큰 칩 두 개 대신 320㎟짜리 칩렛 네 개를 칩렛 표준 규격(UCIe-Advanced)으로 이었는데, 작은 칩은 개발과 수율 확보가 쉽다.[32] 회사는 H200 대비 추론 성능이 약 50% 높고 전력은 절반이라고 주장한다. ISSCC 2026에서 논문과 실물 데모를 발표했고, 5월에 본격 양산 중이며 연내 글로벌 공급을 시작한다고 밝혔다.[32]
퓨리오사AI의 설계 철학은 2024년 ISCA 논문에 나와 있다. 행렬곱이 아니라 텐서 축약을 기본 연산으로 삼는다. 행렬로 펼치기 전의 텐서 모양 정보를 살려 연산하면 데이터를 재사용할 기회가 늘어나고, 배치 크기가 들쭉날쭉한 추론에 유리하다는 주장이다.[33] 이 구조를 쓴 RNGD는 TSMC 5nm, SK하이닉스 HBM3, FP8 512TFLOPS, 전력 180W다.[34] LG AI연구원의 엑사원 실증에서 GPU 대비 전력당 성능 2.25배를 기록했다.[34] 1월에 TSMC로부터 1차 양산분 4,000장을 받았고 올해 약 2만 장이 목표다.[34] 8월에는 스웨덴 스톡홀름의 15MW 데이터센터 사업에 참여해 1단계에 1,800장, 확장까지 포함해 8,800장 이상을 공급하기로 했다.[34] 국산 NPU가 해외 데이터센터에 수천 장 단위로 들어가는 사례다.
한 가지 사례가 3부의 주제를 미리 보여 준다. 퓨리오사AI는 원래 작년에 양산 물량을 받을 예정이었지만, 설계 보완과 TSMC의 대기 기간이 겹쳐 인도가 해를 넘겼다. 보도에 따르면 최근 TSMC의 양산 주문에서 인도까지는 약 10개월이 걸린다.[34] 칩을 설계하는 것과 제때 만들어 받는 것은 다른 문제다.
문제는 1부와 2부에서 반복해서 확인한 사실, 즉 추론의 경제성을 정하는 것이 칩이 아니라 도메인이라는 점이다. 국내 NPU는 칩 하나의 효율로는 경쟁력이 있지만 대형 모델용 스케일업 도메인을 아직 보여 주지 못했다. 그래서 당분간의 시장은 도메인이 크게 필요 없는 곳이다. 중소형 모델의 기업 내부 추론, 공공·금융의 국산화 수요, 그리고 퓨리오사AI의 스웨덴 사례 같은 해외 소버린 AI 수요다. 이 칩들을 평가할 때 볼 것은 세 가지다. ① 스케일업을 어떤 표준으로 할 것인가(UALink나 이더넷 기반 스케일업에 올라타는가), ② 서빙 소프트웨어가 분리 서빙과 전문가 병렬을 지원하는가, ③ 다음 세대의 메모리 전략이다. 4부에서 볼 국내 DPU 회사 망고부스트는 같은 질문에 '시스템을 직접 만든다'로 답한 사례다.
11. 모델을 만드는 기업 (DeepSeek)이 바라보는 하드웨어
지금까지는 칩을 만드는 쪽의 이야기였다. 반대편, 모델을 만드는 쪽은 하드웨어를 어떻게 볼까. 2025년 ISCA에 실린 DeepSeek-V3 논문이 드문 자료다. 모델 회사가 컴퓨터 구조 학회에 나와 부딪힌 하드웨어의 한계와 다음 칩에 바라는 점을 적었다.[35]
이 논문은 1부의 산수를 모델 개발자의 언어로 확인해 준다. KV 캐시를 쓰면 토큰 하나를 만드는 계산이 행렬×행렬에서 행렬×벡터로 바뀌어 연산에 비해 읽어야 할 데이터가 많아지고, 그래서 메모리 접근이 1차 병목이 된다는 것이다.[35]
가장 인상적인 숫자는 KV 캐시 크기다. DeepSeek-V3는 어텐션 구조를 바꿔(MLA) 토큰당 KV 캐시를 약 70KB로 줄였다. 같은 논문이 비교한 Qwen-2.5 72B는 약 327KB, LLaMA-3.1 405B는 약 516KB다. 각각 4.7배, 7.3배 차이다.[35] 1부의 산수를 떠올리면 의미가 분명하다. 디코드의 병목은 '스텝당 읽는 바이트'인데, 모델 쪽에서 그 분자를 7분의 1로 줄였다. 칩이 대역폭을 두 배로 올리는 데는 한 세대가 걸리는데, 모델은 구조를 바꿔 같은 효과를 그보다 빨리 낸다.
이 논문이 2부에 주는 교훈은 공동 설계가 한 방향이 아니라는 것이다. 칩 회사가 모델에 맞춰 칩을 만들기도 하지만, 모델 회사가 칩의 한계에 맞춰 모델을 만들기도 한다. 그리고 후자가 더 빠르다. 사다리의 위쪽 칸, 특히 모델의 구조나 값을 회로에 고정한 칩에는 이것이 가장 큰 위험이다. 모델 회사는 다음 분기에 어텐션 구조를 바꿀 수 있고, 칩은 그럴 수 없다.
12. 만든 사람들이 직접 설명한 설계 철학
지금까지 인용한 발표와 논문을 한 장으로 모았다. 최근 1~2년 안에 각 회사가 자기 칩의 구조를 직접 설명한 자리만 골랐다.
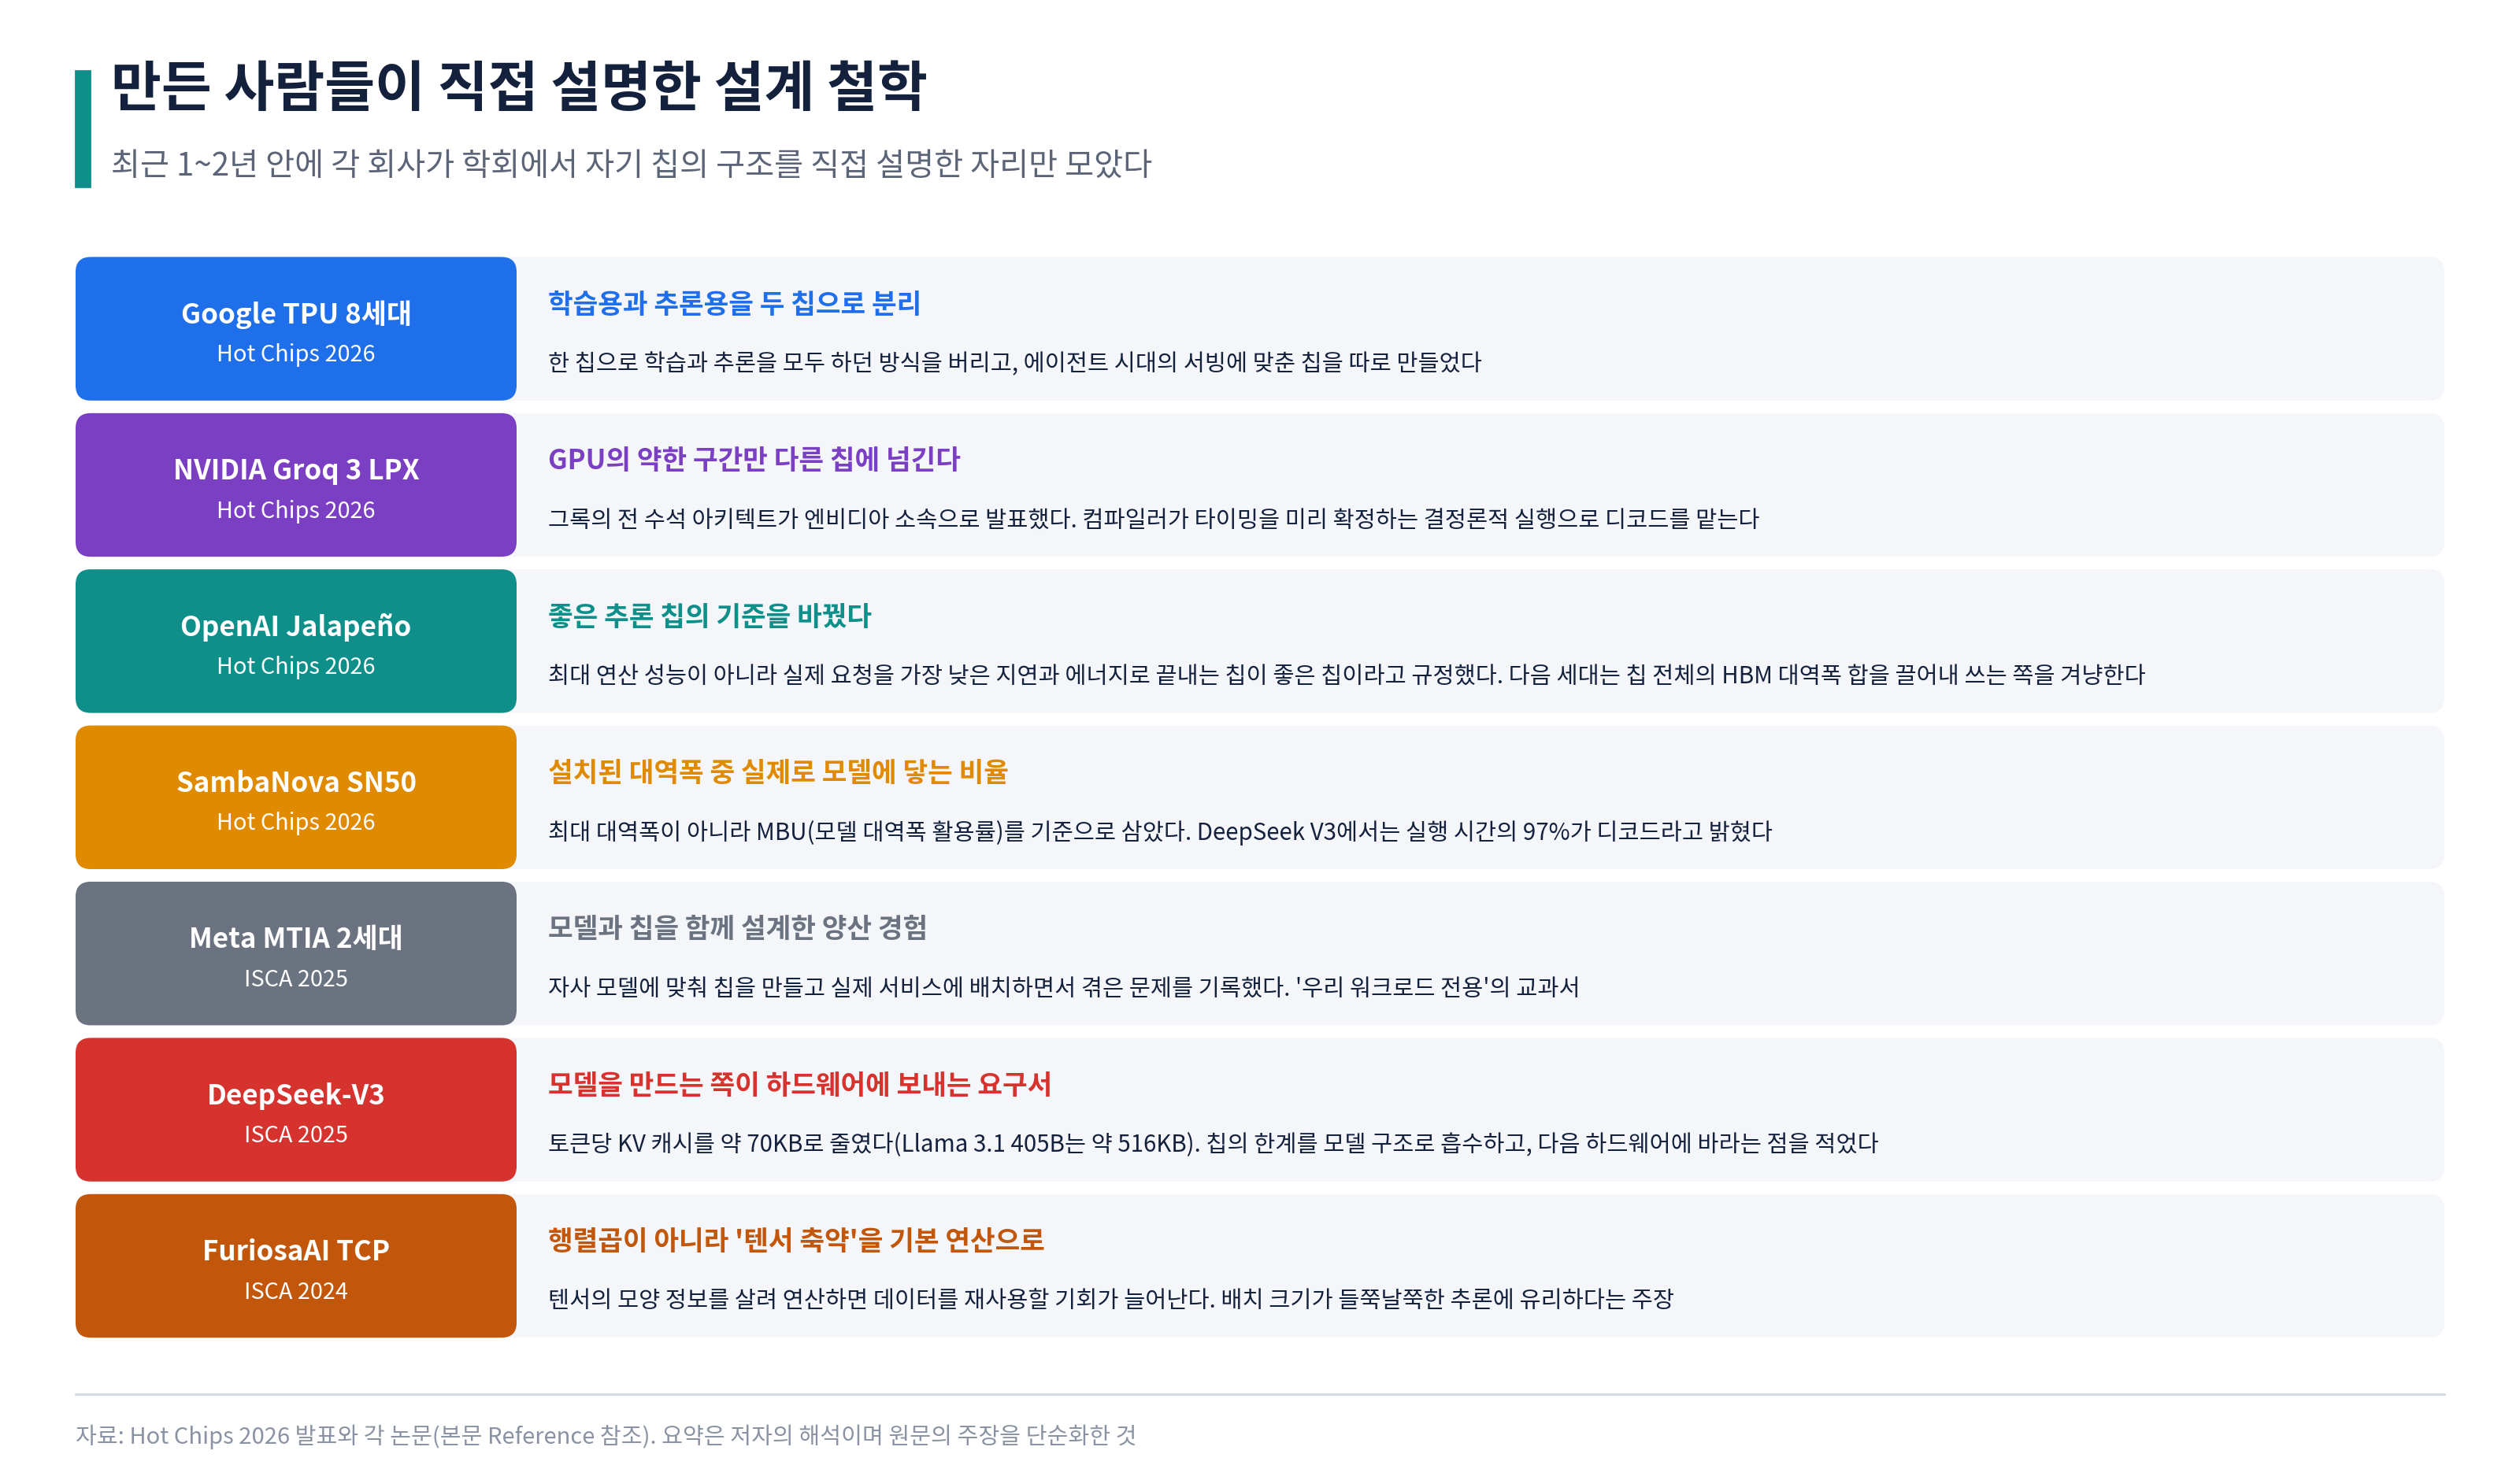
나란히 놓으면 두 부류로 나뉜다. 구글, 메타, OpenAI, DeepSeek의 발표는 '우리 워크로드가 이러하니 하드웨어가 이래야 한다'는 구매자의 언어로 쓰였다. 그록, 퓨리오사AI, SambaNova의 발표는 '이런 구조가 AI 연산에 더 맞다'는 공급자의 언어로 쓰였다. 앞의 부류는 그 하드웨어를 쓸 고객이 자기 자신이다. 뒤의 부류는 그 구조를 받아 줄 고객을 찾아야 한다. 14장의 채택 현황에서 이 차이가 그대로 나타난다.
13. 스케일업 설계 지도 - 세 가지 철학, 그리고 한 방향
지금까지 본 시스템들을 '도메인 크기'와 '칩당 스케일업 대역폭'의 평면에 놓으면 설계 철학이 세 갈래로 나뉜다.
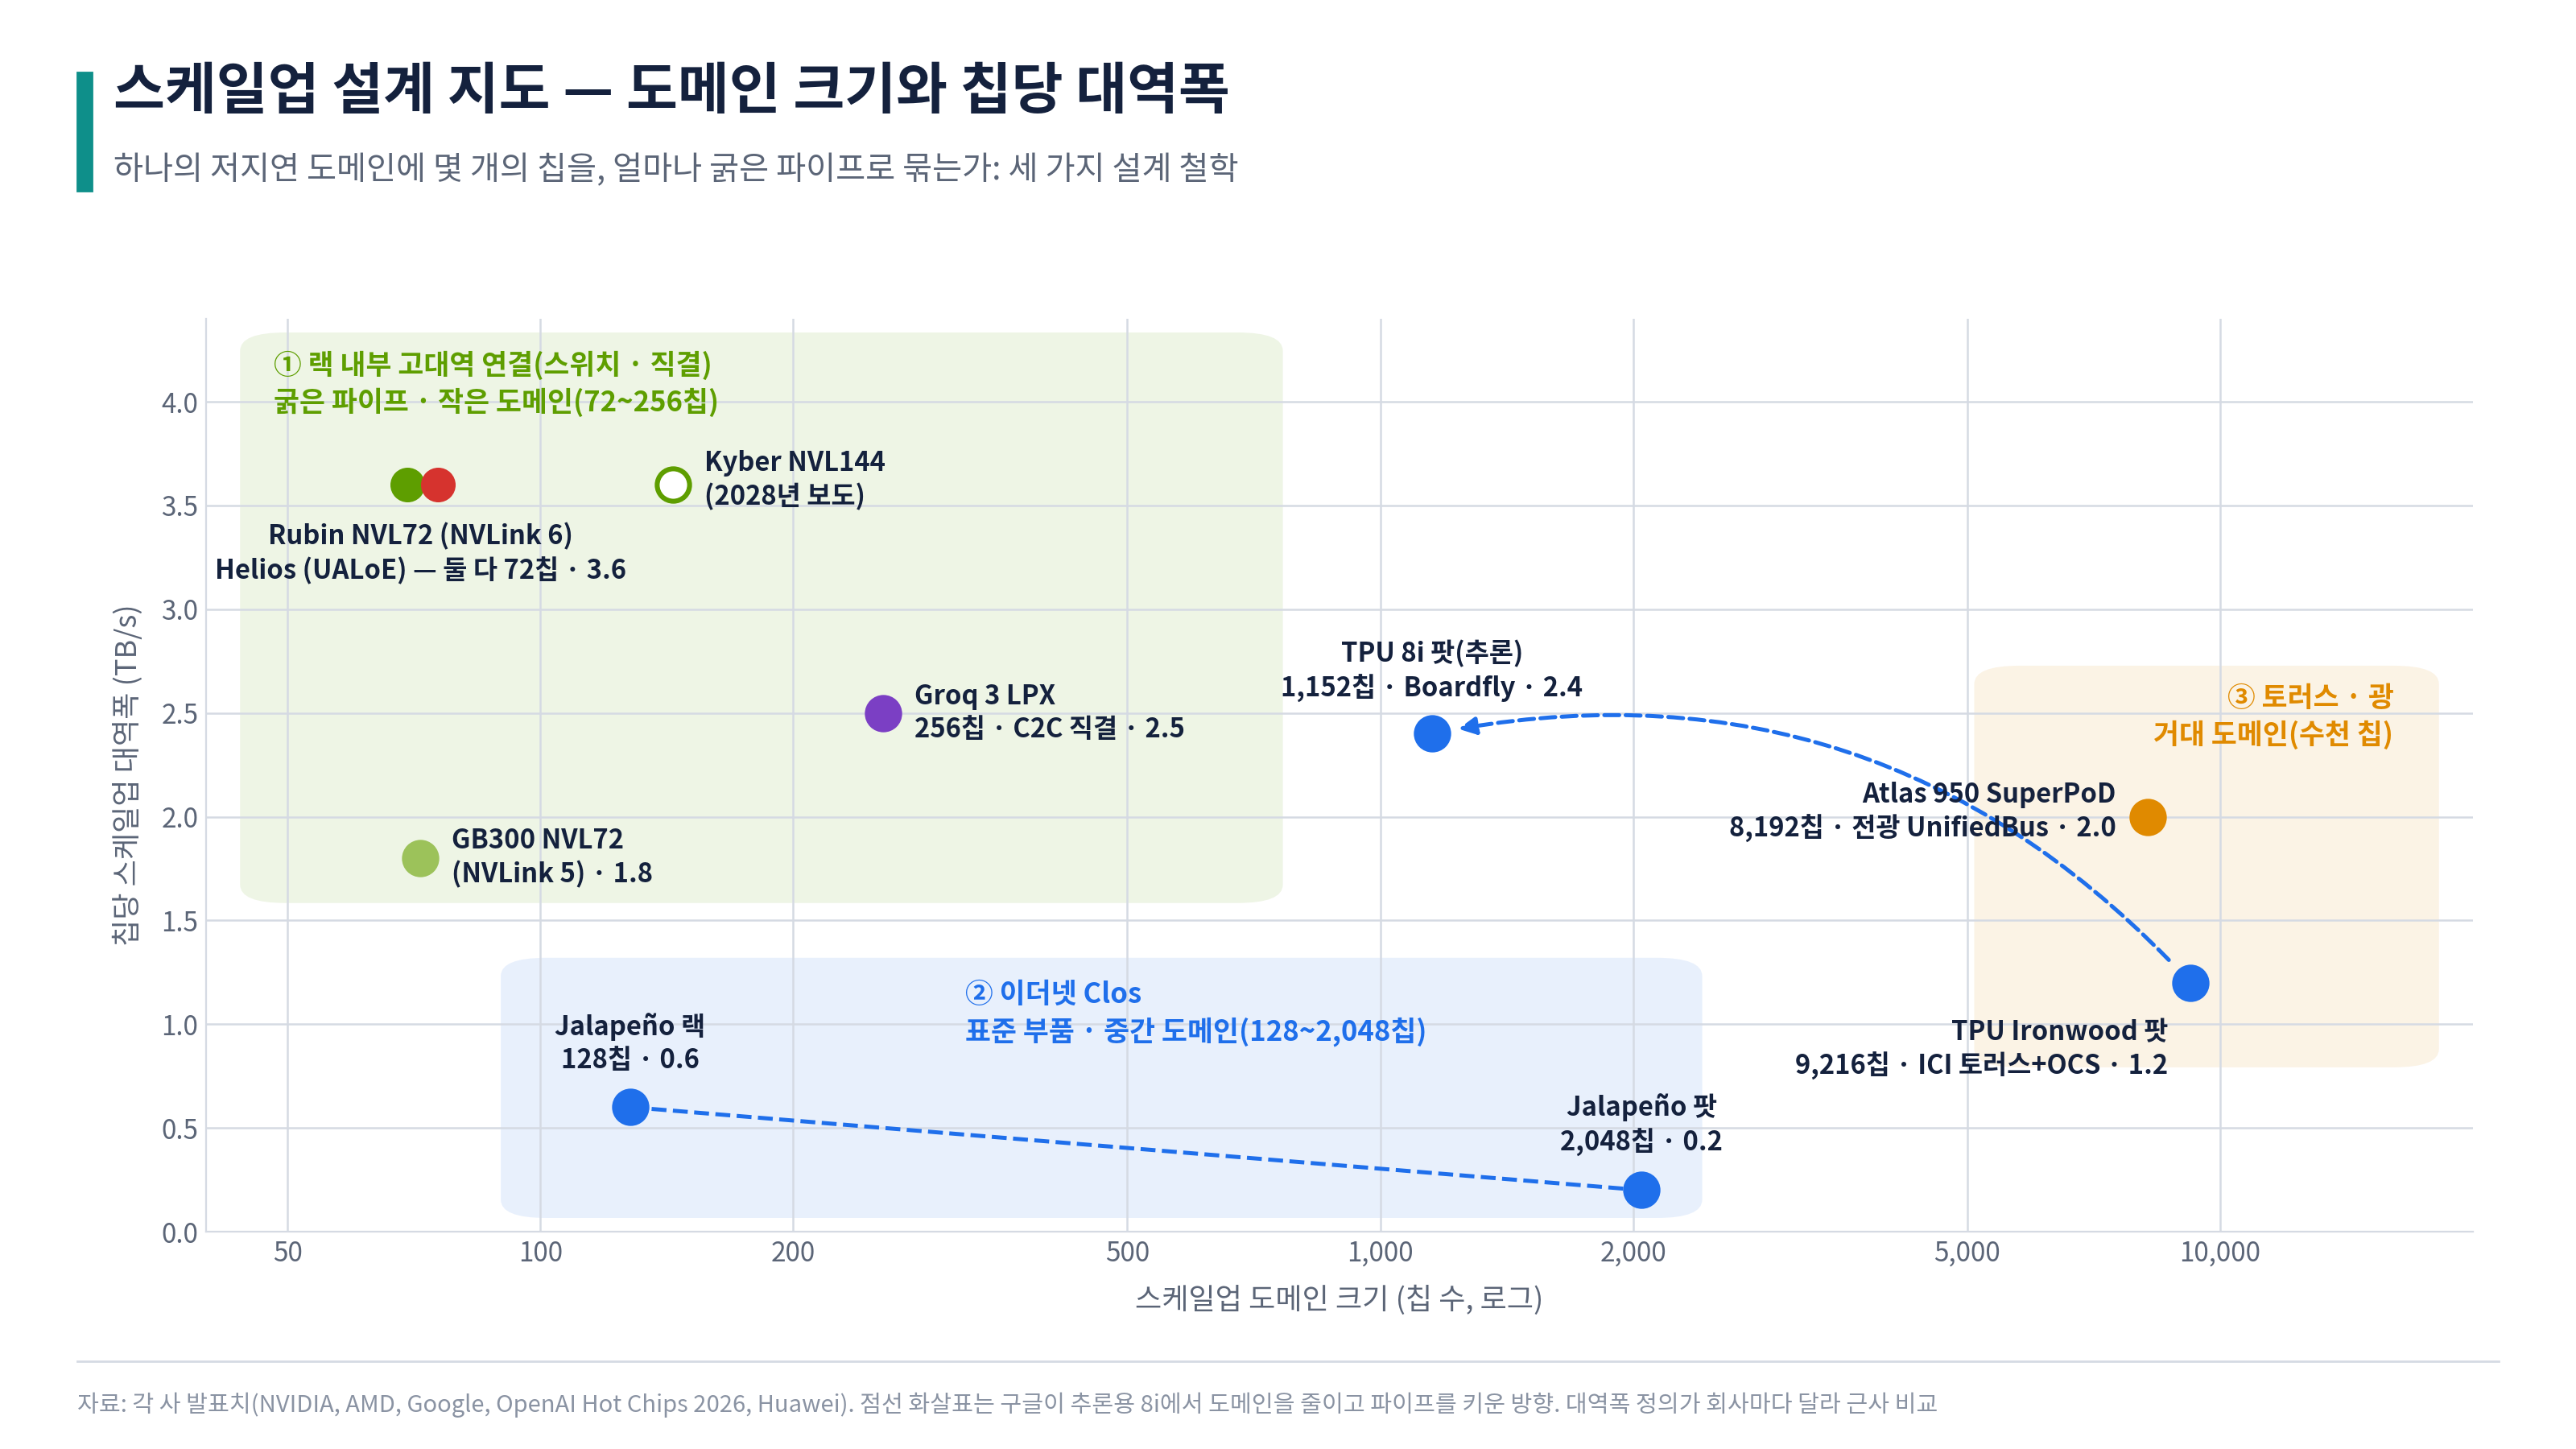
① 굵은 파이프, 작은 도메인. 엔비디아 NVL72와 AMD Helios다. 72개를 칩당 3.6TB/s로 묶는다. 256개 LPU를 칩 간 직결로 묶는 LPX 랙도 같은 부류다. 어떤 통신 패턴이 와도 견디는 범용성이 장점이고, 구리의 도달 거리와 랙의 전력·배선 한계 때문에 도메인을 키우기 어렵다는 것이 단점이다.
② 표준 이더넷, 중간 도메인. OpenAI Jalapeño다. 칩당 대역폭을 6분의 1로 줄이는 대신 128개에서 2,048개까지 표준 스위치로 넓힌다. 모델의 통신 패턴을 아는 회사만 선택할 수 있는 설계다.
③ 토러스와 광, 거대 도메인. 구글 Ironwood(9,216개)와 화웨이 Atlas 950(8,192개)이다. 구글은 작은 파이프를 토폴로지로 보완하고, 화웨이는 광으로 파이프와 도메인을 둘 다 키우되 그만큼의 전력과 비용을 치른다.
그런데 추론 쪽에서는 세 갈래가 한 방향으로 움직이고 있다. 구글은 추론용 8i에서 도메인을 1,152개로 줄이고 칩당 파이프를 두 배로 키웠다. 그림의 점선 화살표가 그 이동이다. 엔비디아는 2028년 Feynman에서 CPO를 내장한 NVLink 스위치로 굵은 파이프를 유지한 채 도메인을 넓히려 한다. 표준 쪽에서는 UALink와 이더넷 기반 스케일업(ESUN)이 개방형 진영의 축이다. 필자는 2028년 전후로 세 갈래가 '광을 이용한 수백~1,000개 규모의 굵은 도메인'에서 만날 것으로 본다. 이 접점이 광통신 시리즈에서 다룬 CPO와 OCS가 가속기 시스템 안으로 들어오는 자리다.
14. 하이퍼스케일러들은 무엇을 샀나 (칩 채택 동향)
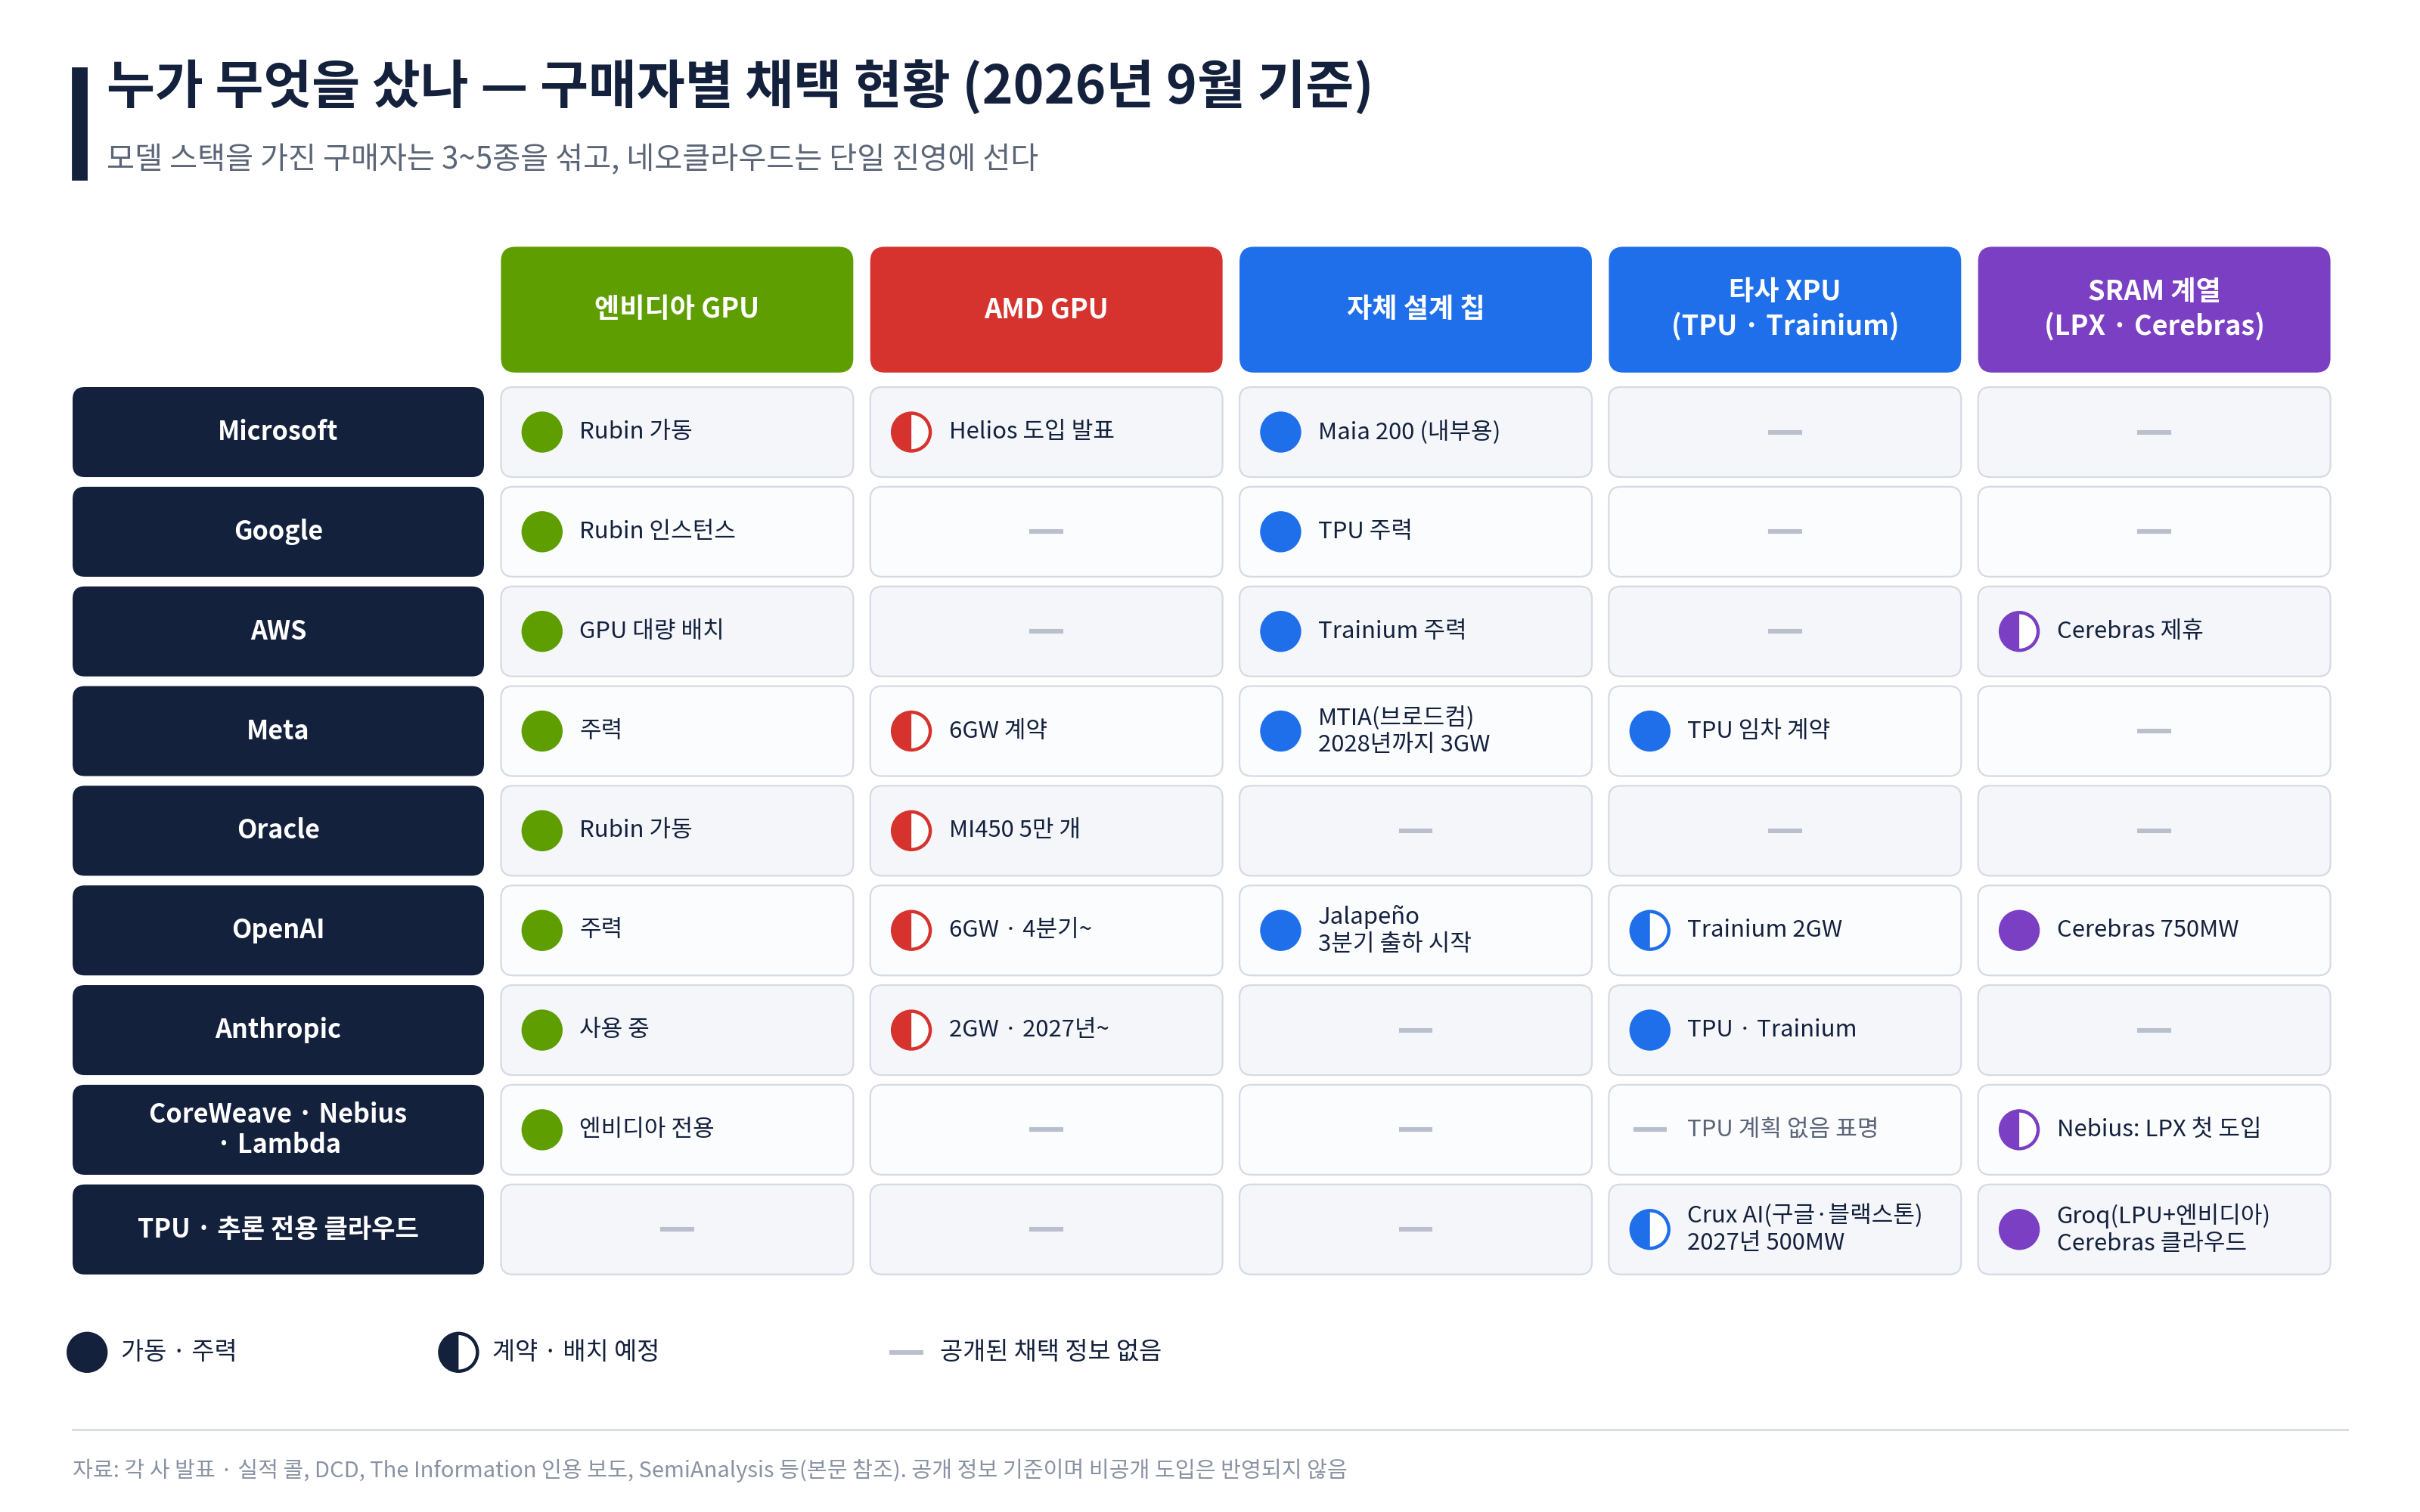
표에서 읽히는 구조는 양극화다. 모델 스택을 직접 가진 프런티어 연구소와 하이퍼스케일러는 예외 없이 여러 칩을 섞어 쓴다. OpenAI는 엔비디아, AMD, 자체 칩, Trainium, 세레브라스를 모두 쓰고, Anthropic은 TPU, Trainium, 엔비디아에 2027년부터 AMD를 더한다. 반면 네오클라우드의 주류는 엔비디아 단일 구성이다. 네비우스, 람다, 코어위브는 당분간 TPU를 도입할 가능성이 낮다고 밝혔다. 엔비디아는 이 세 회사의 주요 투자자이기도 하다.[36] 그 빈자리를 구글·블랙스톤의 Crux AI 같은 TPU 전용 클라우드와, 세레브라스·그록 같은 추론 전용 클라우드가 채우기 시작했다.
이 양극화는 기술적 판정과 맞아떨어진다. 자체 칩과 대안 칩의 이점은 모델과 서빙 소프트웨어를 칩에 맞춰 고칠 수 있는 구매자만 살릴 수 있다. 그럴 역량이 없는 구매자에게는 아무 모델이나 바로 돌아가는 엔비디아가 여전히 합리적인 선택이다. 그래서 엔비디아는 밀려나는 것이 아니다. 모든 구매자의 목록에 남아 있다. 줄어드는 것은 상위 대여섯 개 구매자의 '추가 물량'에서 엔비디아가 차지하는 몫이다.
15. 시스템은 어떤 형태로 갈 것인가 - 2028년까지의 전망
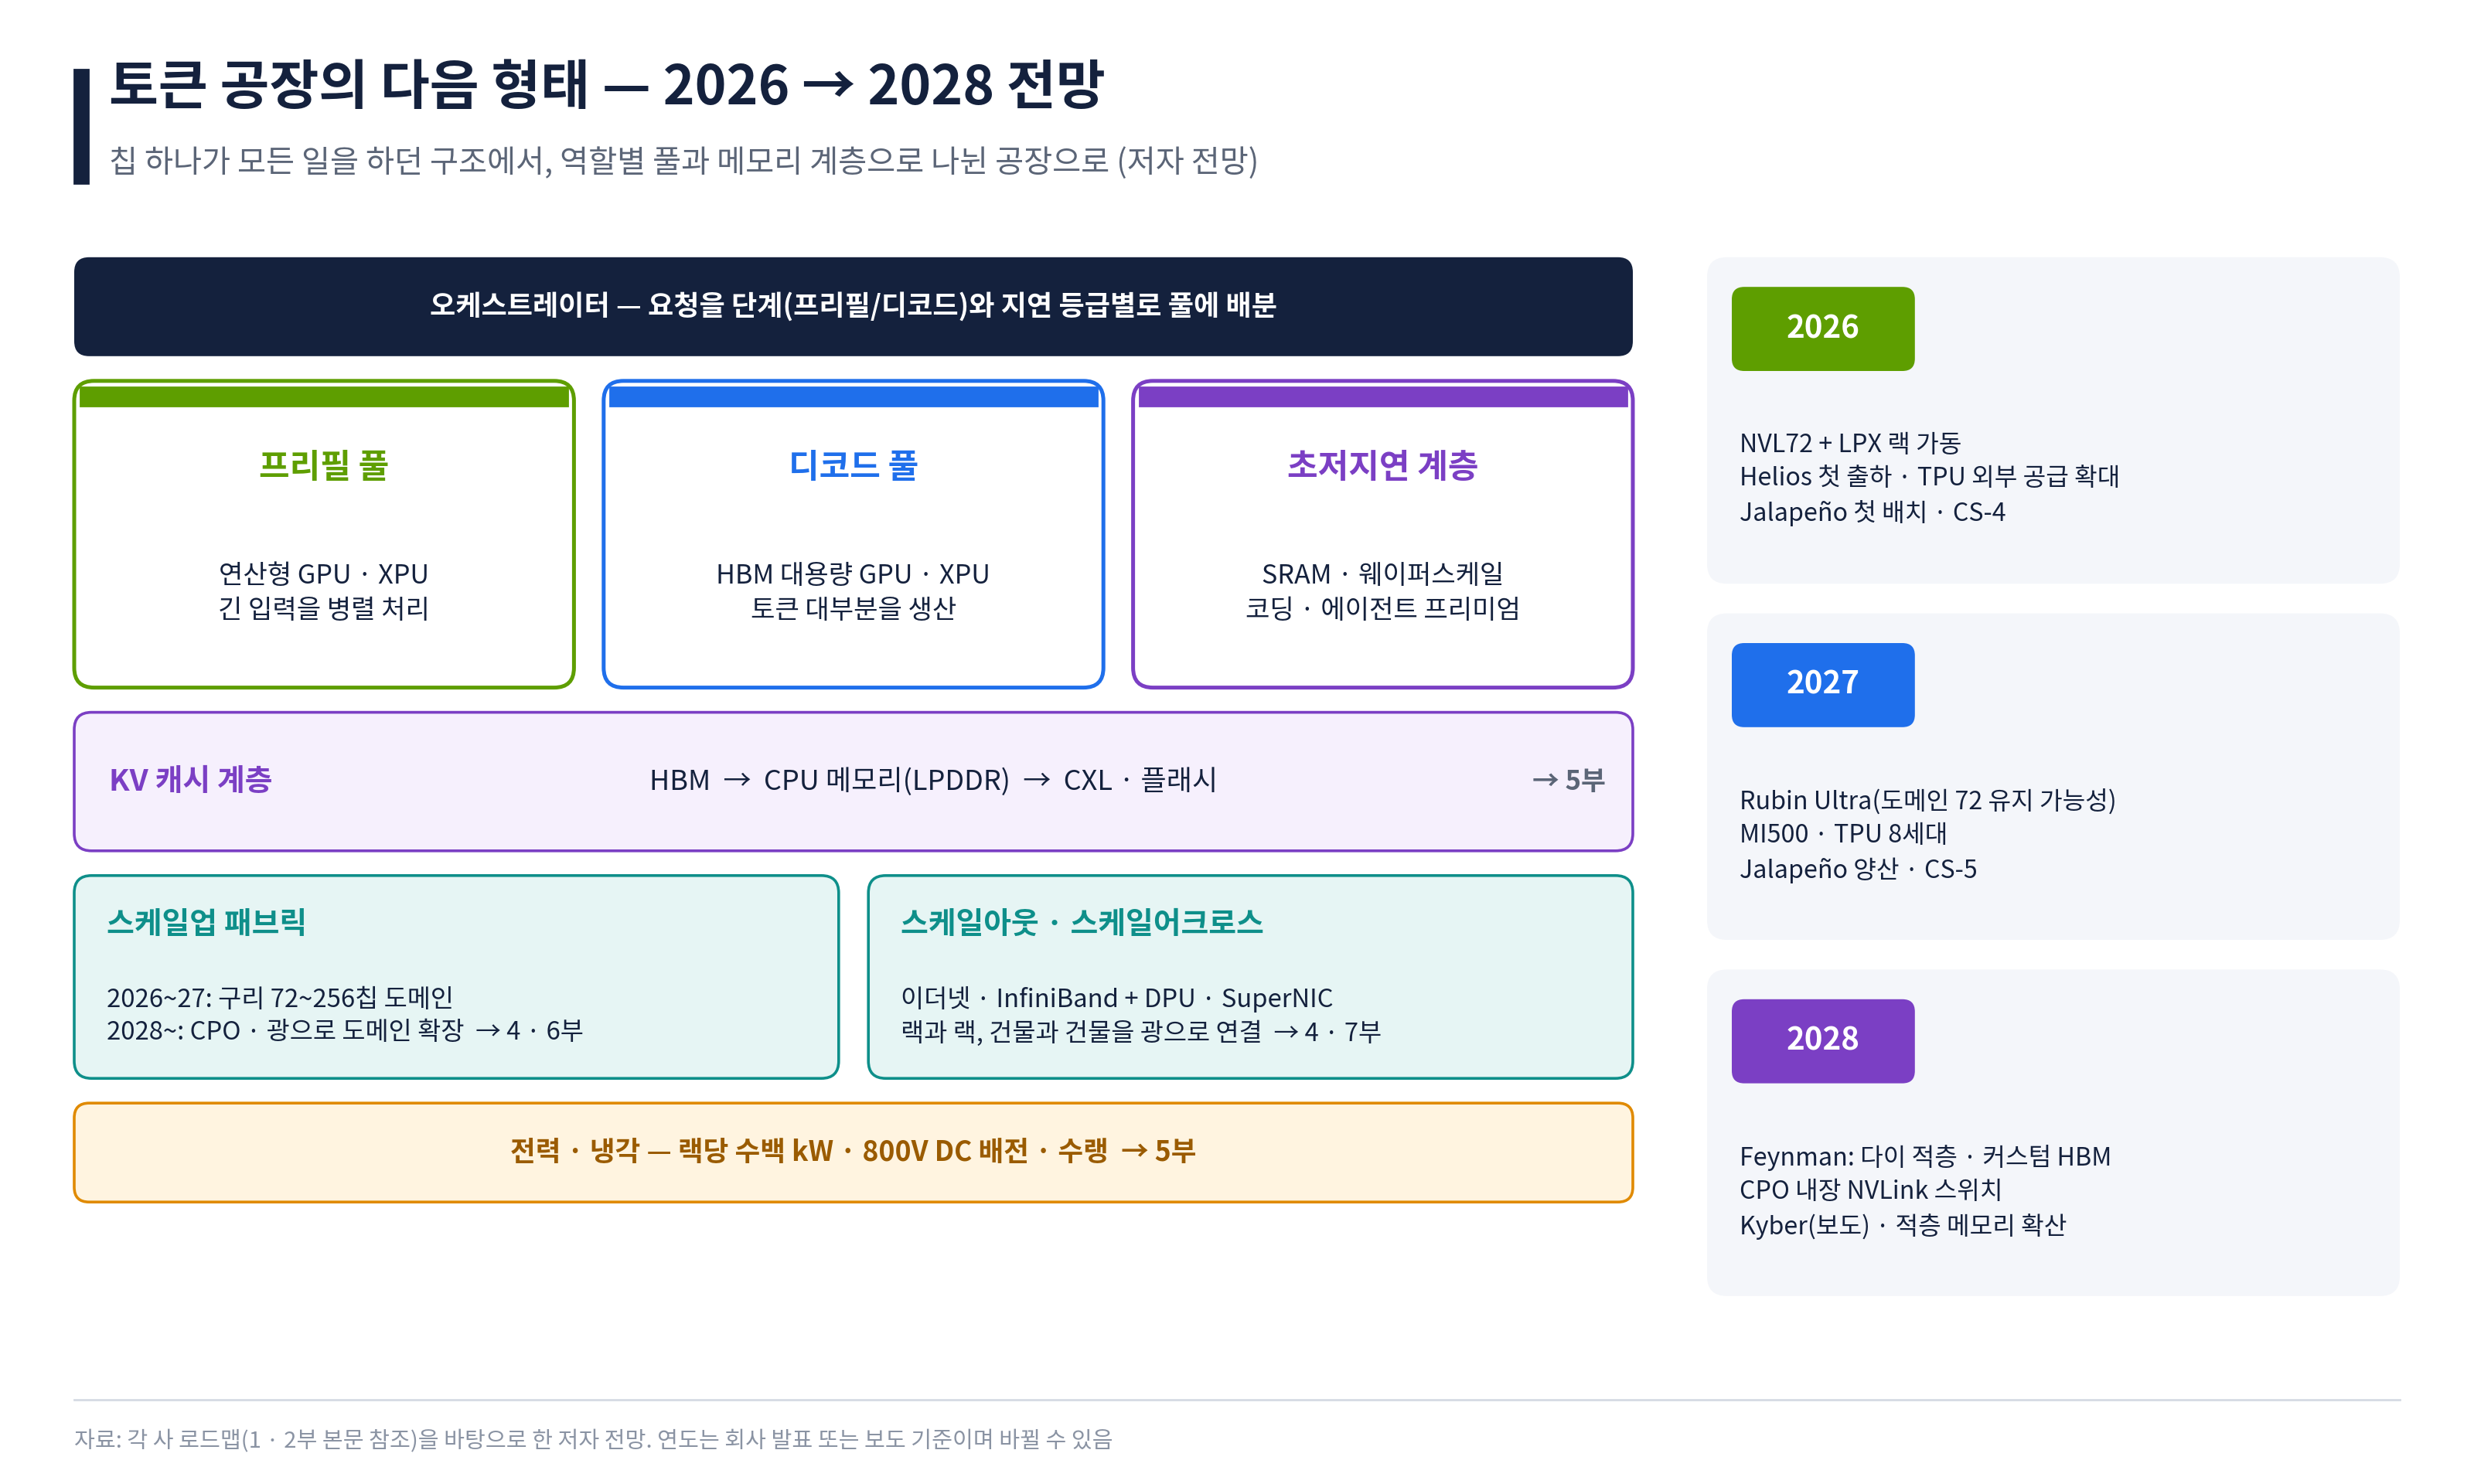
필자의 전망을 다섯 개의 명제로 정리하고, 각 명제에는 그것이 틀렸다고 판단할 조건도 함께 적는다.
명제 1. 추론은 단계별로 나뉜다. 프리필 풀, 디코드 풀, 초저지연 계층이 대형 서빙 시스템의 표준이 된다. 근거는 거의 모든 진영이 같은 방향으로 움직였다는 것이다. 엔비디아는 GPU에 LPU를 붙였고, 구글은 학습용 8t와 추론용 8i로, 화웨이는 950PR과 950DT로 칩을 나눴다. 세레브라스와 SambaNova는 GPU가 프리필을, 자기 칩이 디코드를 맡는 구성을 내세우고, Etched는 아예 두 단계를 서로 다른 부품으로 설계했다. 반례는 Tenstorrent다. 같은 기계로 둘 다 처리하는 것이 모델 변화에 더 강하다고 주장한다. 반증 조건은 LPX 같은 SRAM 계층의 채택이 소수 클라우드에서 멈추는 경우다.
명제 2. 추론 칩 회사는 클라우드 회사가 된다. 세레브라스의 하드웨어 매출은 줄고 클라우드 매출은 세 배 가까이 늘었다. 그록은 엔비디아 시스템까지 들이는 추론 클라우드로 바뀌었고, SambaNova는 랙과 클라우드를 함께 판다. 퓨리오사AI는 해외 데이터센터 사업에 직접 들어갔다. 칩을 팔려면 고객이 그 칩에 맞춰 소프트웨어를 고쳐야 하지만, 토큰을 팔면 그 부담을 칩 회사가 진다. 3부에서 볼 소프트웨어 관문을 넘는 가장 현실적인 방법이다. 반증 조건은 이 회사들이 대형 고객에게 칩이나 랙 자체를 대량으로 파는 계약을 연이어 발표하는 경우다.
명제 3. 굵은 파이프의 도메인은 2027년까지 랙 하나(72~256개)에 머물고, 2028년부터 광으로 넓어진다. 지금 수천 개 규모의 도메인은 모두 칩당 대역폭을 낮춘 이더넷이나 토러스로 구현된 것이다. 굵은 파이프를 유지한 채 도메인을 키우려면 구리의 도달 거리를 넘어야 하고, 그 수단이 광이다. 보도대로 Kyber가 밀린다면 2027년은 엔비디아의 도메인이 가장 작게 머무는 해가 된다. 반증 조건은 GTC 2027 전후에 Kyber의 2027년 양산이 확인되는 경우다.
명제 4. KV 캐시가 독립된 계층이 된다. 에이전트 워크로드는 수십~수백 턴에 걸쳐 컨텍스트가 쌓이고, SemiAnalysis의 에이전트 벤치마크에서는 KV 캐시 적중률이 95%를 넘는다.[37] 다시 계산하지 않고 저장해 뒀다 꺼내 쓰는 것이 경제적이라는 뜻이고, 그 저장 위치는 HBM에서 CPU 메모리, CXL, 플래시로 내려간다. 5부의 주제다. 반대편에서 모델은 DeepSeek처럼 KV 캐시 자체를 줄이는 방향으로 움직인다. 두 흐름이 부딪히는 지점에서 메모리 계층의 크기가 정해진다.
명제 5. 성능의 단위는 'MW당 토큰', 비용의 단위는 'GW당 칩 값'으로 굳어진다. 데이터센터의 1차 제약이 칩 공급에서 전력으로 옮겨 갔기 때문이다. 엔비디아의 GW당 약 400억 달러와 브로드컴의 GW당 200억~300억 달러라는 두 숫자가 구매자의 계산기가 된다.
그래서 누가 앞서 나가는가. 측정된 증거만 놓고 말하면, 2026년의 효율 경쟁은 Rubin을 실측으로 증명한 엔비디아가 앞에 섰다. 맞춤형 칩 진영의 강점은 효율이 아니라 비용과 도메인 구성의 자유, 그리고 그 칩을 살 구매자가 곧 설계자라는 사실이다. 이들은 2027년 TPU 8i와 양산에 들어가는 Jalapeño로 Rubin과 처음 같은 세대에서 맞붙는다. SRAM 계열은 계층으로, 독립 NPU는 도메인이 필요 없는 시장과 소버린 수요에서 자리를 찾는다. 구도가 기술적으로 다시 바뀔 시점은 3D 적층 메모리와 광 스케일업이 함께 들어오는 2028년이다. 공교롭게도 그해는 공급이 풀리기 시작하는 해이기도 하다. 엔비디아가 말한 공급 병목의 끝, 5부에서 볼 메모리 신규 공급, 6부에서 볼 소재 증설이 모두 2027년 말~2028년에 걸려 있다. 만들 수 있는 칩이 다 팔리는 동안 가려져 있던 점유율 경쟁이 매출로 드러나는 첫해가 기술의 전환점과 겹친다.
투자 관점 체크포인트
1) 맞춤형 칩 (ASIC)의 시장 크기는 브로드컴의 AI 매출과 고객별 GW 계획으로 확인한다. GW당 칩 값(엔비디아 약 400억 달러 대 브로드컴 200억~300억 달러)의 격차가 유지되는지가 핵심이다.
2) ASIC의 대표 주자인 구글의 TPU는 분리 서빙끼리 비교한 실측이 나오는 시점, TorchTPU 공개, Crux AI의 첫 고객이 외부 확산의 지표다. TPU의 외부 사용이 안정화 및 성장세가 확인되면, 또 하나의 ASIC 붐이 일어날 것으로 추측한다.
3) Jalapeño와 TPU 8i는 Rubin과 같은 조건에서 비교한 결과가 나오기 전까지 '효율 우위'를 전제하지 않는다. 따라서, 실제 클라우드 및 고객사의 실제 Deploy 현황을 체크해야 할 것으로 보인다.
4) 추론 전용 스타트업은 칩 판매보다 클라우드 매출 비중, 그리고 독립 벤치마크 유무를 먼저 본다. 회로에 새긴 방식은 모델 구조가 바뀔 때의 대응 계획을 확인한다.
5) 국내 NPU는 칩 효율보다 시스템 편입(스케일업 표준, 서빙 소프트웨어, 해외 데이터센터 레퍼런스)과 제조 일정의 안정성으로 평가한다.
Conclusion
GPU 외의 AI가속기들은 같은 전력 예산을 다르게 배분했다. 구글은 칩당 파이프를 줄여 도메인을 키웠다가 추론 칩에서는 다시 파이프를 키웠고, OpenAI는 연산을 덜어 메모리 대역폭에 실었으며, 세레브라스와 LPU는 용량을 포기하고 대역폭을 극단으로 끌어올렸다. Etched와 Taalas는 유연성을 포기하고 속도를 샀다. 이 선택의 대가는 모두 같은 곳에서 치러진다. 모델이 바뀔 때 버틸 수 있는가, 그리고 그 칩에 맞춰 소프트웨어를 고칠 수 있는가다. 그래서 대가를 감당할 수 있는 구매자, 즉 모델을 직접 만드는 회사들이 자체 칩을 가장 많이 쓰고, 그렇지 않은 구매자에게는 엔비디아가 여전히 합리적인 선택으로 남는다. 칩을 파는 대신 토큰을 파는 쪽으로 옮겨 가는 추론 칩 회사들은 이 대가를 스스로 떠안기로 한 경우다.
다음 부 예고
3부에서는 잠시 방향을 바꿔, 이 칩들을 만드는 일 자체가 왜 어려운지를 본다. AI 칩 회사가 통과해야 하는 관문은 다섯 개인데 설계는 그중 두 번째일 뿐이다. 스펙을 올리는 물리적 방법이 왜 세 가지로 제한되는지, 첫 칩이 한 번에 성공할 확률이 왜 떨어지고 있는지, 패키징과 HBM 접근권이 왜 자본으로도 풀리지 않는지, 새 모델 하나를 새 칩에 올릴 때 실제로 무엇이 막히는지, 그리고 랙 72개를 한 대의 컴퓨터처럼 돌리는 일이 왜 별개의 난제인지를 정리한다.
Reference
모든 링크는 2026년 9월 기준으로 접속해 해당 수치를 확인했다. 회사 발표치는 회사의 주장이며 독립 검증과 구분해 읽어야 한다.
[1] Broadcom FY2026 3분기 실적 컨퍼런스콜(2026.9.2) — The Motley Fool 트랜스크립트 https://www.fool.com/earnings/call-transcripts/2026/09/09/broadcom-avgo-q3-2026-earnings-call-transcript/ ; BigGo Finance 정리 https://finance.biggo.com/news/US_AVGO_2026-09-02 ; TIKR https://www.tikr.com/blog/google-anthropic-and-openai-just-locked-in-broadcoms-q3-earnings-through-2028
[2] NVIDIA FY2027 2분기 실적 컨퍼런스콜(2026.8.26) — The Motley Fool 트랜스크립트 https://www.fool.com/earnings/call-transcripts/2026/08/31/nvidia-nvda-q2-2027-earnings-call-transcript/ (GW당 약 400억 달러는 BigGo의 브로드컴 콜 정리에서도 인용)
[3] Ironwood 사양: Tech Insider https://tech-insider.org/google-tpu-8t-8i-broadcom-mediatek-nvidia-2026/ ; Medium(TPU 세대별 정리) https://medium.com/womenintechnology/google-cloud-tpu-architecture-versions-explained-from-v1-to-the-eighth-generation-3f2371962154
[4] Google, “TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings”, ISCA 2023 https://dl.acm.org/doi/10.1145/3579371.3589350 (arXiv https://arxiv.org/abs/2304.01433) ; Google, “Google's Training Supercomputers from TPU v2 to Ironwood”, arXiv 2606.15870, 2026 https://arxiv.org/pdf/2606.15870 ; Google Cloud 블로그 https://cloud.google.com/blog/topics/systems/tpu-v4-enables-performance-energy-and-co2e-efficiency-gains
[5] Google Cloud 블로그, “TPU 8t and TPU 8i technical deep dive”, 2026.4.22 https://cloud.google.com/blog/products/compute/tpu-8t-and-tpu-8i-technical-deep-dive ; DCD https://www.datacenterdynamics.com/en/news/google-unveils-eighth-generation-tpus-two-dedicated-training-and-inference-chips/ ; Technology.org(Boardfly 구조) https://www.technology.org/2026/04/23/google-8th-gen-tpu-split/
[6] SemiAnalysis, “TPU Inference Externalization Full Steam Ahead”, 2026.9.7 https://newsletter.semianalysis.com/p/tpu-inferencex-full-steam
[7] SemiAnalysis, “TPUv7: Google Takes a Swing at the King”, 2025.11 — The Decoder 요약 https://the-decoder.com/the-mere-existence-of-google-tpus-reportedly-saved-openai-30-on-nvidia-chips/
[8] The Information 보도(2026.2) — The Decoder 인용 https://the-decoder.com/meta-signs-multi-billion-dollar-deal-to-rent-googles-tpus-in-a-direct-challenge-to-nvidias-ai-chip-dominance/
[9] Data Center Knowledge, 2026.5.20 https://www.datacenterknowledge.com/infrastructure/blackstone-google-launch-5b-tpu-infrastructure-venture ; Tech Insider(Crux AI) https://tech-insider.org/crux-ai-google-blackstone-alan-duong-2026/
[10] OpenAI Hot Chips 2026 Jalapeño 발표 — Tom's Hardware https://www.tomshardware.com/tech-industry/artificial-intelligence/hot-chips-2026-openais-jalapeno-ai-asic-unpacked-accelerator-developed-using-ai-achieves-efficiency-and-throughput-gains-against-power-hungry-blackwell ; ServeTheHome https://www.servethehome.com/openai-jalapeno-asic-at-hot-chips-2026/ ; DCD https://www.datacenterdynamics.com/en/news/openai-details-jalape%C3%B1o-ai-chip-with-700w-tdp/ ; The Register https://www.theregister.com/systems/2026/08/25/openais-upcoming-jalapeno-chip-looks-like-itll-be-an-inference-beast/5292052 ; SemiWiki https://semiwiki.com/forum/threads/openai-jalapeno-details-at-hot-chips-2026.25770/
[11] TrendForce, 2026.8.26 https://www.trendforce.com/news/2026/08/26/news-openai-debuts-jalapeno-ai-inference-chip-with-samsung-reportedly-supplying-hbm4/ ; TechTimes(InferenceX·SemiAnalysis 검증) https://www.techtimes.com/articles/325710/20260827/openai-jalapeno-chip-posts-19x-efficiency-lead-over-nvidia-huang-answers-96b-quarter.htm
[12] SemiAnalysis, “Vera Rubin NVL72 Agentic Inference”, 2026.9.14 https://newsletter.semianalysis.com/p/vera-rubin-nvl72-agentic-inference
[13] Anthropic, “Anthropic and Amazon expand collaboration for up to 5 gigawatts of new compute”, 2026.4.20 https://www.anthropic.com/news/anthropic-amazon-compute ; OpenAI의 Trainium 2GW는 NeuronFeed(2026.3.23) https://neuronfeed.com/?p=957
[14] AWS Trn3 제품 페이지 https://aws.amazon.com/ec2/instance-types/trn3/ ; HPCwire, 2025.12.2 https://www.hpcwire.com/2025/12/02/aws-brings-the-trainium3-chip-to-market-with-new-ec2-ultraservers/ ; Trainium4 목표치는 Introl https://introl.com/blog/aws-trainium-inferentia-silicon-ecosystem-guide-2025
[15] DCD, “AWS to deploy 2 million additional Nvidia GPUs”, 2026.8 https://www.datacenterdynamics.com/en/news/aws-to-deploy-2-million-additional-nvidia-gpus/ ; TechCrunch https://techcrunch.com/?p=3157431 ; Dealroom(아마존 자체 칩 매출·약정) https://app.dealroom.co/news/note/amazon-expands-nvidia-partnership-with-2-million-additional-gpus
[16] Tom's Hardware, Maia 200 발표, 2026.1.26 https://www.tomshardware.com/pc-components/cpus/microsoft-introduces-newest-in-house-ai-chip-maia-200-is-faster-than-other-bespoke-nvidia-competitors-built-on-tsmc-3nm-with-216gb-of-hbm3e ; TrendForce(The Information 인용), 2026.8.11 https://www.trendforce.com/news/2026/08/11/news-microsoft-eyes-maia-300-launch-in-sep-reportedly-seeks-300k-tsmc-capacity-as-google-aws-race-ahead/ ; Spheron(내부 전용) https://www.spheron.network/blog/hyperscaler-custom-ai-chips-2026-trainium-tpu-maia-mtia-vs-nvidia-gpu/
[17] Spheron(MTIA 300 양산·로드맵) https://www.spheron.network/blog/hyperscaler-custom-ai-chips-2026-trainium-tpu-maia-mtia-vs-nvidia-gpu/ ; Nerd Level Tech(2026.3 네 세대 발표) https://nerdleveltech.com/the-custom-ai-chip-race-2026-meta-google-amazon-microsoft-vs-nvidia
[18] Meta, “Meta's Second Generation AI Chip: Model-Chip Co-Design and Productionization Experiences”, ISCA 2025 https://dl.acm.org/doi/full/10.1145/3695053.3731409
[19] Cerebras Hot Chips 2026 — Cerebras 블로그 https://www.cerebras.ai/blog/ultrafast-frontier-inference-cerebras-deep-dive-at-hot-chips-2026 ; ServeTheHome https://www.servethehome.com/cerebras-talks-going-rack-scale-with-their-wses-at-hot-chips-2026/ ; Tom's Hardware https://www.tomshardware.com/tech-industry/artificial-intelligence/hot-chips-2026-cerebras-lays-out-the-future-of-wafer-scale-ai-nexus-system-architecture-triples-rack-scale-performance-cs-6-wafer-to-incorporate-stacked-dram ; RCR Tech https://rcrtech.com/semiconductor-news/cerebras-cs-4-nexus-rack-cs-6/
[20] Cerebras 2026년 2분기 실적 발표, 2026.8.12 https://investors.cerebras.ai/news-releases/news-release-details/cerebras-systems-fast-inference-cloud-business-nearly-quadruples ; The Motley Fool, 2026.9.5 https://www.fool.com/investing/2026/09/05/cerebras-has-a-usd25-4-billion-backlog-and-one-openai-agreement-is-behind-much-of-it/ ; Yahoo Finance(하드웨어 매출) https://finance.yahoo.com/technology/ai/articles/cerebras-launches-record-setting-ai-193002886.html
[21] Bloomberg, 2026.8.17 https://www.bloomberg.com/news/articles/2026-08-17/groq-valued-at-3-5-billion-in-funding-round-after-nvidia-deal ; TechCrunch https://techcrunch.com/2026/08/17/groq-raises-350m-to-fuel-its-pivot-from-ai-chips-to-neocloud/ ; Dealroom(직원 이동) https://dealroom.co/news/145371-groq-raises-350m-at-3-5b-valuation-to-rebuild-after-nvidias-20b-licensin/ ; Channel Insider(데이터센터 규모) https://www.channelinsider.com/infrastructure/news-groq-350m-nvidia-ai-neocloud/
[22] Tom's Hardware, “Hot Chips 2026: Nvidia presents Groq 3 LPX architecture and unveils its first third-party inference benchmark” https://www.tomshardware.com/tech-industry/semiconductors/nvidia-presents-groq-3-lpx-architecture-and-unveils-its-first-third-party-inference-benchmark
[23] Tenstorrent 발표, 2026.4.28 https://tenstorrent.com/en/newsroom/tenstorrent-enables-ai-at-scale-with-industry-leading-performance ; The Register https://www.theregister.com/software/2026/04/28/tenstorrents-galaxy-blackhole-ai-servers-are-finally-out/5229759 ; IndexBox(EE Times 측정 인용) https://www.indexbox.io/blog/tenstorrent-launches-galaxy-blackhole-server-and-cluster/ ; Datacentre Digest(켈러 발언) https://datacentredigest.com/tenstorrents-galaxy-blackhole-ai-server-supports-prefill-and-decode/ ; Spheron(소프트웨어 성숙도) https://www.spheron.network/blog/tenstorrent-vs-nvidia-open-source-ai-hardware/
[24] SambaNova 제품 페이지 https://sambanova.ai/products/sambarack ; SambaNova Hot Chips 2026 블로그 https://sambanova.ai/blog/hot-chips-2026-dataflow-at-scale ; HPCwire, 2026.2.25 https://www.hpcwire.com/aiwire/2026/02/25/sambanova-eyes-10-trillion-parameter-models-for-agentic-ai-with-new-chip/ ; BigGo(자금·인텔 협상가·JP모건) https://finance.biggo.com/news/1ba754e0-6e9c-4e54-95ea-a5b9f0eac0fc
[25] DCD https://www.datacenterdynamics.com/en/news/qualcomm-launches-ai200-and-ai250-chip-offering-targeting-inferencing-workloads-at-rack-scale/ ; ServeTheHome https://www.servethehome.com/qualcomm-announces-new-integrated-ai-racks-with-768gb-cards-and-a-200mw-ai-deal/
[26] Hot Chips 2026 세션 구성 — SemiHub 참관 가이드 https://semihub.io/en/blog/hot-chips-2026-guide.html
[27] TrendForce, “The Inference Economy Arrives: AI Chip Rules Are Being Rewritten”, 2026.6 https://www.trendforce.com/insights/ai-inference-chip-architecture
[28] Etched 보도자료, 2026.7.23 https://finance.yahoo.com/technology/ai/articles/etched-raises-300m-10-3b-150000873.html ; TechCrunch https://techcrunch.com/2026/07/23/ai-chip-startup-etched-defies-skeptics-hits-10-3b-valuation-from-big-name-investors/ ; DCD(프리필·디코드 두 부품) https://www.datacenterdynamics.com/en/news/ai-chip-startup-etched-closes-300m-funding-round-doubles-its-valuation-to-103bn/ ; MLQ(독립 벤치마크 미공개) https://mlq.ai/news/etched-raises-300m-series-c-at-103b-valuation-to-scale-gpu-free-inference-chips/ ; Startup Fortune(TSMC N4P 첫 실리콘) https://startupfortune.com/etched-raises-300m-at-103b-valuation-as-sequoia-backs-the-harvard-dropouts-it-once-rejected/
[29] AMD, “AMD Acquires Taalas to Advance Compute Solutions for Rapidly Growing AI Inference Market”, 2026.8.6 https://ir.amd.com/news-events/press-releases/detail/1296/amd-acquires-taalas-to-advance-compute-solutions-for-rapidly-growing-ai-inference-market ; CNBC https://www.cnbc.com/2026/08/06/amd-buys-taalas-startup-that-hardwires-ai-models-into-its-silicon.html ; Futurum https://futurumgroup.com/insights/amd-acquires-taalas-to-advance-ai-workload-optimization/
[30] Tech Funding News, 2026.7.29 https://techfundingnews.com/etched-10-3b-series-c-sequoia-record/
[31] 화웨이 기조연설(Huawei Connect 2025) https://www.huawei.com/en/news/2025/9/hc-xu-keynote-speech ; Tom's Hardware https://www.tomshardware.com/tech-industry/artificial-intelligence/huawei-unveils-atlas-950-supercluster-touting-1-fp4-zettaflops-performance-for-ai-inference-and-524-fp8-exaflops-for-ai-training-features-hundreds-of-thousands-of-950dt-apus ; Flopper.io(현재 제품표) https://flopper.io/system/huawei-atlas-950-superpod ; abit.ee(950PR 출시 시점) https://abit.ee/en/processors/huawei-ascend-950dt-ai-chip-ai-accelerator-huawei-cloud-machine-learning-ascend-950-en
[32] Tom's Hardware(ISSCC 2026) https://www.tomshardware.com/tech-industry/semiconductors/isscc-2026-rebellions-ucie-rebel-100 ; 디지털데일리 https://m.ddaily.co.kr/page/view/2025082710490130808 ; 더에이아이(성능 주장) https://www.newstheai.com/news/articleView.html?idxno=20189 ; 리벨리온 뉴스룸(양산·공급 계획, 2026.5) https://kr.rebellions.ai/newsroom/%EB%A6%AC%EB%B2%A8%EB%A6%AC%EC%98%A8-%EB%B0%98%EB%8F%84%EC%B2%B4-%EC%98%AC%EB%A6%BC%ED%94%BD-isscc-2026%EC%84%9C-%EC%B9%A9%EB%A0%9B-%EA%B8%B0%EB%B0%98-%EB%A6%AC%EB%B2%A8%EC%BF%BC%EB%93%9C/
[33] FuriosaAI, “TCP: A Tensor Contraction Processor for AI Workloads”, ISCA 2024 https://dl.acm.org/doi/10.1109/ISCA59077.2024.00069
[34] CIO(RNGD 사양) https://www.cio.com/article/4030108/ai-%eb%b0%98%eb%8f%84%ec%b2%b4-%ec%8a%a4%ed%83%80%ed%8a%b8%ec%97%85-%ed%93%a8%eb%a6%ac%ec%98%a4%ec%82%acai-%ea%b8%b0%ec%97%85-%ea%b3%a0%ea%b0%9d-%ea%b2%a8%eb%83%a5%ed%95%b4-lg%ec%99%80-%ed%98%91.html ; 파이낸셜뉴스(엑사원 실증) https://www.fnnews.com/news/202507221408130370 ; 유니콘팩토리(1차 양산·TSMC 인도 지연) https://www.unicornfactory.co.kr/article/2026012811212239774 ; 뉴시스(연간 목표) https://mobile.newsis.com/view/NISX20260402_0003575939 ; 뉴시스(스웨덴 데이터센터) https://mobile.newsis.com/view/NISX20260805_0003736804
[35] DeepSeek-AI, “Insights into DeepSeek-V3: Scaling Challenges and Reflections on Hardware for AI Architectures”, ISCA 2025 https://dl.acm.org/doi/10.1145/3695053.3731412 (arXiv https://arxiv.org/abs/2505.09343)
[36] DCD, “Nebius, Lambda, and CoreWeave unlikely to buy Google TPUs any time soon”, 2026.5.5 https://www.datacenterdynamics.com/en/news/nebius-lambda-and-coreweave-unlikely-to-buy-google-tpus-any-time-soon/
[37] SemiAnalysis, “AgentX - InferenceXv3: Does CUDA Moat Hold up in Agentic Inferencing?”, 2026.8.24 https://newsletter.semianalysis.com/p/agentx-inferencexv3-does-cuda-moat
이 글은 공개 자료를 바탕으로 한 개인적인 공부 기록이며 투자 권유가 아닙니다. 투자 판단과 책임은 본인에게 있습니다.
반응형'최신 기술동향 > 2차전지 & 반도체' 카테고리의 다른 글
[AI 데이터센터 반도체 4부] 가속기를 묶는 칩 (DPU, 스위치) (0) 2026.09.26 [AI 데이터센터 반도체 3부] AI 칩은 왜 만들기 어려운가 (0) 2026.09.25 [AI 데이터센터 반도체 1부] 칩이 아니라 랙을 판다 (GPU) (0) 2026.09.21 AI 전력 병목의 단기 해법, ESS와 LFP - 비중국 밸류체인은 가능한가 (1) 2026.08.08 2차전지의 무게중심 이동 - EV 캐즘, AI 전력난, 그리고 ESS의 시간 (1) 2026.08.01