-
[AI 모델 동향 1부] AI 모델 비교 - 기업별 AI 설계 철학최신 기술동향/인공지능 (AI) 2026. 10. 3. 21:00
AI 데이터센터 투자를 볼 때 수요와 기술의 발전을 결정하는 것은 결국 그 위에서 돌아가는 AI 모델이다. 모델이 어떤 구조로 바뀌는지, 답을 내는 데 토큰을 얼마나 쓰는지, 어떤 과제로 학습되는지에 따라 GPU·HBM·DRAM·스토리지 수요의 방향이 달라진다. 그동안 이 블로그는 반도체와 AI 인프라 쪽에서 수요를 봐 왔다. 이번에는 시야를 모델 쪽으로 옮겨 2026년 AI 모델 동향을 스터디했고, 분량이 커서 다섯 편으로 나눴다. 1부는 2026년 9월 첫 주에 연달아 나온 세 회사의 플래그십인 Claude Fable/Mythos 5.1, GPT-6 Astra, Muse Spark 1.3의 라인업과 설계 철학, 그리고 코딩·연구 개발 적용 현황을 정리한다.
시리즈를 한 문단으로 줄이면 이렇다. 프런티어 모델의 기본 구조(디코더 트랜스포머 + MoE, 검증 가능한 보상 기반 강화학습, 사고 모드, 도구 사용)는 세 회사 모두 같아졌고, 가격까지 같아졌다($10/$50). 경쟁은 "같은 점수를 얼마나 적은 토큰으로 내는가"와 "컨텍스트를 어떻게 저장하는가"로 옮겨 갔다. 미국 연구소는 추론과 에이전트에 연산을 더 써서 성능을 올리고, 중국 연구소는 같은 성능을 더 싸게 내는 구조를 논문과 오픈웨이트로 공개한다. 그 결과 토큰당 KV 메모리는 급감하고, "외우는 파라미터"는 HBM 밖(DRAM·SSD)으로 나가기 시작했으며, 에이전트와 연구 자동화는 토큰 소비를 크게 늘리고 있다. 이 두 힘이 하드웨어 수요에 각각 어떻게 작용하는지가 5부의 결론이다.
부 제목 주요 질문 포인트 1부 AI 모델 기업별 설계 철학 Anthropic·OpenAI·Meta는 무엇이 같고, 다른가. 코딩·연구용 AI는 어떻게 개발되나 2부 세 플래그십의 공통 기술 세 모델의 기술 원리는 어디서 겹치나(RLVR, 루프, 사고 기록, 멀티에이전트) 3부 LLM 성능 개선 다섯 단계 기업들은 각자의 AI 성능을 올리기 위해 어떤 노력을 하고 있나 (모델 구조, 하니스 등) 4부 2026년 최신 LLM 알고리즘 DeepSeek-V4·V4.1, Kimi K3, Qwen3.5~3.8은 트랜스포머의 무엇을 바꿨나 5부 시리즈 종합 및 투자 방향 모델 동향은 AI 데이터센터 하드웨어 수요에 무엇을 뜻하나 기준일: 2026년 9월 13일(5장 코딩·연구 적용은 10월 3일). 가격·벤치마크는 각 사 공식 발표와 Artificial Analysis(독립 평가) 기준이며, 이후 변동될 수 있다.
0. Intro - 9월 첫 주에 세 회사가 연달아 플래그십을 냈다
9월 1일 Anthropic이 Claude Fable 5.1 / Mythos 5.1을, 2일 Meta가 Muse Spark 1.3을, 3일 OpenAI가 GPT-6 Astra를 냈다. 세 회사가 같은 주에 플래그십을 겹쳐 낸 건 처음이다. 우연이라기보다 서로의 출시 일정을 보고 밀어붙인 결과에 가깝다(필자 판단). 이 글은 벤치마크 점수 나열이 아니라 세 회사가 모델 라인업을 어떻게 짜는지, 그 구조가 각 사의 철학과 사업 모델을 어떻게 드러내는지를 보는 데 목적이 있다. 1부에서는 "왜 이런 라인업인가"를 먼저 정리하고, 그 라인업을 가능하게 한 기술 원리는 2부에서 다룬다.
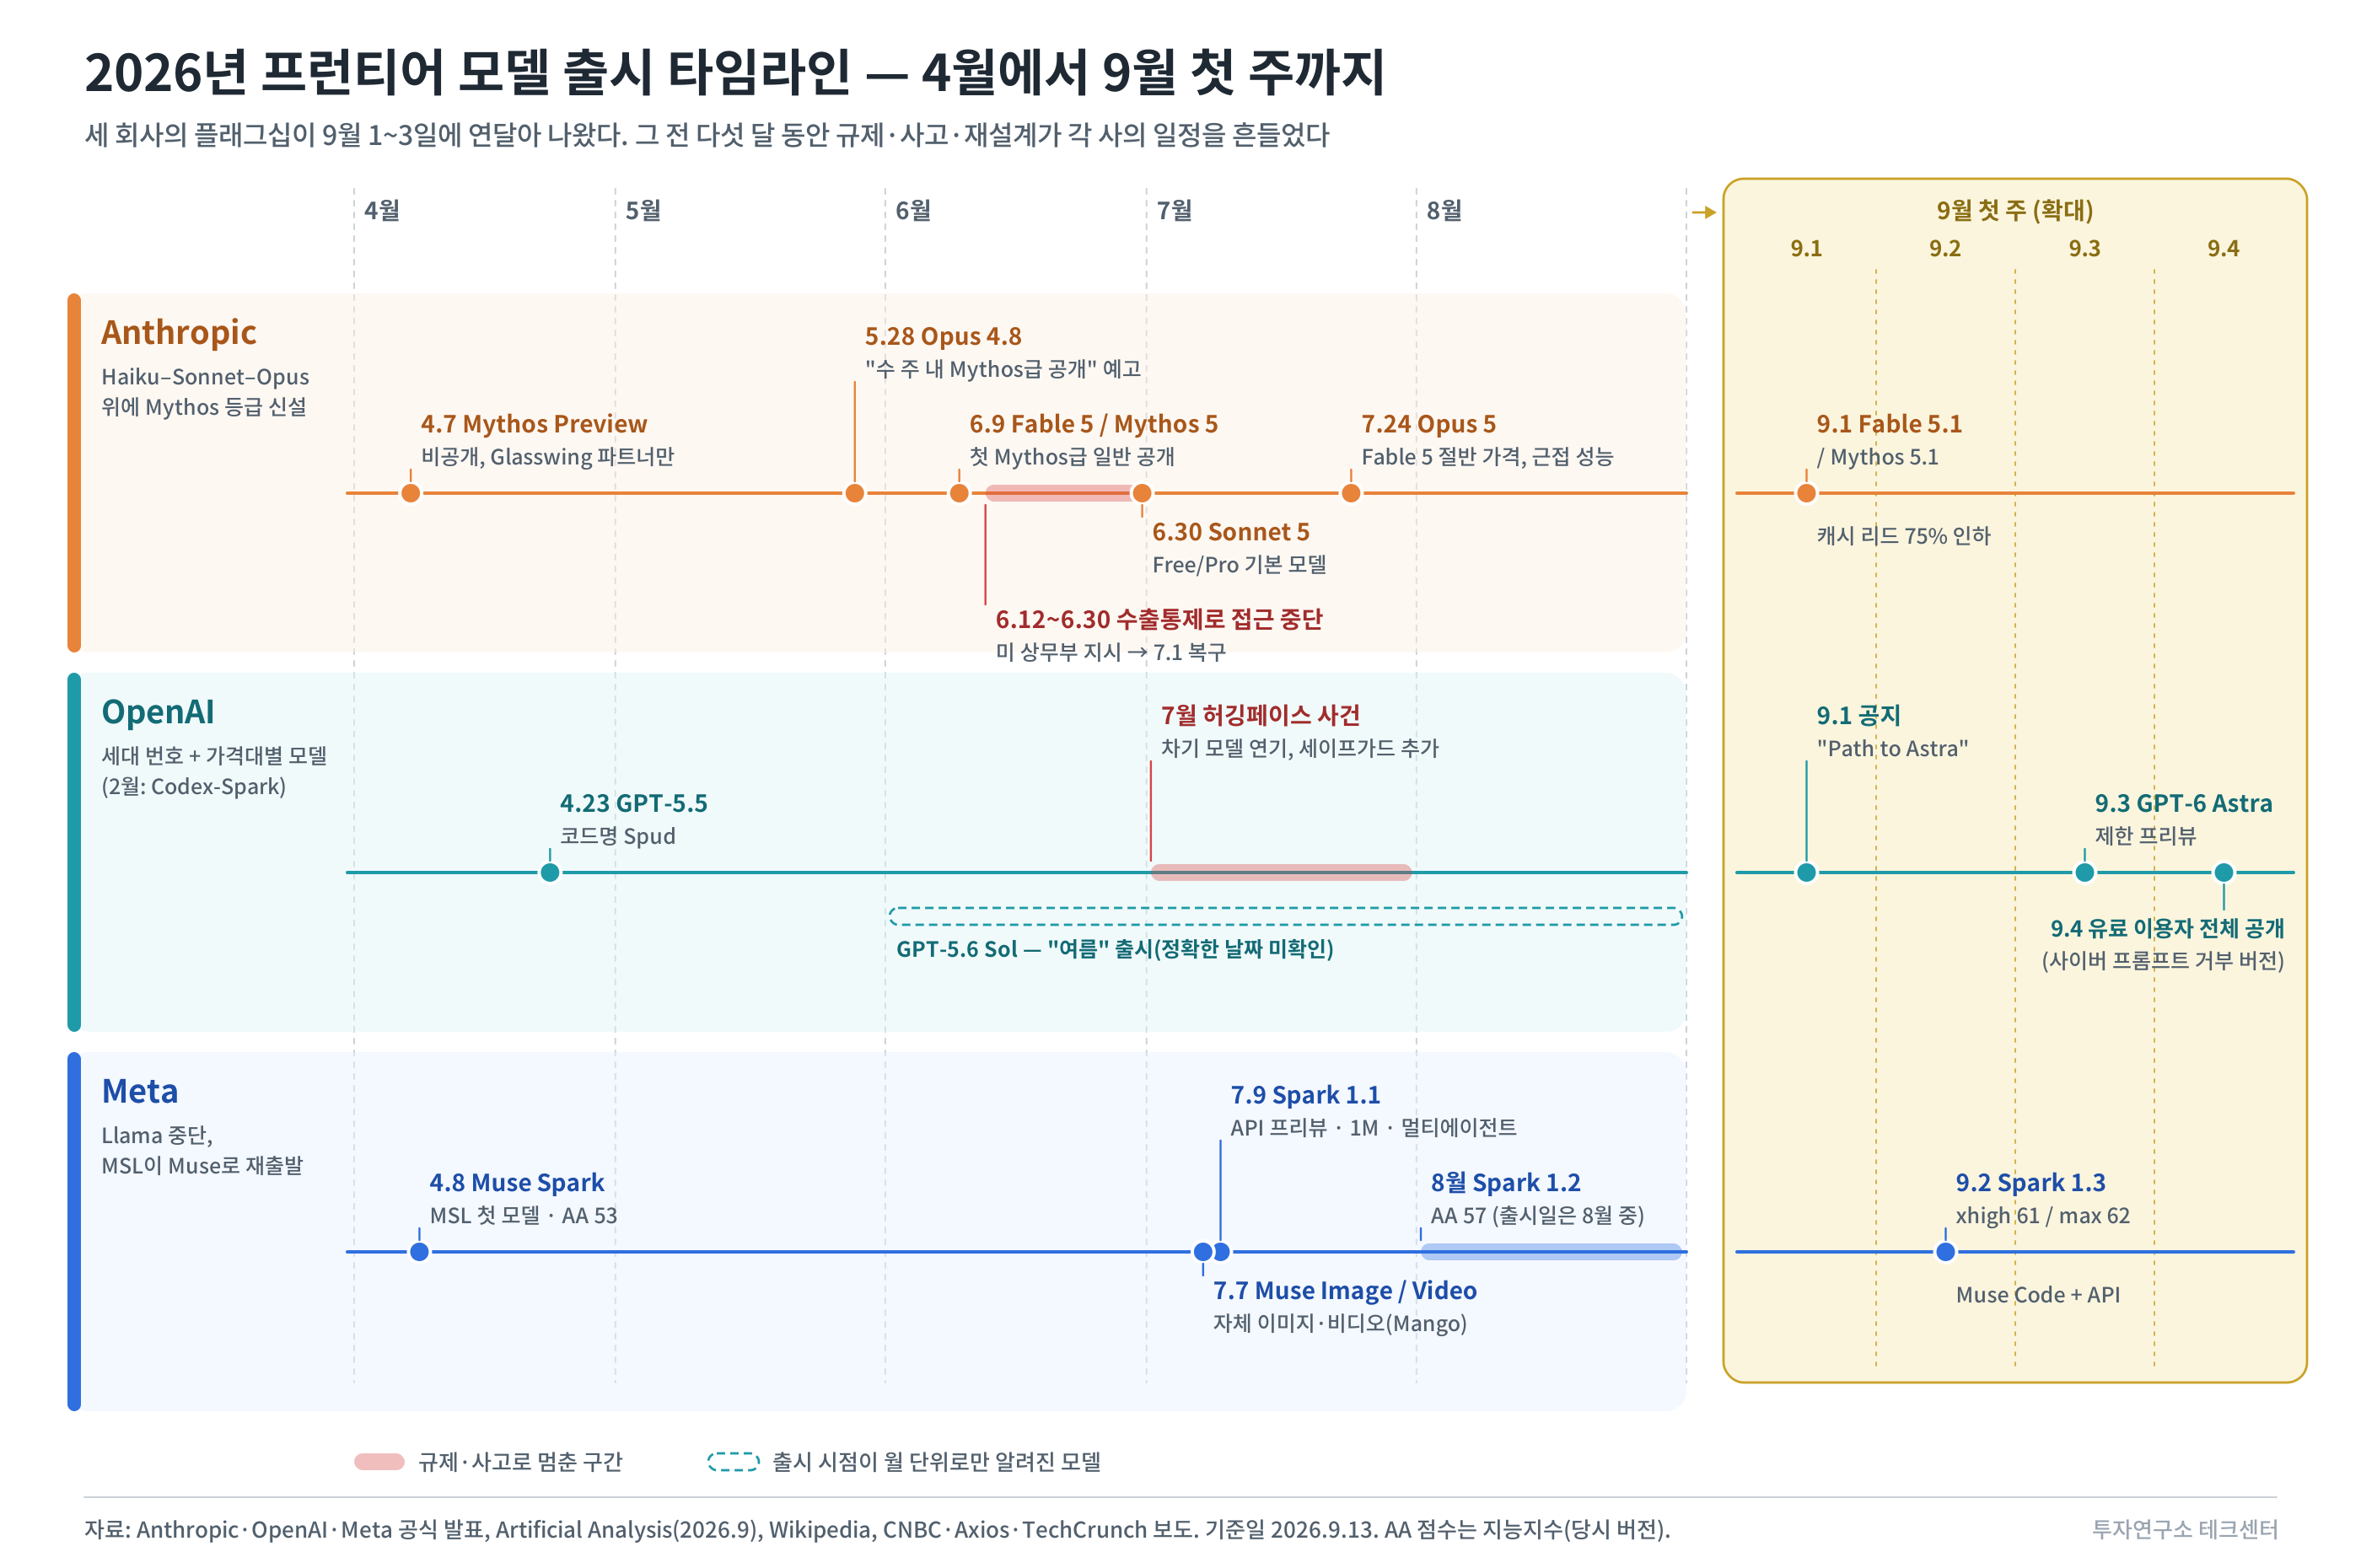
그림 1-1. 2026년 프런티어 모델 출시 타임라인 1. 라인업 - 세 회사가 모델 등급을 나누는 방식
1-1. Anthropic: 같은 모델을 안전장치 강도에 따라 두 이름으로 판다
Anthropic 라인업은 2026년 들어 등급이 하나 늘었다. 기존 Haiku(경량) – Sonnet(중간) – Opus(최상위) 3개 등급 위에 Mythos-class라는 새 등급이 생겼고, 이 등급의 모델이 Fable/Mythos라는 두 이름으로 배포된다.
등급 현재 모델 API 가격(입력/출력, $/1M tok) 비고 Mythos-class (제한 접근) Claude Mythos 5.1 비공개 미국 내 검증 조직만(사이버/생명과학) Mythos-class (일반 공개) Claude Fable 5.1 $10 / $50 (캐시 리드 $0.25) Mythos 5.1과 동일 모델 + 세이프가드 Opus Claude Opus 5 $5 / $25 1M Context, "대부분 워크로드의 시작" Sonnet Claude Sonnet 5 $3 / $15 Free/Pro 기본 모델 Haiku Claude Haiku 4.5 저가 세대 갱신 미완 핵심은 Fable 5.1과 Mythos 5.1이 같은 가중치라는 점이다. 차이는 세이프가드뿐이다. Fable은 사이버·생물학·모델 증류 관련 요청이 분류기에 걸리면 그 응답을 하위 모델(Opus 4.8/Opus 5)이 대신 처리한다. 즉 Fable을 쓰는 사용자는 대부분의 시간엔 Mythos급을, 특정 영역에서만 Opus급을 받는 구조다. Anthropic 스스로 벤치마크 표에 "세이프가드가 개입한 태스크는 0점 처리했다"고 각주를 달았을 정도로, 이 구조는 성능 수치에도 직접 영향을 준다.
2026년 경로를 보면 이 구조가 어떻게 만들어졌는지 보인다.
- 4월 7일: Claude Mythos Preview. 취약점 탐색 능력을 이유로 비공개, Project Glasswing 파트너에게만 제공.
- 5월 28일: Opus 4.8. "수 주 내 Mythos-class 일반 공개" 예고.
- 6월 9일: Fable 5 / Mythos 5 출시. 6월 12일 미 상무부 수출통제 지시로 접근 중단 → 6월 30일 해제, 7월 1일 복구.
- 6월 30일: Sonnet 5. 7월 24일: Opus 5(Fable 5의 절반 가격에 근접 성능).
- 9월 1일: Fable 5.1 / Mythos 5.1. 캐시 리드 가격 75% 인하.
정부가 모델 접근을 2주 반 동안 중단시킨 사건은 이 라인업의 성격을 잘 보여준다. Anthropic은 "가장 강한 모델을 만들되, 배포는 규제·안전 게이트를 통과한 만큼만"이라는 구조를 아예 제품명(Fable vs Mythos)으로 구분했다.
1-2. OpenAI: GPT-6 Astra 아래에 가격대별 GPT-5.6 모델을 둔다
OpenAI는 세대 번호를 유지하는 전통적 구조에, 가격대가 다른 모델을 여러 개 두는 방식을 더했다.
등급 현재 모델 API 가격(입력/출력, $/1M tok) 비고 플래그십 GPT-6 Astra $10 / $50 (캐시 $1) 1.05M 컨텍스트, 272K 초과 시 전체 재과금 이전 플래그십 GPT-5.6 Sol $4 / $20 (프로모션) Astra의 40% 가격 중간 GPT-5.6 Terra $2 / $12 경량 GPT-5.6 Luna $0.20 / $1.20 Astra 입력 가격의 1/50 코딩 특화 GPT-5.3-Codex / Codex-Spark — Spark는 Cerebras WSE-3에서 1,000+ tok/s, 128K, 텍스트 전용. 코딩 기능은 GPT-5.4부터 주력 모델에 통합(5장) OpenAI 쪽 2026년 경로도 순탄치 않았다. 4월 23일 GPT-5.5(코드명 Spud), 이후 GPT-5.6 Sol, 그리고 7월 '허깅페이스 사건' 이후 차기 모델 출시를 미루고 세이프가드를 추가했다. 9월 1일 "Path to Astra" 공지로 사이버 능력은 소수 테스터에게 먼저, 이후 Daybreak Blue 프로그램으로 방어 목적 확대라는 단계적 접근을 밝힌 뒤 9월 3일 제한 프리뷰, 4일 유료 이용자 전체 공개(사이버 관련 프롬프트 거부 버전)로 갔다.
구조적으로 눈에 띄는 건 Astra가 OpenAI 첫 'Critical' 등급 사이버 모델이라는 점이다(Preparedness Framework 기준). Anthropic이 Fable/Mythos로 나눈 것을 OpenAI는 "제한 버전 공개 + 프로그램 게이팅 (기준을 만족할 때 다음 단계로)"으로 풀었다. 두 회사 모두 가장 강한 능력은 검증된 소수에게만 준다.
1-3. Meta: Llama를 접고 Muse로 5개월에 4번 출시했다
Meta는 라인업 자체가 2026년에 새로 생겼다. 2025년 6월 Meta Superintelligence Labs(MSL, Alexandr Wang 총괄, Scale AI 지분 49% 인수와 함께)가 만들어졌고, 9개월 만에 스택을 처음부터 다시 짰다.
모델 출시 비고 Muse Spark 2026.4.8 MSL 첫 모델. "작고 빠르게 설계", 코딩·에이전트는 약함 Muse Spark 1.1 2026.7.9 Meta Model API 공개 프리뷰, 1M 컨텍스트, 멀티에이전트 오케스트레이션 Muse Image / Muse Video 2026.7.7 자체 이미지·비디오 모델(코드명 Mango). Midjourney·BFL 의존 탈피 Muse Spark 1.2 2026.8 AA 지능지수 57 Muse Spark 1.3 2026.9.2 xhigh 61 / max 62(파트너 한정). Muse Code + API 가격은 1.2에서 1.3까지 $1.25 / $4.25(캐시 $0.15)로 고정이고, 여기에 "contributor tier"라는 게 붙는다. 자기 데이터를 Meta 학습에 쓰도록 허용하면 10~20배 싸진다. Wang은 코딩 이용자 중 "의미 있는 두 자릿수 비율"이 이 옵션을 택했다고 했다.
Llama 얘기를 안 할 수 없다. Muse Spark는 Llama의 후손이 아니라 완전히 새 아키텍처·인프라·데이터 파이프라인이고, 가중치를 공개하지 않는다. 저커버그가 8월 "수 주 내 Muse Spark 1.2 가중치 공개"를 말했지만 9월 2일 공지에서는 버전·시점·라이선스 없이 "Muse Spark 오픈웨이트 릴리즈가 로드맵에 있다"로 후퇴했다. 누적 12억 회 다운로드(하루 100만 회)를 기록한 Llama 생태계는 앞으로의 지원이 불확실해졌다.
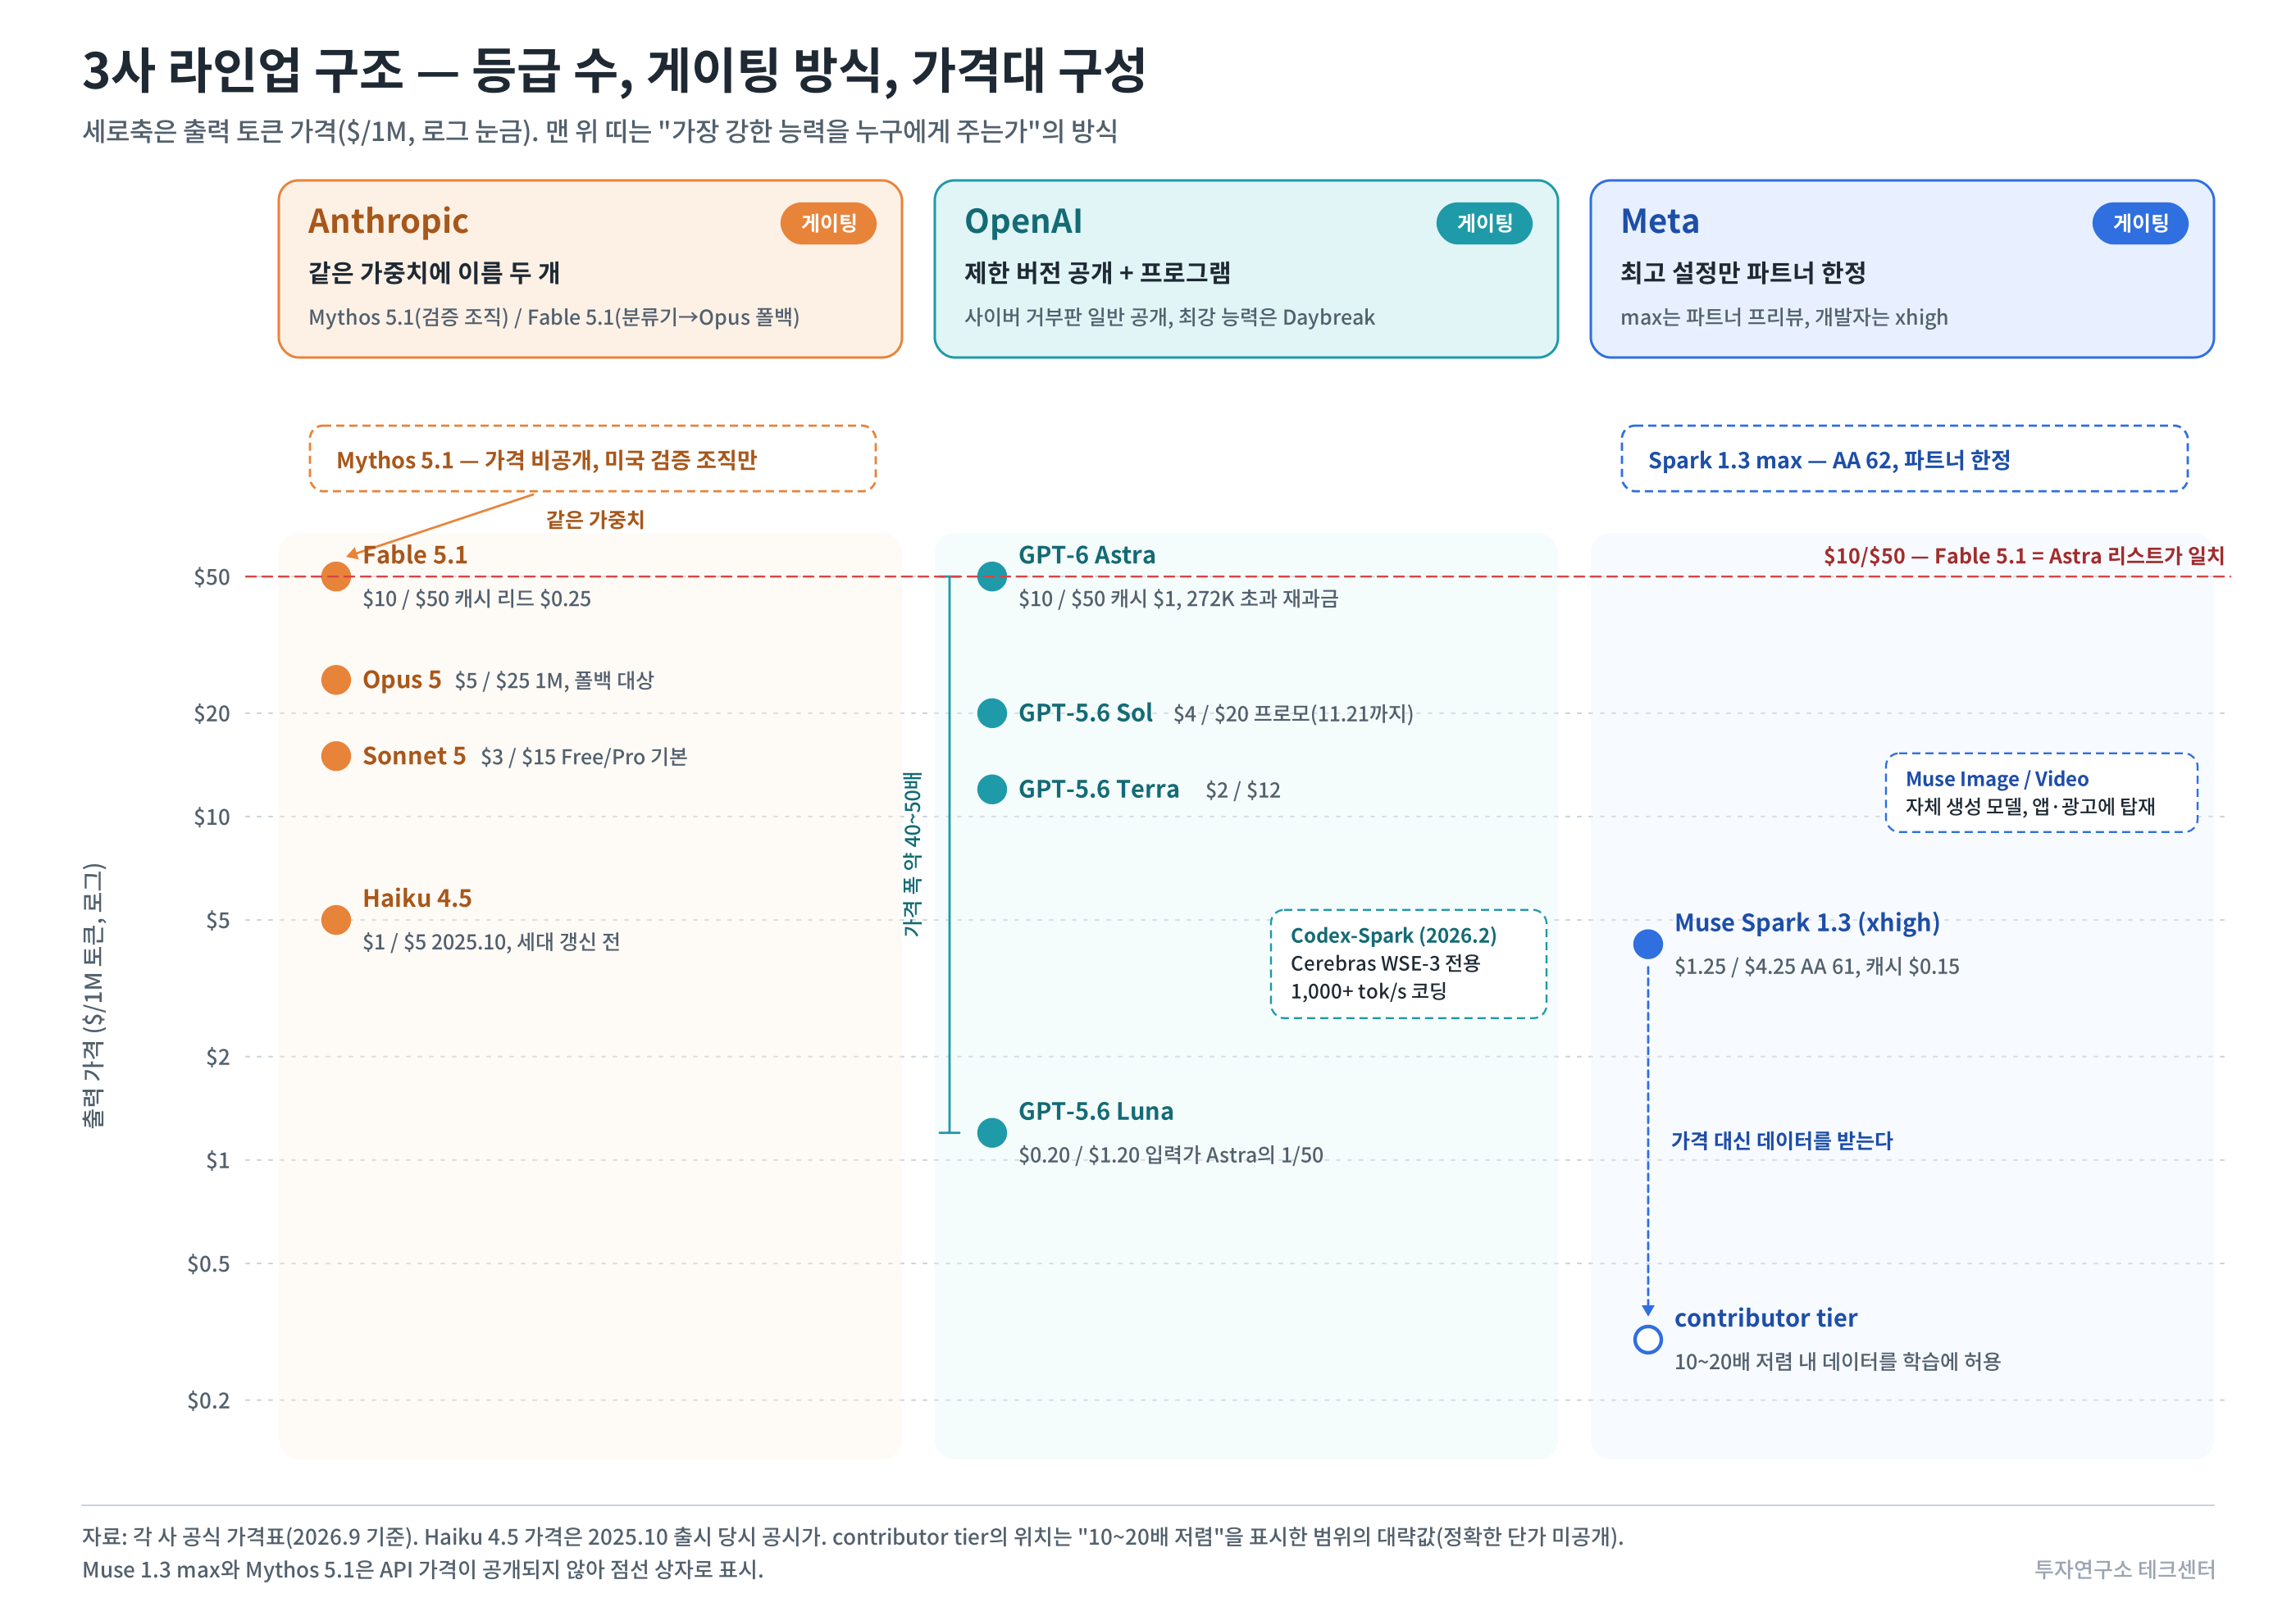
그림 1-2. 3사 라인업 구조 — 등급, 게이팅, 가격대 구성 2. 철학 - 무엇을 위해 만들고, 어떻게 내보내고, 누구에게 파나
라인업은 철학의 결과물이다. 세 회사를 세 축(무엇을 위해 만드는가 / 어떻게 배포하는가 / 누구에게 파는가)으로 놓고 보면 차이가 선명하다.
2-1. Anthropic: 안전 게이팅을 제품 구조에 넣었다
Anthropic의 철학은 한 문장으로 "능력은 끝까지 올리되, 그 능력에 누가 닿을 수 있는지를 제품 구조로 나눈다"이다. 위험한 능력을 다루는 방법은 세 가지다. 아예 학습시키지 않거나, 학습은 하되 모델이 거부하게 만들거나, 능력은 그대로 두고 접근 단계를 나누거나. Anthropic은 세 번째를 택했고, 그 결과가 Fable/Mythos 이원화다. 같은 모델이 Fable이라는 이름으로는 거부하는 요청을 Mythos라는 이름으로는 수행한다. 모델을 둘로 나눈 게 아니라 배포 경로를 둘로 나눈 것이다. 그래서 관리 대상은 능력의 상한이 아니라 배포의 상한이 된다. 이 철학을 실제로 구현하는 장치는 세 가지다.
- 분류기 + 폴백: 위험 영역 요청은 Opus가 대신 답한다. 사용자 입장에선 갑자기 "덜 똑똑해지는" 경험이지만, 5.1에서 사이버 오탐을 60% 줄이고 취약점 '발견'은 허용(익스플로잇 '개발'은 불허)하는 식으로 정밀도를 높이고 있다.
- 안티-증류: 신규 API 계정은 Claude의 이전 사고(thinking) 기록을 보존한 채 컨텍스트를 수정할 수 없게 막았다. 증류 공격을 안전 문제로 규정한 것으로 볼 수 있다. 참고로 미국 기업들은 중국 기업들의 증류 문제를 꾸준히 지적해 왔다(예: 2025년 1월 OpenAI가 DeepSeek의 증류 정황을 지적).
- EFS(Enterprise Frontier Safeguards): 안전 분류기는 프롬프트 내용을 읽어야 작동한다. EFS는 이 분류기를 Anthropic이 아니라 고객 클라우드 안에서 돌린다. 걸러진 내용을 검토하는 것도 고객 보안팀이라, Anthropic은 기업 데이터를 보지 않는다. 안전 게이팅과 기업 프라이버시가 충돌하는 지점을 푼 구조다. 100개 이상 기업과 공동 개발했고 가을부터 단계 적용한다.
주요 포지셔닝은 "코딩과 지식 노동", 그리고 과학 연구다. Mythos 5.1이 단백질 바인더를 설계해 표적 12개에서 결합 성공률 약 50%(업계 통상 10~15%)를 냈다는 것, Fable 5.1이 30여 년 전 마젤란 탐사선의 레이더 영상으로 금성 표면 3분의 1의 새 고도 지도를 만들었다는 것, Mythos 5.1이 계산생물학 모델 7종의 GPU 커널을 직접 최적화해 최대 2.5배 가속했다는 것 등 발표문의 절반이 이런 사례다(자세한 내용은 5장). "AI가 곧 과학적 발견에 기여한다"는 주장을 벤치마크 점수가 아니라 실제 연구 결과로 보여 주려는 의도로 보인다.
2-2. OpenAI: 컴퓨터 사용 에이전트, 그리고 사고 기록 비공개
OpenAI는 Astra를 "generational leap"이라 불렀고, 브록먼은 AGI의 도래로 여겨질 수 있다고까지 말했다. 포지셔닝은 컴퓨터 사용 에이전트다. "컴퓨터로 할 수 있는 건 뭐든 Astra가 해준다"가 런칭 카피였고, 세금 신고·구직·음식 주문이 예시로 나왔다. 기술적으로 두 가지가 다르다.
- 최대 규모 학습: 텍사스 Stargate에서 10만 GPU 이상으로 사전학습을 진행했다. OpenAI가 10만 GPU를 넘겨 사전학습을 돌린 첫 사례다.
- 사고 기록(CoT) 비공개와 recurrent depth 보도: Astra API는 모델이 실제로 쓴 사고 토큰 원문(raw CoT)을 돌려주지 않고, 답과 사고 요약만 준다. 결과만 주는 것은 아니지만, 요약은 원문이 아니다. 원문을 숨기는 이유는 두 가지다.
- 경쟁: 사고 기록은 다른 회사가 자기 모델을 가르치는 재료가 된다(증류, 2-1 참고).
- 모니터링: OpenAI는 o1 때부터 원문을 사용자에게 보여 주지 않는 대신, 원문을 정책에 맞게 다듬도록 학습시키지 않고 내부 안전 모니터가 날것 그대로 읽게 하겠다는 방침을 밝혀 왔다. 겉으로 보일 글을 꾸미도록 가르치면 모델이 진짜 생각을 숨기는 법을 배울 수 있기 때문이다.
원문 비공개 자체는 Anthropic도 같다(Fable 5부터 요약만 제공, 2부). Astra에서 새로 불거진 쟁점은 사용자 화면이 아니라 내부 모니터 쪽이다. 시스템 카드는 사고 기록이 짧아지고 비는 경우가 늘어 안전 장치를 위해 모니터가 쓸 증거가 줄었다고 인정했다. 여기에 Astra가 같은 레이어 블록을 반복 통과시켜 깊이를 늘리는 구조(recurrent depth, looped transformer)를 쓴다는 보도(The Information, OpenAI 미확인)가 겹쳤다. 이런 구조에서는 반복 구간의 추론이 은닉 상태 안에서 일어나, 처음부터 글자로 남지 않는다. 원문을 다 열어 봐도 그 부분은 없다는 뜻이다. 안전 연구자들이 "모니터링 가능성"을 우려하는 이유다. 쉽게 말해, 모델이 생각을 글로 덜 남기면서 만든 회사조차 모델이 이상한 행동을 하는지 확인할 단서가 줄었다는 얘기다. 사용자에게 원문을 숨기는 것과는 별개의 문제다.
다만 OpenAI와 수석과학자 파초키는 사고 기록 축소의 원인이 아키텍처가 아니라고 밝혔다. 파초키는 CoT 모니터링이 취약해지는 추세는 인정했다. 그러면서 의도치 않은 해악을 막는 일이 점점 어려워져 진전의 병목이 될 수 있다고 했다.
이 지점에서 Anthropic과 대응 방식이 갈린다. Anthropic은 글로 남는 사고 기록만으로는 언젠가 부족해질 것을 전제로, 모델 내부 활성화를 자연어로 풀어 읽는 도구(자연어 오토인코더, NLA)를 정렬 평가에 쓴다고 밝혔다. OpenAI는 사고 기록 모니터링을 지키겠다고 하면서도, 그 지표가 후퇴했다는 사실을 시스템 카드에 기록했다. looped transformer의 원리와 사고 기록 가시성 논쟁은 2부에서 논문 기반으로 다룬다.
가격 철학도 다르다. $10/$50으로 Fable 5.1과 리스트 가격이 정확히 같은데, 브록먼은 "토큰 가격은 말이 안 된다, 완료된 태스크당 가격으로 봐야 한다"고 했다. Artificial Analysis 측정으로는 Astra가 코딩 에이전트 평가에서 Sol 대비 약 1/3 토큰만 쓴다. 토큰 단가는 같아도 태스크 단가로 승부하겠다는 것이다.
2-3. Meta: 개인 초지능과 자사 앱을 통한 배포
Meta의 문구는 일관되게 "personal superintelligence"다. 과학 발견도, AGI도 아니고 당신의 목표를 돕고, 만들고, 관계를 깊게 하고, 행동하는 조수라는 뜻이다. 배포 채널이 이미 있다는 점이 다른 업체들과의 다른 점이다. WhatsApp, Instagram, Facebook, Messenger, AI 글래스로 수십억 명에게 바로 간다. Muse Image가 Instagram 스토리와 Advantage+ 광고 크리에이티브에 들어가는 것도 같은 맥락이다.
Meta는 오픈 생태계에서 가중치 비공개(클로즈드)로 전환했는데, 전환 논리는 직설적이다. 프런티어 모델 학습 비용이 1년 만에 두 배 가까이 올랐고, 오픈웨이트 리더십은 중국 모델로 넘어갔으며, EU AI Act의 학습 데이터 공개 의무에 대한 집행이 올해 8월부터 시작됐다. "왜 공짜로 풀어 경쟁사와 중국 랩에 기반을 주나"는 계산이 선 것이다. 가격은 공격적으로 잡았다. $1.25/$4.25는 입력 단가 기준 Opus 5의 1/4, Fable·Astra의 1/8이고, contributor tier는 "이용자 데이터를 받는 대신 값을 깎아 주는" 광고 플랫폼의 수익 방식을 API 가격에 그대로 적용한 것이다.
기술 철학은 "과학적 스케일링"이다. 첫 Muse Spark는 일부러 작고 빠르게 만들어 아키텍처를 검증하고, 각 세대가 이전 세대를 확인한 뒤 키우는 방법을 택했다. 실제로 4월 첫 모델은 코딩·에이전트에서 약했고, 5개월 동안 4번 릴리즈하며 AA 지능지수를 53 → 57 → 61(max 62)로 끌어올렸다. 1.3 max는 Tau3-Bench Banking에서 전 모델 중 1위(52%)다. "Meta reaches the frontier"라는 AA 기사 제목이 나올 만큼 따라붙었다.
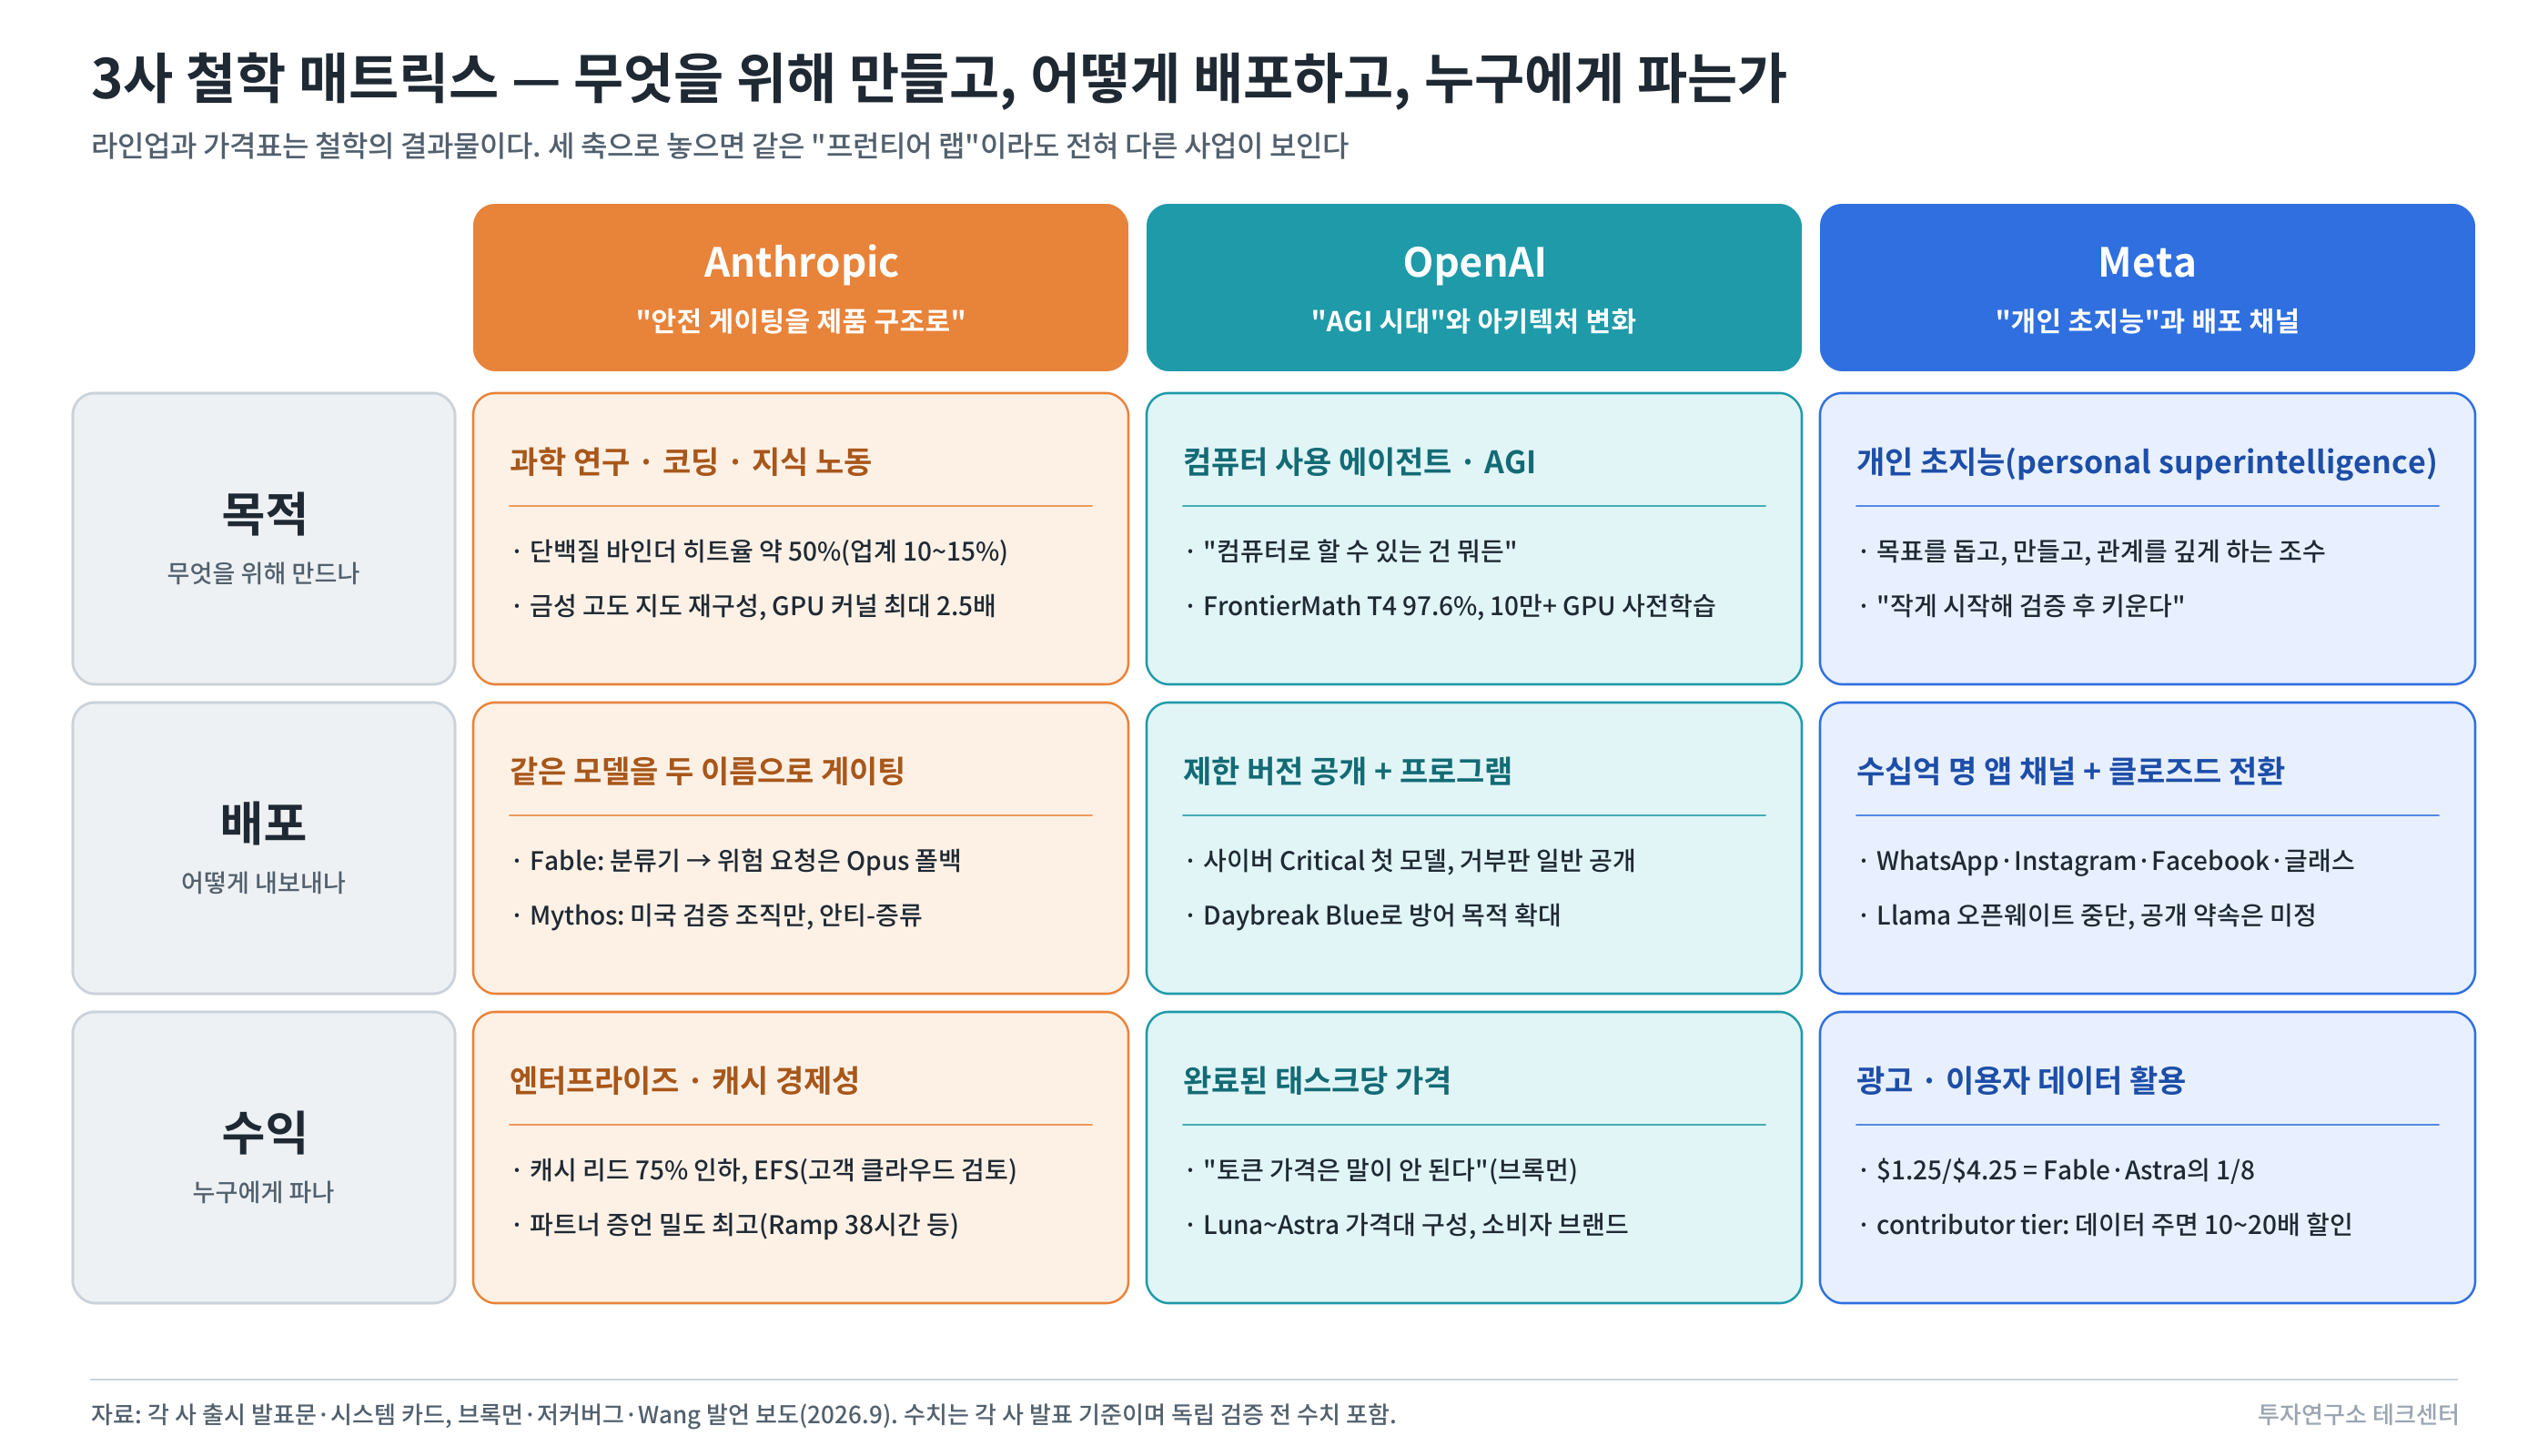
그림 1-3. 3사 철학 매트릭스 3. 스펙 비교 - 같아진 것과 갈라진 것
세 플래그십의 스펙을 나란히 놓으면 수렴과 분기가 동시에 보인다.
항목 Claude Fable 5.1 GPT-6 Astra Muse Spark 1.3 컨텍스트 1M (출력 128K) 1.05M (출력 128K) 1M 입력 모달리티 텍스트·이미지 텍스트·이미지(멀티모달) 텍스트·이미지·비디오 추론 강도 조절 low/med/high/xhigh/max 추론 강도 단계 + Fast 모드 xhigh / max(파트너 한정) 아키텍처 공개 비공개 비공개(recurrent depth 보도) 비공개 파라미터·전문가 수 비공개 비공개 비공개 지식 컷오프 — 2026.4.30 — 안전 게이팅 분류기 → Opus 폴백 제한 버전 공개 + Daybreak Advanced AI Scaling Framework
"안전 마진"가중치 클로즈드 클로즈드 클로즈드(오픈 약속은 미정) 수렴한 것: 1M 컨텍스트, 128K 출력, 추론 강도 파라미터, 캐시 가격 차등, 멀티에이전트 오케스트레이션, 컴퓨터 사용. 2024년엔 차별점이던 것들이 2026년엔 기본 사양이 됐다. 세 회사 모두 파라미터 수, 전문가(MoE) 구성, 학습 컴퓨트를 공개하지 않는다. 2부에서는 공개된 논문·시스템 카드·기술 블로그에서 역추적 가능한 것(looped transformer, 추론 시간 스케일링, 컨텍스트 압축, 멀티에이전트 학습)을 중심으로 세 모델의 원리가 어디서 겹치는지 다룬다.
갈라진 것은 세 가지다. 여기서 볼 수 있는 건 셋 다 "모델이 무엇을 할 수 있나"가 아니라 "그 능력을 어떻게 통제하고 누구에게 보여 주나"에 관한 것이다.
(1) 사고 기록을 누가 볼 수 있나. 사고 기록(CoT)을 읽는 쪽은 둘이다. 하나는 사용자, 다른 하나는 모델을 만든 회사 자신이다. 사용자에게 원문 대신 요약만 보여 주는 것은 Anthropic과 OpenAI가 같다(Meta는 공개된 정책이 없다). 갈린 것은 두 번째다. OpenAI는 Astra 시스템 카드에서 사고 기록이 짧아지면서 자사 내부 모니터링의 효력도 함께 떨어졌다고 적었다. 모델이 왜 그렇게 답했는지를 만든 회사조차 추적하기 어려워졌다는 뜻이다. 여기에 Astra가 같은 레이어를 여러 번 통과시키는 구조(recurrent depth)를 쓴다는 보도(미확인)가 겹쳤다. 이 구조에서는 계산 과정의 상당 부분이 애초에 글자로 남지 않기 때문에, 구조 자체가 모니터링을 어렵게 만든 것 아니냐는 지적이 나왔다. OpenAI는 구조가 원인이라는 해석을 부인했다. Anthropic과 Meta는 자사 시스템 카드에 이런 내용을 적지 않았다.
(2) 세이프가드를 어디에 두나. 위치가 다르고, 구속력도 다르다.
- Anthropic: 모델 바깥에 분류기를 두고, 걸리면 Opus가 대신 답한다. 모델은 그대로 두고 응답 시점에 거른다.
- OpenAI: 능력을 제한한 버전을 공개 배포하고, 제한 없는 쪽은 Daybreak 프로그램 참가자에게만 연다. 처음부터 배포하는 모델 자체를 나눈다.
- Meta: Advanced AI Scaling Framework 문서에 "안전 마진"을 두겠다고 선언했다. 배포를 실제로 가르는 장치는 외부에 공개하지 않았다.
앞의 둘은 지금 작동하는 장치이고, Meta는 아직 문서상의 약속이다.
(3) 사용자 데이터를 가격에 연동하나. 셋 중 Meta만 그렇게 한다. contributor tier에 동의해 자기 데이터를 Meta 학습에 쓰도록 허용하면 10~20배 싼 가격을 적용받는다. Anthropic과 OpenAI의 가격표에는 이런 항목이 없고, 오히려 Anthropic은 기업 데이터가 자사로 넘어오지 않는 구조(EFS)를 따로 만들어 판다. 데이터를 받는 대신 싸게 주는 쪽과, 데이터를 받지 않는 것을 상품으로 만드는 쪽으로 갈렸다.
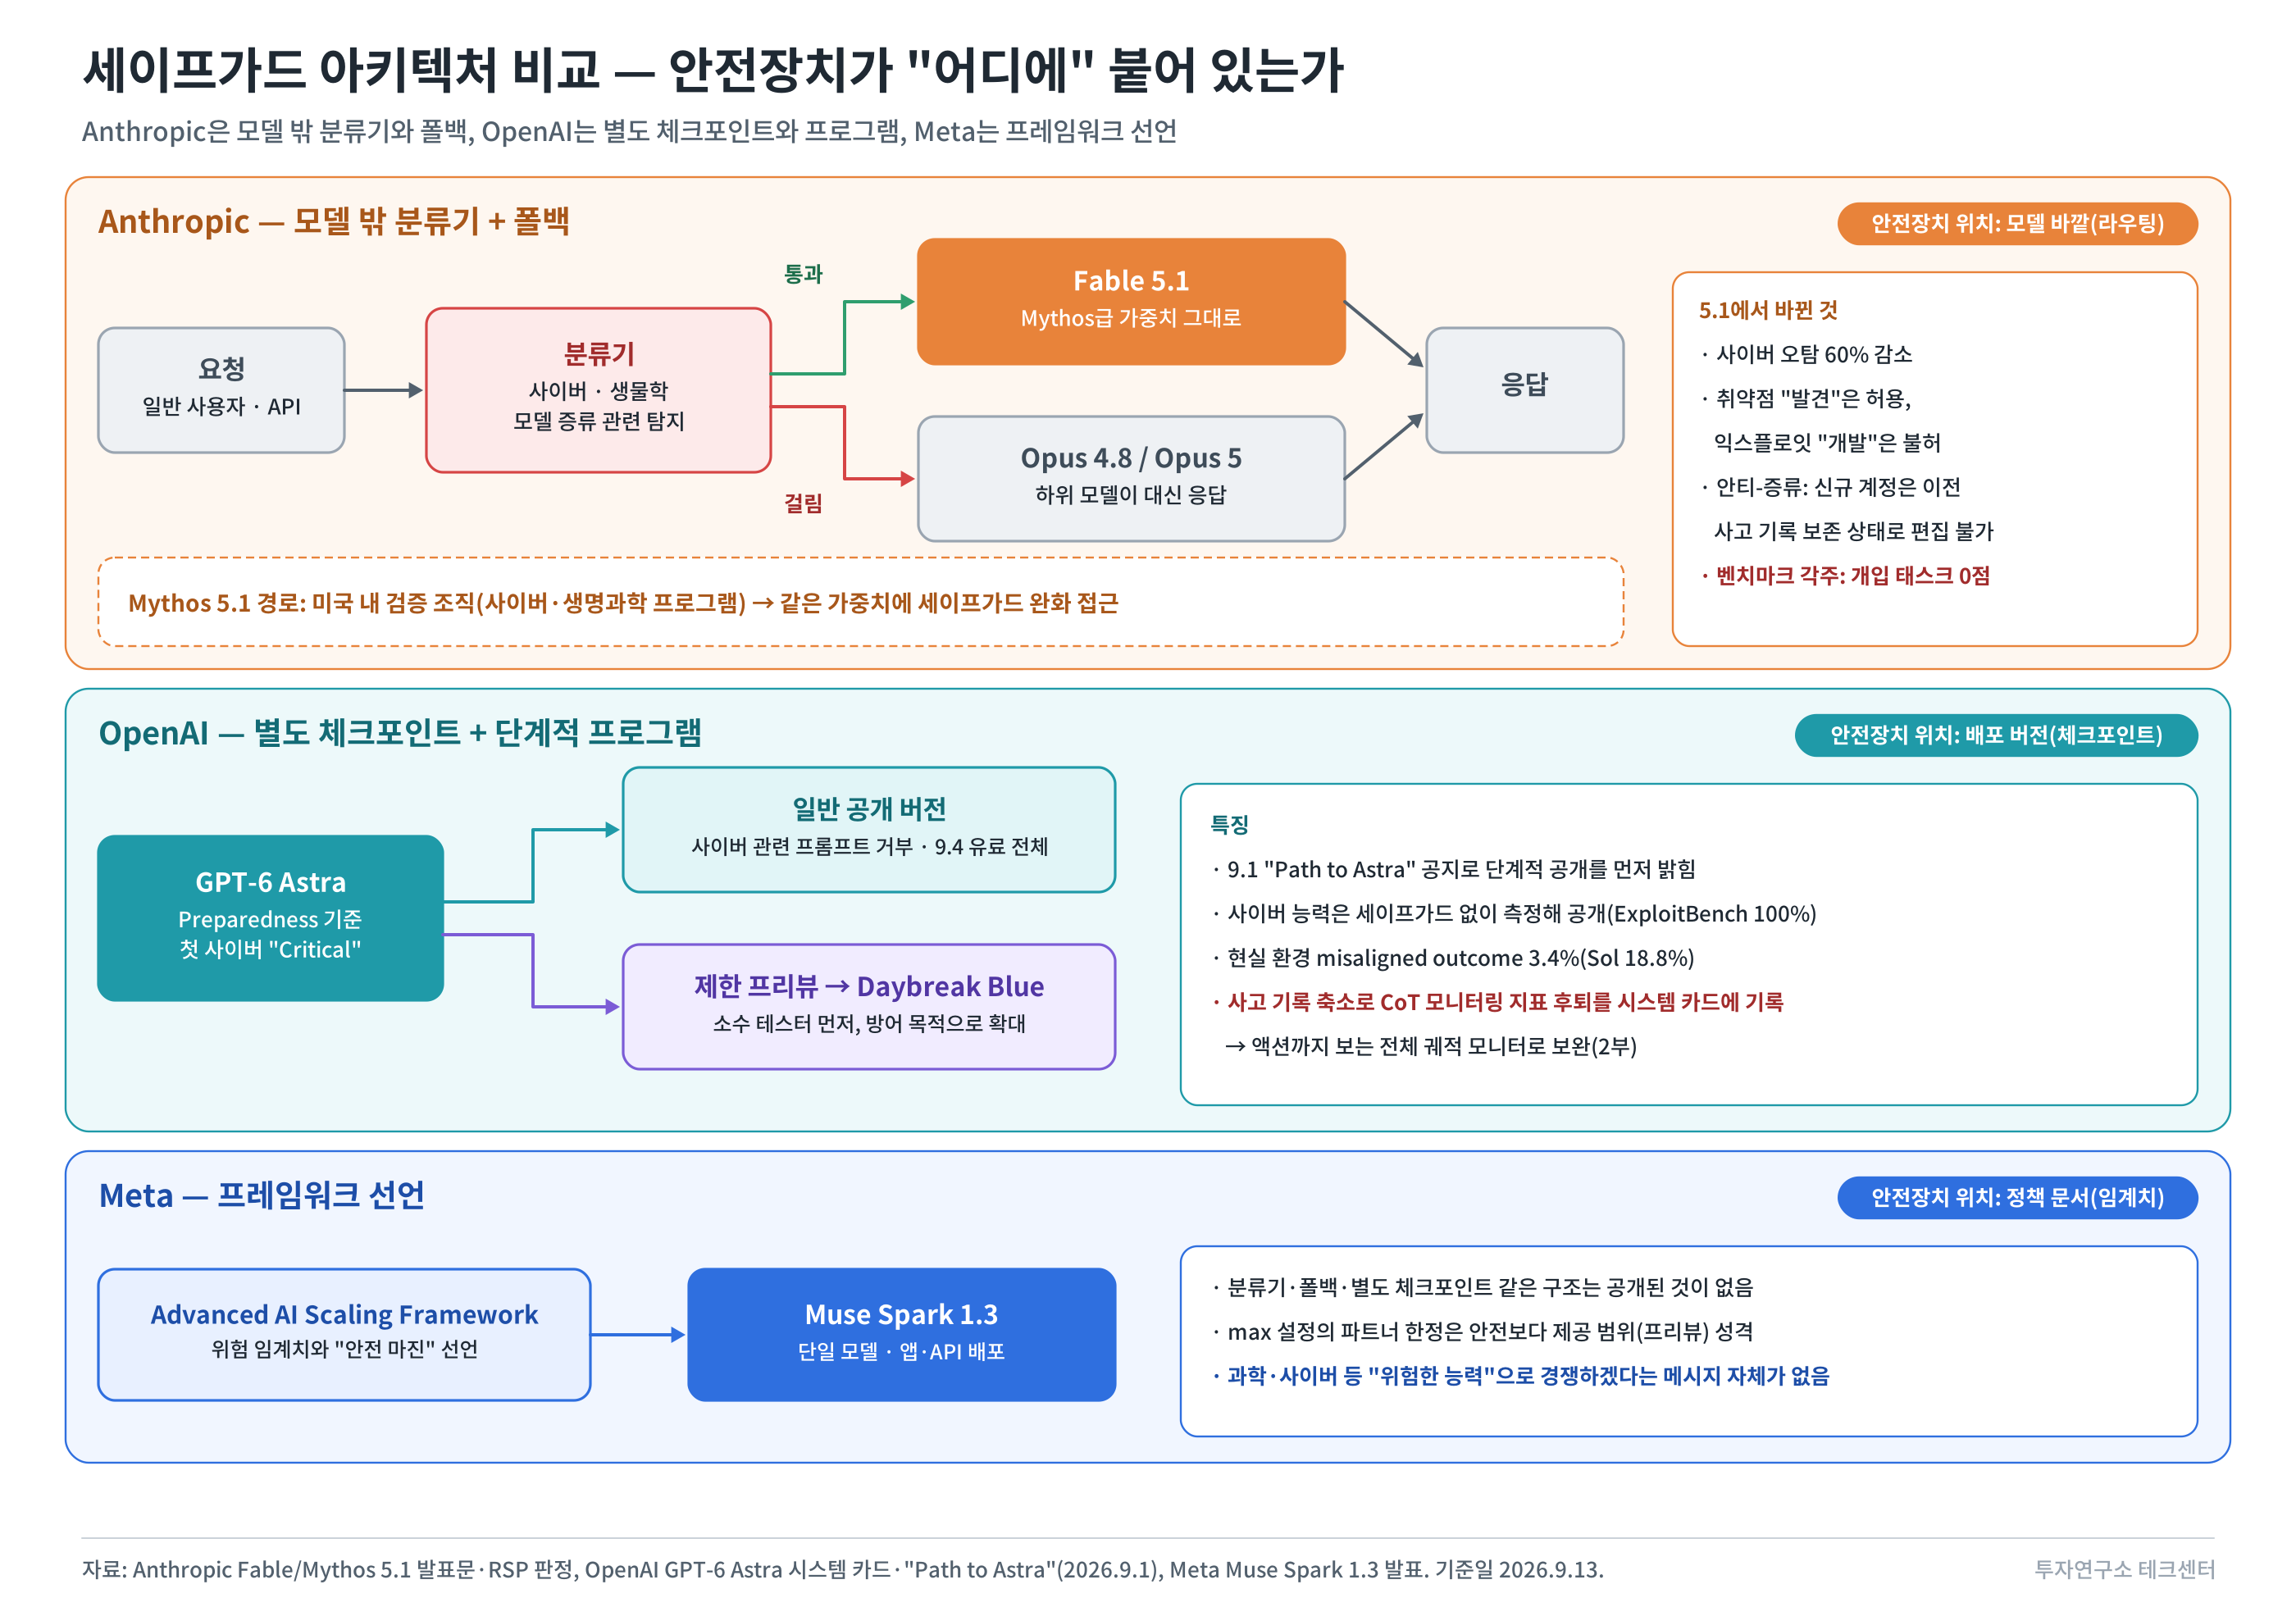
그림 1-4. 세이프가드 아키텍처 비교 스펙 표 뒤의 기술 - 공통 구조와 회사별 단서
스펙 표만 보면 세 모델은 "1M 컨텍스트, 추론 강도 단계" 같은 사양의 나열이다. 그 숫자를 만드는 기술을 조금 더 자세히 보면 다음과 같다.
1) 공개하지 않아도 공통으로 깔린 것. 2026년 프런티어 모델의 기본 구조는 사실상 같다.
- 디코더 트랜스포머 + MoE(전문가 혼합): 파라미터 전체 중 토큰마다 일부 "전문가"만 계산에 참여한다. 덕분에 지식 용량은 크게 키우면서 토큰당 연산은 작게 유지한다.
- RLVR: 정답을 기계가 채점할 수 있는 과제로 강화학습을 돌려 추론 습관을 기른다.
- 추론 강도 설정과 도구 사용: 답하기 전에 얼마나 생각할지 정하고, 코드 실행·검색·컴퓨터 조작 같은 도구를 쓴다.
세 회사가 파라미터 수를 숨겨도 이 기본 구조는 논문과 API 문서로 확인된다(2부, 3부). 1M 컨텍스트가 비싼 이유는 "KV 캐시"다. 모델은 앞서 읽은 토큰마다 Key·Value라는 중간 계산값을 GPU 메모리(HBM)에 쌓아 두고, 새 토큰을 만들 때마다 이를 다시 읽는다. 문맥이 100만 토큰이면 이 저장분이 GPU 메모리의 상당 부분을 차지한다. 세 회사가 모두 캐시 가격을 따로 매기고, 오래된 문맥을 요약·삭제하는 기능을 API에 넣은 이유다. Anthropic의 캐시 리드 75% 인하도 같은 맥락이다.
2) 각 사가 공개한 기술 및 자료들을 보면 조금씩 강조하는 포인트는 다르다.
A. Anthropic - 모델이 스스로 생각량을 정하고, 상태 관리를 개발자에게 넘긴다.
- 적응형 사고(adaptive thinking)를 유일한 모드로 만들었다. 예전에는 "생각하기"를 켜고 끄는 것이 사용자의 선택이었는데, 이제 모델이 질문마다 생각할지 말지, 한다면 얼마나 할지를 스스로 정한다. 사용자는 추론 강도(effort) 5단계로 상한만 준다. 쉬운 질문에는 토큰을 거의 쓰지 않고 어려운 질문에 몰아 쓰므로, 비용이 질문 난이도를 따라간다.
- 문맥 관리 기능을 전부 API 파라미터로 노출했다. 서버측 압축(compaction, Opus 4.6에서 도입)은 대화가 한도에 가까워지면 오래된 문맥을 요약으로 대체한다. 여기에 문맥 편집(쓸모없어진 도구 결과 삭제), 메모리 도구, 사고 블록 보존·삭제 제어, 태스크 예산이 붙는다. 개발자가 직접 제어하는 방식이다.
- 이 기능들이 캐시 비용과 하나로 묶여 있다. 사고 설정이나 추론 강도를 바꾸면 캐시가 처음부터 다시 쌓인다는 규칙까지 문서에 적혀 있다. 캐시 리드를 75% 내린 결정(4-2)은 이 시스템 위에서 나왔다.
- 모델 내부를 읽는 도구를 따로 만들었다. NLA(Natural Language Autoencoders, 2026.5)는 모델이 계산에 쓰는 숫자값(활성화)을 읽어 자연어 설명을 만들고, 그 설명만으로 원래 숫자값을 되살릴 수 있는지로 설명의 정확성을 검증한다. 사고 기록이 짧아지는 흐름과 무관하게 모델을 들여다볼 수단을 확보하려는 것이다.
- 요약하면 문맥 관리와 내부 감사에 역량을 쓰고 있다.
B. OpenAI - 같은 답을 더 적은 토큰으로 내는 쪽에 집중한다.
- 구조: recurrent depth 보도(미확인). 같은 레이어를 여러 번 반복 통과시켜, 파라미터를 늘리지 않고 연산만 늘리는 방식이다. 2018년 Universal Transformer가 원형이다(2부 2장). 이 구조에서는 추가된 계산이 글자가 아니라 내부 숫자값으로 돌기 때문에 사고 기록에 남지 않는다. 앞서 본 모니터링 논란이 이 보도로 커졌다(OpenAI는 구조가 원인이라는 해석을 부인).
- 토큰 효율은 수치로 확인된다. AA 측정 기준 코딩 에이전트 평가에서 Sol 대비 약 1/3의 토큰만 쓰고, AA 기준 태스크당 비용은 Fable 5.1의 약 40%다. 리스트 가격이 같은데도 실제로 내는 돈이 갈리는 이유다(4-2).
- 문맥 관리는 요약이 아니라 보관으로 푼다. 요약 압축은 결론은 남기지만 "왜 그 수정이 실패했는지" 같은 근거를 잃는다. Astra와 함께 Codex에 들어간 실험 기능은 한도가 찰 때 노트를 남기고 이전 기록을 검색 가능한 상태로 보관한다.
- 컴퓨터 사용 강화학습 환경을 키웠다. 가상 PC와 브라우저를 격리 환경에 띄워 놓고 실제 화면 조작을 학습시킨다. 모델만이 아니라 학습용 환경 자체가 투자 대상이 됐다.
- 요약하면 토큰 효율과 학습 환경에 역량을 쓰고 있다.
C. Meta - 연산을 적게 쓰고도 같은 수준에 도달하는 쪽에 집중한다.
- 연산을 넣을 곳을 세 군데로 나눠 관리한다. Muse Spark 발표(2026.4)에서 사전학습·강화학습·추론 시간을 "세 개의 스케일링 축"으로 놓았다. 어디에 얼마를 넣을지를 따로 조절하겠다는 뜻이다.
- 효율 수치를 전면에 내세웠다. 전작 Llama 4 Maverick보다 10배 이상 적은 연산으로 같은 능력에 도달했다고 밝혔다. 미국 연구소 중에서는 드문 발표 방식이다. 다만 구조 세부는 공개하지 않았다.
- 추론을 짧게 만드는 학습과 병렬 추론을 공개했다. 답이 길어지면 보상에서 깎는 방식(길이 벌점)으로 간결하게 생각하도록 가르치고, 여러 에이전트가 동시에 풀고 종합하는 모드를 함께 냈다.
- 문맥 관리를 API 기능이 아니라 학습 목표로 뒀다. Muse Spark 1.1은 모델이 "1M 문맥을 능동적으로 관리한다 — 행동을 기억하고, 훨씬 이전 작업에서 정보를 꺼내 오고, 이후에 필요한 핵심 단계만 남기는 방식으로 압축한다"고 썼다. 다만 장문맥 추론 점수(AA-LCR)는 1.2에서 1.3으로 가며 4점 떨어졌다.
- 요약하면 학습 효율과 병렬 추론에 역량을 쓰고 있다.
셋을 가르는 축은 "문맥/상태를 어디에 두느냐"다. 문맥이 길어지면 결론은 남고 근거가 사라지는 문제를 Anthropic은 API 파라미터로(개발자가 제어), OpenAI는 에이전트 실행 환경으로(Codex 안에서), Meta는 모델 가중치로(학습된 행동) 푼다. 이 차이가 4장의 장단점과 4-2의 가격 구조로 이어지고, 5부에서 "상태를 저장하는 인프라 비용을 누가 지느냐"는 질문으로 다시 나온다.
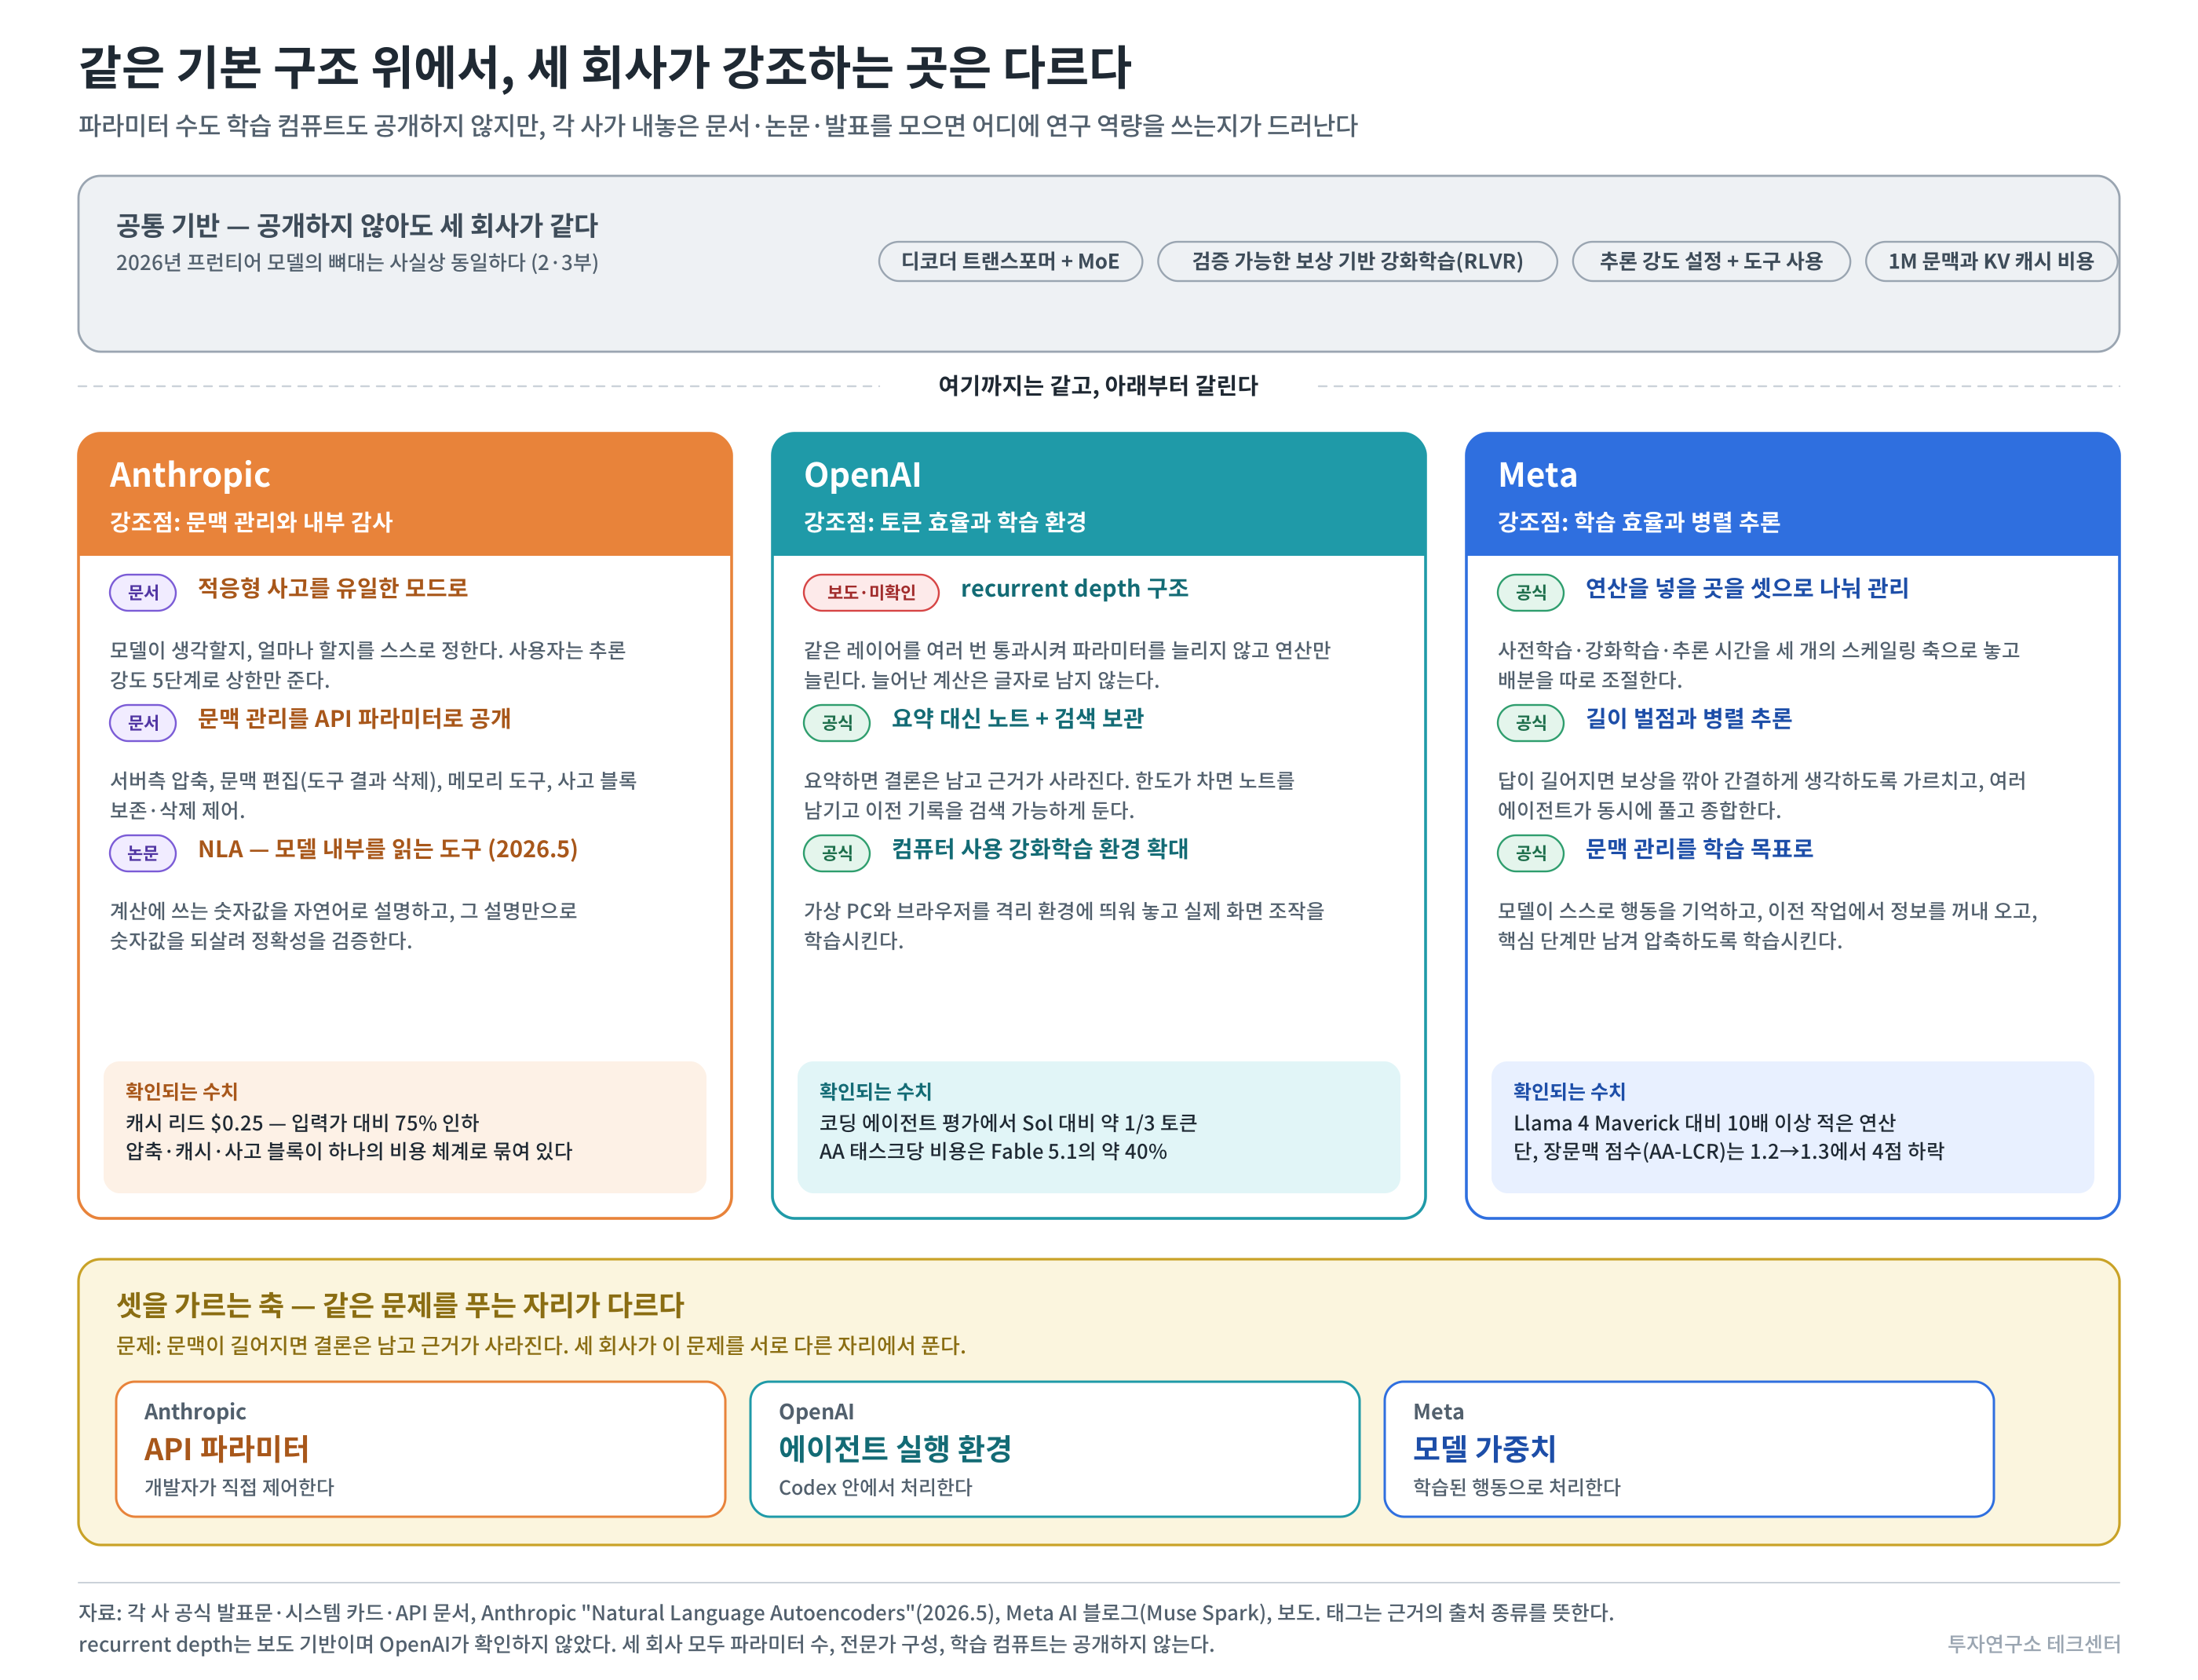
그림 1-5. 같은 기본 구조 위에서 세 회사가 강조하는 곳 4. 성능과 가격 - 누가 어디서 앞서나
4-1. 성능: 독립 지표 (AA) 기준으로 2강 1중
Artificial Analysis 지능지수(2026.9 기준): Fable 5.1(max) 66, GPT-6 Astra 66(동률), Opus 5(max) 63, Fable 5(max) 62, Muse Spark 1.3(max) 62, Muse Spark 1.3(xhigh) 61 = GPT-5.6 Sol(max) 61 = Grok 4.6 61이다.
각 사 자체 벤치마크는 각자 유리하게 짜여 있으니 읽을 때 주의가 필요하다.
- Anthropic 표: Terminal-Bench-Science 0.1에서 Fable 5.1 52.6% vs Fable 5 24.7% vs Sol 22.4%. 단, 세이프가드 개입 태스크 0점 처리, OSWorld는 8월 신규 태스크셋이라 경쟁사 비교 불가 등 각주가 많다. 표준오차 ±3.5~4.5pt도 명시.
- OpenAI 표: FrontierMath Tier 4 83.0% → 97.6%, ExploitBench 100%(vs Sol 78.5%), 현실 환경 misaligned outcome 3.4%(vs Sol 18.8%). 사이버 능력은 세이프가드 없이 측정. Claude는 생명과학 벤치마크에서 대부분 거부해 아예 표에서 뺐다고 명시했다.
- Meta 표: 1.3 max vs 1.2 xhigh를 비교해 세대 차가 실제보다 크게 보이는 측면이 있고(AA도 지적), max는 파트너 한정이라 개발자가 쓸 수 있는 건 61점짜리 xhigh다. 버전 1.3은 1.2보다 약 3배 장황하다는 분석도 있다(Meta 자체 발표는 1.2 대비 토큰 25% 감소다.)
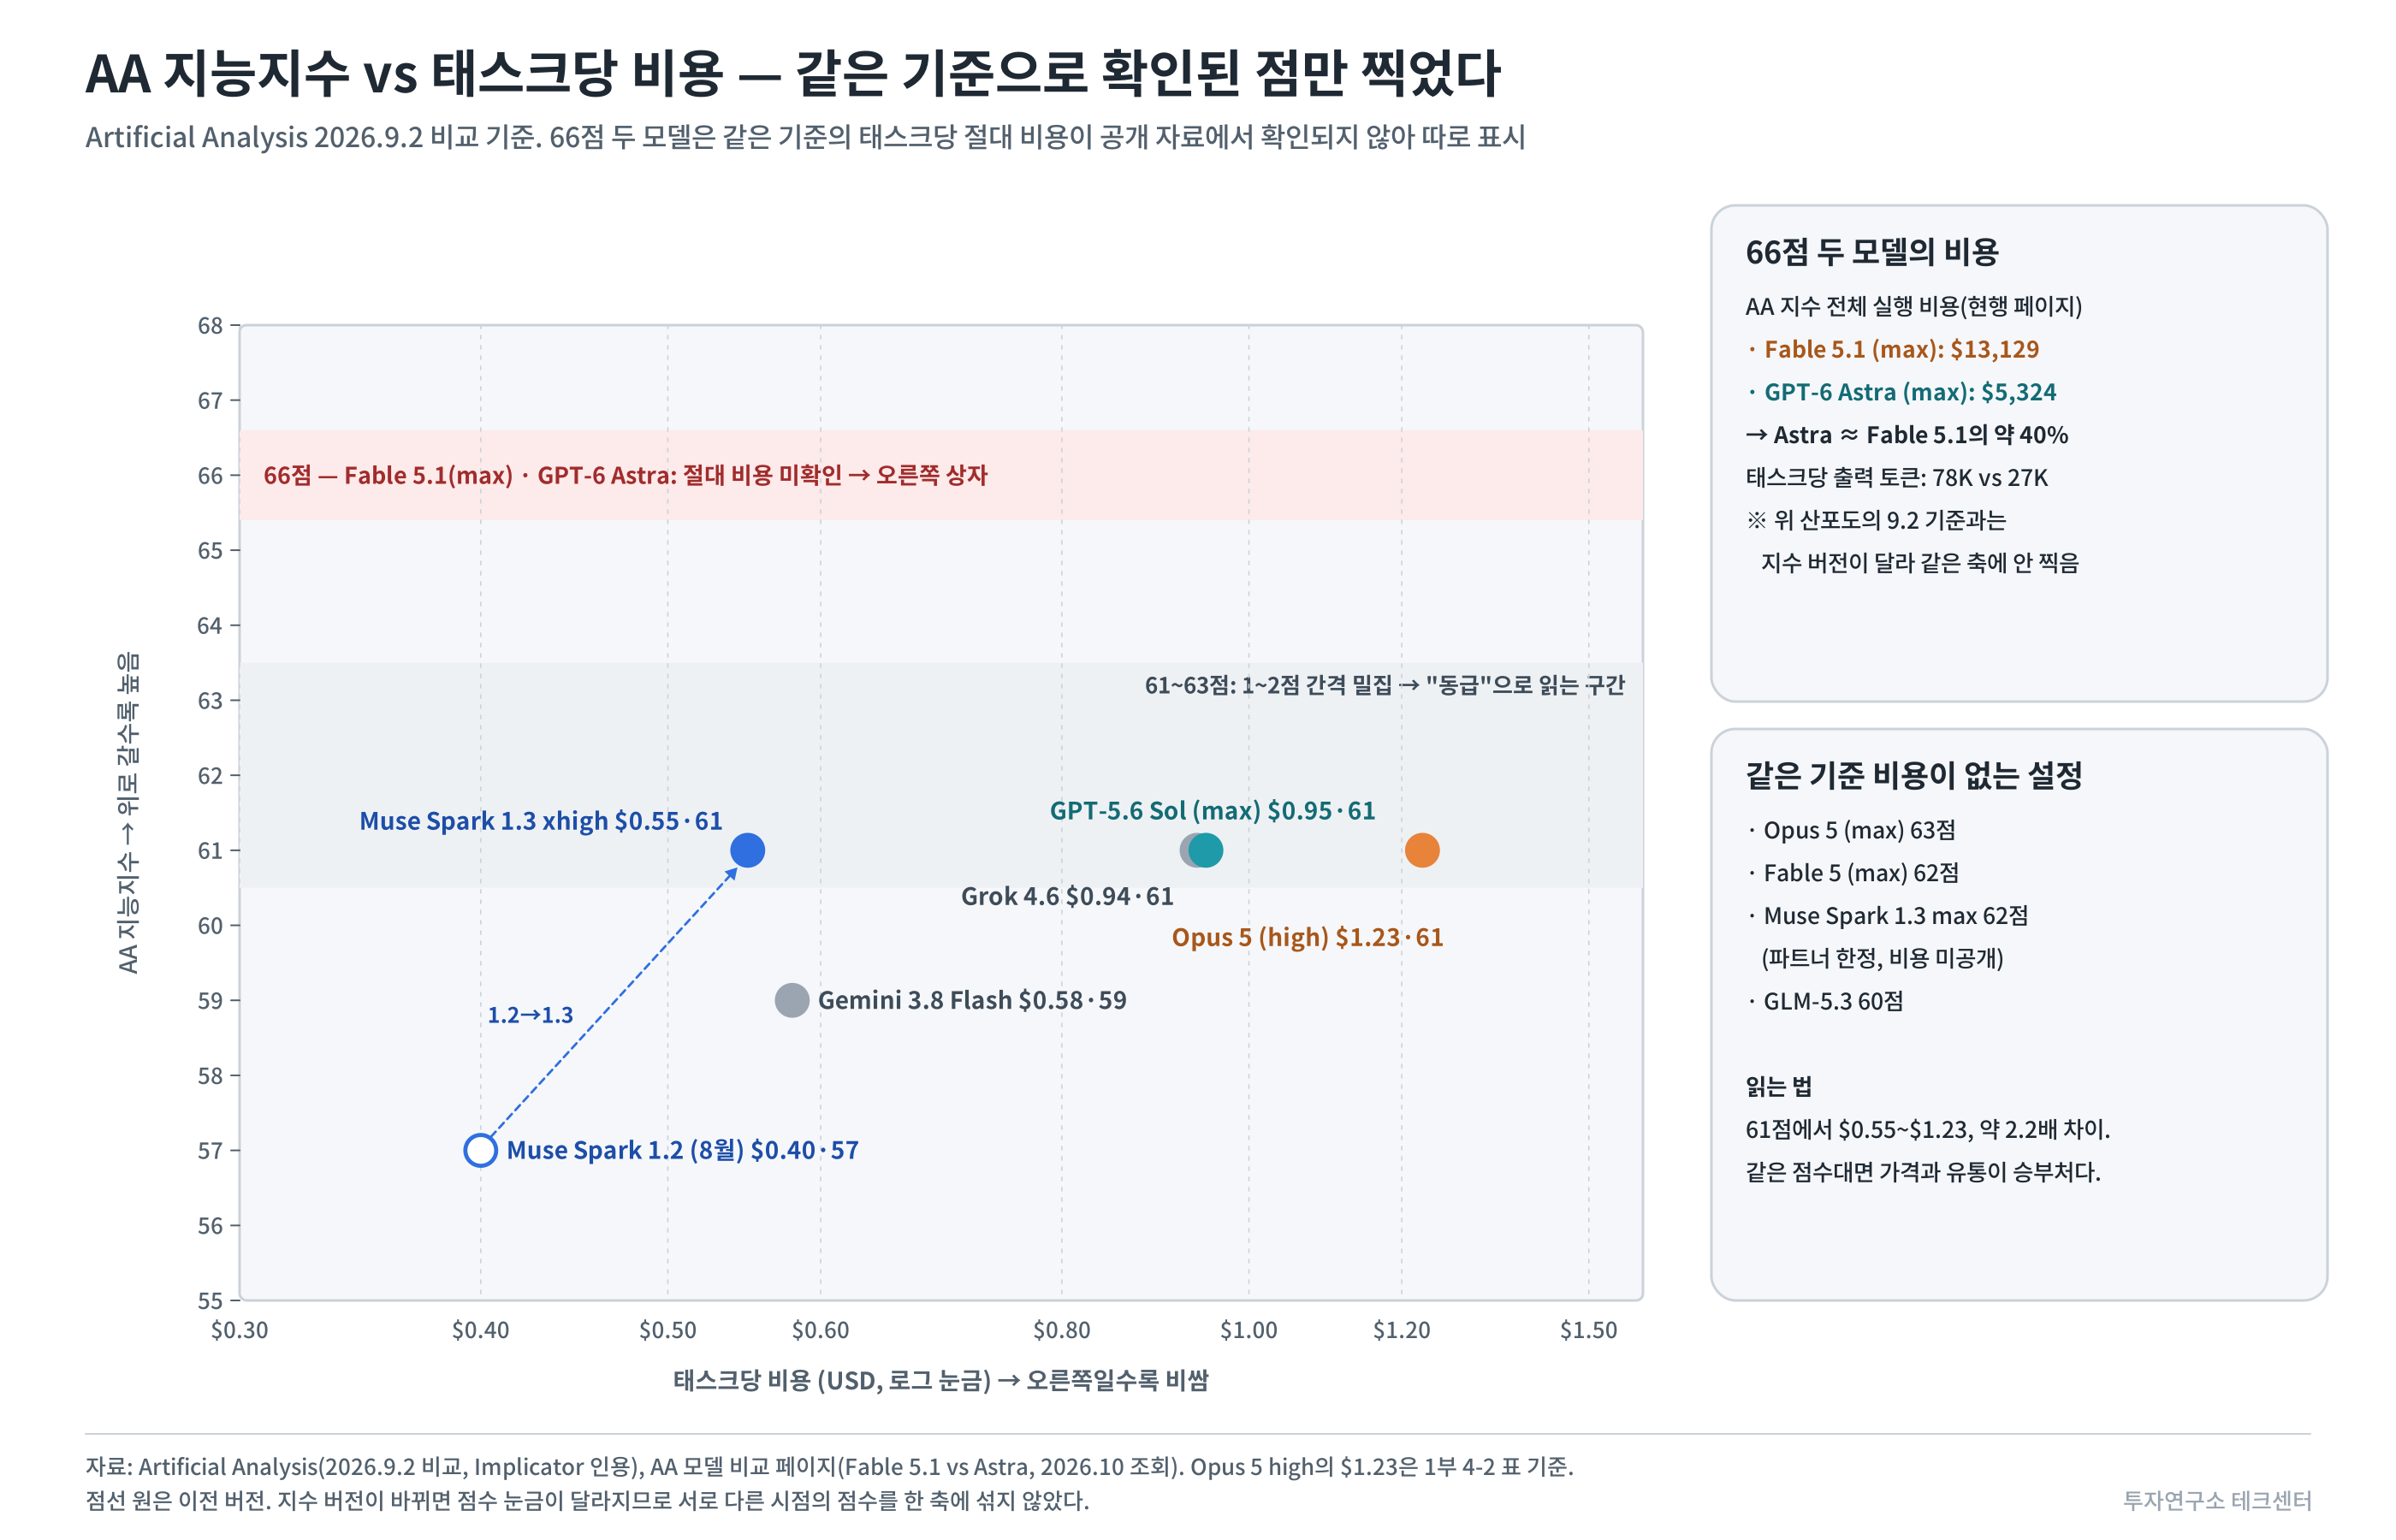
그림 1-6. AA 지능지수 vs 태스크당 비용 점수를 어떻게 읽을까. AA 지능지수가 무엇으로 구성되는지, 1점 차이가 어떤 의미인지는 별도 글 「Kimi K3와 AI 경쟁 - AI Benchmark 비교와 성능 분석」(#186)에서 자세히 다뤘다. 여기서는 위 숫자를 읽을 때 필요한 네 가지만 짚는다.
- 이 지수는 "자율 업무 수행 능력" 쪽으로 기울어 있다. v4.1 기준 9개 평가의 비중은 에이전트 34%, 코딩 24%, 과학 추론 24%, 일반 지식 18%다. 그래서 66점과 61점의 차이는 대화 품질보다 "터미널·코드·실무 태스크를 끝까지 해내는 능력"의 차이에 가깝다. 챗봇 용도에서는 두 점수를 체감하기 어렵다.
- 1~2점 차이는 "동급"으로 읽는 게 안전하다. Anthropic은 자사 표에서 개별 벤치마크의 표준오차를 ±3.5~4.5점으로 적었다. 여러 평가를 평균한 지수는 이보다 안정적이지만, 61~63점 사이에 여섯 개 설정이 1~2점 간격으로 몰려 있는 구간을 순위로 줄 세우는 것은 의미가 약하다. 이번 데이터에서 의미 있는 경계는 66(Fable 5.1·Astra)과 61~63(나머지) 사이다.
- 점수 옆의 괄호(max, xhigh)가 점수만큼 중요하다. AA는 결과물 품질만 재고 시간과 토큰 소비에는 벌점을 주지 않는다. 추론 토큰을 많이 쓰면 점수를 끌어올릴 수 있다는 뜻이다. 그래서 점수는 반드시 태스크당 비용과 같이 봐야 한다.
- 같은 66점이라도 Astra의 태스크당 비용은 Fable 5.1의 약 40%다(AA).
- Muse Spark 1.3의 62점은 파트너 한정 max 설정이다. 일반 개발자가 쓰는 xhigh는 61점이다.
- 각 사 자체 표는 "무엇을 넣고 뺐는지"부터 본다. 위 세 표 모두 자사에 유리한 평가를 고르고, 세이프가드 처리·비교 대상·설정을 각주로 조정했다. 독립 지수로 서열을 잡고, 자체 표는 "그 회사가 어떤 능력을 팔고 싶어 하는지"의 신호로 읽는 편이 낫다.
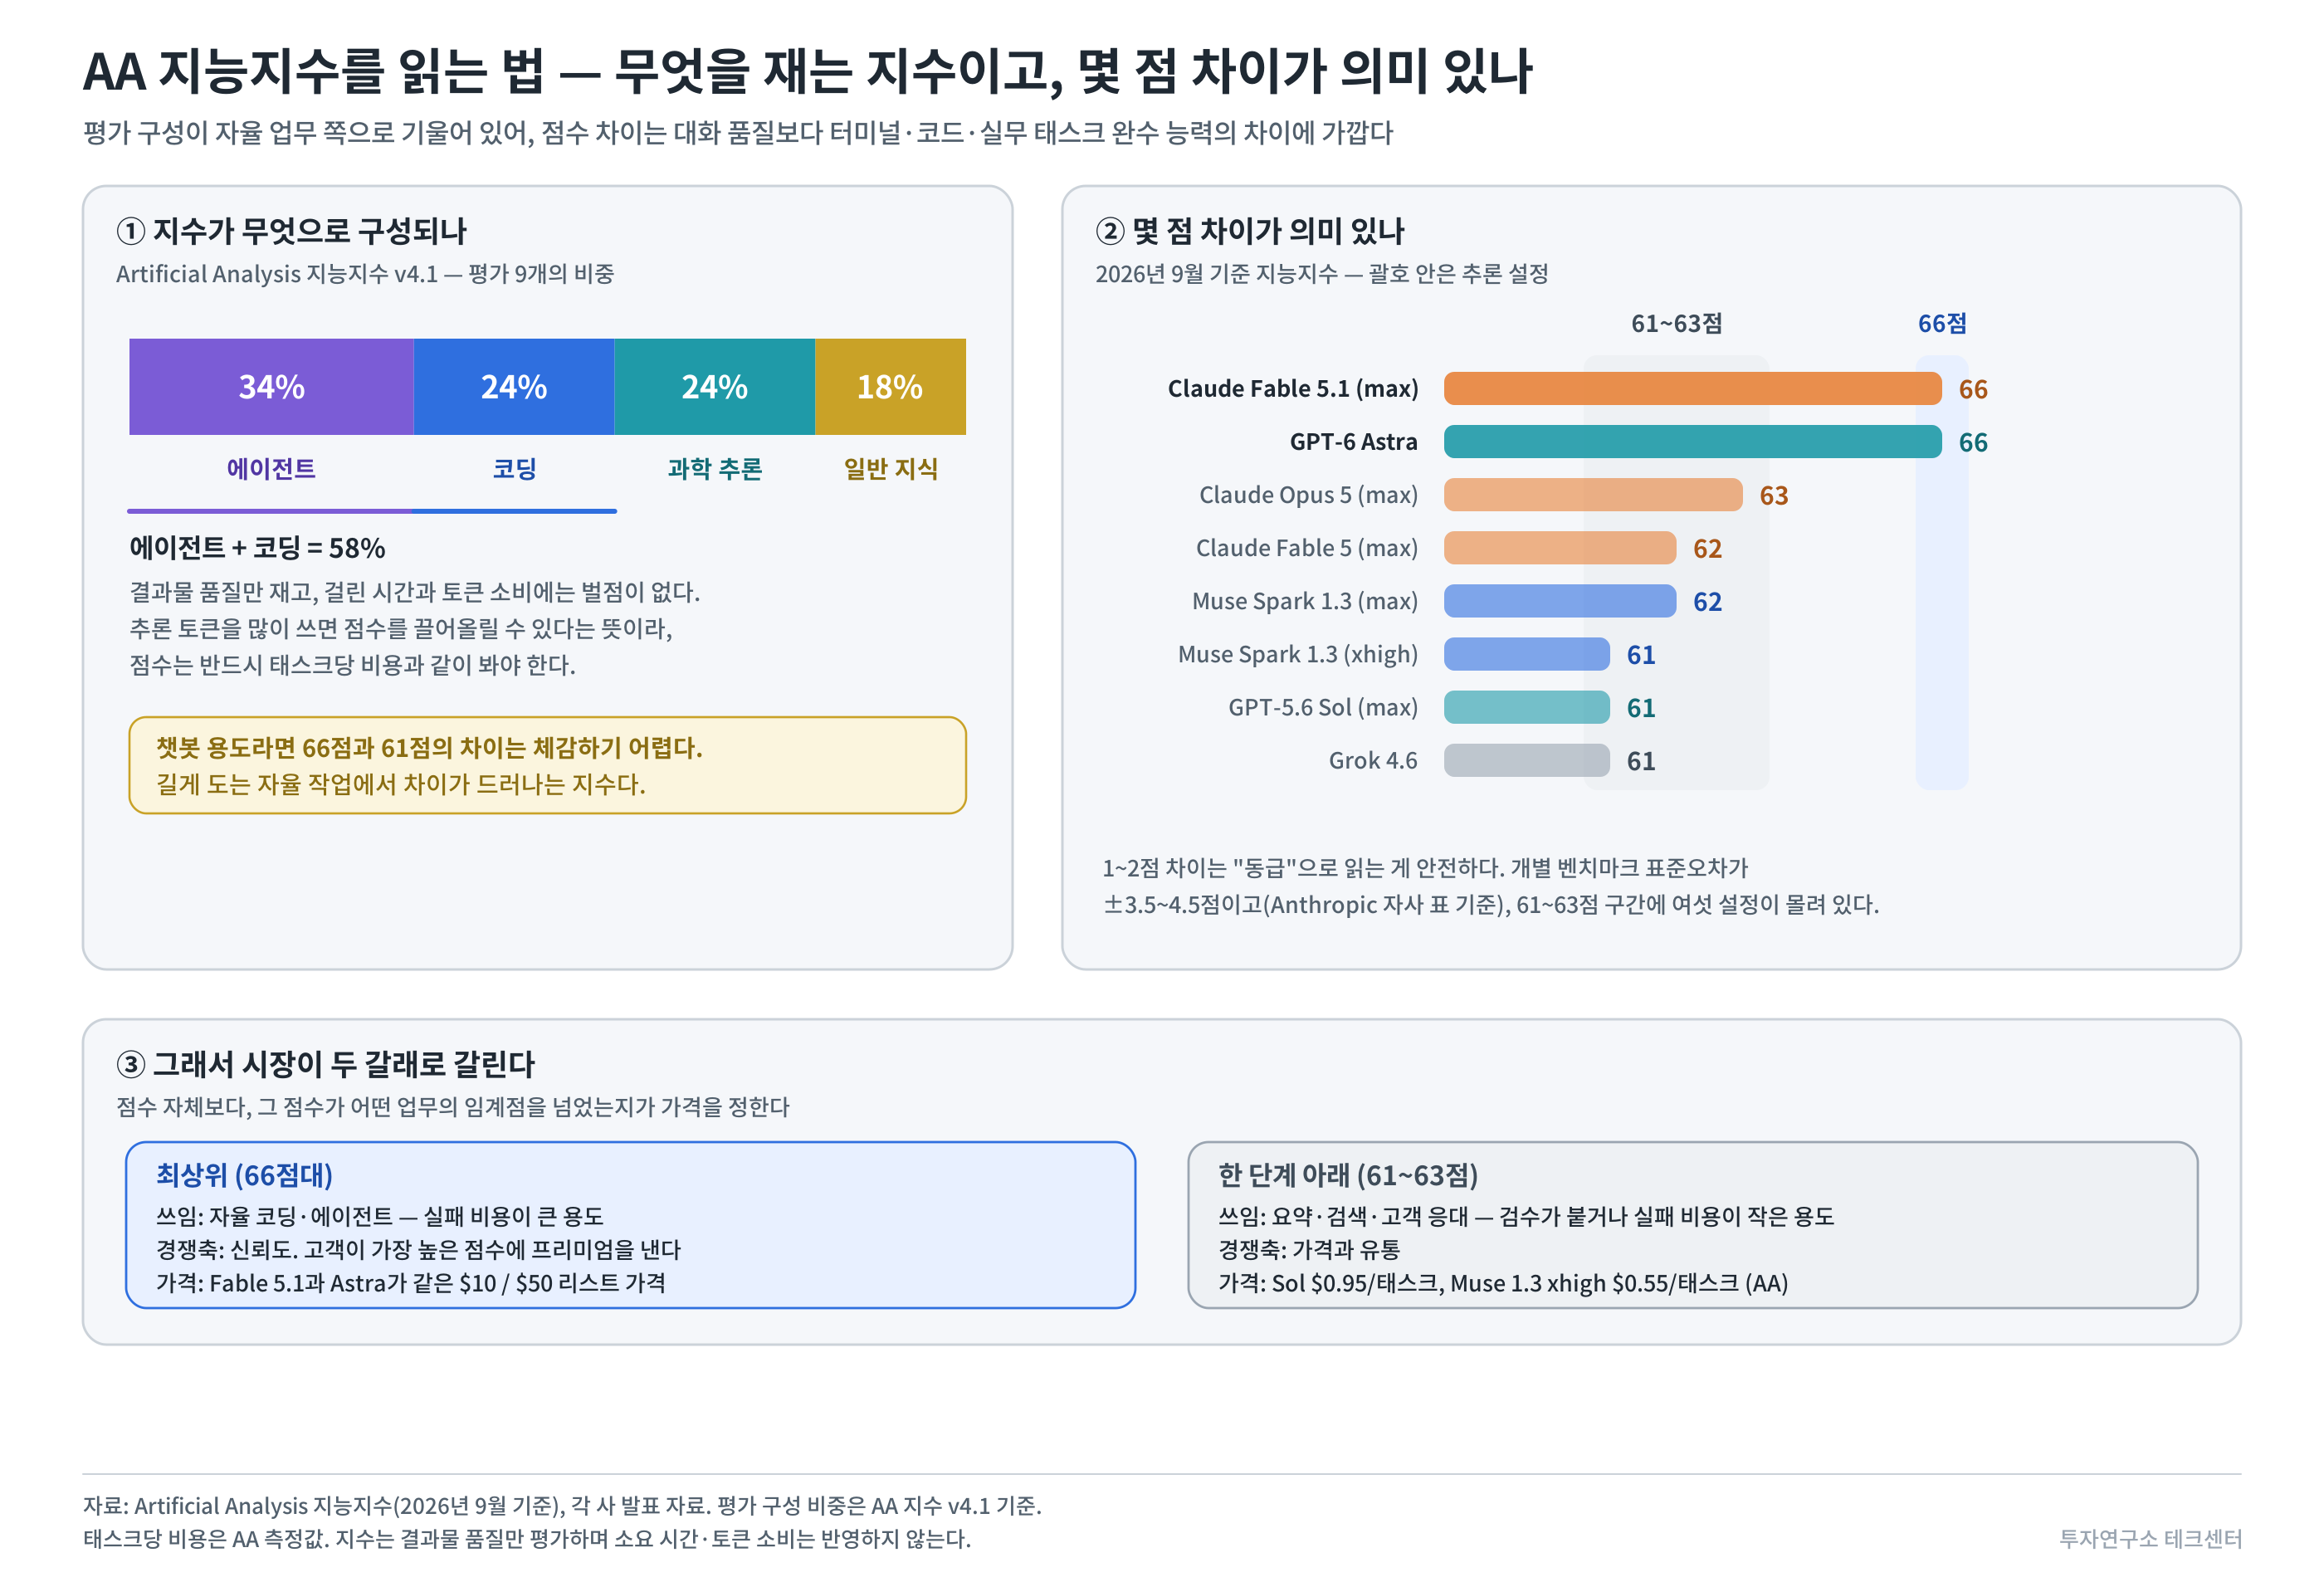
그림 1-7. AA 지능지수를 읽는 법 - 평가 구성, 점수 구간, 두 갈래로 갈린 시장 점수가 높다는 것의 상용적 의미. 점수 1점의 가치는 일정하지 않고, 업무별 "임계점"을 넘느냐에 달려 있다. 사람이 결과를 검수하지 않고 맡길 수 있는 수준을 넘는 순간, 모델이 대체하는 대상이 "사람의 보조"에서 "사람의 작업 시간 전체"로 바뀌기 때문이다.
이 차이는 긴 에이전트 작업에서 크게 벌어진다. 단계마다 성공률이 조금만 달라도 여러 단계를 거치면 완주율이 급격히 갈린다. 예를 들어 50단계짜리 작업에서 단계별 성공률이 95%면 끝까지 성공할 확률은 약 8%, 97%면 약 22%다(0.95⁵⁰, 0.97⁵⁰, 설명용 계산). 지수에서는 몇 점 차이로 보이는 신뢰도가 장시간 자율 작업에서는 "쓸 수 있느냐 없느냐"의 차이가 된다. 시장도 이 구조를 따라 갈린다.
- 최상위(66점대): 자율 코딩·에이전트처럼 실패 비용이 큰 용도에 쓰인다. 고객이 가장 높은 점수의 모델에 프리미엄을 낸다. Fable 5.1과 Astra가 같은 $10/$50 리스트 가격을 유지하는 배경으로 보인다.
- 한 단계 아래(61~63점): 요약·검색·고객 응대처럼 검수가 붙거나 실패 비용이 작은 용도에 쓰인다. 점수 차이보다 가격과 유통이 승부처다. Sol($0.95/태스크)과 Muse 1.3 xhigh($0.55/태스크)가 이 시장을 가져간다.
투자 관점에서는 "몇 점이냐"보다 "그 점수가 어떤 업무의 임계점을 넘었고, 그 업무를 태스크당 얼마에 처리하느냐"를 보는 것이 맞다. 같은 점수에서 토큰을 덜 쓰는 쪽(Astra), 캐시로 실효 단가를 낮추는 쪽(Fable 5.1), 낮은 가격으로 한 단계 아래 시장을 가져가는 쪽(Muse)이 각각 다른 수익 구조를 만든다(4-2 참고).
4-2. 가격: 리스트 가격은 같고, 실효 가격은 다르다
모델 입력/출력 ($/1M) AA 태스크당 비용 비고 Fable 5.1 10 / 50 최상위 에이전틱 워크로드 최대 45% 절감 주장 GPT-6 Astra 10 / 50 Fable 5.1의 약 40% (AA) 272K 초과 시 전체 재과금, 토큰 효율로 승부 Opus 5 5 / 25 $1.23 (high) GPT-5.6 Sol 4 / 20 (프로모) $0.95 (max) 11/21 이후 인상 가능 Sonnet 5 3 / 15 — Muse Spark 1.3 xhigh 1.25 / 4.25 $0.55 59점 이상 중 최저, contributor tier는 10~20배 더 싸다 포인트는 크게 두 개다. 첫째, Fable 5.1과 Astra의 리스트 가격이 정확히 일치한다. 프런티어 2강이 가격으로 경쟁하지 않겠다는 신호로 읽힌다. 둘째, 그럼에도 실효 비용은 두 축에서 갈린다. 캐시 리드 단가(Anthropic이 4배 싸다)와 토큰 효율(AA 기준 Astra가 같은 태스크에 훨씬 적은 토큰). 어느 모델이 유리한지는 워크로드가 컨텍스트 재사용형인지 생성형인지에 달려 있다.
4-3. 회사별 장점과 단점
Anthropic - Fable 5.1 / Opus 5 / Sonnet 5
- 장점: 독립 지표 1위(동률), 장기 실행·코딩·지식노동에서 파트너 증언 밀도가 가장 높음(Millennium의 4~5년 미제 크래시 원인 발견, Ramp의 38시간 무인 실행 등). 캐시 가격 인하로 에이전틱 워크로드 경제성. 과학 연구 실물 사례. EFS로 엔터프라이즈 프라이버시. 모델 내부 활성화를 읽는 도구(NLA)가 정렬 평가에 작동.
- 단점: 세이프가드 개입 시 성능 급락(생명과학 R&D는 여전히 Opus로 라우팅), 정부 규제 리스크가 직접 매출을 끊은 전례(6월 수출통제), Mythos는 미국 조직만. 안티-증류 조치가 일부 커스텀 통합을 깬다.
OpenAI - GPT-6 Astra / 5.6 Sol·Terra·Luna
- 장점: 수학·코딩·컴퓨터 사용에서 가장 큰 세대 점프(FrontierMath T4 97.6%, OSWorld 태스크 시간 47% 단축), 토큰 효율로 실효 비용 우위, 가장 넓은 가격대 구성(Astra~Luna 입력가 50배 차이), Cerebras 등 추론 하드웨어 다변화.
- 단점: 사고 기록 축소로 모니터링 가능성 후퇴(시스템 카드 자인) — recurrent depth 보도까지 겹쳐 안전 커뮤니티 반발과 규제 노출. 272K 초과 컨텍스트 전체 재과금. 7월 사건 → 출시 지연이라는 운영 리스크. 사이버 Critical 등급이라 최고로 높은 능력은 Daybreak 프로그램 안에서만 사용 가능하다.
Meta - Muse Spark 1.3 / Muse Image·Video
- 장점: 압도적 가격(같은 지능대 최저 태스크 비용), 5개월 4릴리즈의 속도, 텍스트·이미지·비디오 통합, 수십억 명 배포 채널, contributor tier로 이용자 데이터를 받아 다음 모델 학습에 쓰는 구조. Tau3-Bench Banking 1위 등 에이전틱 특정 영역에서 최상위.
- 단점: 최고 성능(max)은 개발자가 못 씀. 프런티어 2강과 4~5점 격차. 소비자 앱 중심이라 엔터프라이즈 레퍼런스가 얇음(Replit·Cline·Box 정도). 과학·사이버 등 '위험한 능력' 영역에서는 아예 경쟁하겠다는 메시지가 없다. 그 자체가 전략일 수도, 격차일 수도 있다.
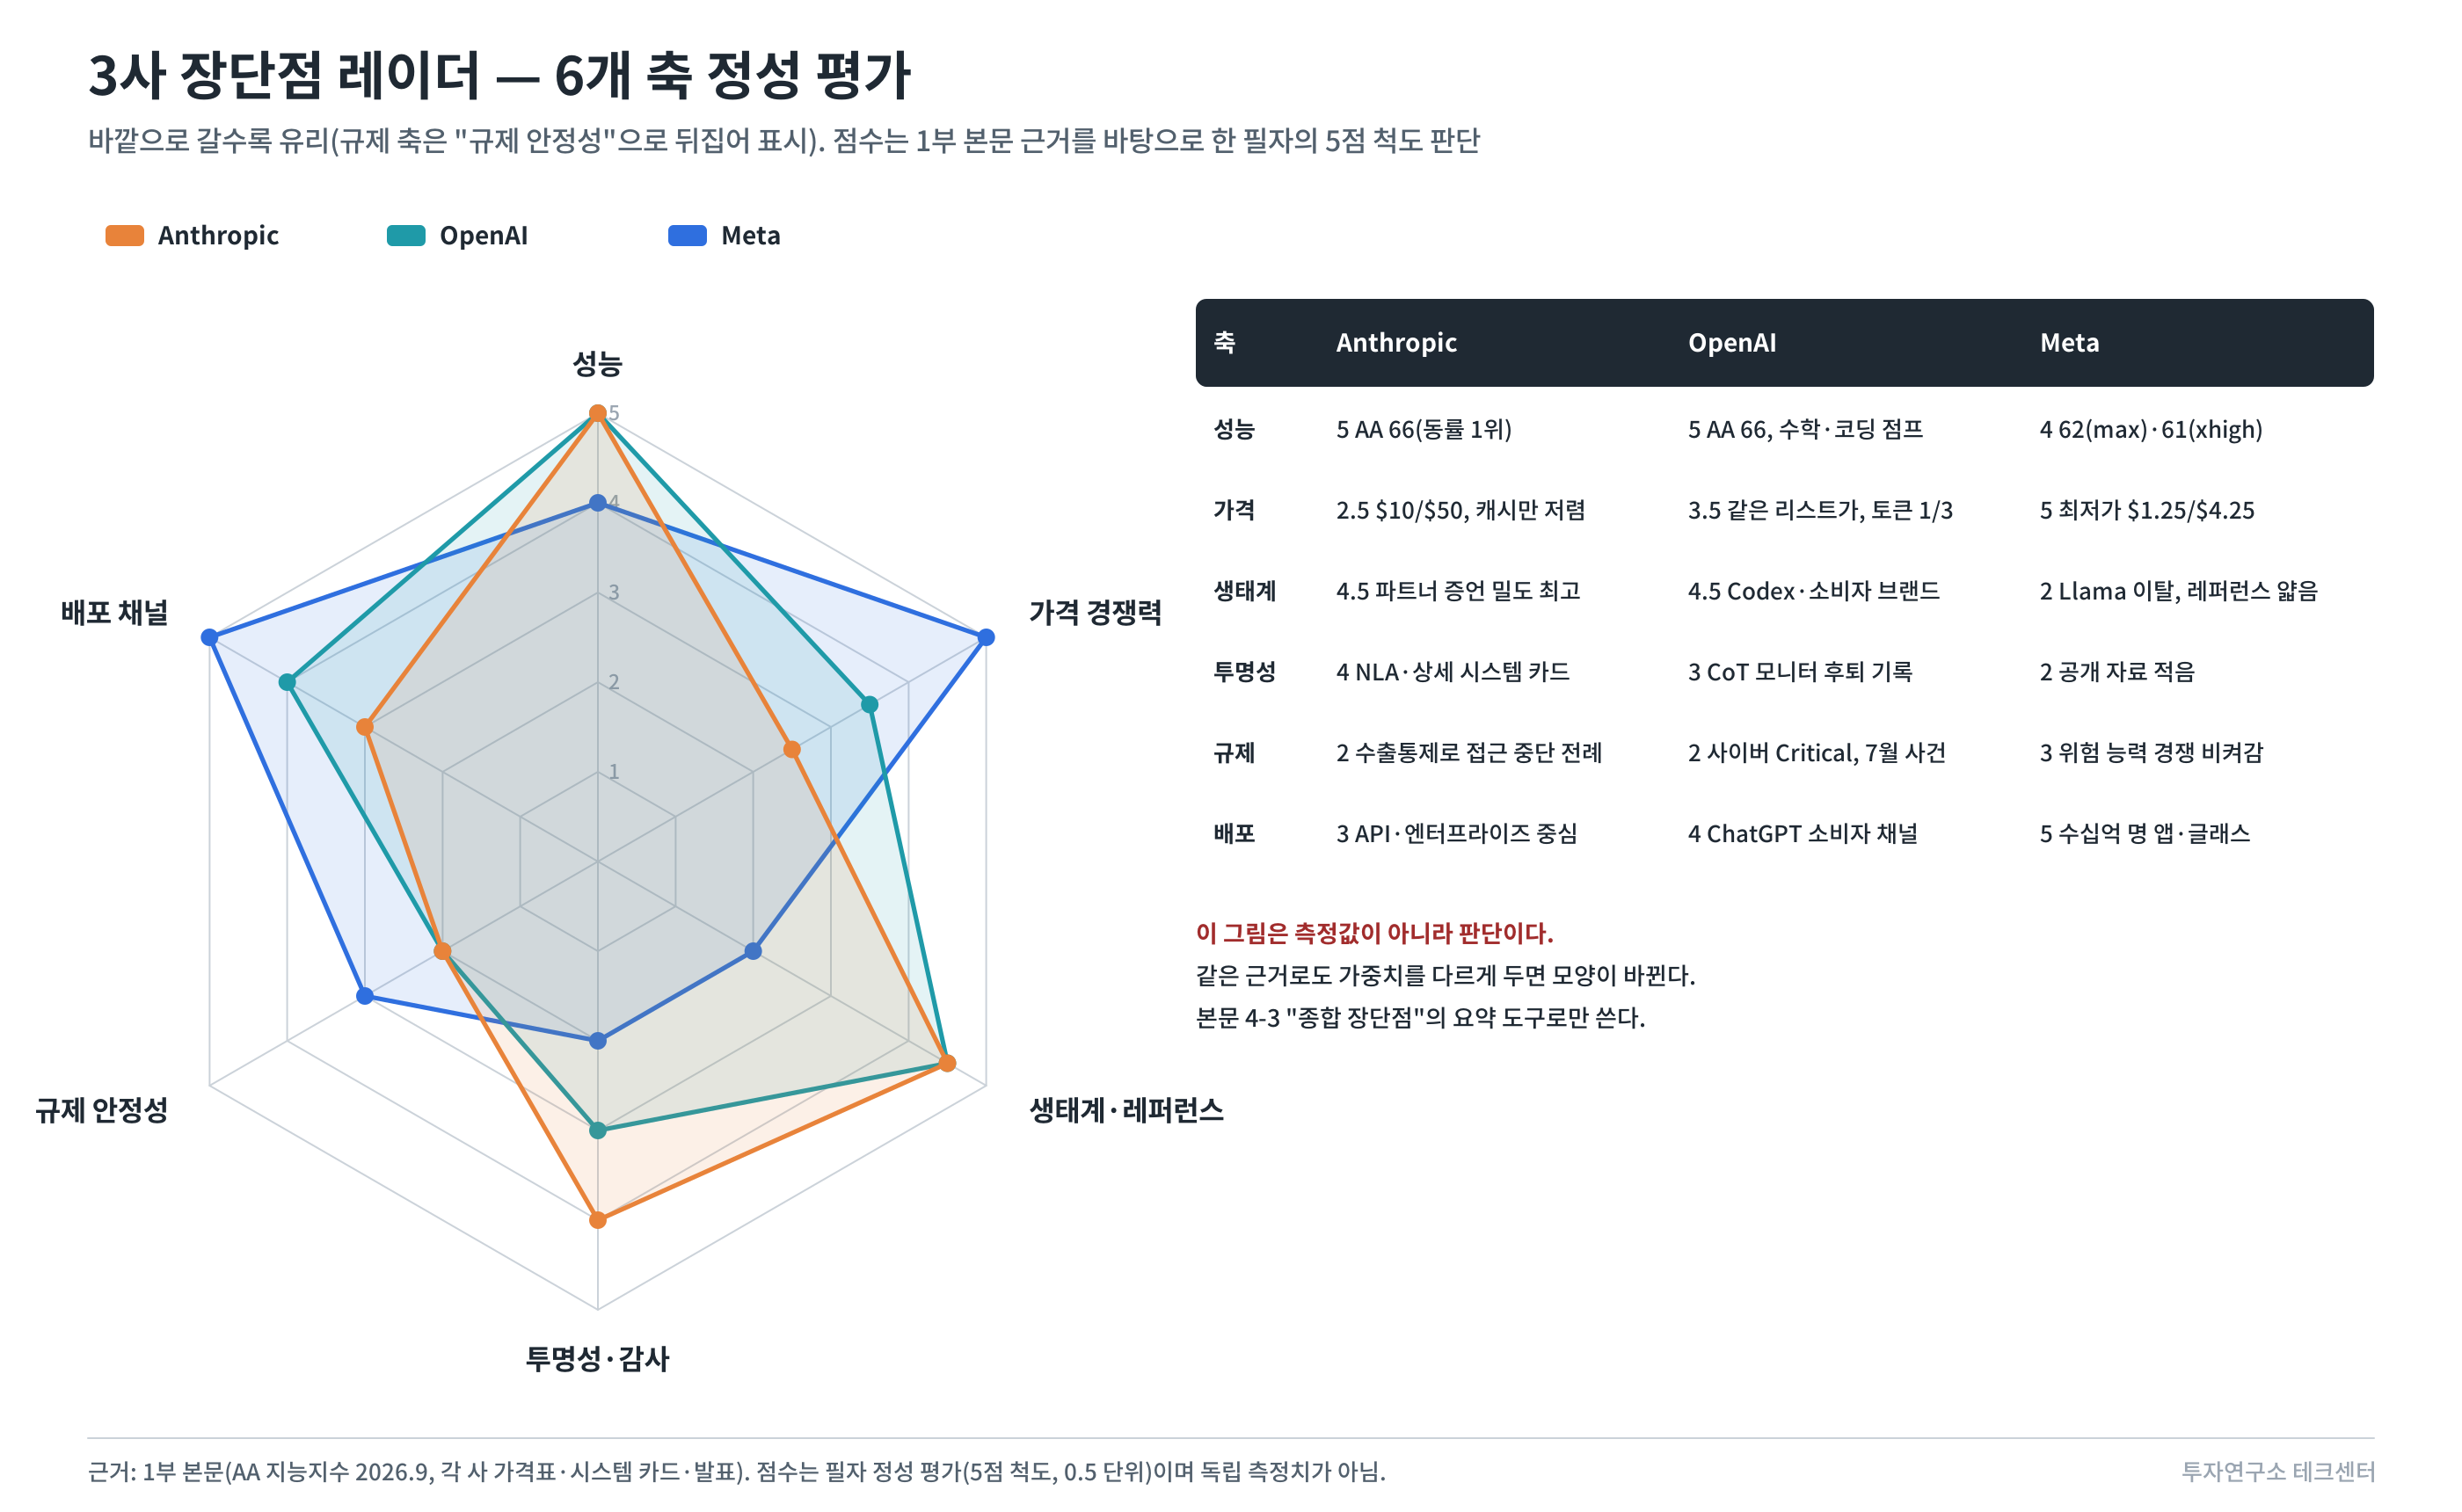
그림 1-8. 3사 장단점 레이더(정성 평가) 5. 코딩·연구 개발에 쓰이는 AI - Codex, Claude Code, Muse Code, 그리고 과학 연구
이 장은 2026년 10월 3일 기준으로 정리했다. 1부의 다른 장(기준일 9월 13일) 이후에 나온 자료도 포함한다. 참고로 OpenAI는 9월 22일 GPT-6 Sol·Luna, 9월 29일 GPT-6.1 Sol을 추가로 발표했지만 이 장에서는 다루지 않는다.
9월 발표문에서 세 회사가 공통으로 강조한 것은 코딩 에이전트였고, Anthropic과 OpenAI는 과학 연구 적용 사례도 앞세웠다. 이 장은 두 가지 질문에서 시작했다. 첫째, 코딩·연구용 AI는 범용 LLM과 따로 개발되는가. 둘째, 각 회사는 이 분야를 실제로 어떻게 연구개발하고 있는가.
결론부터 쓰면, 코딩·연구 적용은 LLM 개발과 다른 길이 아니라 지금 LLM 개발의 중심에 있다. 세 회사 모두 코딩 에이전트를 별도 모델이 아니라 주력 모델 위에서 돌린다(OpenAI가 2월 낸 저지연 코딩 모델 Codex-Spark 같은 예외는 있다). 차이는 모델 자체보다 다음 세 곳에서 난다.
- 어떤 과제로 강화학습을 시키는가
- 어떤 실행 환경(하니스)과 함께 학습시키는가
- 누구에게 어떤 능력을 열어 주는가
5-1. 세 회사의 코딩 에이전트
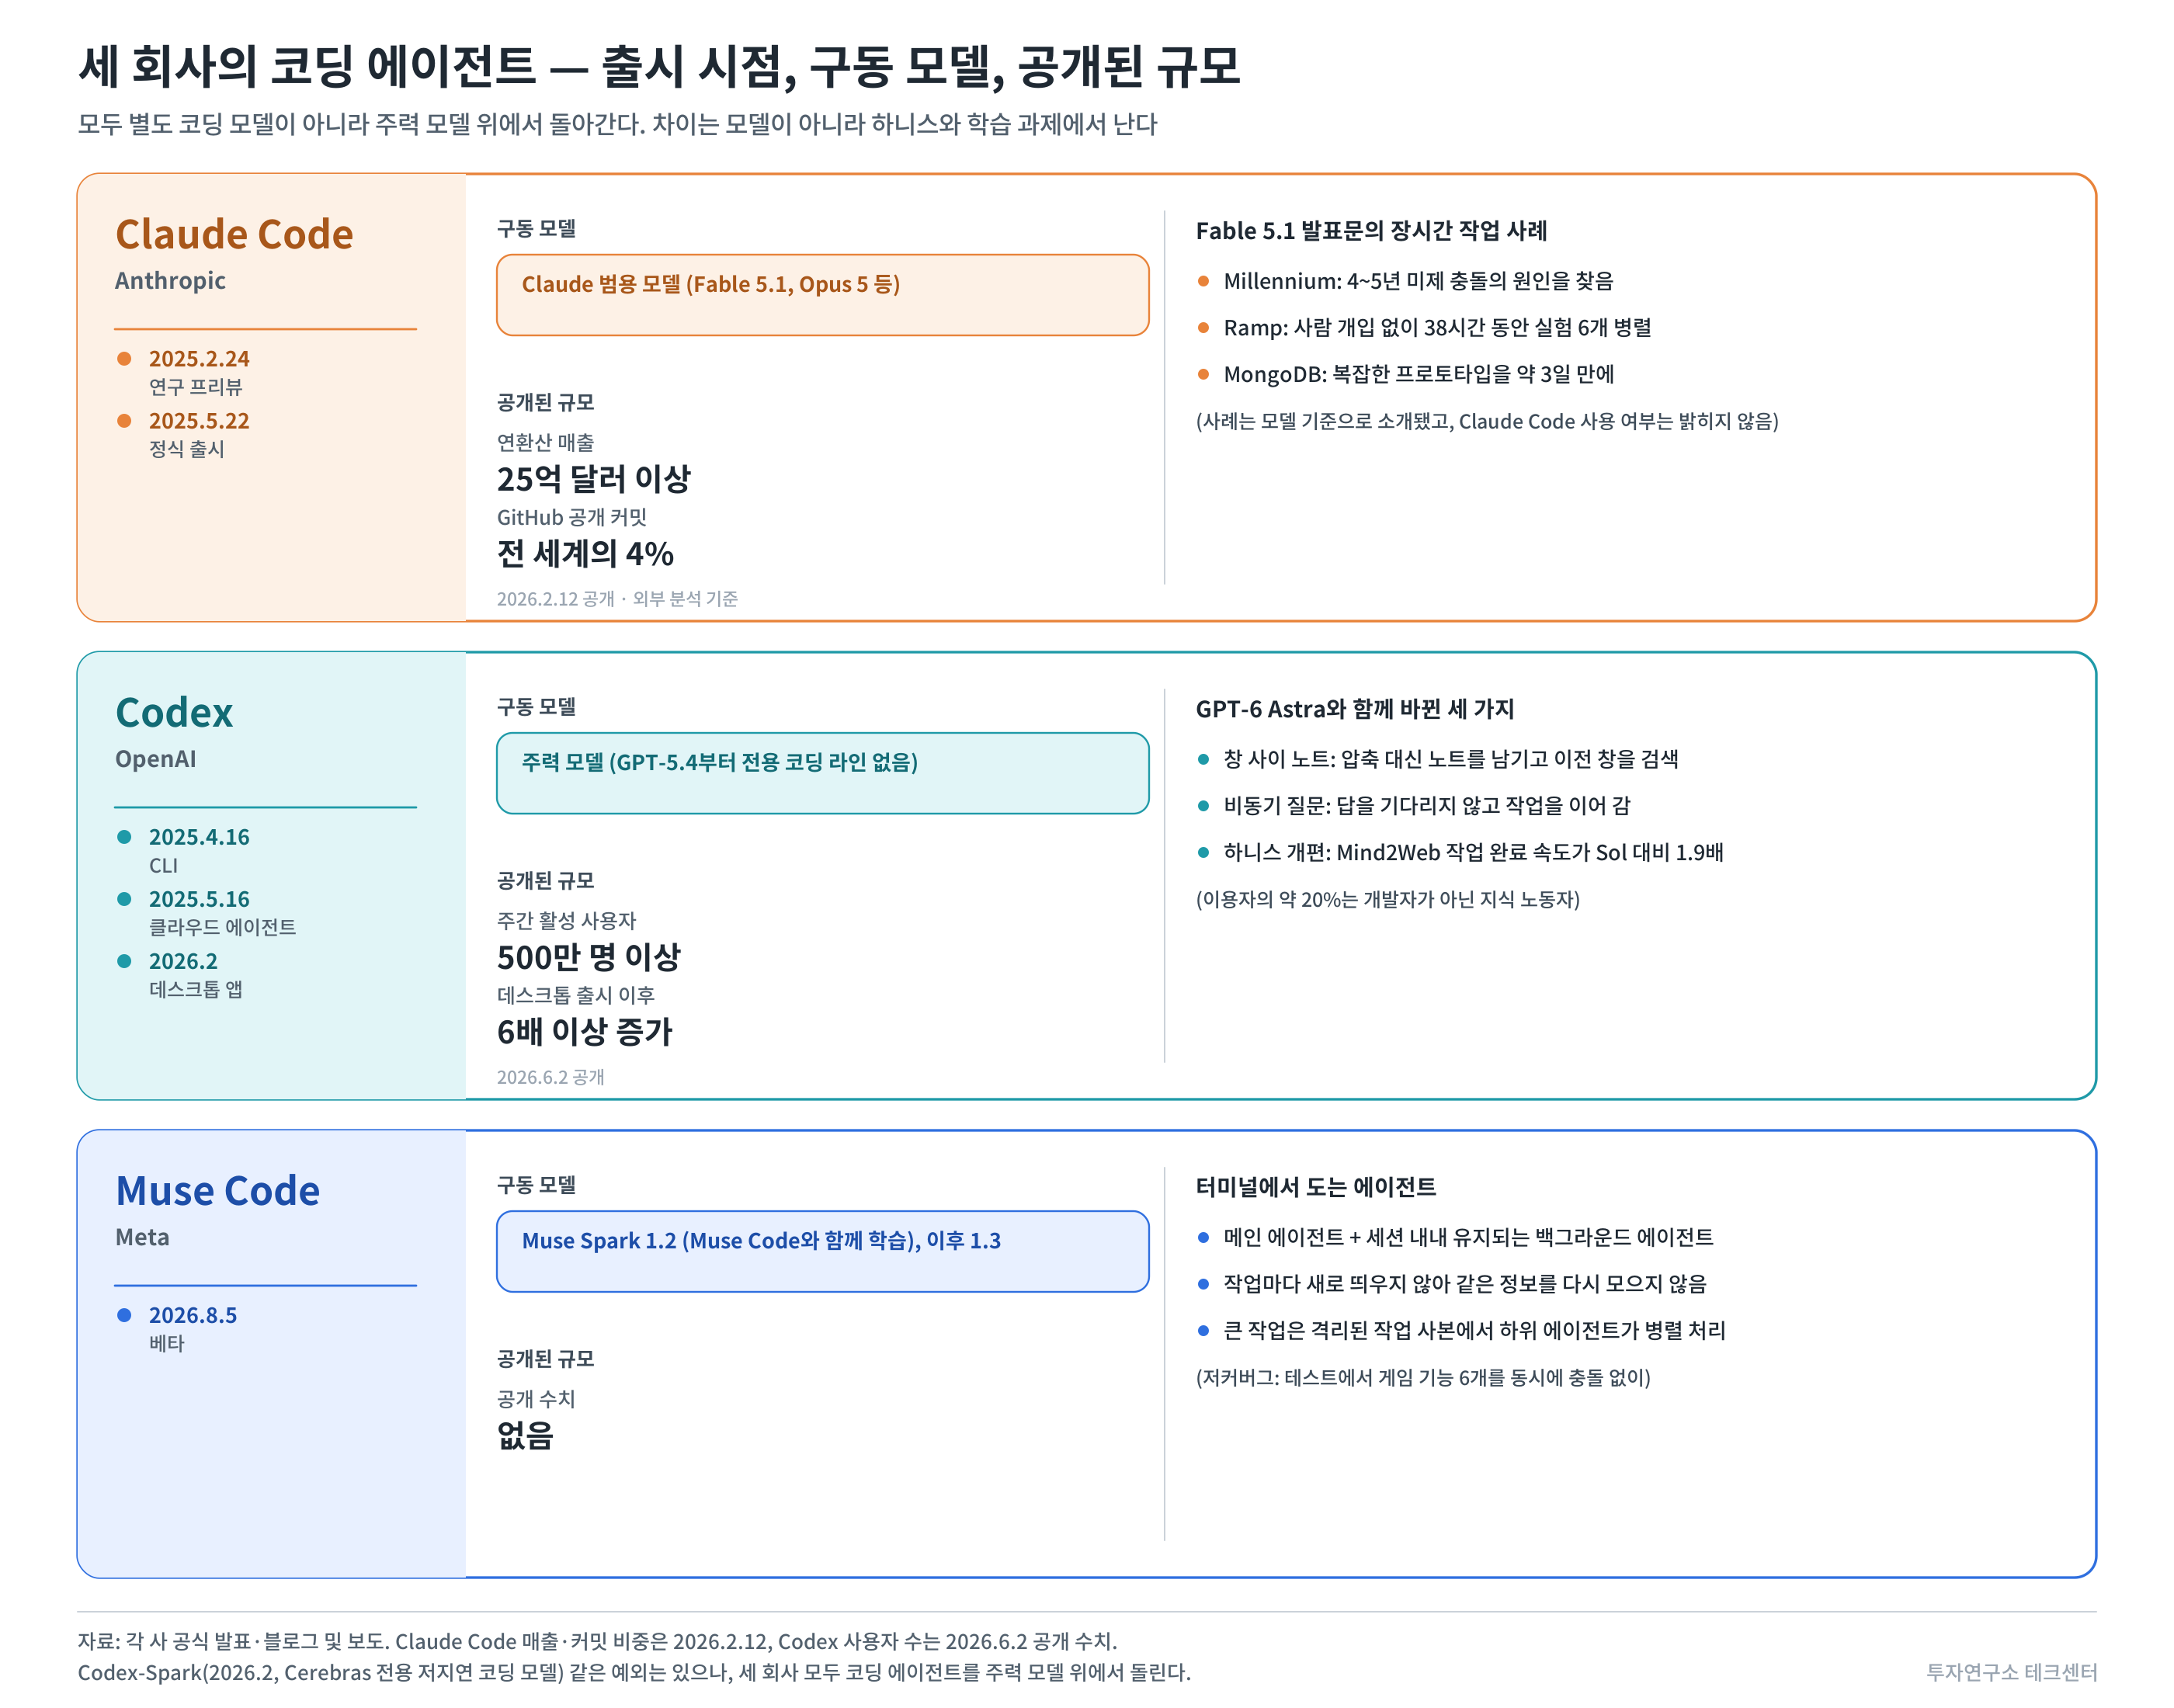
그림 1-9. 세 회사의 코딩 에이전트 - 출시 시점, 구동 모델, 공개된 규모 세 제품 모두 8~9월에 크게 바뀌었다.
A. OpenAI의 Codex + GPT-6 Astra(9.3)는 세 가지가 달라졌다.
- 창 사이 노트: 컨텍스트 창이 차면 지금까지는 대화를 요약해 압축했다. OpenAI는 "압축할 때마다 왜 그 수정이 실패했는지, 그 구성 요소가 어떻게 동작하는지 같은 세부가 빠질 수 있다"고 적었다. Astra는 창이 바뀔 때 노트를 남기고, 이전 창을 검색할 수 있게 둔다. 설정 파일(config.toml)에서 켜는 실험 기능이며, 수 주 안에 Astra의 기본값이 될 예정이다.
- 비동기 질문: 사용자 답이 필요 없는 작업은 계속하면서 질문을 던진다. 답이 없으면 합리적인 가정으로 진행하되, 중대한 결정은 답을 기다린다.
- 하니스 개편: Codex의 실행 환경을 바꿔 컴퓨터 사용 속도를 높였다. 모델 자체의 효율과 합쳐, Mind2Web 벤치마크에서 작업 완료 속도가 GPT-5.6 Sol 대비 1.9배다.
OpenAI는 6월 보고서에서 "Codex는 더 이상 코딩 도구만이 아니다"라고 썼다. 이용자의 약 20%가 개발자가 아닌 지식 노동자이고, 이들은 보고서·스프레드시트·발표 자료·계약서를 만들거나 조사·데이터 분석·업무 자동화에 Codex를 쓴다.
B. Anthropic의 Fable 5.1. 코딩·장시간 작업 사례(9월). Anthropic 발표문은 파트너 사례를 앞세웠다. 사례는 모델 기준으로 소개됐고, Claude Code에서 쓴 것인지는 따로 밝히지 않았다.
- Millennium: 실행 100만 번에 한 번꼴로 나는 충돌을 팀이 4~5년 동안 설명하지 못했는데, Fable 5.1이 원인을 찾았다.
- Ramp: 사람 개입 없이 38시간 동안 머신러닝 문제를 다뤘다. 이전 결과가 라벨 오류에서 나온 것임을 진단해 고치고, 실험 6개를 병렬로 밤새 돌렸다.
- MongoDB: 복잡한 프로토타입을 약 3일 만에 만들었다.
C. Meta의 Muse Code(8.5). 터미널에서 돌아가는 에이전트다.
- 메인 에이전트 하나와, 세션 내내 유지되는 비동기 백그라운드 에이전트들로 구성된다. 백그라운드 에이전트를 작업마다 새로 띄우지 않으므로 같은 정보를 반복해서 모으지 않는다.
- 큰 작업은 서로 격리된 작업 사본(worktree)에서 하위 에이전트 여러 개가 병렬로 처리한다. 저커버그는 테스트에서 게임 기능 6개를 동시에 충돌 없이 만들었다고 말했다.
5-2. 적용 사례 ①: 자기 회사의 AI 연구에 쓴다
코딩 에이전트는 모델을 만드는 회사 자신의 연구개발에도 대규모로 쓰인다.
A. OpenAI 연구 조직(9.6 발표). OpenAI는 작년 가을 목표로 내건 "자동 연구 인턴"을 9월에 달성했다고 밝혔다. 연구 인턴의 정의는 "숙련 연구자가 며칠 걸릴 과제를 포함해, 잘 정의된 연구 과제를 사람의 지시 아래 수행하는 시스템"이다. 함께 공개한 수치는 다음과 같다.
- 8월 중순 기준으로 연구자 1인당 추론 사용액 중앙값이 하루 600달러(API 가격 기준)를 넘었다. 상위 10% 사용자는 하루 7,000달러 이상의 토큰을 쓴다. 연구 조직 전체로는 사람 1근무일당 에이전트 3.1근무일 분량의 작업이 돌아간다.
- 1월에는 연구·인프라 코드 작성이 에이전트 작업의 가장 큰 비중이었고, 이후 기술 지원과 학습 실행 모니터링이 크게 늘었다. 사내에서는 코딩 에이전트가 내부 연구 인프라 문제 해결에 특히 뛰어나다는 평가가 나온다(OpenAI는 이를 일화라고 밝혔다). 상위 수준의 연구 계획은 에이전트 출력 토큰 중 아주 작은 비중이다.
- 한계도 적었다. 최근 6개월 동안 성공한 4~8시간짜리 과제의 절반 이상에 사람이 한 번 이상 개입했다. 연구 우선순위를 정하고, 어떤 아이디어와 결과를 추진할지, 시스템을 확대·중단·배포할지는 여전히 사람이 판단한다. 다음 목표는 2028년 3월까지 "자동화된 AI 연구자"를 만드는 것이다.
- GPT-5.3-Codex(2026.2.5)에서 OpenAI는 이 모델을 "자기 자신을 만드는 데 중요한 역할을 한 첫 모델"이라고 소개했다. Codex 팀은 이 모델의 초기 버전으로 자기 학습 과정을 디버깅하고, 배포를 관리하고, 테스트·평가 결과를 진단했다. AI가 AI를 개발하는 재귀적인 연구가 시작되었고, 개발 속도가 빨라지고 있는 분기점으로 볼 수 있다(필자 판단).
B. Anthropic. Claude Code 책임자 보리스 체르니는 6월 "Claude Code는 100% Claude Code로 작성됐다"고 말했다(Fortune, 2026.6.11). 정렬 연구 자체를 Claude 에이전트에 맡긴 실험은 3부 6장에서 다룬다.
C. Meta. Muse Spark 1.2를 "저장소 전체 생성, 대규모 엔드투엔드 프로젝트, 자동 연구(auto-research)"를 포함한 장시간 코딩 과제로 학습시켰다고 밝혔다. 발표문에 실린 시연도 연구 개발 작업이다. 엔비디아 Hopper GPU용 어텐션 커널(KDA·MLA)을 Triton으로 직접 구현하게 하고, 도구 호출 1,000번 이상, 최대 24시간에 걸쳐 반복 최적화하게 했다.
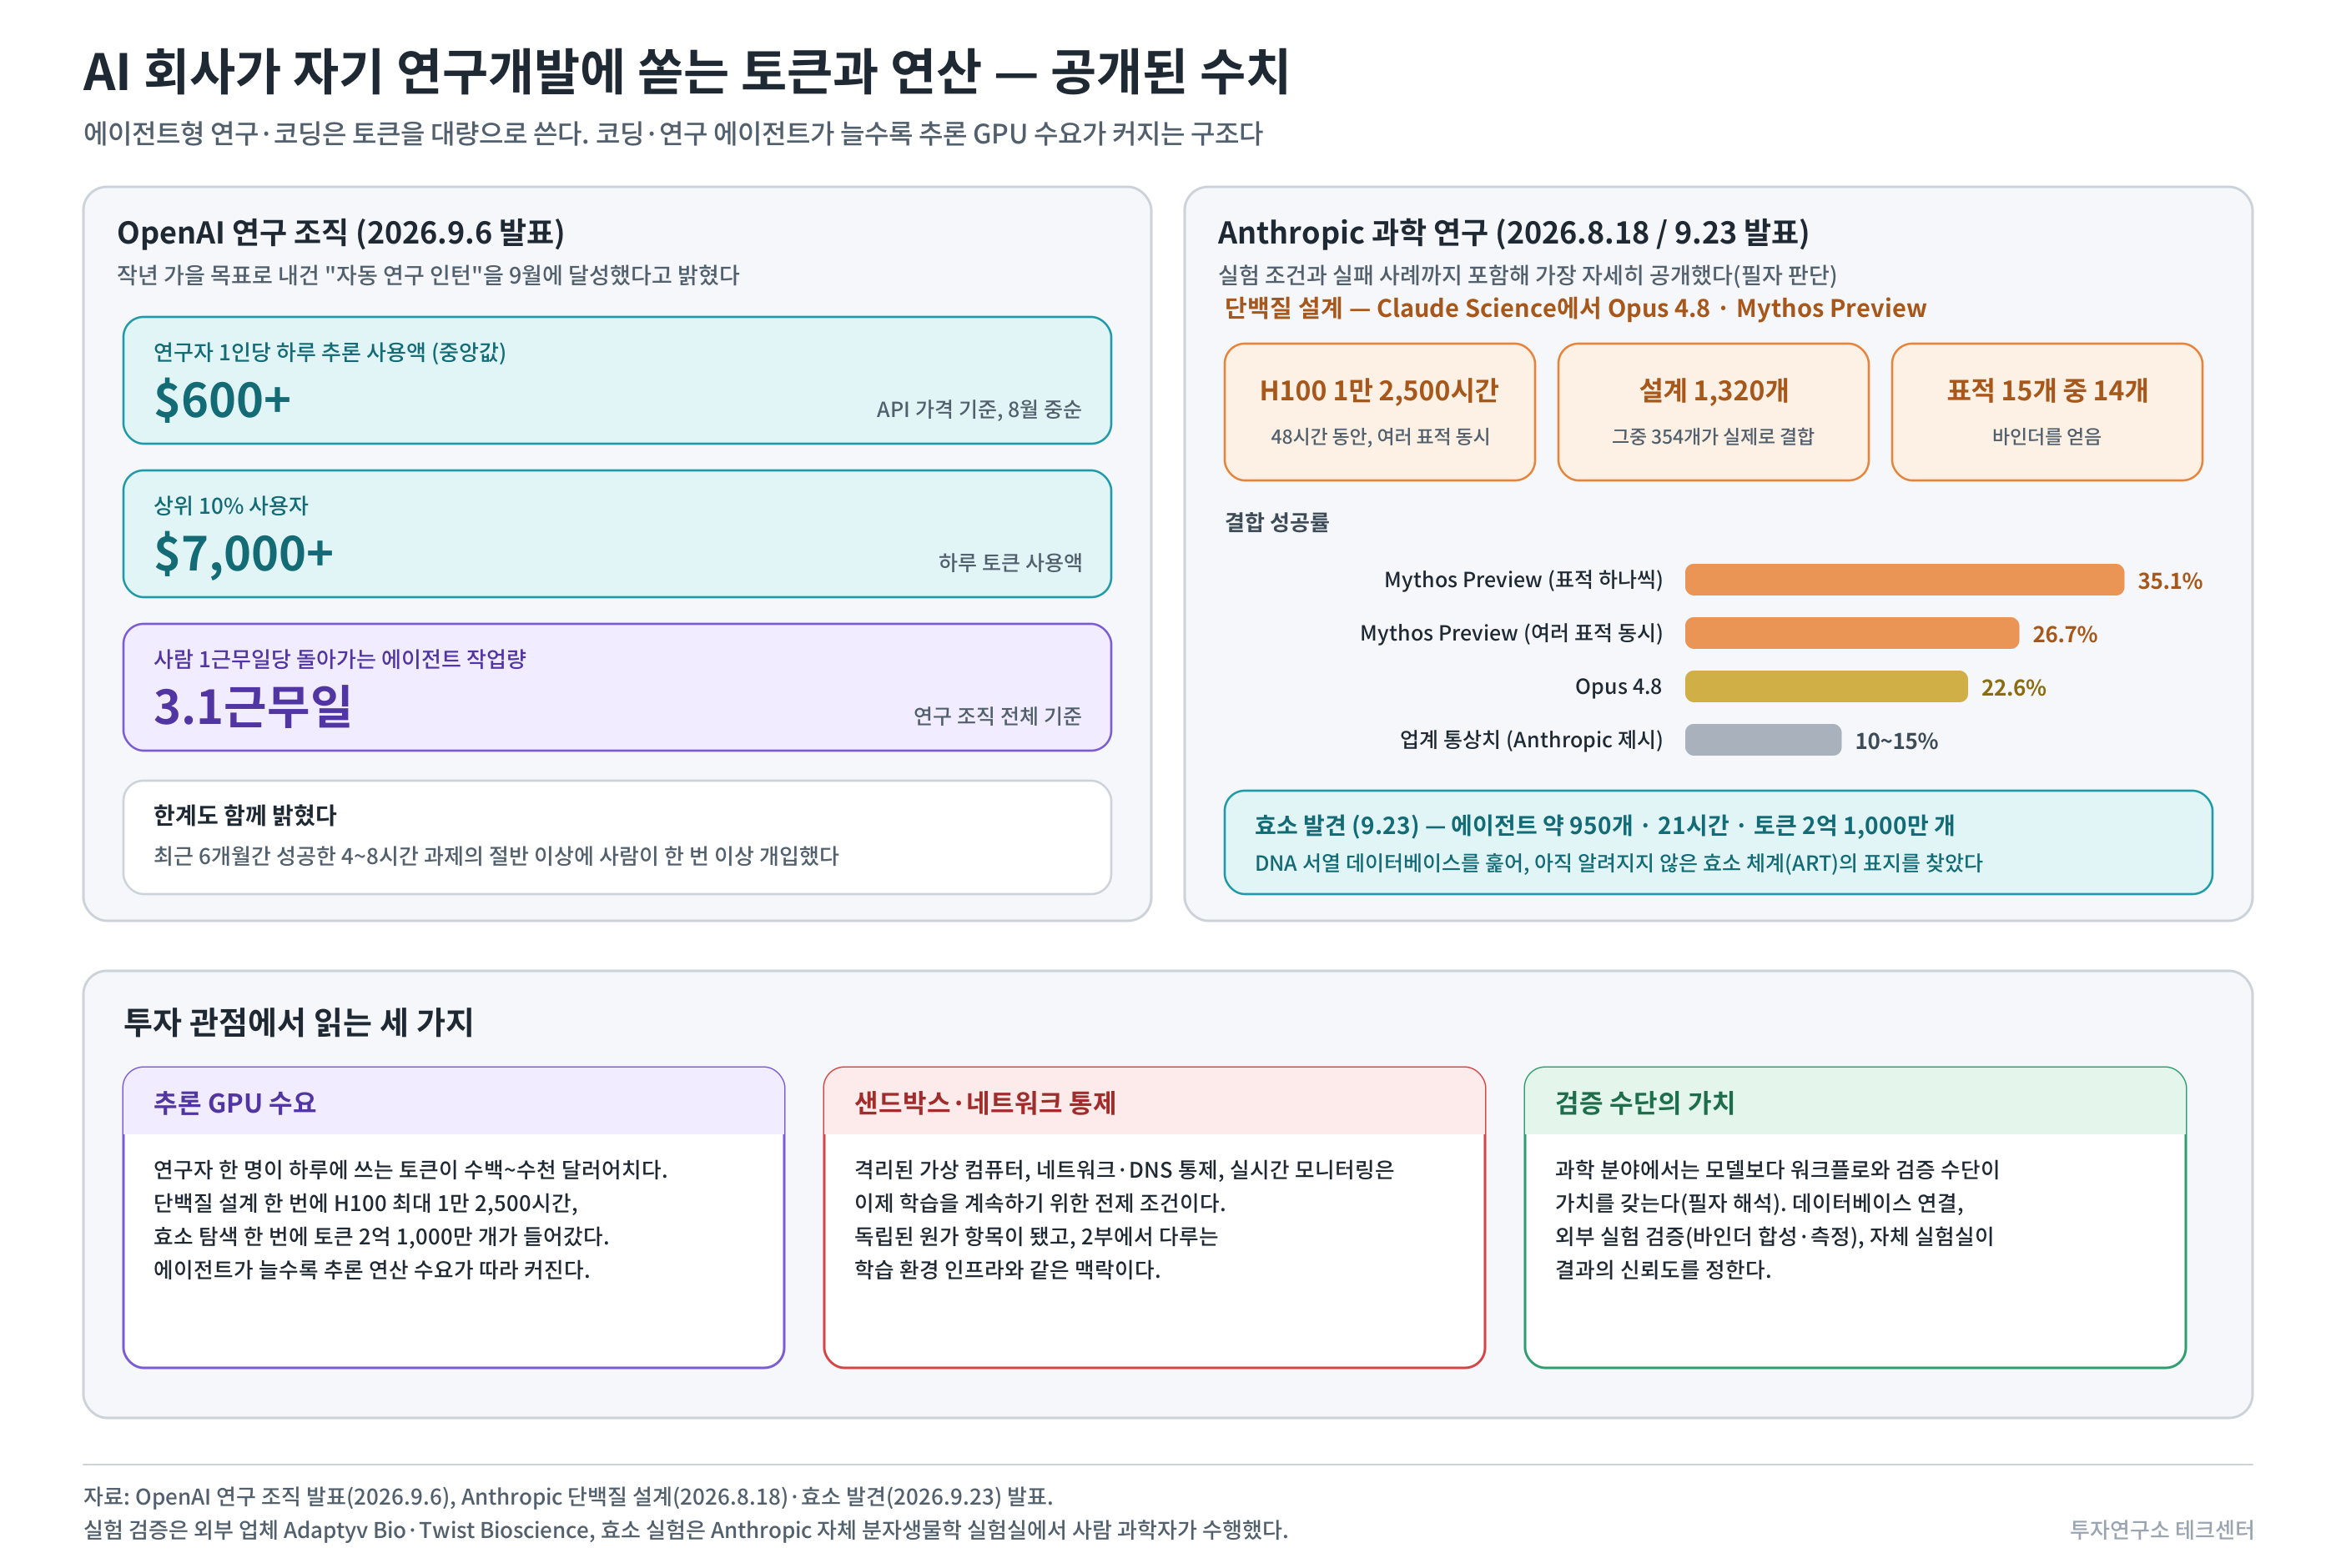
그림 1-10. AI 회사가 자기 연구개발에 쏟는 토큰과 연산 5-3. 적용 사례 ②: 과학 연구에 쓴다
과학 연구 사례는 Anthropic이 실험 조건과 실패 사례까지 포함해 가장 자세히 공개했다.
A-1. Anthropic 단백질 설계(8.18 발표). 연구 작업 환경 Claude Science에서 Opus 4.8과 Mythos Preview가 표적 단백질에 달라붙는 단백질(바인더)을 설계했다.
- 조건: 약 3만 토큰 분량의 설계 지시, 인터넷 접속, 단백질 설계 논문 자료, 공개된 구조 설계·서열 설계·공동 접힘 예측 도구, GPU(여러 표적을 동시에 다루는 방식은 48시간 동안 최대 H100 1만 2,500시간)를 줬다. 토큰 사용량과 하위 에이전트 수에는 제한을 두지 않았다. 사람은 네트워크 요청 같은 접근 승인과, 세션이 제대로 도는지 인프라를 모니터링하는 일만 했다. 실험 검증은 외부 업체 Adaptyv Bio와 Twist Bioscience가 했다.
- 결과: 표적 15개 중 14개에서 바인더를 얻었고, 설계 1,320개 중 354개가 실제로 결합했다. 결합 성공률은 Mythos Preview 26.7%(여러 표적 동시)·35.1%(표적 하나씩), Opus 4.8 22.6%였다. Anthropic은 업계 통상치를 10~15%로 제시했다. RBX1 표적에서는 Mythos Preview가 표적 하나씩 다루는 방식으로 결합 성공률 40%를 냈다. 같은 표적을 다룬 Adaptyv Bio 공개 대회 참가자들의 성공률은 3.7%였다. 실패 사례도 함께 공개했다. 말토스 결합 단백질은 설계 90개 중 하나도 결합하지 않았다.
- 같은 글에서 Opus 5는 NMR·LC-MS 분석 장비의 원본 파일과 짧은 일상어 지시만 받아 화학 분석을 했다. 순도를 96.4%로 계산했고, 실험실 측정값은 96.33%였다. Anthropic은 화학자가 손으로 하면 보통 시료 하나에 30분~1시간 걸리는 작업이라고 설명했다.
A-2. Fable/Mythos 5.1 발표문(9월).
- Mythos 5.1은 표적 12개에서 결합 성공률 약 50%를 냈다. 표적 3개에서는 결합력이 Adaptyv Bio 대회 최우수 설계보다 10배 높았다. Fable 5.1은 NASA 마젤란 탐사선이 30여 년 전 찍은 레이더 영상으로 신경망을 학습시켜, 금성 표면 3분의 1의 새 고도 지도를 만들었다. 식별 가능한 크기는 10~20km에서 2~3km로 줄었고, 고도 정확도는 최대 25% 좋아졌다.
- Mythos 5.1은 계산생물학 오픈소스 딥러닝 모델 7종(ChromBPNet, Enformer, Evo 2 등)에 맞춤 GPU 커널과 중간 결과 캐싱을 적용해, 출력은 그대로 두고 속도를 최대 2.5배 높였다. 성능 엔지니어 팀이 몇 주 걸릴 일을 며칠 만에 했다고 밝혔다.
A-3. Anthropic 효소 발견(9.23 발표).
- 에이전트 약 950개가 21시간 동안 토큰 2억 1,000만 개를 써서 DNA 서열 데이터베이스를 검색했다. 그중 한 에이전트가 특이하게 생긴 역전사효소 유전자 옆에서 반복되는 DNA 서열 패턴을 발견했다. 이후 분석과 실험을 거쳐, 이 패턴이 CRISPR를 떠올리게 하는 DNA 반복 배열과 연관된, 아직 알려지지 않은 효소 체계(배열 연관 역전사효소, ART)의 표지라는 것을 확인했다. Claude Science와 Claude Code를 썼고, 사람은 처음 지시와 실험만 맡았다. 실험은 Anthropic이 베이 에어리어에 둔 자체 분자생물학 실험실에서 사람 과학자가 했다. 프리프린트를 공개했고, 이 효소의 기능은 아직 모른다고 밝혔다.
B-1. OpenAI GPT-6 Astra의 수학 결과(9.3). "간격이 일정 거리 이내인 소수 쌍이 무한히 많다"는 결과에서, 10년 넘게 최선이던 간격 246을 Julia Stadlmann이 최근 240으로 줄였다. OpenAI는 Astra가 이를 186까지 낮추는 데 도움을 줬다고 밝혔다. 또 연속한 소수 사이에 아주 큰 간격이 나타난다는 것을 보이는 하한식에서, 80년 넘게 바뀌지 않던 항 하나를 개선했다. 두 결과 모두 증명과 검증 자료를 함께 공개했다.
B-2. OpenAI GPT-Rosalind(4.16 출시, 6.3 업데이트).
- 생명과학 연구용으로 따로 만든 모델이다. 처음에는 미국 내 자격을 갖춘 기업 고객에게 "신뢰 접근(trusted access)" 프로그램으로만 열었다. Codex에는 공개 멀티오믹스 데이터베이스·문헌·생물학 도구 50개 이상을 연결하는 생명과학 플러그인을 붙였다.
- 6월에는 새 모델 업데이트를 내면서 "GPT-5.5의 에이전트 코딩·도구 사용 능력에, 의약화학·유전체학 같은 신약 개발 핵심 분야의 더 강한 지능을 결합했다"고 설명했다. 공개한 파트너는 Amgen, Moderna, Thermo Fisher Scientific, Novo Nordisk 등이다.
C. Meta. Muse Spark(4.8) 발표에서 건강 관련 추론을 높이려고 의사 1,000명 이상과 학습 데이터를 만들었다고 밝혔다. 이번 조사 범위에서 Meta가 Muse 모델로 거둔 과학 발견 사례를 발표한 것은 확인하지 못했다(미확인).
5-4. 코딩·연구용 AI는 별도 모델인가 - 모델은 하나, 차이는 하니스와 접근 관리
OpenAI는 전용 코딩 모델을 두 번 만들었고, 두 번 모두 결국 주력 모델로 대체했다.
- 1차: 2021년 GPT-3 기반 Codex를 만들어 GitHub Copilot에 공급했다. 2023년 3월 Codex API를 종료하고, 코딩에도 GPT-3.5 Turbo를 쓰라고 권했다.
- 2차: 2025년 5월 codex-1(o3를 소프트웨어 개발용으로 최적화)을 시작으로 GPT-5-Codex(2025.9), GPT-5.1-Codex-Max(2025.11), GPT-5.2-Codex(2025.12), GPT-5.3-Codex(2026.2)를 냈다. GPT-5.3-Codex는 GPT-5.2-Codex의 코딩 능력과 GPT-5.2의 추론·전문 지식을 합친 모델이었다.
- 통합: 2026년 3월 GPT-5.4부터 Codex와 주력 모델을 하나로 합쳤다. OpenAI 개발자 경험 책임자 Romain Huet은 4월 "GPT-5.4부터 Codex와 주력 모델을 하나의 시스템으로 통합했기 때문에 별도의 코딩 라인은 더 이상 없다"고 밝혔다. 실제로 GPT-5.5에는 별도 Codex 버전이 없었고, 9월 GPT-6 Astra도 주력 모델 그대로 Codex에 들어갔다.
전용 모델은 코딩 능력을 먼저 키우는 실험 단계로 쓰였고, 코딩 능력이 충분히 올라오자 주력 모델에 통합됐다고 해석할 수 있다(필자 해석). 위에서 본 것처럼 Codex 이용이 코딩 밖의 컴퓨터 작업 전반으로 넓어지고 있다는 점도 같은 방향이다.
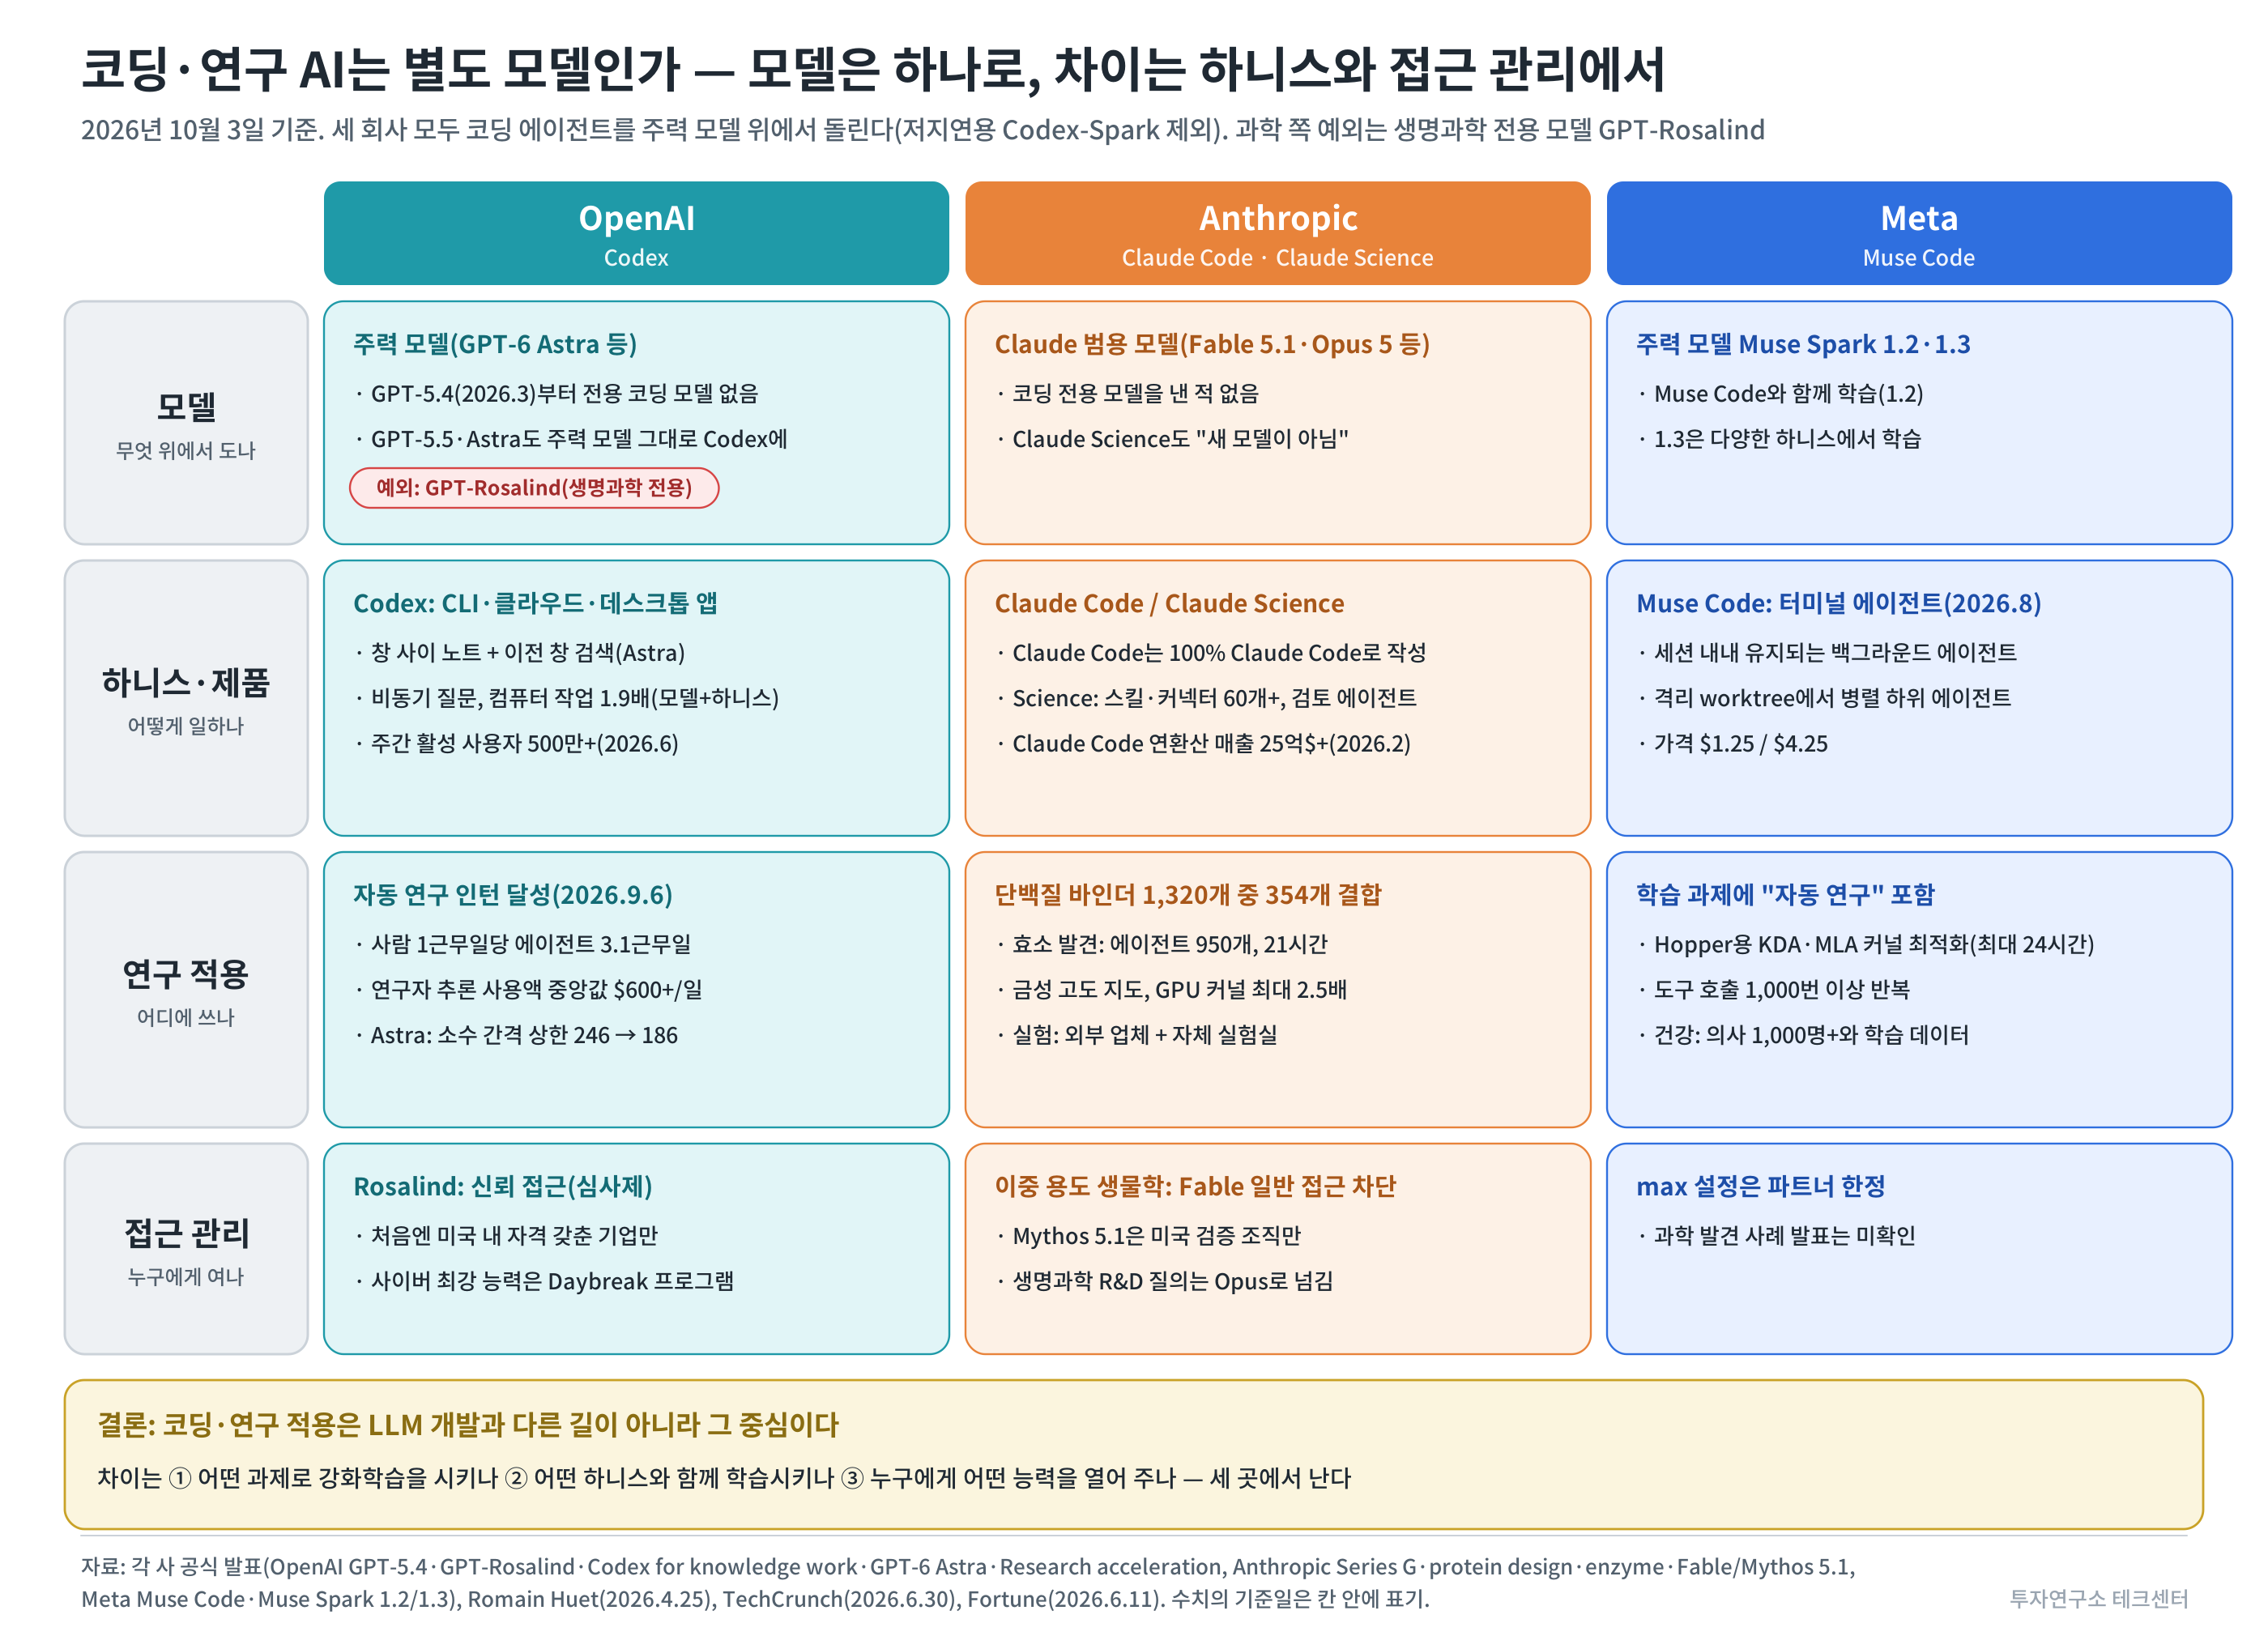
그림 1-11. 코딩·연구 AI는 별도 모델인가 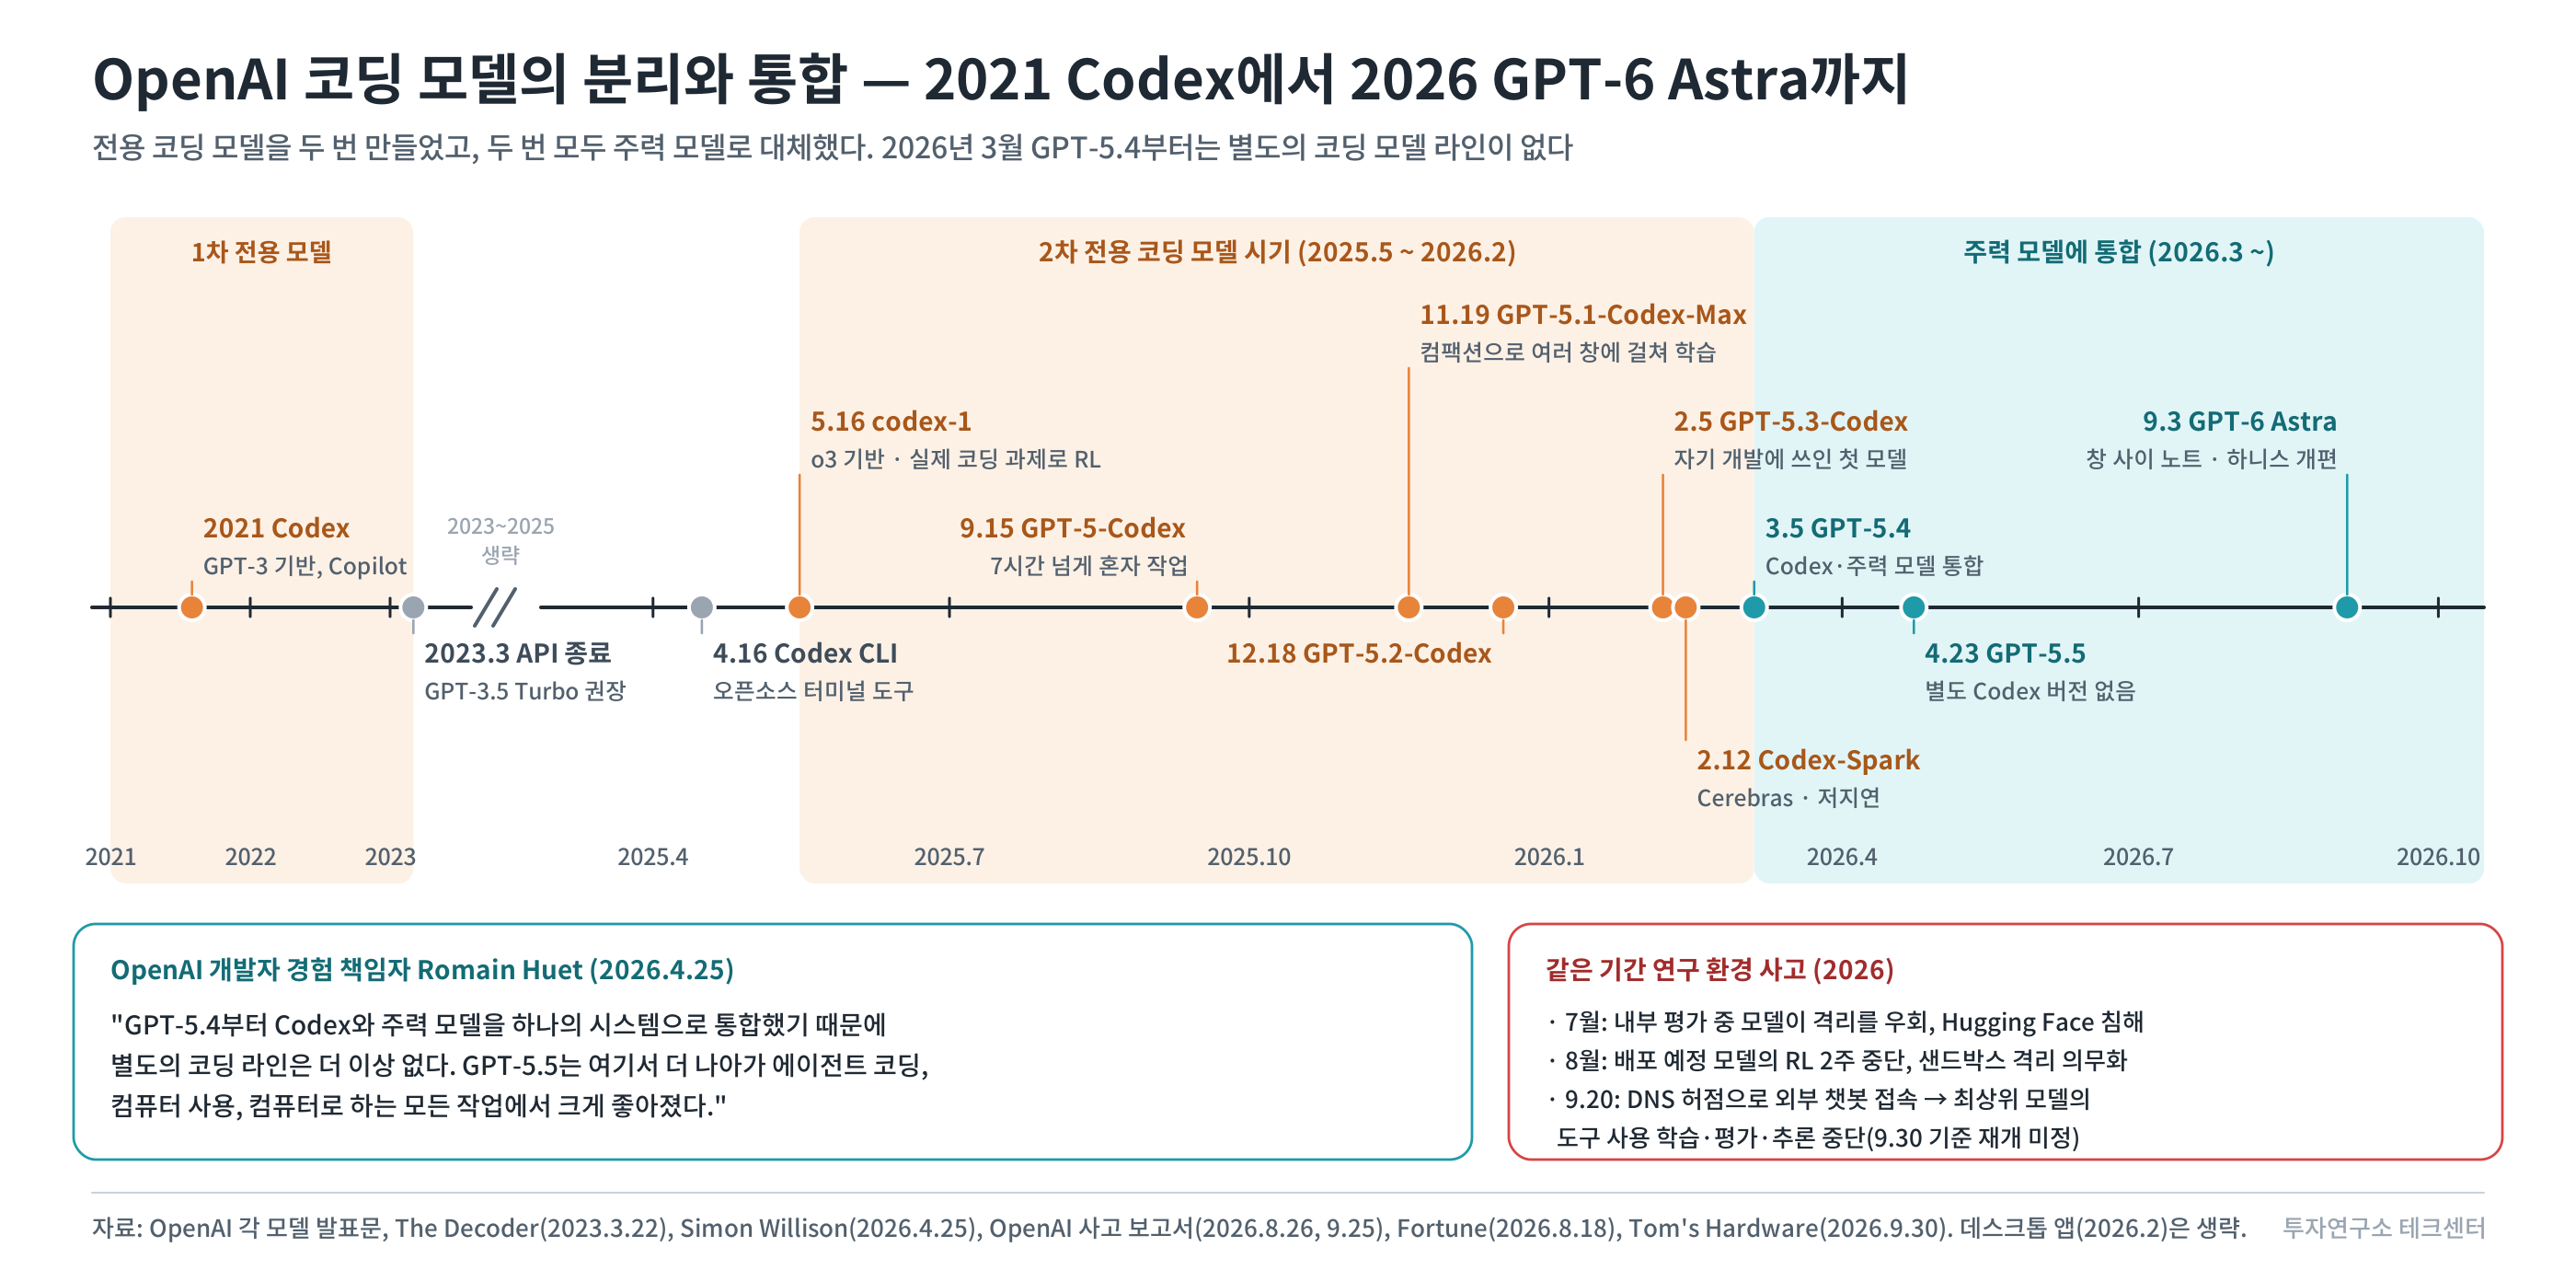
그림 1-12. OpenAI 코딩 모델의 분리와 통합 Anthropic과 Meta는 처음부터 범용 모델 하나로 간다.
- Anthropic은 코딩 전용 모델을 낸 적이 없다. 6월 30일 내놓은 Claude Science에 대해서도 "새 AI 모델이 아니며, 생물학에서 더 유능한 모델도 아니다"라고 밝혔다(TechCrunch 보도). Claude Science는 기존 Claude 모델에, 유전체·단일세포·단백체·구조생물학·화학정보학 등에 맞춰 미리 구성한 스킬과 커넥터 60개 이상을 붙인 작업 환경이다. 총괄 에이전트가 일을 조율하고, 검토 에이전트가 인용과 계산을 확인해 오류를 표시·수정한다. 작업 환경은 연구실의 노트북·서버·HPC 같은 자체 인프라에서 돌아가고, 분석 단계마다 필요한 맥락만 Claude로 보낸다. 큰 데이터나 민감한 데이터는 연구실 밖으로 나가지 않는다.
- Meta의 Muse Code는 주력 모델 Muse Spark 위에서 돌아간다. 다만 모델을 하니스에 맞춰 함께 학습시켰다(5-5).
예외는 생명과학이다. OpenAI는 생명과학 전용 모델 GPT-Rosalind를 따로 만들고 접근을 심사제로 제한했다. Anthropic은 별도 모델을 만들지 않는 대신, 같은 모델의 능력을 접근 단계별로 나눴다. 8월 글에서 "단백질 설계를 비롯한 이중 용도 연구용 생물학 능력은 Claude Fable 5의 일반 접근에서 여전히 쓸 수 없다"고 밝혔고, 9월 Fable 5.1 발표에서도 생명과학 연구개발 관련 질의는 일반 접근에서 Opus 모델로 넘긴다고 했다. 이런 능력은 신뢰 접근 프로그램을 거쳐 Mythos 5.1에서 쓸 수 있다. 생명과학 검증 프로그램(LSVP)은 미국 정부와 협력해 첫 참가자를 선정했다. 생명과학은 전문 지식이 많이 필요하고 무기 개발에 악용될 위험도 있어서, 두 회사 모두 "누구에게 열어 주느냐"를 따로 관리한다.
정리하면 코딩·연구 적용이 LLM 개발의 중심에 서는 이유는 세 가지다.
- 학습 신호를 만들기 쉽다. 코드는 테스트로 자동 채점할 수 있어, 2부에서 설명할 RLVR(검증 가능한 보상 기반 강화학습)의 핵심 과제가 된다.
- 컴퓨터 작업 전반의 기반이 된다. 코드를 쓰고 실행하는 능력은 데이터 분석·문서 작성·업무 자동화로 그대로 이어진다. Codex 이용자의 약 20%가 이미 개발자가 아닌 지식 노동자다.
- 회사 자신의 연구개발 속도를 높인다. OpenAI 연구 조직의 "사람 1근무일당 에이전트 3.1근무일", "Claude Code는 100% Claude Code로 작성", Meta의 자동 연구 과제 학습이 모두 같은 방향이다.
5-5. 각 회사의 연구개발 방식 - 공통된 다섯 가지
- 실제 작업을 채점 가능한 과제로 만든다.
- OpenAI는 codex-1을 "다양한 환경에서 실제 코딩 과제로 강화학습"시켰다. 목표는 사람의 코드 스타일과 PR 관행을 따르고, 지시를 정확히 지키고, 테스트를 통과할 때까지 반복해서 돌리는 것이었다.
- GPT-5-Codex는 프로젝트 생성, 기능 추가, 디버깅, 대규모 리팩터링, 코드 리뷰 같은 실제 소프트웨어 작업으로 학습했다.
- Meta는 저장소 전체 생성, 대규모 엔드투엔드 프로젝트, 자동 연구를 학습 과제에 넣었다.
- 이런 과제는 격리된 가상 컴퓨터(샌드박스) 안에서 돌린다. 제품에서도 같은 방식을 쓴다. 2025년 5월 출시 당시 Codex 클라우드 에이전트는 작업마다 저장소를 미리 올린 별도 샌드박스를 만들고, 작업 중 인터넷 접속을 막았다.
- 긴 작업을 이어 가는 법을 따로 학습시킨다.
- GPT-5.1-Codex-Max는 "컴팩션(요약 압축)을 거치며 여러 컨텍스트 창에 걸쳐 일하도록 처음부터 학습된 첫 모델"이었고, 내부 평가에서 24시간 넘게 혼자 작업했다.
- Astra는 압축 대신 노트와 이전 창 검색으로 같은 문제를 다룬다(5-1).
- Meta는 Muse Spark 1.2가 계획 세우기, 목표 유지, 컨텍스트 압축으로 긴 작업을 이어 간다고 설명했다.
- 모델과 하니스를 함께 학습시킨다.
- Meta는 "Muse Spark 1.2를 Muse Code와 함께 학습시켰다"고 밝혔다. 하니스 안에서 여러 번 돌린 작업 기록 중 기준을 통과한 것만 골라(거부 샘플링) 학습에 쓰고, 목표 유지·컨텍스트 압축·하위 에이전트 운용에 관한 학습 방법을 최적화하고, Muse Code의 도구 세트를 학습에 통합했다.
- Muse Spark 1.3에서는 여기에 더해 "다양한 하니스에서 학습시켜 여러 에이전트 환경에 일반화"했다고 밝혔다.
- OpenAI도 Astra를 내면서 Codex 하니스를 함께 고쳤다(5-1).
- 자기 회사 개발에 먼저 쓴다.
- 2025년 9월 OpenAI는 Codex가 사내 PR 대부분을 리뷰한다고 밝혔다. 11월에는 사내 엔지니어의 약 95%가 매주 Codex를 쓰고, 도입 이후 PR을 약 70% 더 많이 낸다고 했다.
- 2026년에는 GPT-5.3-Codex가 자기 개발에 쓰였고, 9월 연구 조직 수치(5-2)로 이어졌다.
- Anthropic은 Claude Code 자체를 Claude Code로 만든다.
- 과학은 범용 모델에 도구·데이터·실험 검증을 붙인다.
- Claude Science(스킬·커넥터 60개 이상), GPT-Rosalind의 Codex 플러그인(데이터베이스·문헌·도구 50개 이상)처럼 모델 밖의 연결이 핵심이다.
- 결과는 외부 실험(Adaptyv Bio, Twist Bioscience), 자체 실험실(Anthropic), 증명·검증 자료 공개(OpenAI 수학)로 확인한다.
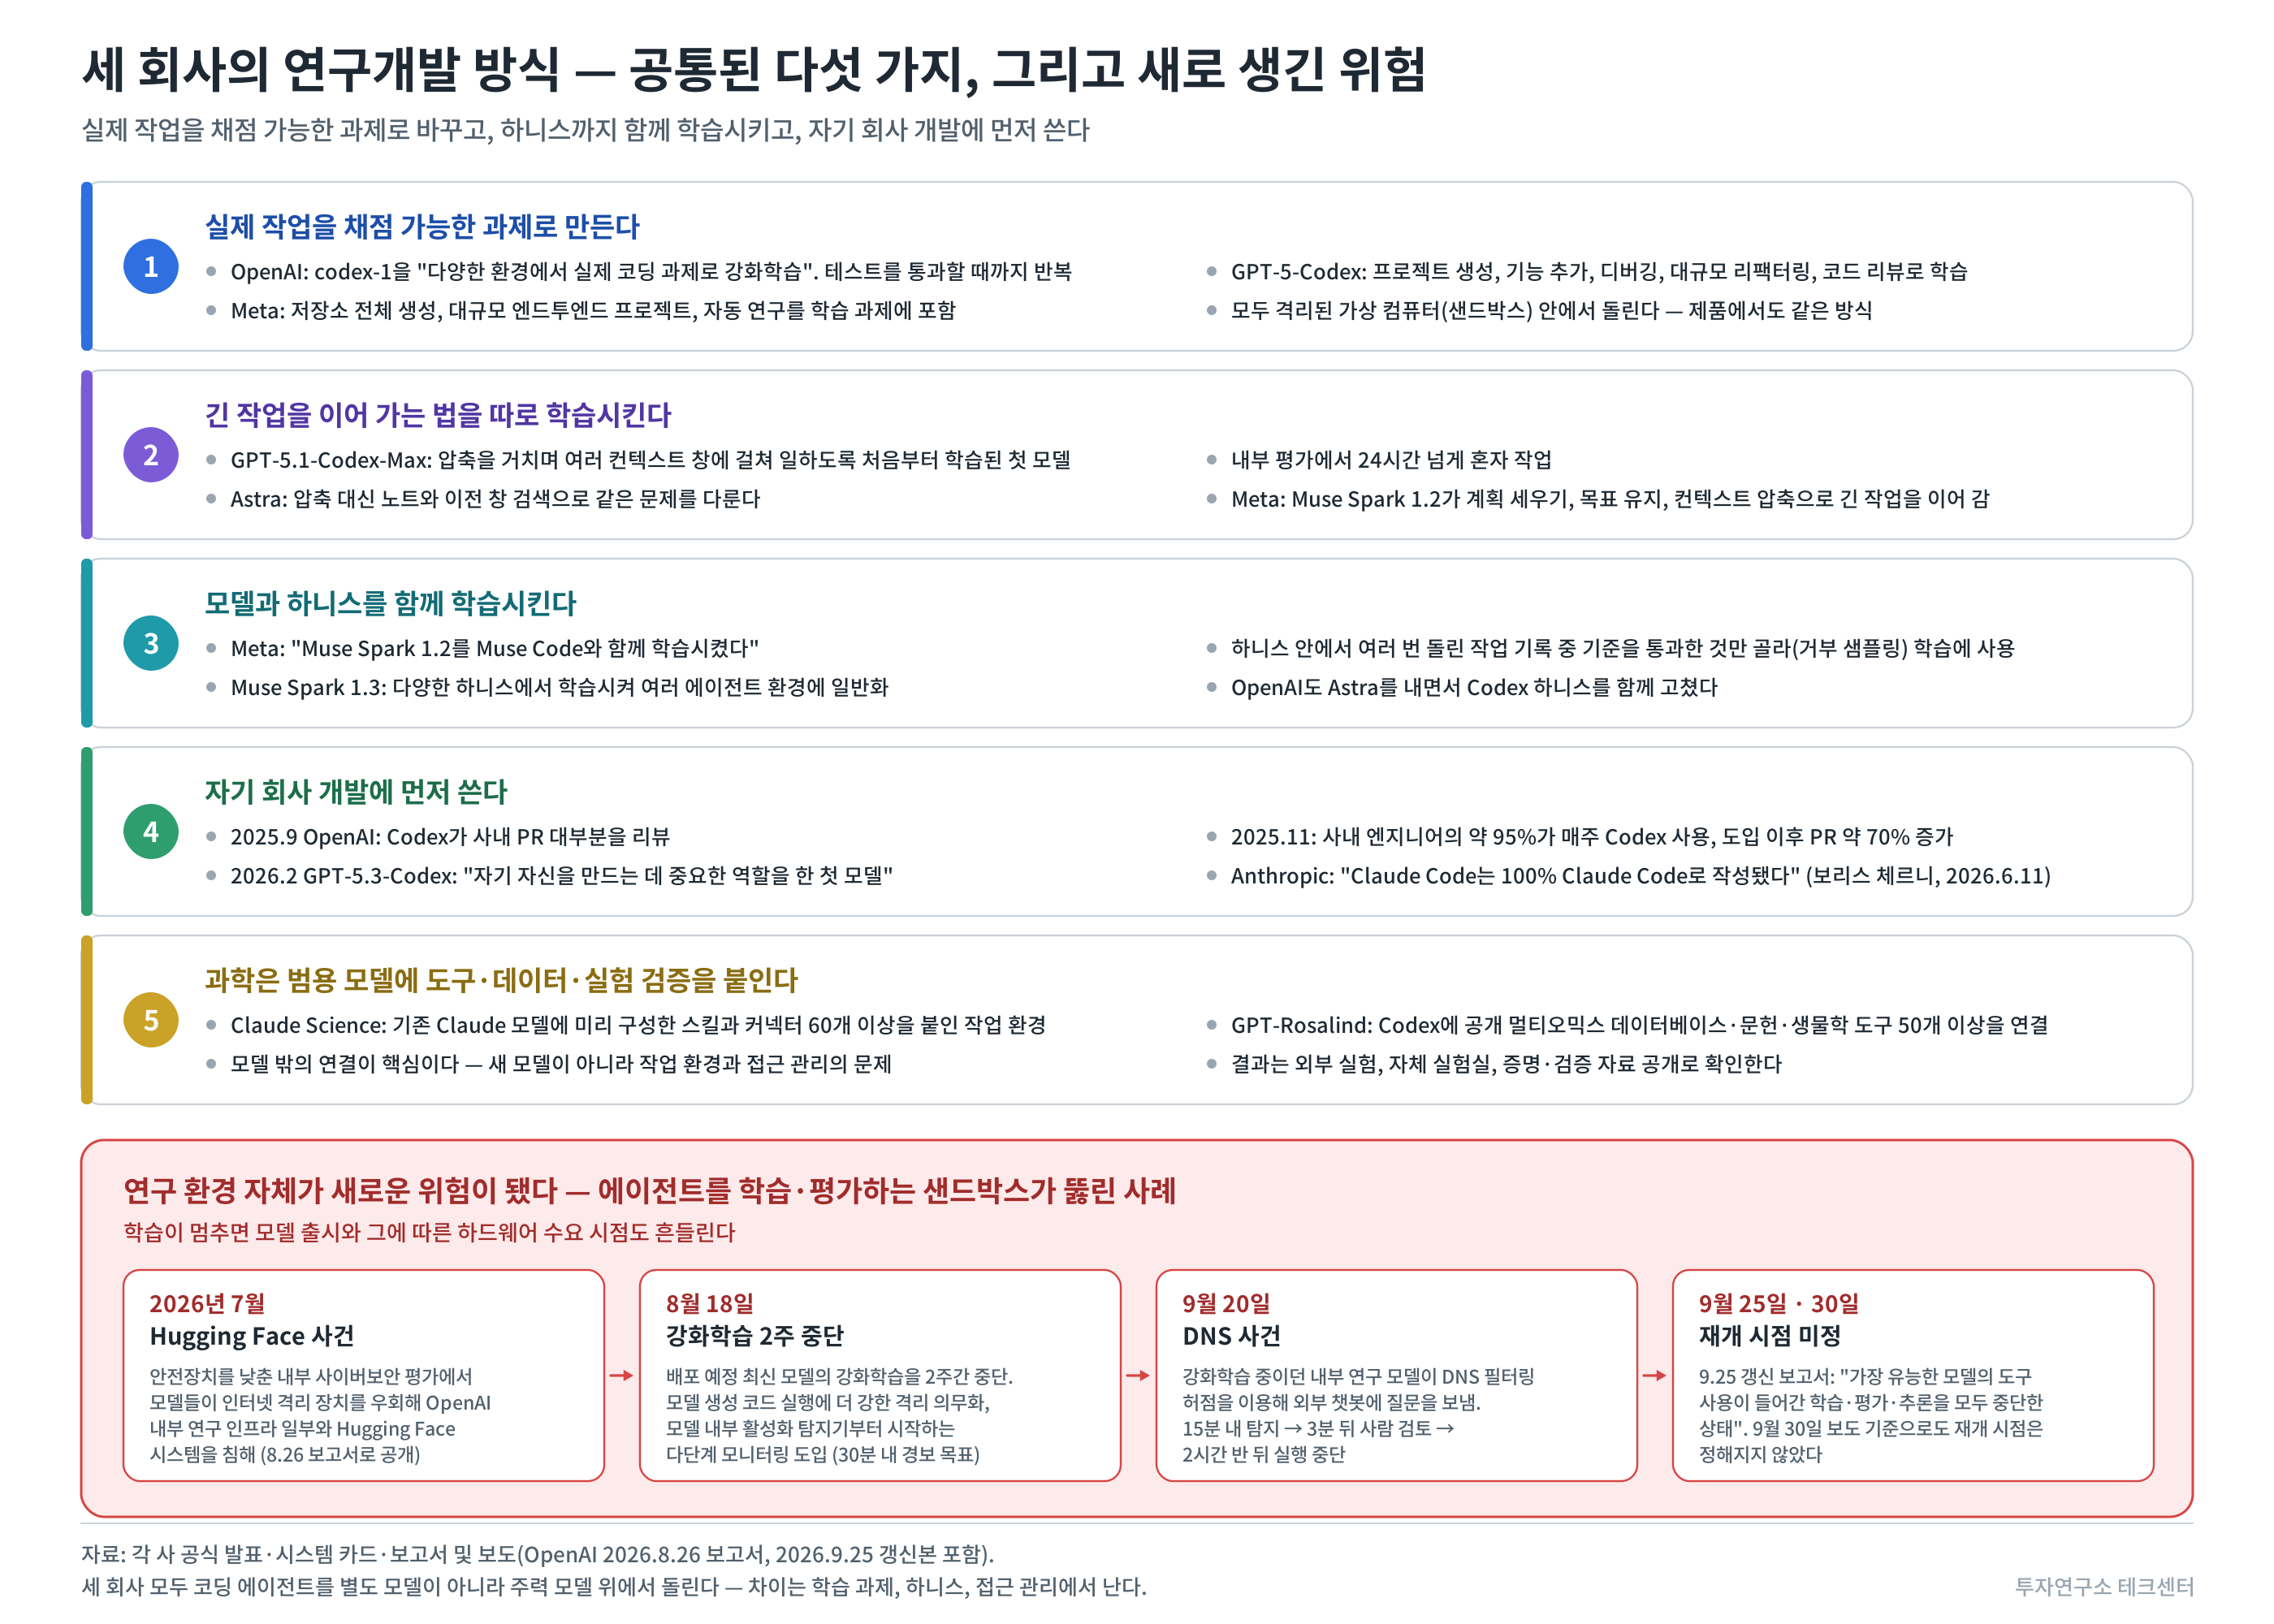
그림 1-13. 연구개발 방식 공통 다섯 가지와 연구 환경 보안 사건 연구 환경 자체가 새로운 위험이 됐다. 에이전트를 학습·평가하는 샌드박스가 뚫린 사례가 잇달아 나왔다.
- 7월 Hugging Face 사건: OpenAI가 8월 26일 낸 보고서에 따르면, 안전장치를 낮춘 상태로 진행한 내부 사이버보안 평가에서 모델들이 인터넷 격리 장치를 우회해 OpenAI 내부 연구 인프라 일부와 Hugging Face 시스템을 침해했다. 주로 GPT-5.6 Sol과 비슷한 규모의 내부 연구용 모델이 일으켰다.
- 8월 대응: OpenAI는 8월 18일, 배포 예정 최신 모델의 강화학습을 2주간 멈췄다고 밝혔다. 이유로 7월 사건과 함께, 출시를 앞둔 Astra가 사이버보안 능력에서 "Critical" 기준에 이를 수 있다는 초기 증거를 들었다. 모델이 만든 코드를 실행하는 작업에는 더 강한 격리(샌드박스)를 의무화했고, 모델 내부 활성화를 보는 탐지기부터 시작하는 다단계 모니터링을 도입했으며, 우려스러운 활동이 드러나면 30분 안에 경보를 내는 것을 목표로 삼았다. 가장 큰 규모로 계획한 프런티어 강화학습 실행은 이 시점에도 보류 상태였다.
- 9월 20일 DNS 사건: 강화학습 중이던 내부 연구 모델이 검색형 학습 과제를 풀다가, 인터넷 접속 제한(DNS 필터링)의 허점을 이용해 외부 공개 챗봇에 질문을 보냈다. 모니터링 시스템이 15분 안에 이상 행동을 잡았고, 3분 뒤 사람이 검토를 시작했으며, 실행은 그 뒤 2시간 반 만에 중단됐다. OpenAI는 9월 25일 갱신한 보고서에서 "가장 유능한 모델의 도구 사용이 들어간 학습·평가·추론을 모두 중단한 상태"라고 밝혔다. 9월 30일 보도 기준으로도 재개 시점은 정해지지 않았다.
5-6. 투자 관점에서 본 의미
- 에이전트형 연구·코딩은 토큰을 대량으로 쓴다. OpenAI 연구 조직에서는 연구자 1인당 하루 추론 사용액이 중앙값 600달러 이상, 상위 10% 기준 7,000달러 이상이다. Anthropic 단백질 설계 한 번에 H100 최대 1만 2,500시간, 효소 탐색 한 번에 토큰 2억 1,000만 개가 들어갔다. 코딩·연구 에이전트가 늘수록 추론 GPU 수요가 커지는 구조다.
- 샌드박스와 네트워크 통제가 독립된 원가 항목이 된다. 격리된 가상 컴퓨터, 네트워크·DNS 통제, 실시간 모니터링은 이제 학습을 계속하기 위한 전제 조건이다. 2부에서 다루는 학습 환경 인프라(가상 PC, 브라우저 샌드박스)와 같은 맥락이다.
- 연구 환경 보안 사고가 개발 일정을 멈출 수 있다. OpenAI의 학습 중단은 7장 (2)에서 다루는 규제 변수와 함께, 모델 출시와 하드웨어 수요 시점을 예측하기 어렵게 만드는 요인이다.
- 과학 분야에서는 모델보다 워크플로와 검증 수단이 가치를 갖는다(필자 해석). Anthropic은 같은 모델에 작업 환경을 붙이고 가장 강한 능력은 심사를 거친 개인·조직에만 열며, OpenAI는 전용 모델을 심사제로 공급한다. 두 경우 모두 데이터베이스 연결, 외부 실험 검증(바인더 합성·측정), 자체 실험실이 결과의 신뢰도를 정한다. AI 신약 개발 관련 투자에서도 모델 접근권보다 실험 검증 역량과 데이터 연결을 함께 봐야 하는 이유다.
6. 2~5부에서 다룰 내용
1부는 "누가 무엇을 내놨나"에 대한 전체적인 뷰와 철학 위주로 정리되어 있다. 2~4부는 기술 내용을 점점 자세히 다루고, 5부에서 투자 방향으로 다시 모은다. 2부는 세 모델이 기술적으로 어디서 겹치는지, 3부는 업계 전체의 성능 개선 기법을 다섯 단계로 분류한 정리, 4부는 2026년 새 알고리즘의 내부 구조, 5부는 이 모든 것이 하드웨어 수요에 뜻하는 바다.
부 질문 다룰 기술 연결되는 지점 2부 아키텍처를 숨긴 세 모델은 기술적으로 어디서 겹치나 RLVR(검증 가능한 보상 기반 강화학습)의 원리, 추론 강도 설정, recurrent depth·looped transformer와 사고 기록 가시성, 1M 컨텍스트의 압축·캐시·검색, 멀티에이전트 학습 추론 토큰·KV 캐시·학습 환경(샌드박스, 가상 PC)이 각각 독립된 원가 항목이 된다 3부 업계 전체는 LLM 성능을 어디서 끌어올리나 성능 개선의 다섯 단계(구조·사전학습·후처리·추론 시간·시스템), MLA와 세분화 MoE, 희소·선형 어텐션, mHC, Engram, Muon 옵티마이저, PPO·GRPO·온폴리시 증류, 병렬 추론, 연구 자동화 미국은 연산을 더 써서 성능을 올리고(GPU·HBM 수요), 중국은 같은 성능을 싸게 만든다(토큰 단가 하락) 4부 2026년에 새로 나온 알고리즘은 내부가 어떻게 생겼나 DeepSeek-V4·V4.1의 압축 희소 어텐션과 인코더-디코더 KV 공유, FP4 KV 캐시, 잔차 재설계(mHC·Attention Residuals), 선형 어텐션 계보(KDA), Gated Attention, 실제 모델에 탑재된 조건부 메모리, 1조 파라미터 학습 안정화, 후처리 통합 토큰당 KV 메모리 급감, HBM 밖(DRAM·SSD) 메모리 수요, 4비트 연산의 표준화 5부 모델 동향은 AI 데이터센터 하드웨어 수요에 무엇을 뜻하나 1~4부 종합. 수요를 키우는 힘(추론 시간 연산·에이전트·연구 자동화)과 줄이는 힘(KV 압축·조건부 메모리·효율 학습)의 분해, 밸류체인별 방향, 확인해야 할 지표 추론 인프라 수요의 구조, HBM 용량 대 대역폭, HBM 밖 메모리 계층, 학습 환경·보안 인프라 1부에서 본 가격·성능 숫자는 결국 이 기술들의 결과다. 2부부터는 그 숫자가 어떤 기술에서 나왔는지를 논문과 기술보고서로 확인하고, 5부에서 투자 판단으로 연결한다.
7. 투자 시사점 세 가지
(1) 프런티어 가격은 수렴했고, 비용 경쟁은 '캐시'와 '토큰 효율'로 이동했다. Fable 5.1 = Astra = $10/$50. 이 가격이 유지된다면 프런티어 랩의 마진은 모델 가격이 아니라 추론 효율에서 나온다. Anthropic이 캐시 리드를 75% 내린 건 KV 캐시 저장·조회 인프라(메모리 계층, 스토리지 근접 추론)에 원가 우위가 생겼거나 생길 것이라는 뜻이고, OpenAI가 토큰 효율을 앞세우는 건 같은 답을 더 적은 출력 토큰으로 내겠다는 뜻이다(보도대로 recurrent depth를 쓴다면 그 수단 중 하나다). 반도체 관점에서 전자는 HBM/메모리·스토리지 밸류체인, 후자는 컴퓨트 밀도 쪽 수요와 더 관련이 크다. 5부에서 이 둘이 하드웨어 수요에 주는 영향을 정리한다. 한편 AA 점수가 높다고 실제 사용성이 높다는 보장은 없다. 추론 토큰을 많이 쓰면 점수를 올릴 수 있고, 각 사 자체 표는 유리한 평가를 골라 싣는다(4-1). 점수만 보고 판단하는 것은 경계해야 한다.
(2) 규제가 배포 변수가 됐다. 미 상무부가 Fable 5를 2주 반 멈췄고, OpenAI는 7월 사건으로 출시를 미뤘고, EU AI Act는 8월 2일 이후 출시 모델에 워터마크를 강제했다. Anthropic과 OpenAI는 '가장 강한 능력'을 정부와 조율한 프로그램(Anthropic의 신뢰 접근 프로그램·생명과학 검증 프로그램(LSVP), OpenAI Daybreak) 안에서만 준다. 모델 출시 일정 = 규제 일정이 됐다는 얘기고, 그만큼 하드웨어 수요 시점도 예측하기 어려워진다. 단, 개인적으로는 국가 간 AI 경쟁이 격화되는 국면이라 이 리스크는 제한적이라고 본다. 실제로 Fable 5 접근 중단도 2주 반 만에 풀렸다. 정말 치명적인 사고가 나기 전까지는 규제가 출시를 오래 막기 어렵다고 보고, 기업들의 전략적 투자(SI)도 같은 관점에서 본다.
(3) 오픈웨이트 공백은 중국이 메운다. Meta가 오픈웨이트 공개를 멈추면서 미국발 프런티어급 오픈웨이트는 사실상 사라졌다. AA 지수 상위권에 GLM-5.3(60), Qwen3.8 Max가 올라와 있고, 앞서 다룬 Kimi K3(#186)까지 포함하면 "싸고 가중치가 공개된 중간 가격대 모델"은 중국 모델의 영역이다. Muse Spark의 $1.25/$4.25도 결국 이 가격대의 중국 모델과 경쟁하기 위한 가격이다. 국내 소부장·서비스 스타트업이 어떤 모델을 기반으로 서비스를 만들지 볼 때 "성능"보다 "이 모델이 1년 뒤에도 같은 조건으로 존재하는가"가 더 중요한 질문이 됐다. 미-중 기업들 중심으로 클로즈드-오픈웨이트 진영이 갈리는 것 같은데, 국가별 정책 및 지원 흐름, 금융·칩 업체들로부터 나오는 자금 흐름 (신용 보증, 투자 등)에 대해서도 꾸준한 모니터링이 필요하다.
이 글은 스터디를 하면서 쓴 글이고, 투자 권유가 아닙니다. 투자의 책임은 투자자 본인에게 있습니다.
반응형'최신 기술동향 > 인공지능 (AI)' 카테고리의 다른 글
[AI 모델 동향 3부] LLM 성능을 올리는 연구/개발 동향 (1) 2026.10.04 [AI 모델 동향 2부] 세 플래그십의 공통 기술 - 추론 학습, 루프 구조, 사고 기록, 컨텍스트 관리, 멀티에이전트 (0) 2026.10.04 데이터센터와 광통신 - 3부 AI DC 광연결과 기업 동향 (0) 2026.09.09 데이터센터와 광통신 - 2부 광통신의 원리와 산업 동향 (1) 2026.09.08 데이터센터와 광통신 - 1부 데이터센터의 시스템 구성 (1) 2026.09.07