-
[AI 모델 동향 3부] LLM 성능을 올리는 연구/개발 동향최신 기술동향/인공지능 (AI) 2026. 10. 4. 21:00
프런티어 LLM 회사들은 모두 "더 좋은 모델"을 만들고 있지만, 성능을 끌어올리는 지점은 서로 다르다. 기본 구조(디코더 트랜스포머 + MoE, 검증 가능한 보상 기반 강화학습, 사고 모드, 도구 사용)는 이미 같아졌다. 차이는 그 위에서 어느 단계에 연산과 연구 역량을 집중하느냐에서 갈린다. 미국 연구소는 학습 후반·추론·에이전트 쪽(③④⑤)에 연산을 더 쓰는 방향으로 차별화하고, 중국 연구소는 같은 성능을 더 싸게 내는 구조·옵티마이저(①②)를 논문과 오픈웨이트로 공개하며 차별화한다. 1부(#207)가 세 회사의 철학을, 2부가 세 플래그십의 공통 기술을 다뤘다면, 3부는 시야를 프런티어 연구소 전체로 넓혀 "성능이 어디에서 오르는가"를 단계별로 정리한다.
시리즈 구성: 1부 AI 모델 기업별 설계 철학 → 2부 세 플래그십의 공통 기술 → 3부 LLM 성능을 올리는 연구/개발 동향(이 글) → 4부 2026년 최신 LLM 알고리즘 → 5부 시리즈 종합 및 투자 방향
기준일: 2026년 10월 3일. 각 사의 공개 논문, 기술보고서, 모델카드, 공식 블로그를 기준으로 했다. 수치는 모두 원문 인용이며, 원문에서 확인하지 못한 내용은 "미확인"으로 표시했다. 그림 속 곡선 중 "개념도"라고 적은 것은 서술을 도식화한 것이고 실측값이 아니다. 각 장 끝의 "투자 함의"는 필자 판단이다.0. Intro - "다 똑같이 LLM 성능 경쟁 아닌가?"
1·2부에서 Anthropic·OpenAI·Meta 세 회사를 들여다보면서 생긴 질문이 하나 있다. 이 회사들은 결국 모두 같은 일, 즉 LLM 벤치마크 점수를 올리는 일을 하고 있는 것 아닌가? 반은 맞다. 2025~2026년의 프런티어 모델은 기본 구조가 거의 같다. 그런데 논문과 기술보고서를 단계별로 나눠 읽으면, 회사마다 성능을 "어디에서" 끌어올리는지가 뚜렷하게 다르다. 그리고 그 차이가 반도체·인프라 수요에 미치는 방향도 다르다.
이 글은 LLM 성능 개선을 다섯 단계로 나누고, 단계마다 핵심 알고리즘을 소개하고, 회사별로 어느 단계에 집중하는지를 정리한다. 각 장 끝에는 그 기술이 하드웨어·사업 수요에 어떤 뜻인지를 한 가지씩 적었다. 마지막에 숫자 정밀도(FP16·FP8·FP4·INT)와 양자화를 참고 자료로 붙였다.
1. 성능 개선의 다섯 단계 - 회사별 차이가 보이는 틀
LLM의 성능은 다음 다섯 단계 중 어딘가를 바꿔서 오른다. 모델을 설계하고, 학습시키고, 다듬고, 실제로 답하게 하고, 도구와 엮어 쓰는 순서다. ①에 가까울수록 모델 자체의 설계이고, ⑤에 가까울수록 모델을 쓰는 방식이다.
- ① 구조: 네트워크 설계 자체. 어텐션을 어떻게 계산하는지, FFN을 전문가(MoE)로 나누는지, 잔차 연결을 어떻게 잇는지. 목표는 토큰 하나를 처리하는 비용을 줄이는 것이다.
- ② 사전학습: 무엇을(데이터), 어떻게(옵티마이저, 정밀도) 배우는지. 같은 데이터와 연산으로 더 많이 배우는 것이 목표다.
- ③ 후처리: 사전학습 이후 강화학습·증류로 추론 습관과 행동을 교정한다.
- ④ 추론 시간: 답하기 전에 연산을 더 쓰는 사고 과정. 길게 생각하거나, 여럿이 동시에 생각한 뒤 종합한다.
- ⑤ 시스템: 모델을 도구, 컴퓨터, 다른 모델과 엮는다. 에이전트와 연구 자동화가 여기에 속한다.
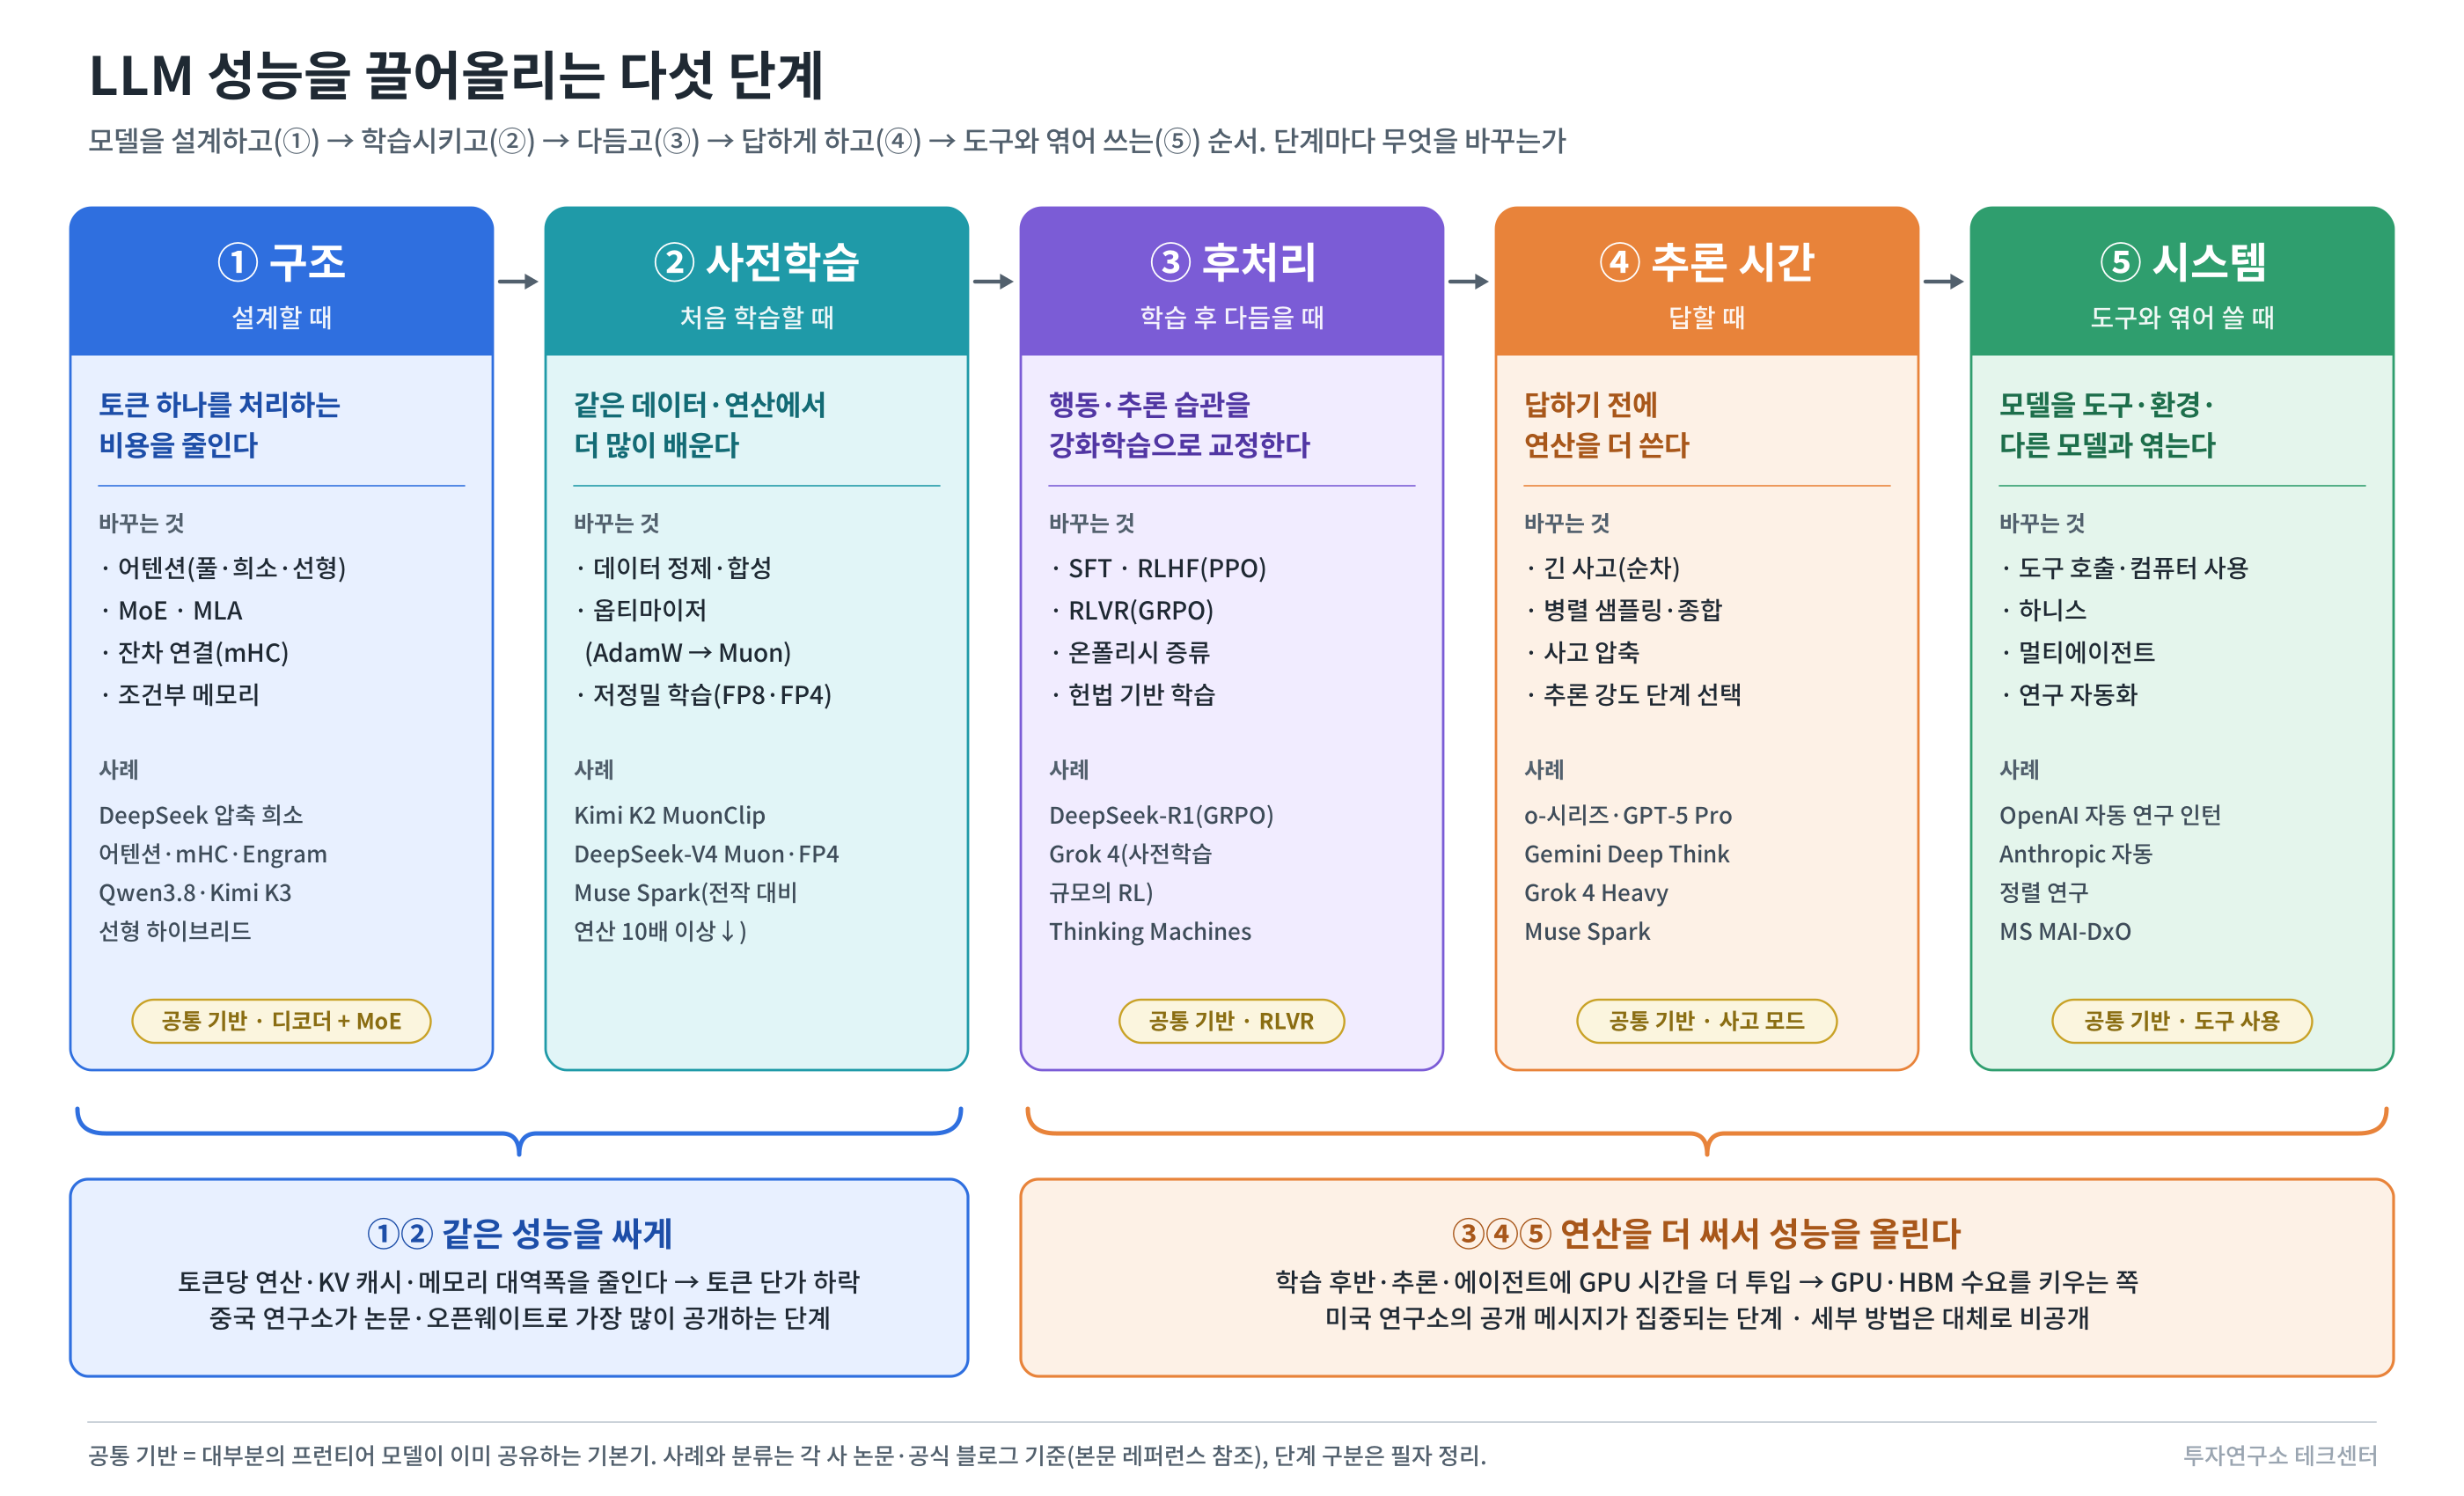
그림 3-1. LLM 성능을 끌어올리는 다섯 단계 "공통 기반"으로 표시한 것(디코더 + MoE, RLVR, 사고 모드, 도구 사용)은 프런티어 모델 대부분이 이미 공유하는 기본기다. 이것만으로는 차별화가 안 된다. 그래서 각 사가 경쟁하는 곳은 그 위다.
그림 아래의 두 묶음이 이 글의 결론을 요약한다. ③④⑤는 GPU 시간을 더 써서 성능을 올리는 방향이고, ①②는 같은 성능을 더 싸게 내는 방향이다.
2. ① 구조 - 토큰 하나의 처리 비용을 줄인다
구조 단계는 중국 연구소, 특히 DeepSeek가 가장 많이 공개한 영역이다. 미국 연구소는 구조 세부를 거의 공개하지 않는다. 미국 연구소가 구조 혁신을 안 한다는 뜻은 아니다. 공개하지 않을 뿐이다.
구조 단계를 읽으려면 먼저 비용이 어디서 나오는지 알아야 한다. 트랜스포머가 토큰 하나를 만들 때 드는 비용은 둘이다. 연산(얼마나 많은 곱셈을 하나)과 메모리(얼마나 많은 숫자를 GPU 메모리에서 읽고 저장하나)다. 2부 2-3에서 봤듯 긴 문맥에서는 메모리, 특히 앞서 읽은 문맥을 저장해 둔 KV 캐시가 비용을 좌우한다. 이 장의 네 가지 기법은 각각 이 둘 중 하나를 겨냥한다.
2-1. MLA와 세분화 MoE - DeepSeek가 표준으로 만든 두 설계
MLA(Multi-head Latent Attention)는 KV 캐시 문제를 겨냥한다. 직관적으로 말하면, 앞서 읽은 문맥을 토큰마다 통째로 저장하는 대신 작게 요약한 압축본만 저장해 두고, 필요할 때 그 압축본에서 원래 값을 복원하는 방식이다. 기존 멀티헤드 어텐션(MHA)은 문맥이 길어질수록 헤드별 Key·Value를 전부 GPU 메모리(HBM)에 쌓아 둬야 한다. MLA는 은닉 상태를 작은 잠재 벡터 하나로 압축해 그것만 캐시하고, 계산할 때 K·V를 복원한다. DeepSeek-V2 논문은 DeepSeek 67B 대비 KV 캐시를 93.3% 줄이고 최대 생성 처리량을 5.76배로 높였다고 보고했다. 이 수치는 MLA만이 아니라 모델 전체를 비교한 결과라는 점은 감안해야 한다. MLA는 이후 DeepSeek-V3·V3.2와 Kimi K2가 그대로 채택했고, Kimi K3도 Gated MLA 층을 쓴다.
DeepSeekMoE는 FFN을 잘게 쪼갠 다수의 "라우팅 전문가"와 항상 켜져 있는 "공유 전문가"로 나눈다. 직관적으로는, 모든 질문에 전 직원이 달려드는 대신 질문마다 담당자 몇 명만 호출하고, 누구나 알아야 할 공통 지식은 상근 직원 한 명이 맡는 구조다. 공통 지식은 공유 전문가가 맡고, 라우팅 전문가는 더 좁은 영역에 특화된다. 그 결과 파라미터(지식 용량)는 크게 키우면서 토큰당 연산은 작게 유지한다. 이 설계는 사실상 업계 표준이 됐다.
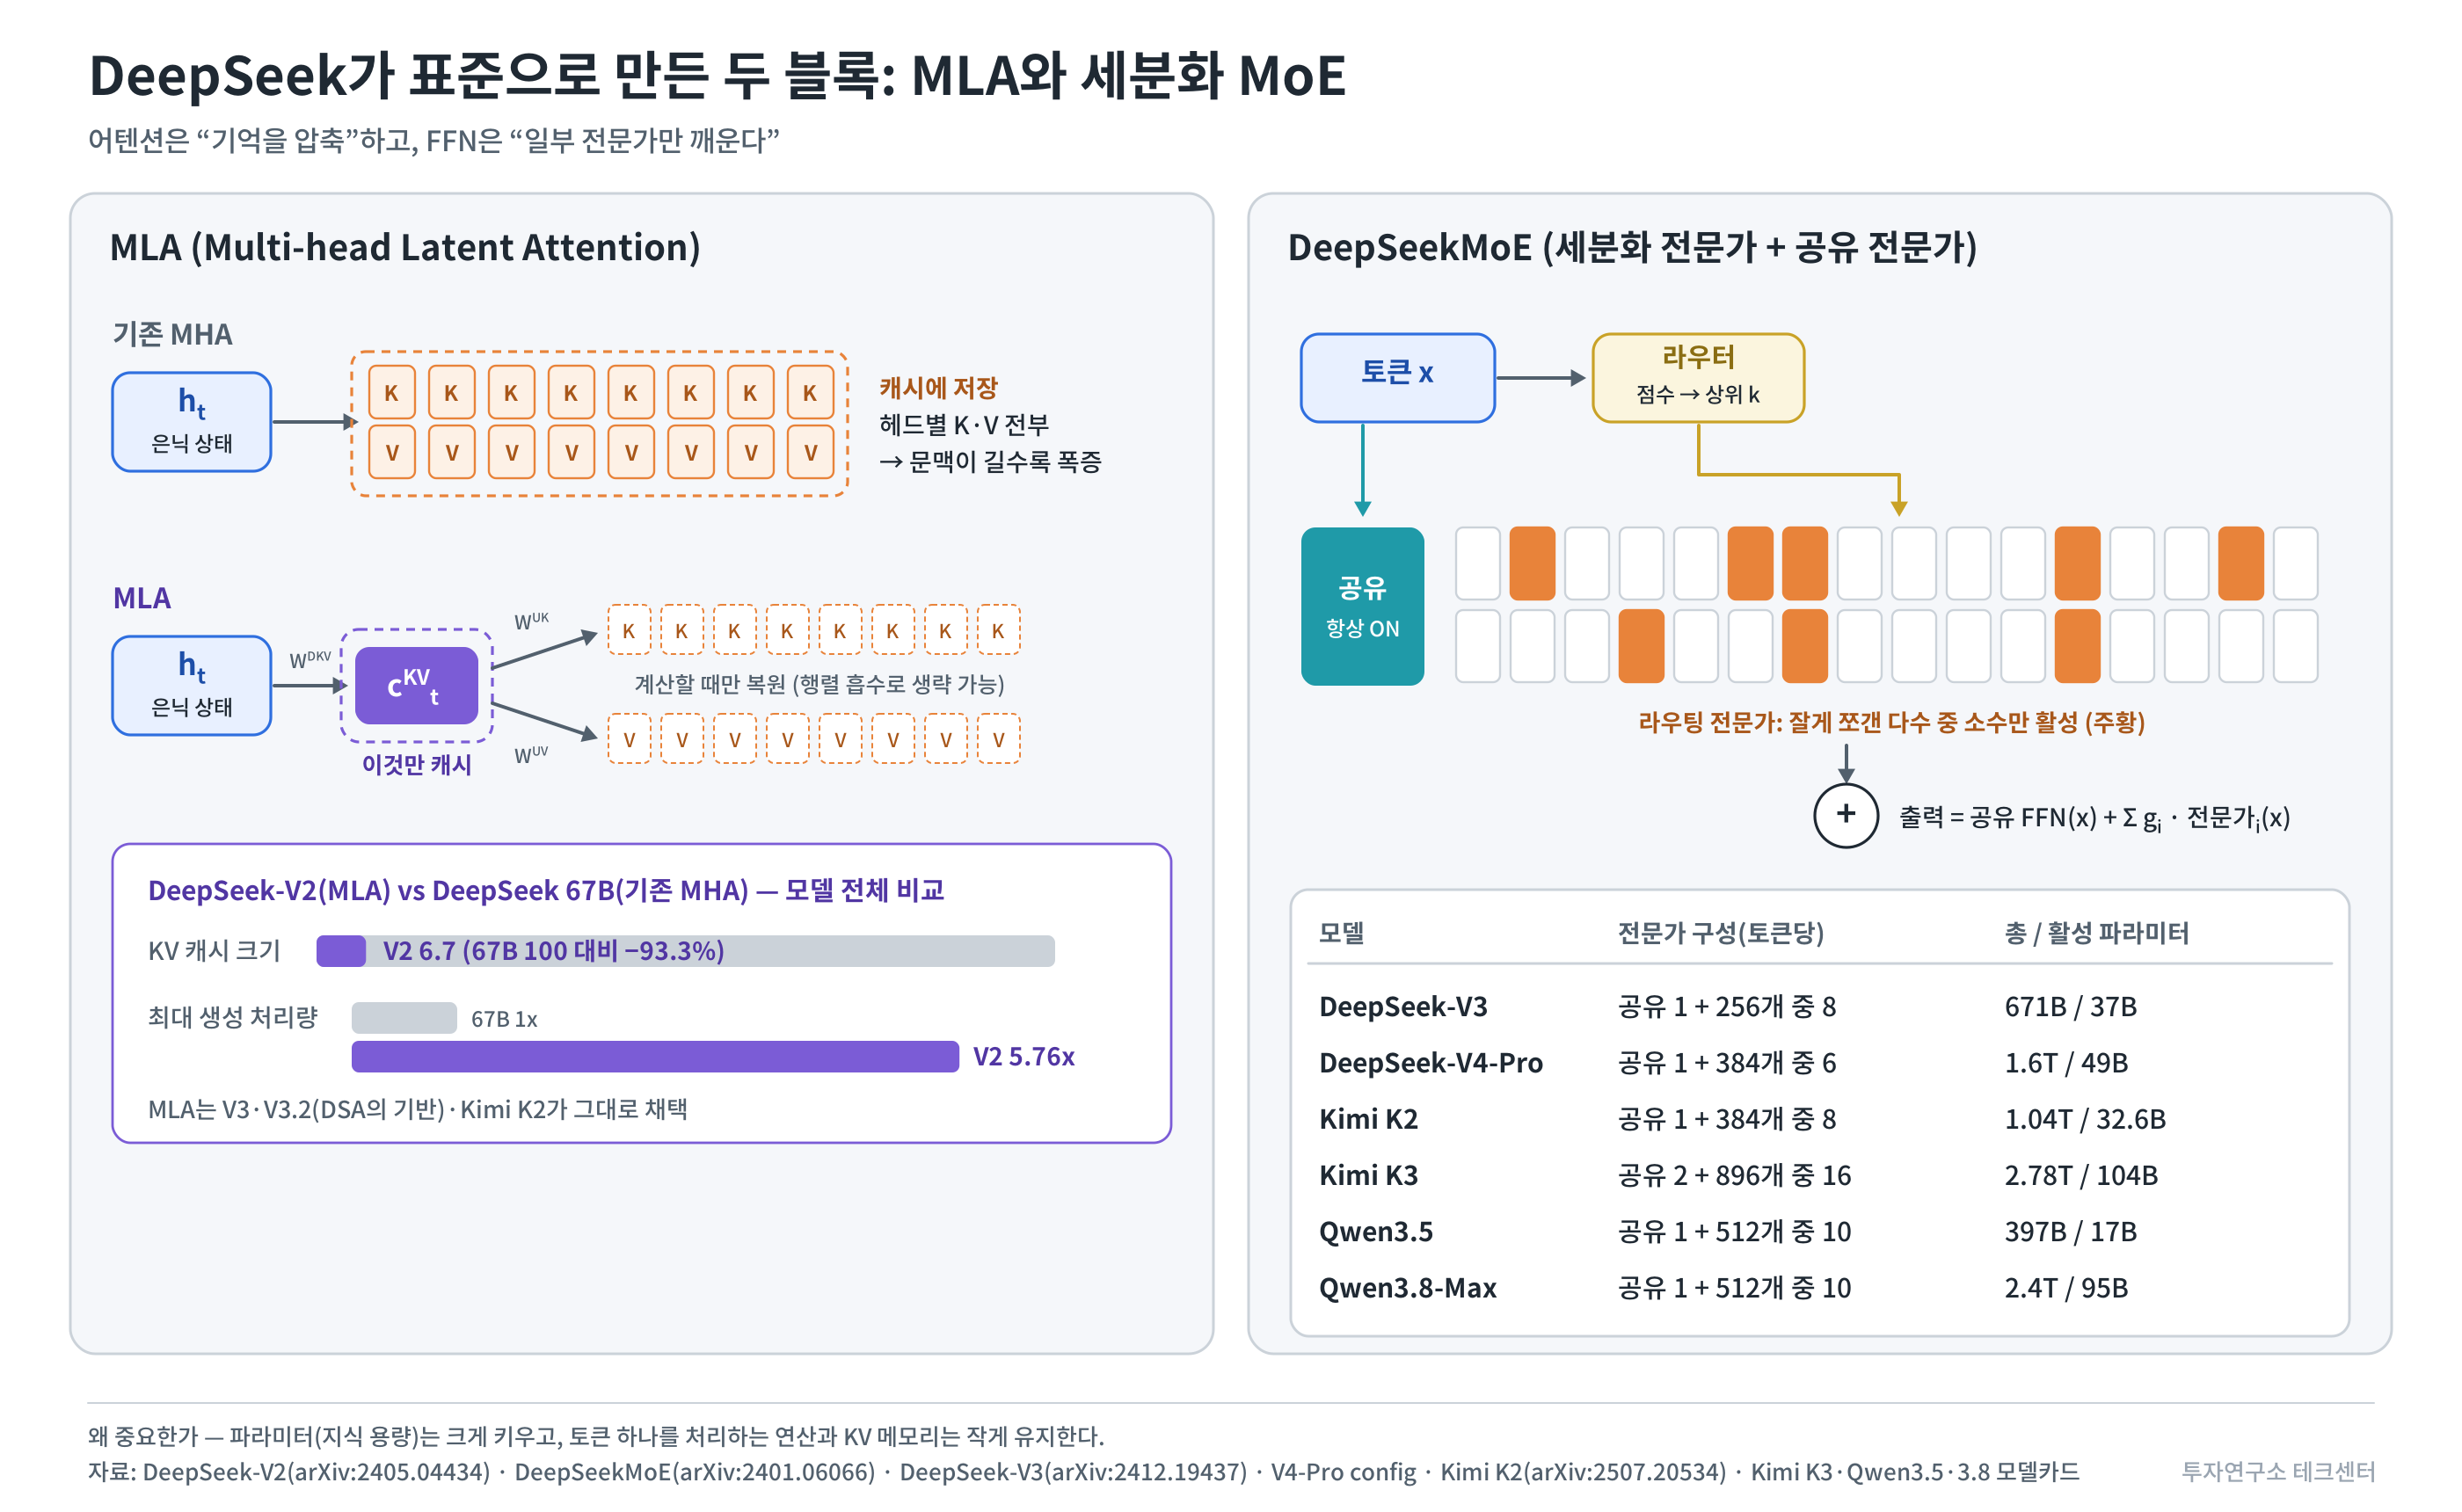
그림 3-2. MLA와 DeepSeekMoE 모델 전문가 구성(토큰당) 총 / 활성 파라미터 DeepSeek-V3 공유 1 + 라우팅 256개 중 8개 671B / 37B DeepSeek-V4-Pro (2026.4) 공유 1 + 라우팅 384개 중 6개 1.6T / 49B Kimi K2 (2025.7) 공유 1 + 라우팅 384개 중 8개 1.04T / 32.6B Kimi K3 (2026.7) 공유 2 + 라우팅 896개 중 16개 2.78T / 104B Qwen3.5 (2026.2) 공유 1 + 라우팅 512개 중 10개 397B / 17B Qwen3.8-Max (2026.8) 공유 1 + 라우팅 512개 중 10개 2.4T / 95B 활성 파라미터는 총 파라미터의 2~5% 수준이다. 1조 파라미터급 모델이 토큰당으로는 수백억 파라미터 모델의 연산만 쓴다는 뜻이다.
투자 함의 - MoE는 연산 수요를 줄이지만 GPU 사이 통신 수요를 늘린다
MoE가 토큰당 연산을 2~5%로 줄인다는 사실에서 "GPU가 덜 필요하다"로 바로 가면 틀린다. 총 파라미터는 1~3조이므로 가중치를 올리는 데는 여전히 GPU 수십 장이 필요하고(2부 2-3), 토큰마다 "어느 전문가가 어느 GPU에 있나"에 따라 데이터를 GPU 사이로 보내야 한다(all-to-all 통신). 전문가 수가 256개에서 896개로 늘수록 이 통신이 더 잦아진다. 즉 MoE는 비용의 중심을 연산에서 GPU 간 인터커넥트(NVLink·스케일업 네트워크)로 옮긴다. 연산 성능보다 GPU 사이의 대역폭이 모델 서비스 원가를 가르는 구조이고, 이는 NVIDIA가 GPU 단품보다 랙 단위(NVL72 등)로 파는 이유와 맞물린다. MLA도 마찬가지다. KV 캐시를 93% 줄이면 같은 HBM으로 동시 사용자를 그만큼 더 받을 수 있으므로, 결과는 "HBM을 덜 산다"가 아니라 "GPU 한 장당 매출이 올라간다"다.
2-2. 희소 어텐션과 선형 하이브리드 - 긴 문맥을 싸게 처리하는 두 방법
긴 문맥에서 비용이 폭증하는 이유는 풀 어텐션이 모든 과거 토큰을 다 보기 때문이다. 연산은 문맥 길이의 제곱(L²)에, KV 캐시는 문맥 길이(L)에 비례한다. 책 한 권을 읽으면서 새 문장을 읽을 때마다 앞의 모든 문장을 전부 다시 훑는 것과 같다. 이를 줄이는 길은 두 갈래다.
(a) 풀 어텐션 - 기준. 새 토큰 하나를 만들 때마다 과거 토큰 전부와 비교하고, 과거 토큰마다 Key·Value를 KV 캐시에 저장해 둔다. 가장 정확하지만 문맥이 길어질수록 연산과 메모리가 함께 늘어난다. 아래 두 방법은 이 기준에서 각각 "비교 횟수"와 "저장량"을 줄인다.
(b) 희소 어텐션 - DeepSeek DSA. 직관적으로는, 모든 과거 토큰을 다 보는 대신 "지금 질문과 관련 있을 것 같은 토큰 2,048개만 골라서 본다"는 방식이다. 고르는 일은 작고 빠른 보조 모델이 맡는다. DeepSeek-V3.2는 FP8로 동작하는 가벼운 "라이트닝 인덱서"가 과거 토큰마다 점수를 매기고, 쿼리마다 상위 2,048개 토큰만 골라 어텐션을 계산한다(DeepSeek Sparse Attention). 연산은 L·k에 비례하게 된다. DeepSeek는 V3.2-Exp를 내면서 API 가격을 50% 이상 내렸다(2025.9.29 공지). 다만 DSA는 계산을 줄일 뿐 KV는 그대로 보관한다. 2026년 4월 공개된 DeepSeek-V4는 여기서 한 걸음 더 나갔다. KV를 압축한 뒤 희소 선택하는 CSA(Compressed Sparse Attention)와 KV를 훨씬 강하게 압축하는 HCA(Heavily Compressed Attention)를 섞었다. 기술보고서는 100만 토큰 문맥에서 V4-Pro가 V3.2 대비 토큰당 추론 FLOPs 27%, KV 캐시 10%만 쓴다고 밝혔다. 9월 10일 공개된 V4.1-Flash는 인코더가 만든 KV를 디코더 층 전체가 공유하는 구조와 FP4 KV 캐시를 더해, 토큰당 전역 KV를 890바이트(V4-Flash의 약 1/4)까지 줄였다. Qwen도 8월 Qwen3.8-Flash-Next에서 풀 어텐션 층을 같은 계열의 희소 어텐션(QSA)으로 바꿨다(4부).
(c) 선형 하이브리드 - Qwen, Kimi. 직관적으로는, 과거 문맥을 토큰별로 저장하지 않고 크기가 고정된 "요약 노트" 하나에 계속 덮어쓰면서 들고 다니는 방식이다. 문맥이 100만 토큰이어도 노트 크기는 그대로다. 선형 어텐션 층은 과거 전체를 고정 크기 상태 행렬 S에 압축해 들고 다닌다. 그래서 KV 캐시가 문맥 길이와 무관하다. 대표 업데이트 규칙인 Gated DeltaNet은 S_t = S_{t−1}·α_t(I − β_t k_t k_tᵀ) + β_t v_t k_tᵀ 형태다. 감쇠(α)로 오래된 기억을 지우고, 델타 규칙(β)으로 새 정보를 덮어쓴다. 다만 요약 노트만으로는 "300페이지 앞의 그 숫자가 정확히 뭐였지"를 찾는 정밀 검색이 약하다. 그래서 실제 모델은 선형 3층마다 풀 어텐션 1층을 섞는다.
- Qwen3-Next(2025.9)·Qwen3.5(2026.2)·Qwen3.8(2026.8): Gated DeltaNet 3 : Gated Attention 1. 2.4T 플래그십 Qwen3.8-Max도 이 3:1 배치를 그대로 쓴다. Qwen3-Next-80B-A3B는 Qwen3-32B 대비 학습 비용 10% 수준으로 더 나은 성능을 냈고, 32K 이상 문맥에서 추론 처리량이 10배라고 모델카드에 적었다.
- Kimi Linear(2025.10): KDA(Kimi Delta Attention) 3 : MLA 1. KV 캐시 최대 75% 절감, 100만 토큰 문맥에서 디코딩 6.3배.
- Kimi K3(2026.7): KDA 69층 + Gated MLA 24층. 플래그십(2.78T)에 선형 하이브리드를 그대로 올렸다.
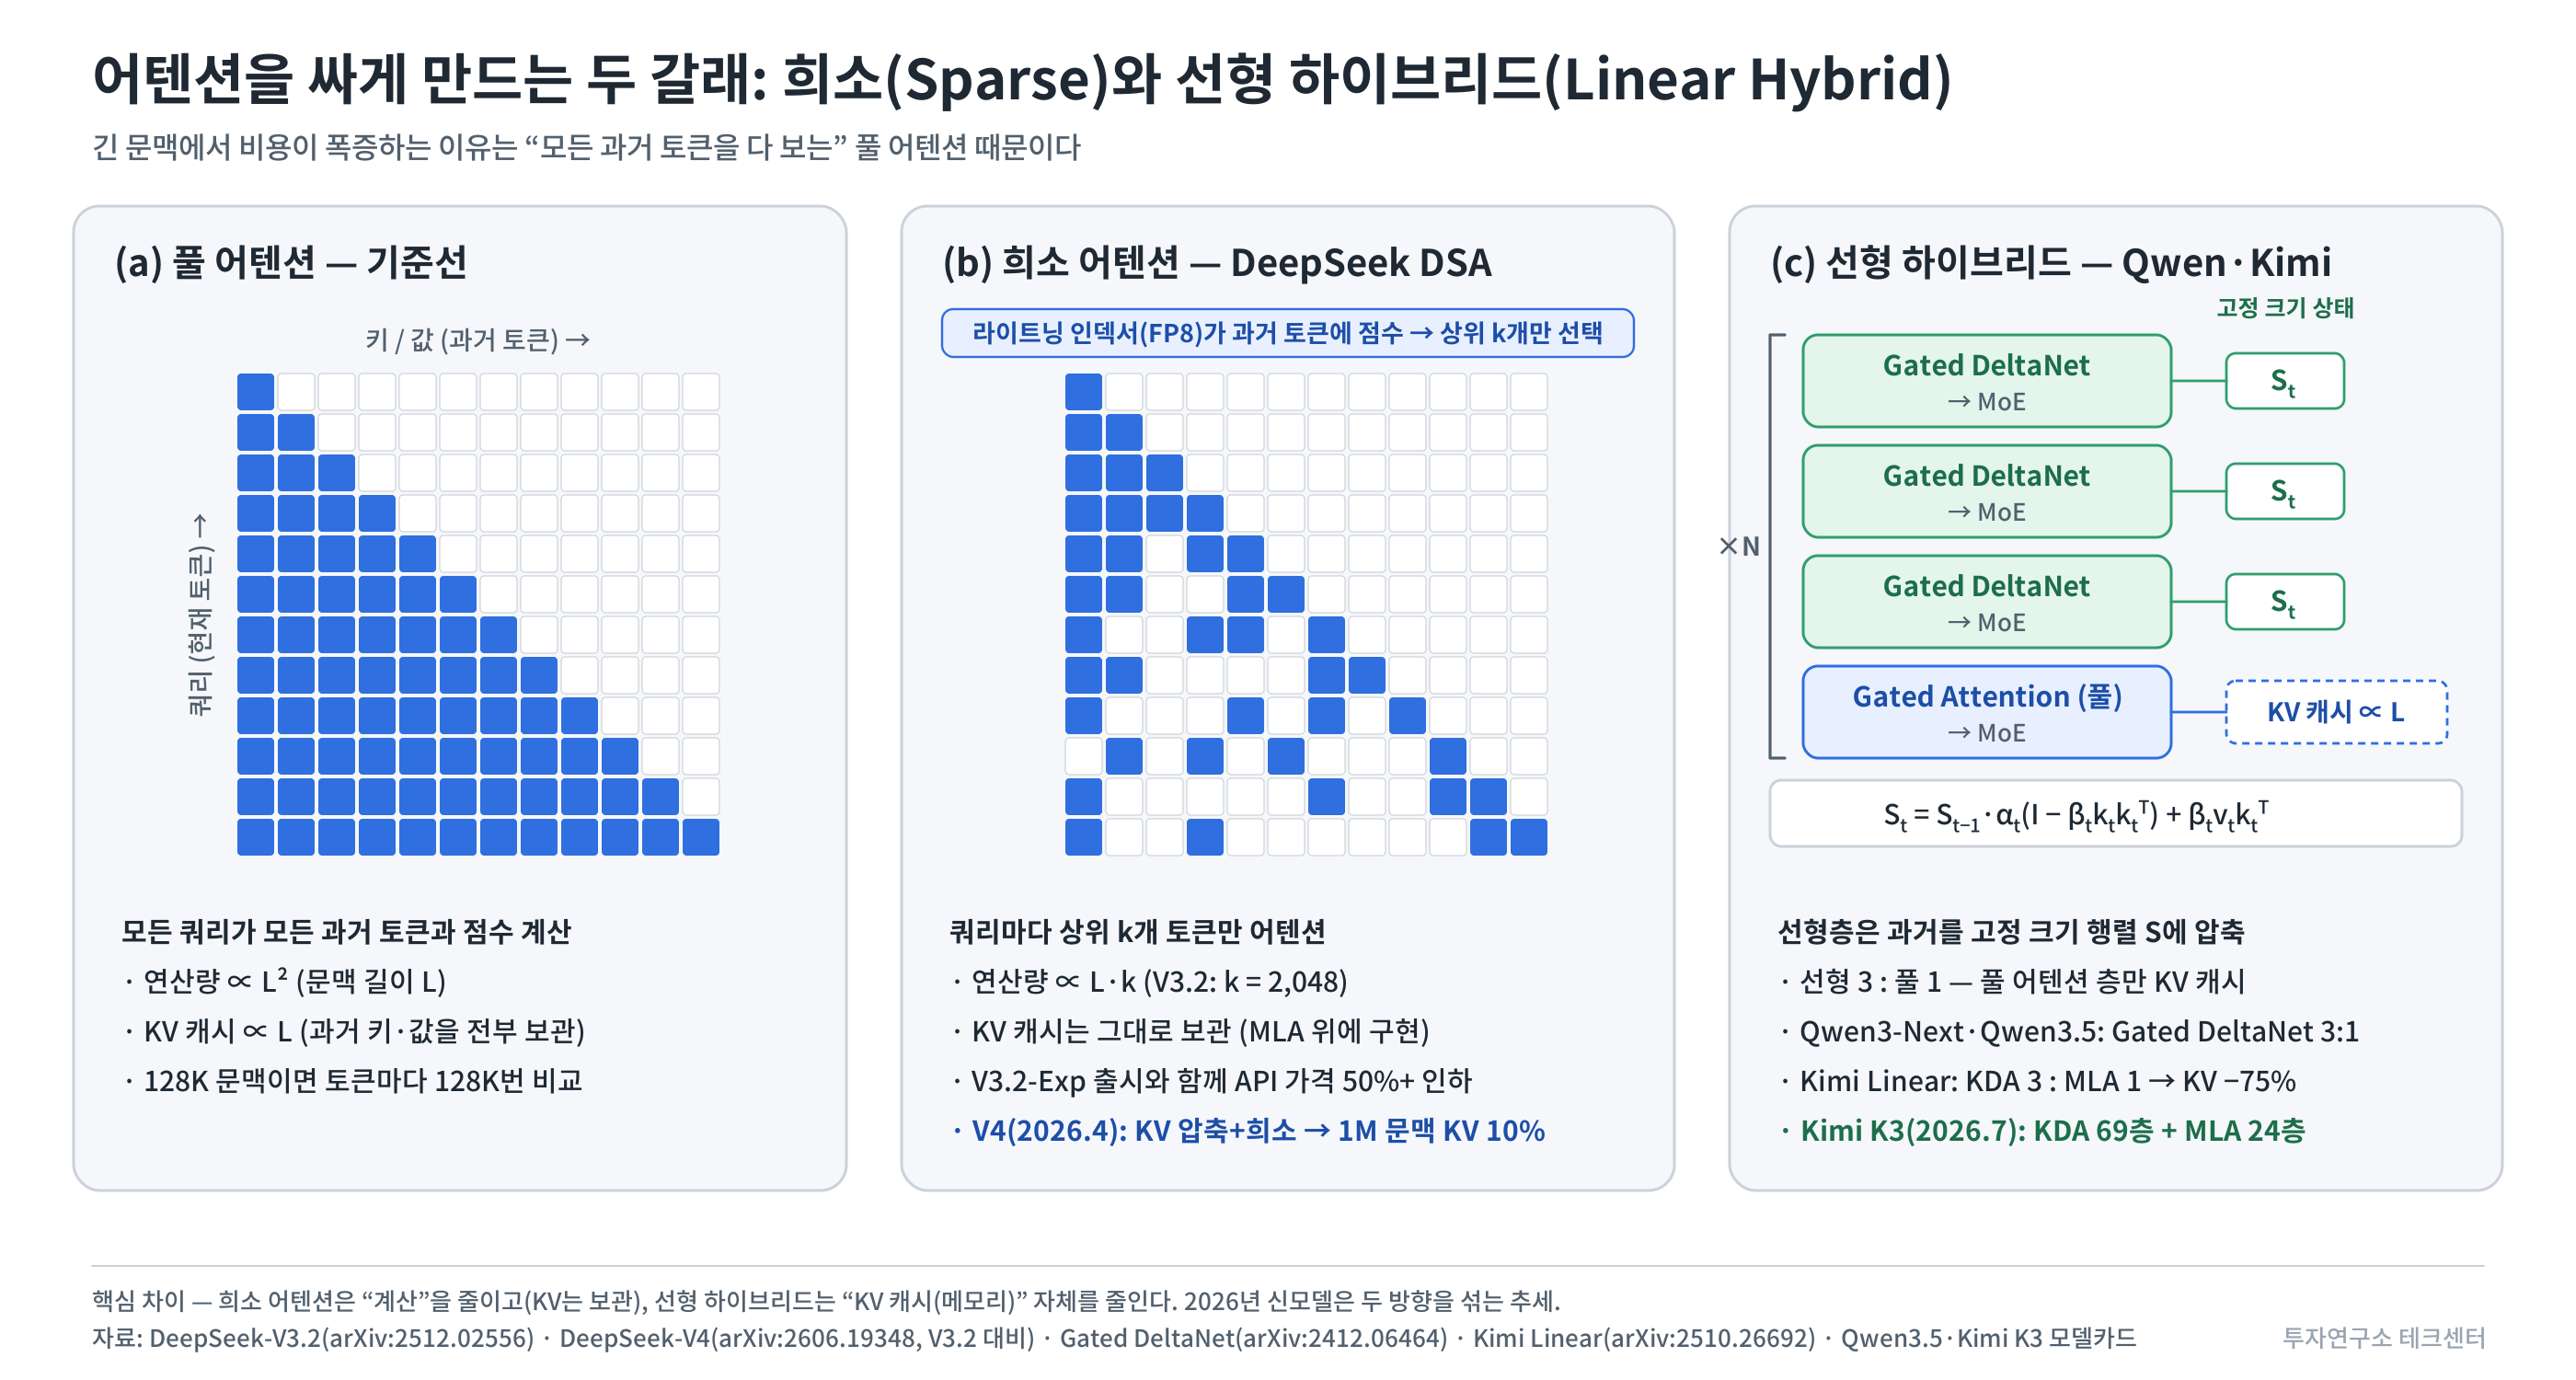
그림 3-3. 어텐션을 싸게 만드는 두 갈래 정리하면 희소 어텐션은 "계산"을 줄이고, 선형 하이브리드는 "KV 캐시(메모리)" 자체를 줄인다. 2026년 신모델들은 두 방향을 섞는 쪽으로 가고 있다.
투자 함의 - 긴 문맥이 싸지면 "컨텍스트 길이"는 차별화 요소에서 사라진다
선형 하이브리드가 KV 캐시를 문맥 길이와 무관하게 만들면, 1M 컨텍스트를 제공하는 비용이 10만 토큰과 크게 다르지 않게 된다. 그러면 "우리 모델은 몇 M까지 된다"는 마케팅은 의미를 잃고, 경쟁은 2부 4장에서 본 "그 긴 문맥 안에서 작업 상태를 어떻게 관리하느냐"로 옮겨 간다. 더 눈여겨볼 것은 가격 구조다. Anthropic이 캐시 읽기 가격을 75% 내린 것(1부)과 DeepSeek가 희소 어텐션으로 API 가격을 절반으로 내린 것은, 긴 문맥을 "읽는" 비용이 구조적으로 떨어지고 있다는 같은 신호다. 입력(읽기)은 싸지고 출력(생각하고 쓰기)은 비싼 채로 남는 가격 구조가 굳어지면, 사용량이 늘어나는 쪽은 "긴 문서를 넣고 짧게 묻는" 워크로드다. 추론 하드웨어 수요도 연산(prefill)보다 메모리 대역폭(decode)에 더 쏠린다.
2-3. mHC - 10년 된 잔차 연결의 재설계
잔차 연결(x_{l+1} = x_l + F(x_l))은 2015년 ResNet 이후 거의 바뀌지 않은 구성 요소다. 직관적으로는 각 층이 입력을 처음부터 다시 만드는 게 아니라, 입력을 그대로 넘기면서 "고칠 부분만" 더하는 구조다. 입력이 그대로 다음 층으로 넘어가는 "항등 경로" 덕분에 깊은 망도 안정적으로 학습된다. 대신 잔차 흐름이 한 줄이라 층 사이에 전달할 수 있는 정보량이 제한된다.
ByteDance의 Hyper-Connections(HC)는 이 잔차를 n개 갈래(스트림)로 넓히고, 갈래 사이를 섞는 행렬을 자유롭게 학습하게 했다. 한 줄로 흐르던 정보를 여러 줄로 나눠 흘리고, 줄 사이를 섞는 비율을 모델이 스스로 정하게 한 것이다. 성능은 올랐지만 문제가 생겼다. 층을 지날 때마다 이 행렬이 곱해지면서 신호가 증폭된다. DeepSeek의 27B 실험에서는 합성 증폭이 최대 약 3,000배까지 치솟았다. 이상적인 값은 1이다. 복사기로 복사본을 또 복사하면 얼룩이 점점 진해지는 것과 같은 문제다.
DeepSeek의 mHC(2025.12.31, 량원펑 공저)는 섞는 행렬을 "이중확률행렬"로 제한한다. 모든 원소가 0 이상이고, 행의 합과 열의 합이 모두 1인 행렬이다. 직관적으로는 갈래 사이에서 정보를 "옮기기만" 하고 "크기를 키우지는" 못하게 규칙을 건 것이다. 학습된 값을 Sinkhorn-Knopp 알고리즘으로 행·열 정규화를 반복해 이 집합(버코프 다면체)에 투영한다. 핵심은 이중확률행렬끼리 곱해도 다시 이중확률행렬이 된다는 성질이다. 층을 아무리 쌓아도 신호 크기가 보존되므로, 넓은 잔차의 이점은 유지하면서 항등 경로의 안정성을 되찾는다. 확장률 n=4에서 추가 학습 시간은 6.7%였다.
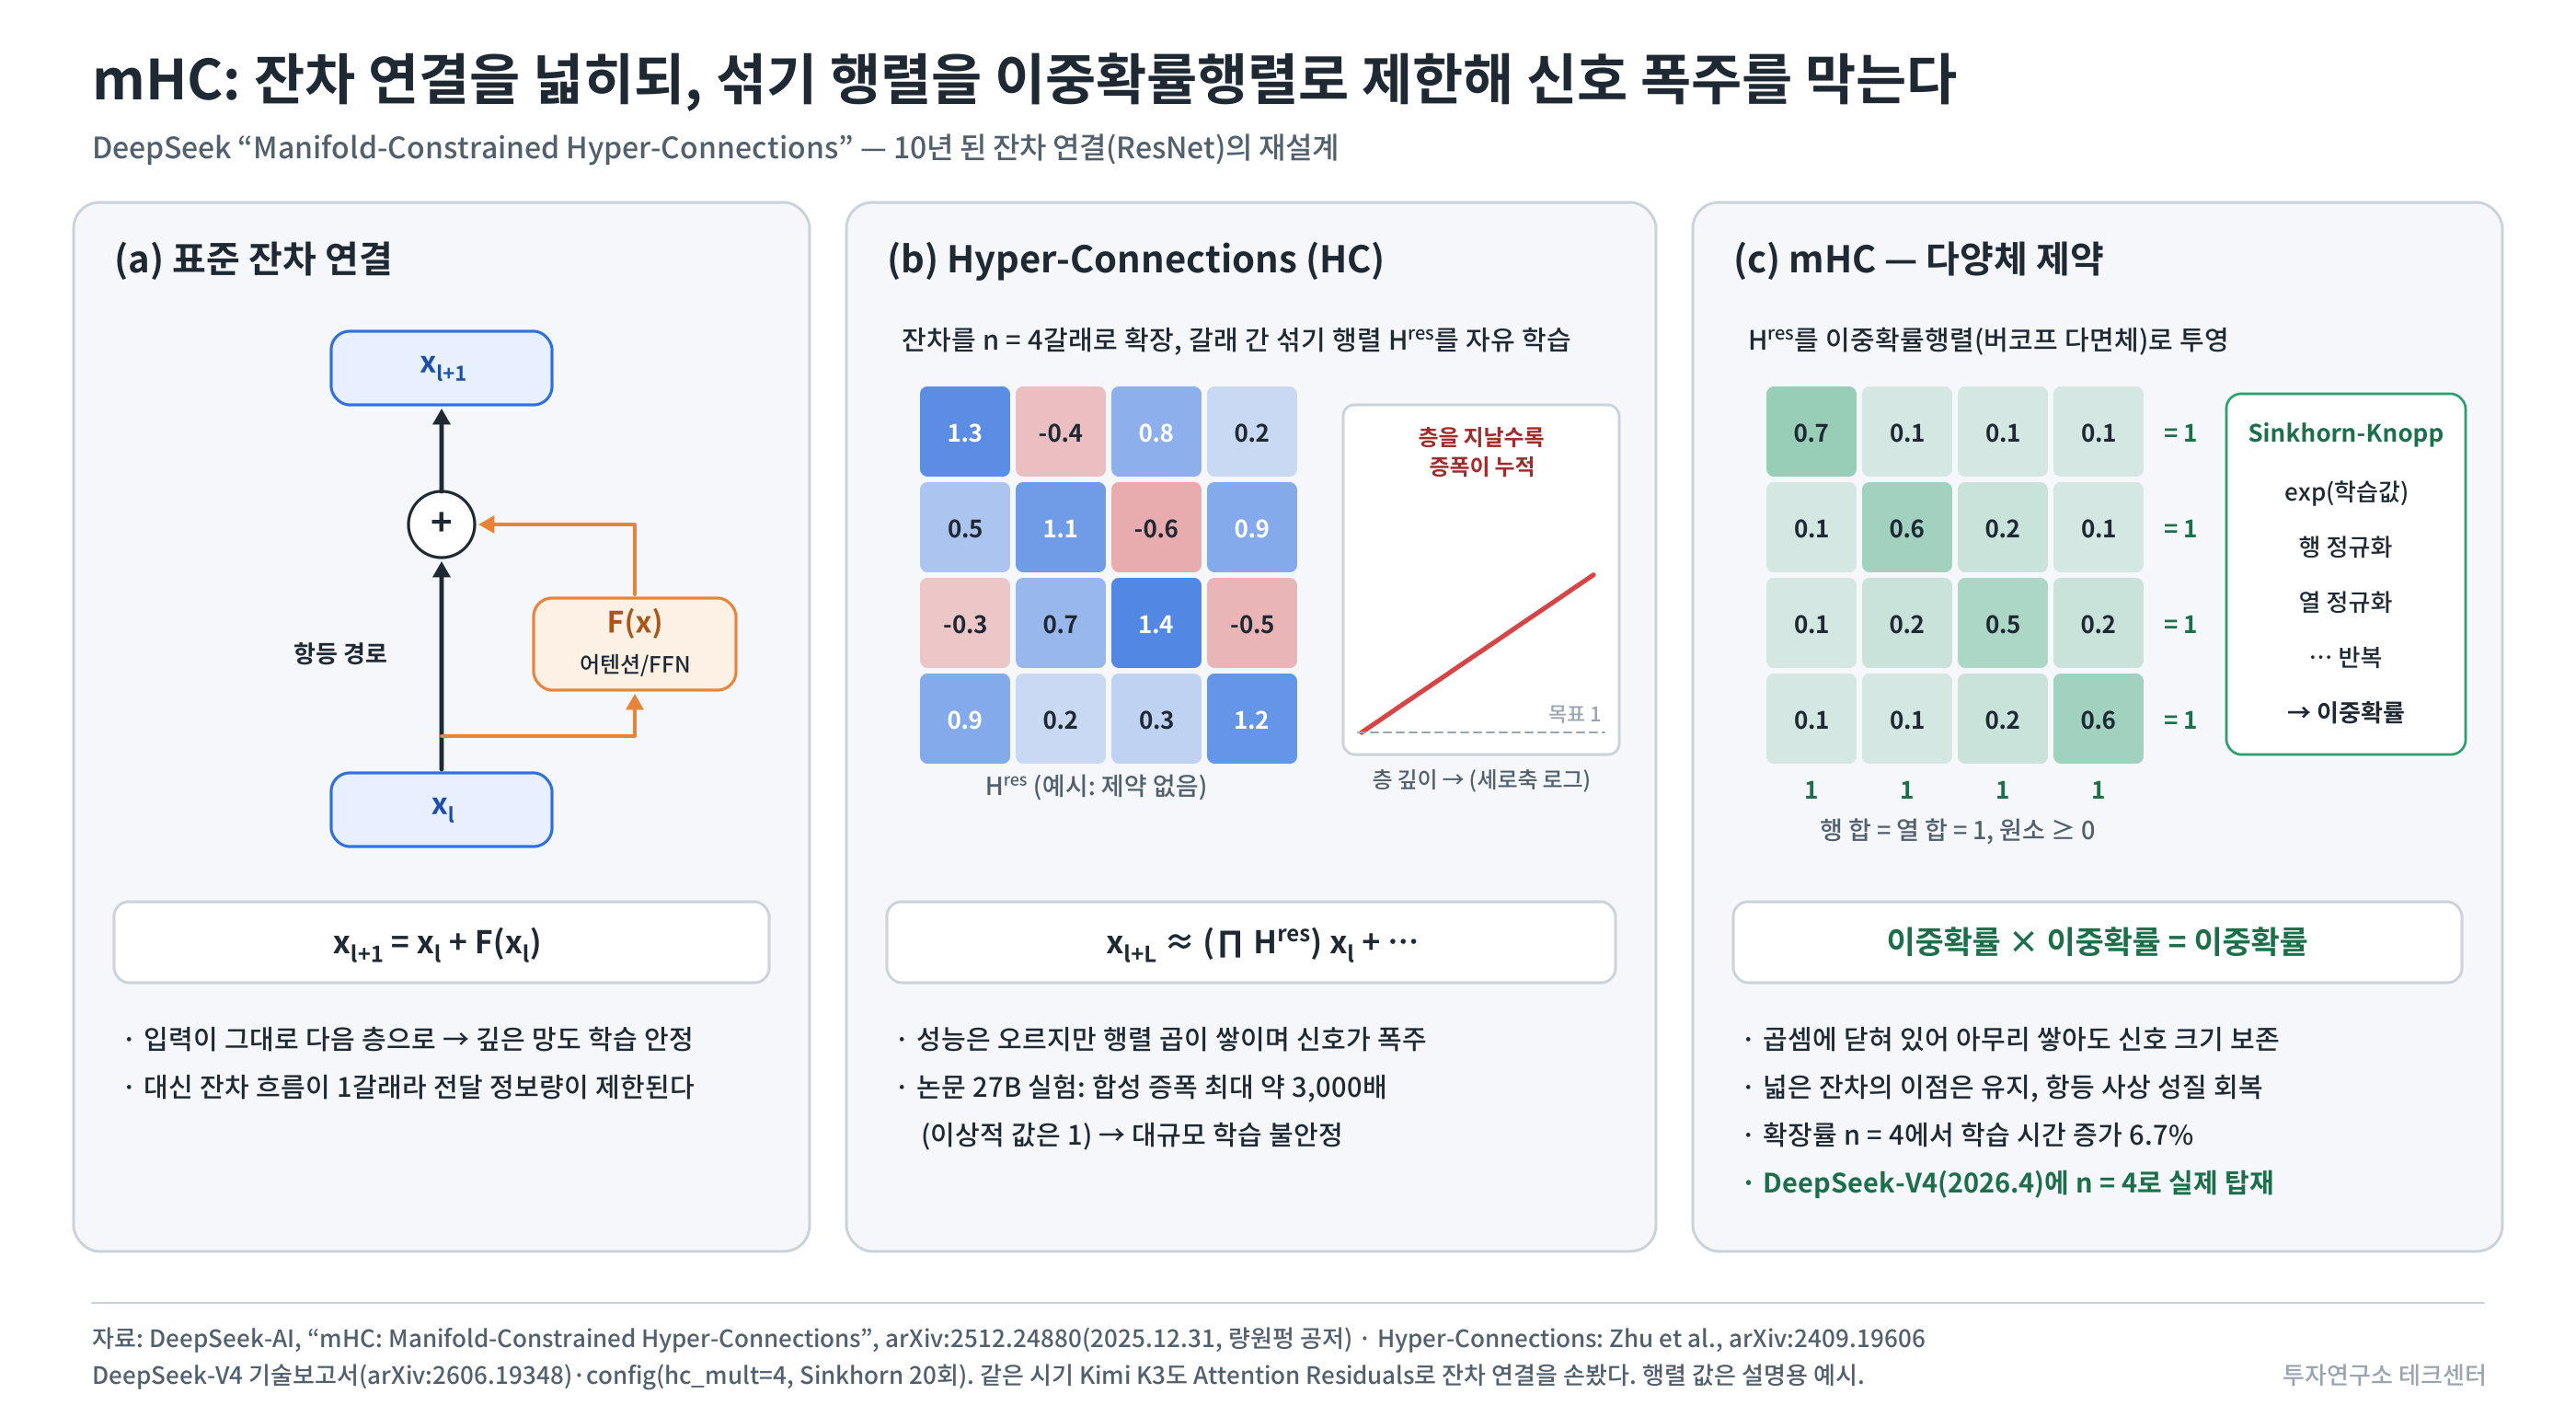
그림 3-4. mHC mHC는 논문에서 끝나지 않았다. DeepSeek-V4 설정 파일에는 hc_mult=4, Sinkhorn 반복 20회가 그대로 들어가 있다. 이어서 문샷도 2026년 3월 "Attention Residuals"라는 이름으로 잔차 연결을 다시 설계해 Kimi K3에 적용했다. 중국 연구소들이 트랜스포머의 가장 기본적인 구성 요소까지 다시 설계하고 있다는 신호다.
투자 함의 - 학습 안정화 기법은 "실패해서 버리는 GPU 시간"을 줄인다
mHC나 뒤에 나올 MuonClip 같은 안정화 기법의 가치는 성능 몇 점이 아니라 학습이 중간에 터지지 않는다는 데 있다. 1조 파라미터 모델을 수만 장 GPU로 몇 달 학습하다 발산하면, 마지막 체크포인트로 되돌아가 다시 돌려야 하고 그 사이의 GPU 시간은 버려진다. 학습 비용의 상당 부분이 이런 재시도에 들어간다는 것은 업계에서 널리 알려진 사실이지만 공개 수치는 없다. 안정화 기법이 논문으로 공개되면 이 "버리는 시간"이 산업 전체에서 줄고, 그 효과는 GPU가 적어 한 번의 실패가 치명적인 중소 연구소와 후발 주자에게 더 크다. 프런티어 진입 장벽 중 "학습 실패 리스크"가 낮아지고, 같은 GPU 예산으로 완주할 수 있는 모델 크기가 커진다. 학습 클러스터의 명목 수요가 아니라 유효 가동률이 올라가는 효과다.
2-4. Engram - 외우는 일을 조회로 바꾼다
트랜스포머에는 "지식을 찾아보는" 기능이 따로 없다. "대한민국의 수도는" 같은 고정된 패턴도 매번 여러 층의 연산으로 재구성한다. 직관적으로는, 구구단을 외우지 않고 매번 덧셈으로 계산하는 것과 같다. DeepSeek의 Engram(2026.1.12, 량원펑 공저)은 이를 고전적인 N-gram 임베딩의 현대판으로 해결한다. 자주 나오는 단어 조합은 계산하지 않고 표에서 바로 찾아 쓰게 한 것이다.
- 직전 N개 토큰(N-gram)을 여러 해시 함수에 통과시켜 주소를 만든다.
- 그 주소로 거대한 메모리 테이블을 O(1)에 조회한다.
- 현재 문맥과 맞을 때만 반영되도록 게이트(g)로 가중치를 매겨 백본 은닉 상태에 더한다.
주소가 입력 토큰만으로 결정되므로, 테이블을 GPU HBM이 아니라 CPU 메모리(DRAM)에 두고 미리 가져올(prefetch) 수 있다. 논문은 오버헤드가 미미하다고 보고했다. 또 MoE(조건부 연산)와 Engram(조건부 메모리) 사이에 희소 파라미터를 나누는 최적 비율이 U자형 곡선을 그린다는 "희소성 배분 법칙"을 제시했다.
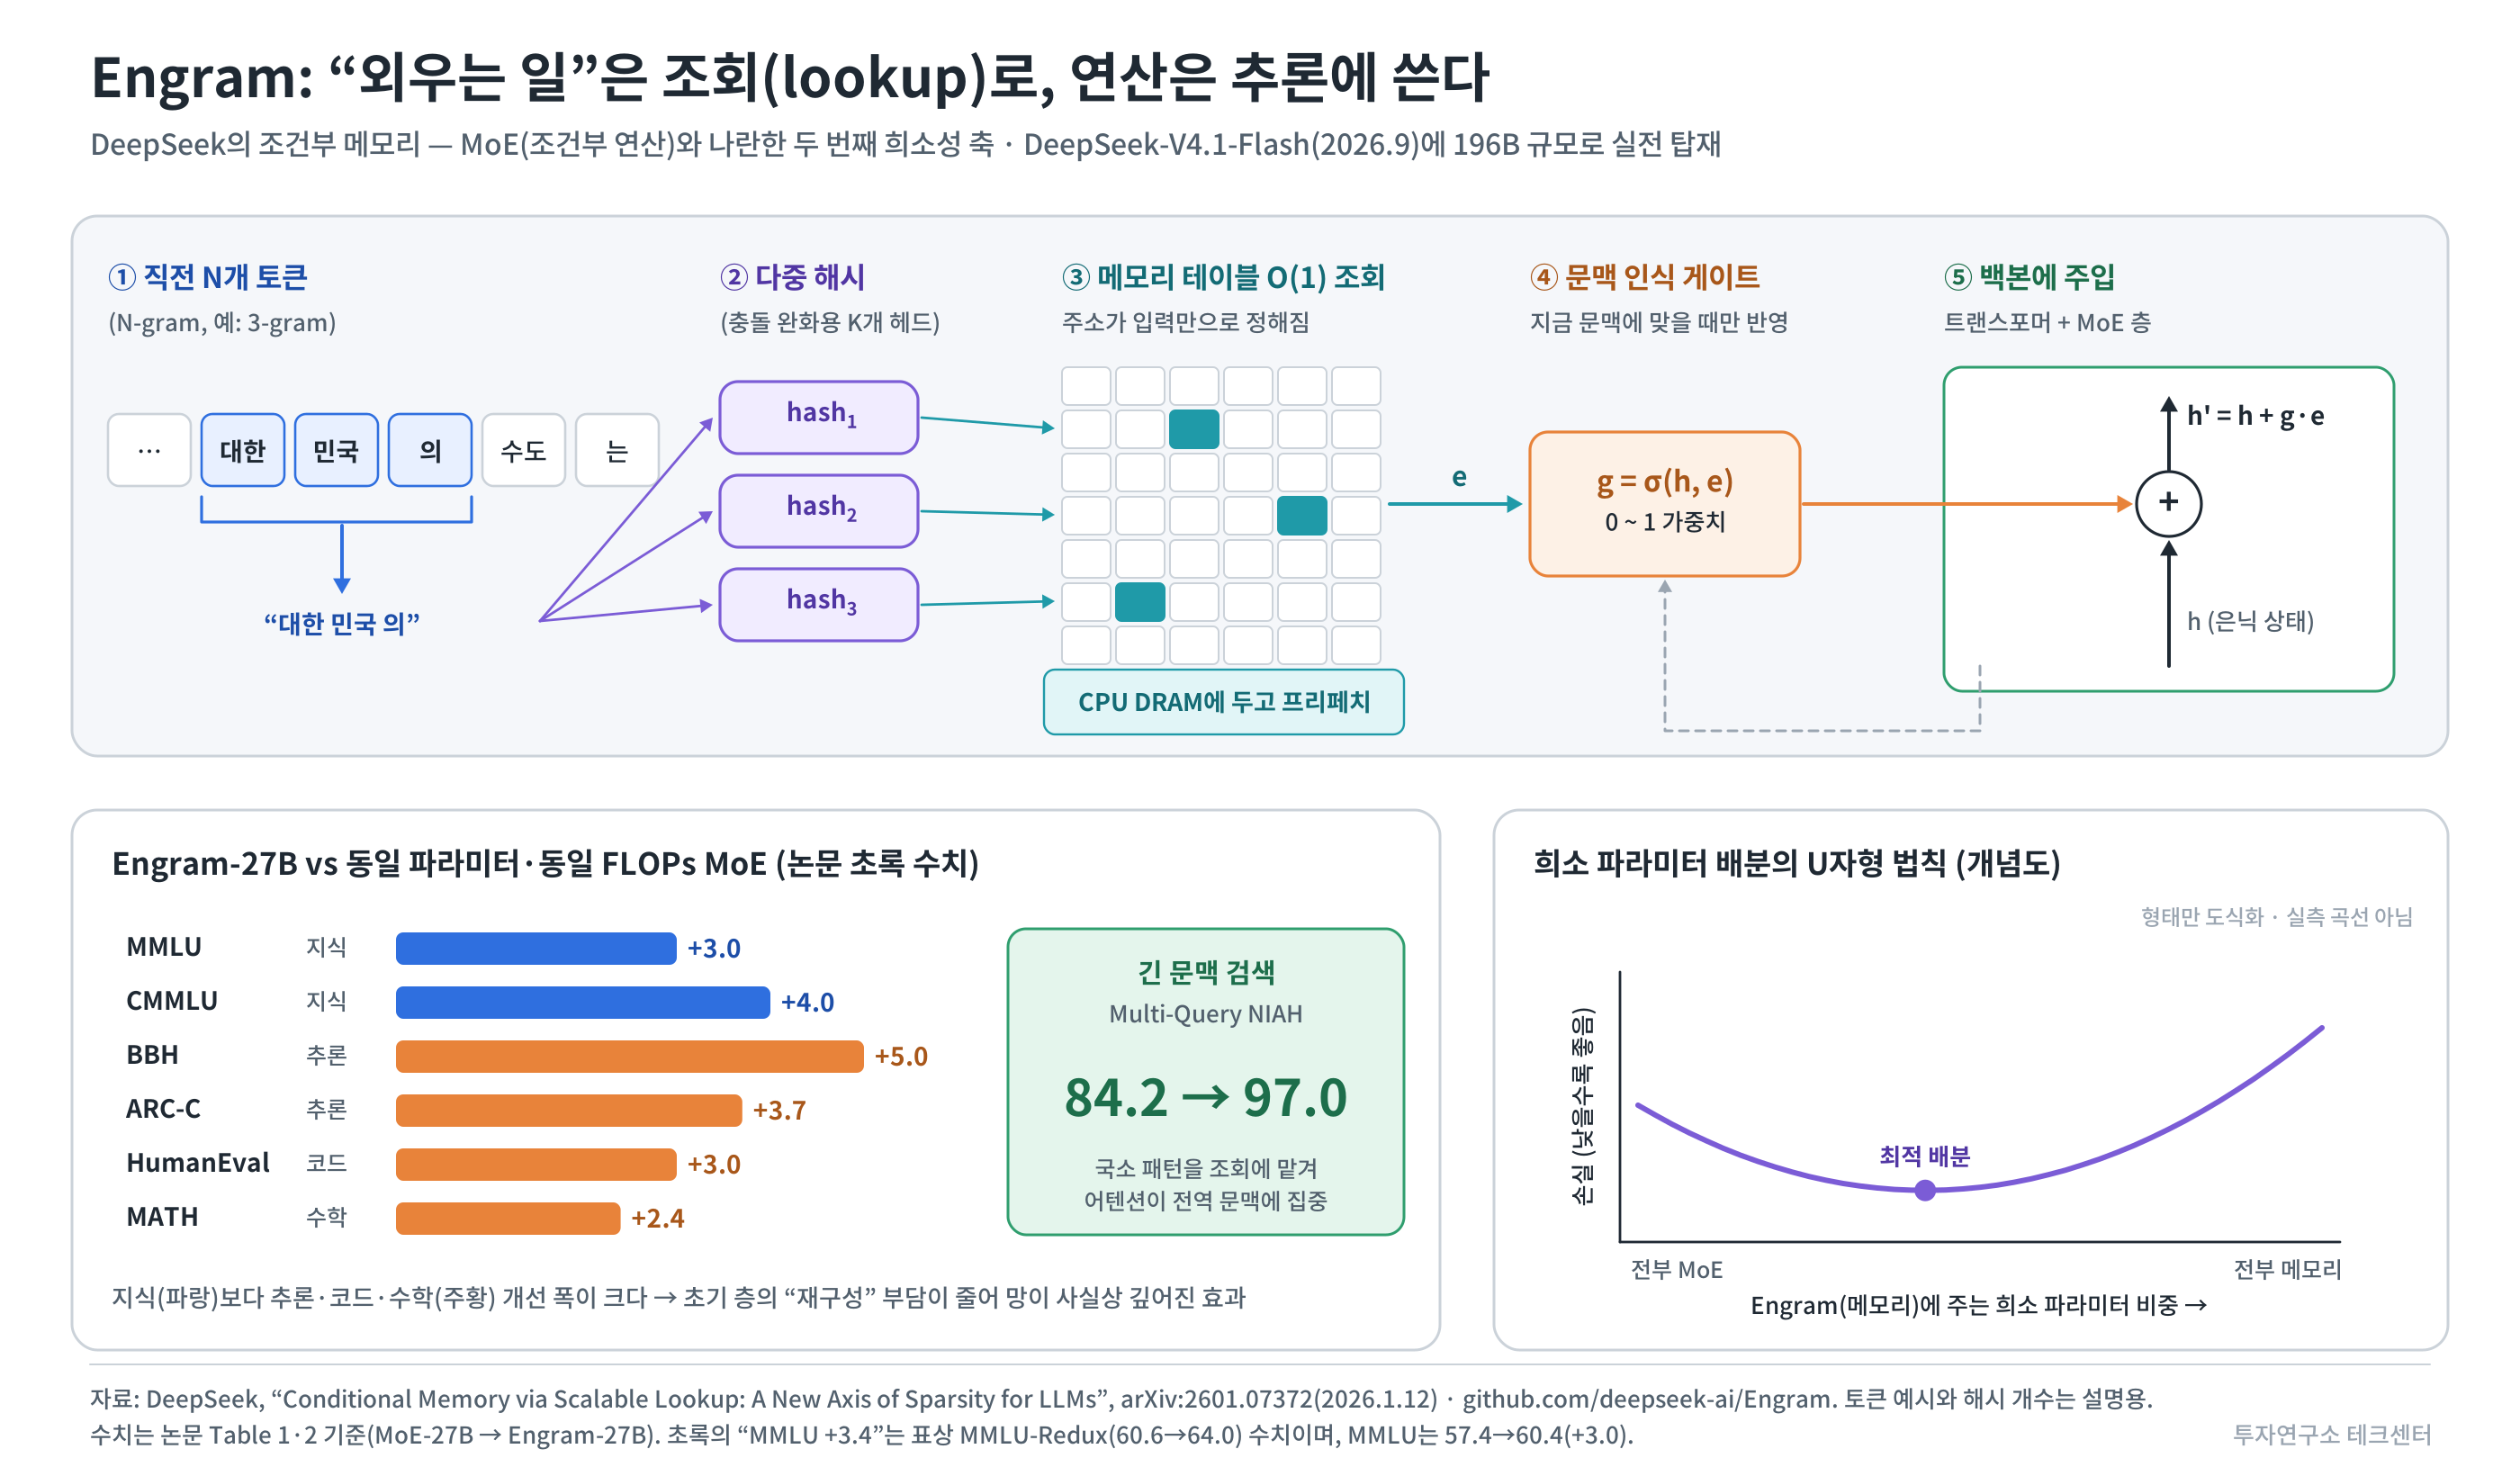
그림 3-5. Engram 결과도 흥미롭다. 같은 파라미터·같은 FLOPs의 MoE와 비교한 Engram-27B는 지식 과제(MMLU +3.0, CMMLU +4.0)보다 추론·코드·수학(BBH +5.0, ARC-Challenge +3.7, HumanEval +3.0, MATH +2.4)에서 더 크게 올랐다. 긴 문맥 검색(Multi-Query NIAH)은 84.2에서 97.0으로 뛰었다. 논문의 해석은 이렇다. 국소 패턴을 조회에 맡기니 초기 층이 "재구성" 부담에서 풀려 망이 사실상 깊어졌고, 어텐션이 전역 문맥에 집중할 수 있게 됐다.
Engram은 논문 8개월 만에 제품이 됐다. 4월의 DeepSeek-V4에는 없었지만, 9월 10일 공개된 DeepSeek-V4.1-Flash에 1,960억 파라미터 규모로 탑재됐다. 백본 552B와 별도로 표기된 메모리다. 알리바바도 8월 Qwen3.8-Flash-Next에 510억 파라미터 n-gram 임베딩 테이블을 넣었다. 이 테이블은 호스트 메모리에 두고 미리 가져오며, 논문에서 Engram의 문맥 게이트를 인용했다. 두 탑재 사례의 세부는 4부에서 비교한다.
투자 함의 - 조건부 메모리는 "서버당 DRAM"과 "CPU-GPU 연결"의 수요다
Engram 테이블 1,960억 파라미터는 16비트로 약 390GB다. 이것이 HBM 밖 호스트 메모리에 놓인다면, GPU 서버 한 대의 DRAM 요구량이 수백 GB 단위로 늘어난다. 그런데 더 중요한 것은 CPU 메모리에서 GPU로 데이터를 실시간으로 끌어오는 통로다. 토큰마다 조회가 일어나므로 PCIe로는 부족하고, Grace-Blackwell처럼 CPU와 GPU가 고속으로 묶인 구조나 CXL 메모리가 유리해진다. 즉 조건부 메모리는 "HBM 대신 DRAM"이라는 대체 관계가 아니라, GPU 옆에 큰 DRAM을 빠른 연결로 붙이는 서버 구조의 수요다. 다만 V4.1의 실서비스에서 테이블을 실제로 어디에 두는지는 공개되지 않았으므로, 이 함의는 논문의 설계 의도 기준이다.
3. ② 사전학습 - 같은 데이터·연산으로 더 많이 배운다
사전학습 단계에서 지난 1년간 가장 큰 변화는 옵티마이저다. 옵티마이저는 "틀린 만큼 가중치를 어느 방향으로 얼마나 고칠지"를 정하는 규칙이다. 2017년 이후 거의 모든 LLM은 AdamW를 썼다. AdamW는 가중치 행렬의 원소 하나하나를 따로 정규화한다. 행렬의 "구조"는 보지 않기 때문에 업데이트가 소수 방향(큰 특이값)에 쏠리기 쉽다.
Muon은 기울기 행렬(모멘텀) 전체를 Newton-Schulz 반복으로 직교화해서 업데이트한다. 직관적으로는 몇 방향으로만 몰려 가던 수정을 모든 방향에 고르게 나눠 주는 것이다. 문샷 AI의 Moonlight 논문은 연산 최적 학습에서 AdamW 대비 약 2배의 연산 효율을 보고했다. 문제는 규모를 키우면 어텐션 로짓이 폭주해 손실 스파이크와 발산이 생긴다는 점이었다.
MuonClip(Kimi K2, 2025.7)은 여기에 QK-Clip을 붙였다. 학습 중 헤드별 최대 어텐션 로짓이 임계값(τ=100)을 넘으면, 그 헤드의 W_q, W_k만 비율에 맞춰 줄인다. 어텐션 값이 지나치게 커지는 순간을 감지해 그 부분만 눌러 주는 안전장치다. 순전파 계산은 그대로 두고 가중치만 사후 보정한다. 그 결과 Kimi K2(1.04T/32.6B)는 15.5T 토큰 사전학습 동안 손실 스파이크가 한 번도 없었다. 이후 DeepSeek-V4(2026.4)와 Qwen3.8-Flash-Next(2026.8)도 Muon 옵티마이저를 채택했다. 중국 연구소끼리 공개 논문을 통해 기법을 빠르게 주고받는다는 사례다.
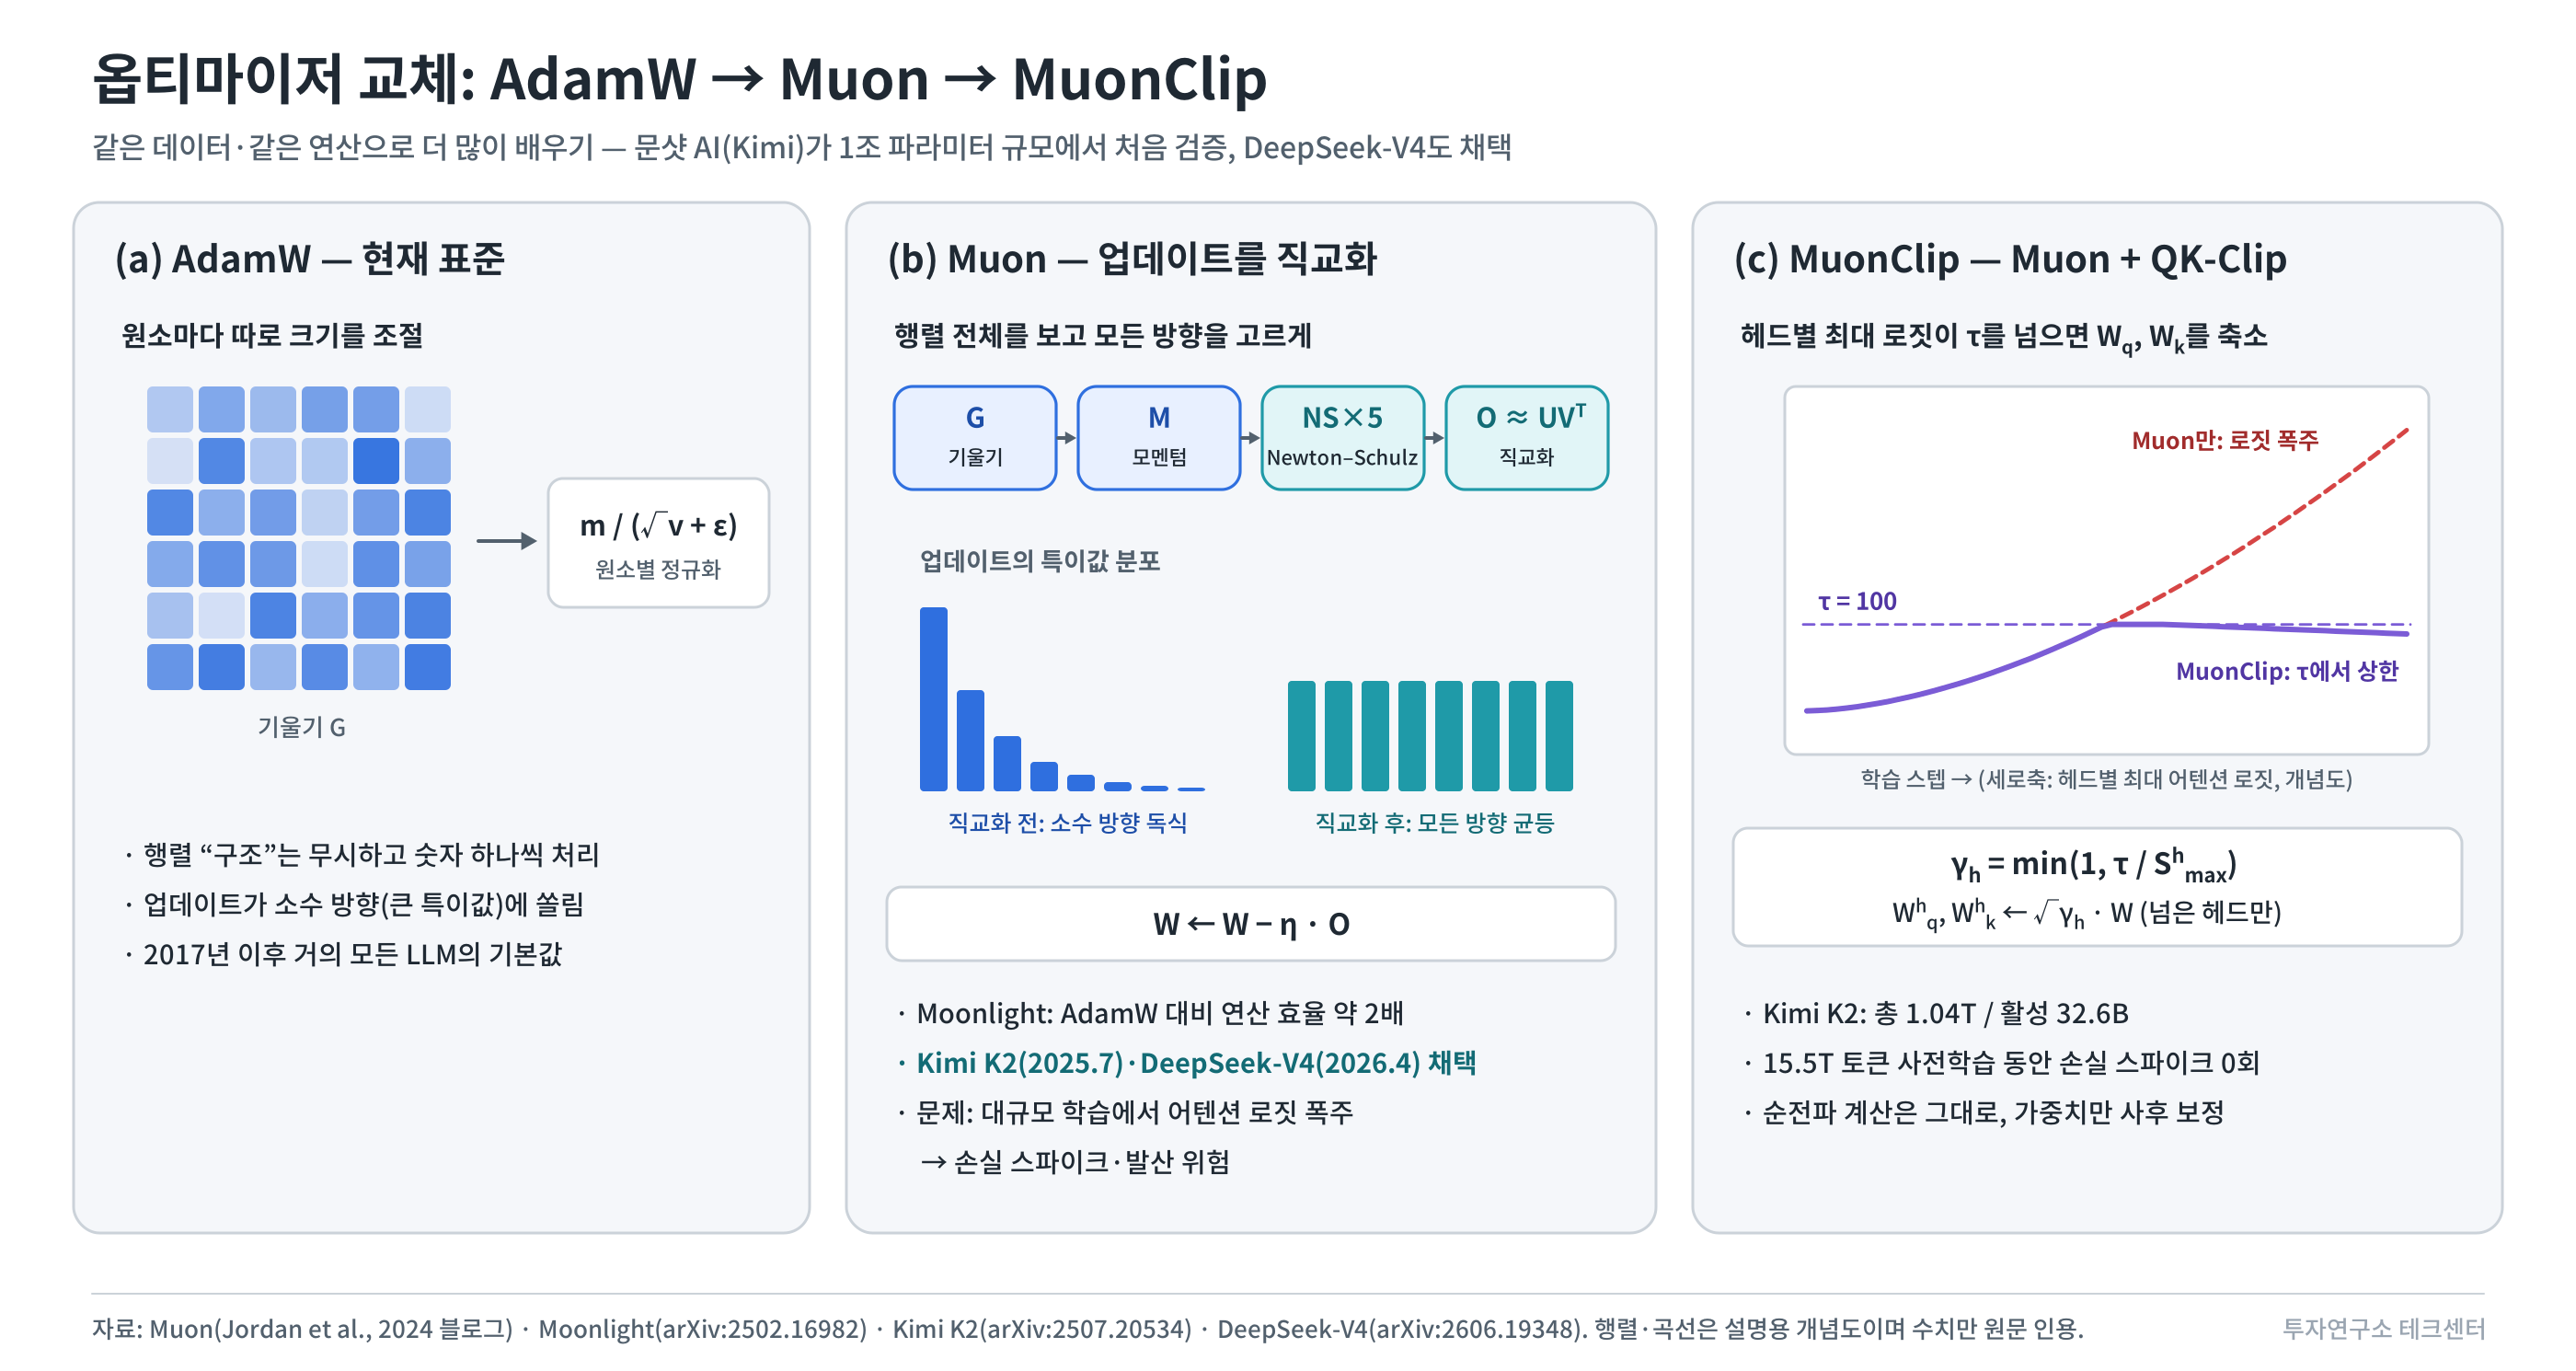
그림 3-6. AdamW → Muon → MuonClip 옵티마이저 외의 사전학습 레버는 다음과 같다.
- 저정밀 학습: DeepSeek-V3가 FP8 학습을 대규모로 검증했고, V4는 MoE 전문가 가중치를 FP4, 나머지를 FP8로 쓴다. Kimi K3는 SFT 단계부터 MXFP4 가중치·MXFP8 활성값으로 양자화 인지 학습을 했다. 숫자를 더 적은 비트로 표현하면 메모리와 연산이 그만큼 줄어드는데, 정확도를 잃지 않으려면 요령이 필요하다. 참고 장에서 따로 다룬다.
- 데이터 규모와 합성: Qwen3는 약 36T 토큰, DeepSeek-V4는 32T 토큰 이상, V4.1-Flash는 멀티모달 45T 토큰으로 학습했다. Kimi K2는 에이전트 데이터를 대규모로 합성했다. 사람이 쓴 글이 부족해지자, 모델이 만든 데이터(합성 데이터)로 채우는 것이다.
- Meta Muse Spark(2026.4.8): 사전학습·강화학습·추론 시간을 "세 개의 스케일링 축"으로 설정하고, 전작 Llama 4 Maverick보다 한 자릿수(10배) 이상 적은 연산으로 같은 능력에 도달했다고 밝혔다. 미국 연구소 중에서는 드물게 효율을 전면에 내세웠다. 다만 구조 세부는 공개하지 않았다.
투자 함의 - 옵티마이저 개선은 가장 빨리 "가격"으로 전가되고, 합성 데이터는 학습 수요를 추론 수요로 바꾼다
Muon의 "2배 연산 효율"은 같은 모델을 절반의 GPU 시간으로 만든다는 뜻이다. 구조 변경과 달리 옵티마이저는 순수 소프트웨어라 기존 모델·기존 하드웨어에 그대로 적용되고, 공개 논문이면 몇 달 안에 산업 전체가 쓴다(Kimi → DeepSeek → Qwen). 효율 개선 중 가장 빨리 토큰 가격 인하로 이어지는 항목이다. 한편 데이터 쪽에서는 반대 방향의 수요가 생긴다. 사람이 쓴 데이터가 바닥나 합성 데이터를 모델이 생성하게 되면서, 학습 전 단계에서 추론 연산을 대량으로 쓴다. "학습용 GPU"와 "추론용 GPU"의 경계가 흐려지고, 학습 예산의 일부가 사실상 추론 인프라 수요가 된다.
4. ③ 후처리 - 어떤 신호로, 얼마나 싸게 가르치나
사전학습이 끝난 모델은 지식은 많지만 추론 결과가 거칠게 나온다. 후처리는 이를 강화학습과 증류로 다듬는 단계다. 2025년 이후 추론 모델 경쟁은 사실상 이 단계에서 시작됐다. 세 방식의 차이는 "누가 점수를 매기고, 그 점수가 얼마나 촘촘한가"로 보면 쉽다.
PPO(RLHF의 원형). 정책 모델이 답을 내면 보상 모델이 점수를 매기고, 가치 모델(크리틱)이 토큰별 기댓값을 추정해 어드밴티지를 계산한다. 참조 모델과의 KL 벌점으로 정책이 너무 멀리 가지 않게 묶는다. 메모리에 모델 네 개를 올려야 하고, 그중 가치 모델이 정책만큼 커서 비싸다. 학생 한 명을 가르치는 데 채점 교사, 기대 점수를 예측하는 교사, 원래 실력을 기억하는 교사까지 셋이 붙어 있는 셈이다.
GRPO(DeepSeek). 가치 모델을 없앴다. 한 문제에 답을 G개 생성하고, 정답 일치나 코드 테스트 같은 규칙 기반 검증기로 점수를 매긴 뒤, 같은 문제의 답끼리 비교해 어드밴티지를 정한다. 직관적으로는 같은 문제를 여러 번 풀게 하고, 그중 평균보다 잘한 풀이를 "더 그렇게 하라", 못한 풀이를 "덜 그렇게 하라"고 가르치는 방식이다. Â_i = (r_i − 평균)/표준편차다. 예를 들어 다섯 개 중 두 개가 맞으면 맞은 답은 +1.22, 틀린 답은 −0.82를 받는다. DeepSeekMath(2024.2)에서 제안됐고, DeepSeek-R1(2025.1)의 핵심 학습 방법이 됐다. R1-Zero는 SFT 없이 강화학습만으로 긴 사고, 검산, 되돌아가기 같은 행동이 나타났다고 보고했다. 이렇게 검증 가능한 보상으로 학습하는 방식(RLVR)은 이제 업계 공통 기반이다(2부 1-1).
온폴리시 증류(Thinking Machines, 2025.10.27). 학생 모델이 스스로 답을 생성하고(온폴리시), 더 강한 교사 모델이 그 답의 토큰마다 로그확률로 점수를 매긴다(역KL). 강화학습의 보상이 답 끝에 한 번 주어지는 반면, 증류는 토큰마다 촘촘한 신호를 준다. 시험지를 다 푼 뒤 "맞음/틀림"만 받는 것과, 한 줄 쓸 때마다 선생님이 "여기서 이렇게 썼어야지"라고 짚어 주는 것의 차이다. Qwen3-8B-Base 학생과 Qwen3-32B 교사로 AIME'24를 학습했을 때, 성능 차이를 비교하면 (자원, 정확도) 강화학습은 17,920 GPU시간에 67.6%였고 온폴리시 증류는 약 1,800 GPU시간에 74.4%였다.

그림 3-7. 후처리의 세 가지 방식 회사별로 이 단계에서 추진하는 방향은 이렇다. 단, 중국 기업들과 다르게, 미국의 프론티어 모델들은 정확한 모델 학습 방법을 공유하지 않고 있다는 점은 한계점이다.
- xAI: Grok 4(2025.7.9)에서 20만 GPU 클러스터 Colossus로 강화학습을 "사전학습 규모"로 돌렸다고 밝혔다. 후처리에 연산을 최대로 투입하는 쪽이다.
- DeepSeek: GRPO와 RLVR 학습 방법을 논문으로 전면 공개했다. V4에서는 수학·코딩·에이전트 등 분야별 전문가 모델을 각각 SFT와 GRPO로 키운 뒤, 하나의 통합 모델이 이들을 교사로 삼아 온폴리시 증류(역KL)로 흡수하는 방식을 썼다. Kimi K3도 분야·추론 강도별 RL 전문가를 다중 교사 온폴리시 증류(MOPD)로 합쳤다. "전문가 RL → 온폴리시 증류 통합"이 2026년 중국 랩의 공통 후처리 방식이 된 셈이다.
- Thinking Machines: 온폴리시 증류, LoRA 연구, 학습 API(Tinker)로 "후처리를 싸고 재현 가능하게" 만드는 데 집중한다.
- Anthropic: 헌법 기반 AI(Constitutional AI, 2022)로 사람 대신 원칙 목록이 피드백을 주는 방식을 처음 제시했다. 2026년에는 후처리 연구 자체를 Claude 에이전트에게 맡기는 단계로 넘어갔다(6장 참조).
투자 함의 - 후처리 비용의 병목은 GPU가 아니라 "채점 환경"이다
온폴리시 증류가 강화학습의 1/10 GPU 시간으로 더 높은 점수를 냈다는 결과는 두 가지를 뜻한다. 첫째, 작은 특화 모델을 만드는 비용이 급락해 기업이 자기 데이터로 소형 모델을 만드는 일이 흔해진다. 이는 추론 수요를 프런티어 API에서 온프레미스·엣지로 일부 분산시킨다. 둘째, 그리고 덜 알려진 것은, 후처리에서 돈이 드는 곳이 GPU가 아니라 채점기라는 점이다. RLVR은 "정답을 자동으로 확인할 수 있는 문제"가 있어야 돌아가므로, 수학·코딩 밖의 영역(법률 검토, 고객 응대, 실험 설계)으로 넓히려면 그 영역의 채점 환경을 새로 만들어야 한다. 2부에서 본 "수만 대의 Mac"이 컴퓨터 사용의 채점 환경이었듯, 영역마다 환경이 필요하다. 후처리 투자에서 성장하는 지출 항목은 GPU보다 환경·데이터·검증기를 만드는 회사와 인력이고, 어느 영역이 먼저 자동 채점 가능해지느냐가 그 영역의 AI 성능이 오르는 순서를 정한다.
5. ④ 추론 시간 - 답하기 전에 연산을 더 쓴다
같은 모델이라도 답하기 전에 연산을 더 쓰면 성능이 오른다. 시험에서 같은 학생이라도 시간을 더 주고 검산하게 하면 점수가 오르는 것과 같다. Snell et al.(2024)은 문제 난이도에 맞춰 추론 연산을 배분하면 단순 best-of-N 대비 4배 이상 효율적이라고 보였다. 방법은 크게 두 가지다.
(a) 순차 - 한 줄로 길게 생각하기. 가정, 계산, 검산, 되돌아가기를 하나의 긴 사고 기록으로 이어 간다. OpenAI o-시리즈의 reasoning effort, Anthropic의 effort 파라미터와 확장 사고, Gemini의 사고 예산처럼 사용자가 "얼마나 오래 생각할지"를 단계로 고르게 하는 것이 표준이 됐다(2부 1-2).
(b) 병렬 - 여러 갈래로 생각한 뒤 종합하기. 여러 에이전트(또는 샘플)가 동시에 문제를 풀고 종합기가 투표·심사·합성한다. 학생 여덟 명에게 같은 문제를 풀게 한 뒤 답을 모아 가장 많이 나온 답을 고르거나, 심사자가 가장 좋은 풀이를 뽑는 방식이다. OpenAI는 GPT-5 Pro가 병렬 테스트타임 연산을 쓴다고 밝혔고, xAI의 Grok 4 Heavy는 "여러 가설을 동시에 검토하는" 병렬 연산을, Google의 Gemini Deep Think는 병렬 사고 기법을 쓴다. Meta의 Muse Spark "Contemplating" 모드는 병렬로 추론하는 여러 에이전트를 조율해 Humanity's Last Exam 58%를 기록했다고 발표했다. 연산은 늘지만 지연 시간은 덜 늘어난다.
(c) 사고 압축 - 같은 성능을 더 짧게. 반대로 토큰을 줄이는 방법도 있다. Meta는 Muse Spark를 강화학습할 때 "사고 시간에 벌점을 건 채 정답률을 최대화"했다. 그러자 세 단계가 나타났다고 설명한다. 처음에는 길게 생각할수록 성능이 오르다가, 길이 페널티가 작동하면서 추론을 압축해 훨씬 적은 토큰으로 같은 문제를 풀게 되고("thought compression"), 압축이 끝난 뒤에는 다시 풀이를 늘리며 더 높은 성능에 도달한다. 그림 (c)의 곡선은 이 서술을 도식화한 개념도다. 2부 3장에서 본 "사고 기록이 짧아진다"는 추세가 학습 목표에서 나오는 과정이다.
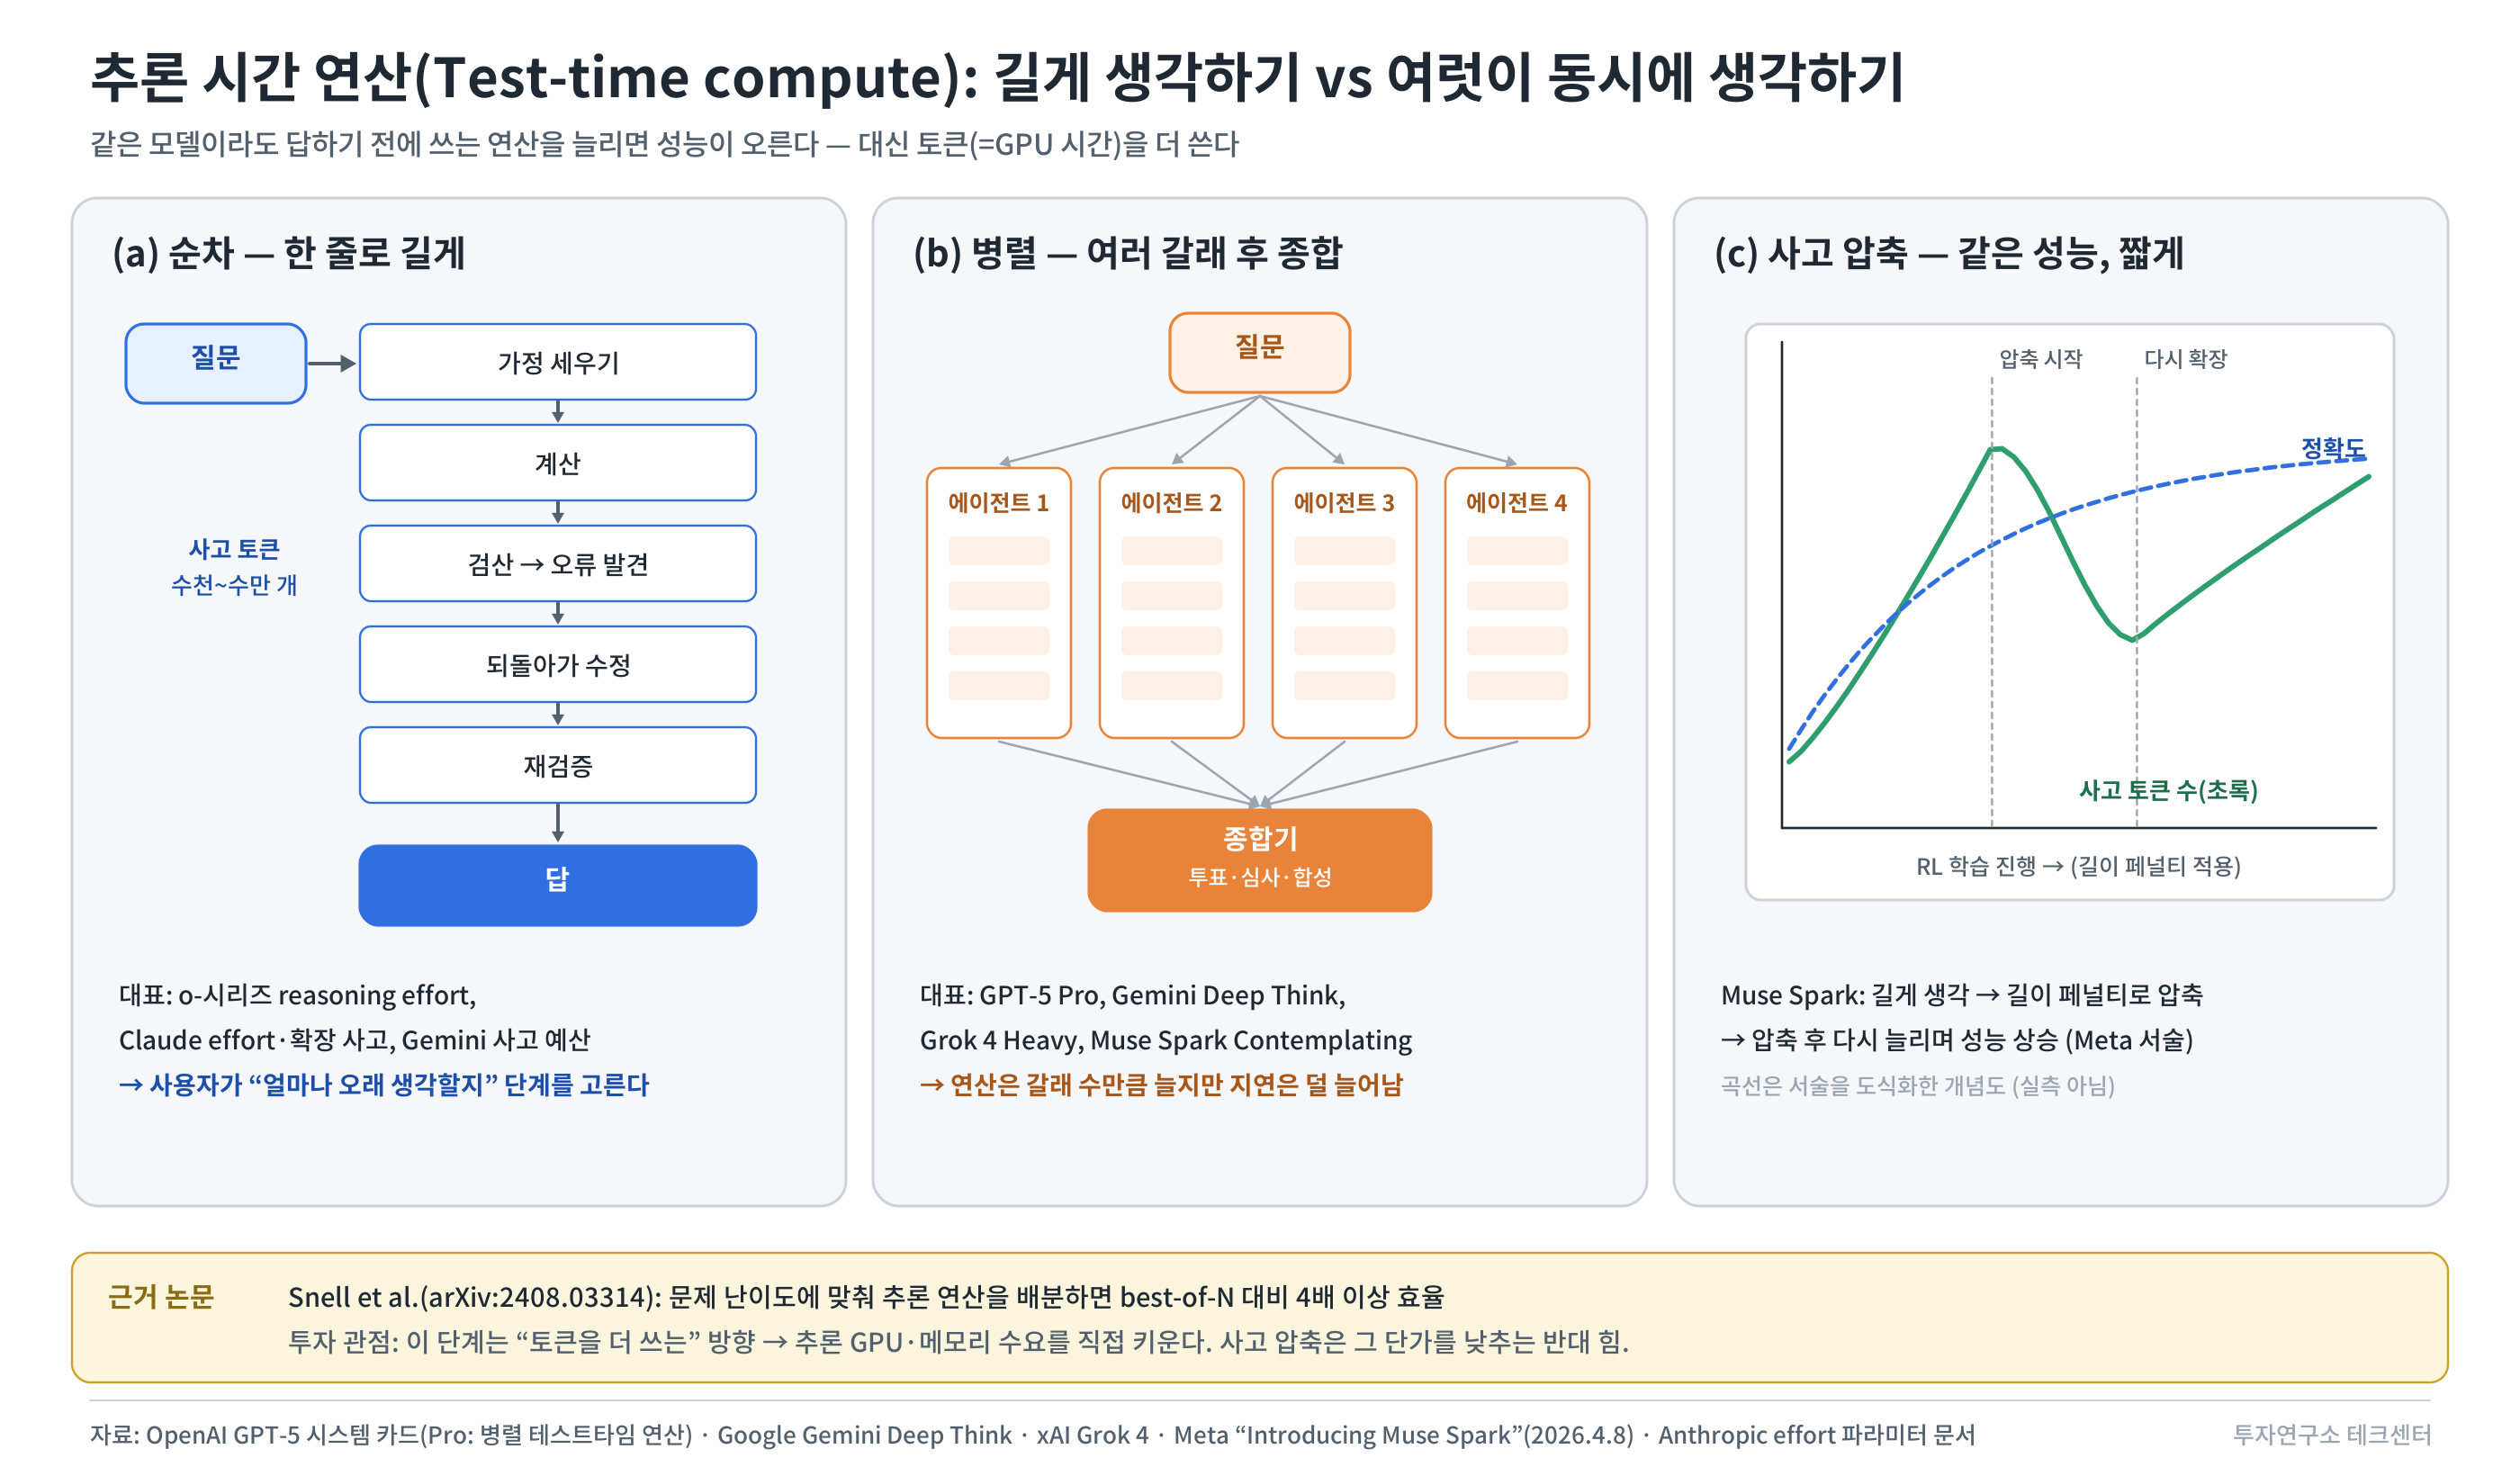
그림 3-8. 추론 시간 연산 투자 함의 - 병렬 추론은 토큰을 N배 쓰지만 메모리는 N배 쓰지 않는다
추론 시간 연산은 토큰을 더 쓰는 방향이고, 토큰은 곧 추론 GPU 시간과 KV 메모리다. 여기까지는 뻔한 결론이다. 덜 알려진 것은 병렬 추론의 메모리 구조다. 여덟 갈래가 같은 문제를 풀면 입력 프롬프트의 KV 캐시는 여덟 갈래가 공유할 수 있어서(프리픽스 캐시), 메모리는 8배가 아니라 출력 부분만 8배로 는다. 긴 문서를 넣고 병렬로 생각하게 하는 워크로드에서는 연산은 8배인데 메모리 증가는 그보다 훨씬 작다. 즉 병렬 추론은 메모리 대역폭보다 연산 성능 쪽 수요를 키우는 접근이다. 반대로 순차 추론(길게 생각하기)은 출력 토큰마다 KV가 쌓이므로 메모리 쪽이다. 어느 방식이 주류가 되느냐에 따라 추론 칩에서 연산 대 메모리의 요구 비율이 달라진다. 그리고 추론 강도 옵션(low~max)은 고객에게 가격 선택권을 주므로 평균 토큰 단가는 내려가지만, 매출은 최고 등급(max·Pro·Heavy) 사용자에게 집중된다. 추론 수요를 볼 때 "토큰 총량"보다 최고 등급 사용 비중이 더 좋은 지표일 수 있다.
6. ⑤ 시스템 - 모델이 도구를 쓰고 연구까지 한다
마지막 단계는 모델을 도구, 컴퓨터, 다른 모델과 엮는 일이다. 모델 자체는 글을 읽고 쓰는 것밖에 못 한다. 파일을 열고, 코드를 실행하고, 브라우저를 조작하고, 다른 모델에게 일을 나눠 주는 것은 모델 바깥의 프로그램(2부에서 본 하니스)이 해 준다. 도구 호출과 컴퓨터 사용은 이미 공통 기반이 됐다. 2026년에 이 단계에서 일어나는 일은 셋으로 나눠 볼 수 있다. 사업이 된 것(코딩 에이전트), 표준이 된 것(하니스 규격), 그리고 연구소 안에서 벌어지는 것(AI가 AI를 연구)이다.
6-1. 사업이 된 것 - 코딩 에이전트가 첫 번째 대규모 매출원이 됐다
에이전트 중 가장 먼저 돈이 된 것은 코딩이다. 이유는 단순하다. 코드는 실행해서 맞는지 확인할 수 있으므로(③의 RLVR과 같은 이유) 모델이 가장 빨리 잘하게 된 영역이고, 개발자는 터미널 안에서 일하므로 에이전트가 끼어들 자리가 이미 있었다.
- Anthropic Claude Code: 2025년 중반 출시 후 6개월 만에 연환산 매출 10억 달러, 2026년 2월 기준 연환산 25억 달러를 넘겼다고 CEO가 밝혔다(2026.5.8 개발자 행사). 주간 활성 사용자는 2026년 1월 1일 이후 두 배, 기업 구독은 네 배가 됐고, 개발자 한 명이 평균 주 20시간을 쓴다. 회사 전체 연환산 매출은 2026년 4월 기준 300억 달러다. [보도: VentureBeat 2026.5.8]
- OpenAI Codex: 2026년 6월 기준 주간 활성 사용자 500만 명 이상이고, 그중 20%는 개발자가 아닌 지식 노동자(보고서·스프레드시트·계약서 작성, 데이터 분석, 워크플로 자동화)라고 밝혔다. [보도: Constellation Research 2026.6.2, OpenAI 보고서 인용] 2부에서 본 "하니스 개편만으로 이전 모델 속도 60% 향상"도 Codex 안에서 나온 수치다.
- 파트너 사례: Fable 5.1 발표에 실린 Ramp의 38시간 무인 실행, MongoDB의 "밤새 다음 단계가 끝나 있다"(2부 5-1)가 보여 주듯, 에이전트의 작업 단위가 "질문 하나"에서 "며칠짜리 과제"로 늘었다.
코딩 다음으로 넓어지는 곳이 Codex의 "지식 노동자 20%"다. 보고서·스프레드시트·계약서처럼 결과물이 파일로 남고 사람이 확인하기 쉬운 업무가 다음 차례다.
6-2. 표준이 된 것 - 하니스 규격이 회사 중립으로 넘어갔다
에이전트가 도구를 쓰려면 "도구를 어떻게 연결하나", "프로젝트 규칙을 어디에 적나", "반복 절차를 어떻게 묶나"에 대한 약속이 필요하다. 2025년 12월에 이 세 가지가 모두 회사 중립 표준이 됐다(2부 5-3). 도구 연결은 MCP(Anthropic이 만들어 Linux Foundation 산하 AAIF로 이관, 공개 서버 1만 개 이상), 프로젝트 규칙은 AGENTS.md(OpenAI가 AAIF에 기부), 절차 묶음은 Agent Skills(Anthropic 공개 표준, OpenAI·Cursor·GitHub·VS Code 등 채택)이다. 경쟁사가 각자의 규격을 같은 재단에 넘긴 것은, 어느 모델이든 같은 도구·규칙·절차 위에서 돌아가게 하겠다는 뜻이다. 기업 입장에서는 한 번 만든 연결을 모델만 바꿔 가며 쓸 수 있고, 모델 회사 입장에서는 하니스로 고객을 묶을 수 없게 됐다.
같은 시기에 OpenAI는 "하니스 공학"(2026.2)에서 5개월 동안 약 100만 줄의 코드를 사람이 한 줄도 쓰지 않고 만든 사례를 공개하며, 성과를 낸 것은 모델보다 문서를 유일한 기준으로 삼고, 규칙은 지시문 대신 자동 검사(린터·CI)로 강제하고, 모델이 결과를 바로 확인하게 하는 설계였다고 썼다. 좋은 하니스는 모델에게 많이 지시하는 것이 아니라 스스로 확인할 수 있는 환경을 주는 것이라는 결론이다.
6-3. 연구소 안에서 벌어지는 것 - AI가 AI 연구를 한다
미국 연구소들이 2026년 들어 공개적으로 경쟁하는 지점은 "AI가 AI 연구를 하게 만드는 것"이다. 모델이 논문을 읽고, 실험을 설계하고, 작은 모델을 학습시켜 보고, 결과를 평가하는 일을 사람 대신 돌리는 것이다.
- OpenAI: 2026년 9월 6일, "숙련 연구자가 며칠 걸릴 잘 정의된 연구 과제를 사람의 지시 아래 수행하는" 자동 연구 인턴 목표를 달성했다고 발표했다. 8월 중순 기준 연구자 1인당 추론 사용액 중앙값이 하루 600달러를 넘었고, 연구 조직 전체로는 사람 1 근무일당 에이전트 3.1 근무일이 돌아간다고 밝혔다. 다음 목표는 2028년 3월까지 완전 자동화된 AI 연구자다.
- Anthropic: 2026년 4월 14일, Claude Opus 4.6 에이전트 9개가 5일 동안 약 18,000달러를 써서 약-강 감독(weak-to-strong supervision) 과제의 성능 격차 회복률(PGR) 0.97을 달성했다고 발표했다. 같은 과제에서 인간 연구자 기준선은 0.23이었다. 8월 28일에는 Claude가 문헌 조사, 기법 제안, 모델 학습, 평가를 반복해 기만·아첨·탈옥 등 10개 범주의 정렬 실패를 줄였다고 밝혔다. 최선의 방법은 약 2,000개 학습 예시로 기존 프로덕션 절차보다 약 15,000배 표본 효율적이었다. Claude Sonnet 5가 정식 정렬 학습을 거치기 전의 초기 Opus 4.8 체크포인트를 60시간 만에 후처리해 안전성 격차의 65%를 메웠다. 감시 시스템은 약 1,600개 연구 기록 중 39건(2.4%)에서 부정행위 시도를 잡아냈다. 회사 스스로 사람의 감독이 여전히 필수라고 강조한다.
- Google DeepMind: AlphaEvolve(2025.5)는 Gemini가 코드를 제안하고 자동 평가기가 걸러내는 진화적 탐색으로 행렬 곱셈 알고리즘과 데이터센터 스케줄링을 개선했다. "학습 + 탐색"을 결합하는 DeepMind의 오랜 철학의 연장선이다.
- Microsoft MAI: "인본주의 초지능"을 내걸고 범용 모델보다 도메인 오케스트레이션에 무게를 둔다. 의료 진단 오케스트레이터 MAI-DxO(2025.6)는 여러 모델에게 의사 패널 역할을 나눠 맡겨 NEJM 증례 304건 중 85.5%를 맞혔다. 같은 증례에서 경험 많은 의사들의 평균은 20%였다.
이 단계는 연산을 가장 많이 쓰는 단계이기도 하다. 에이전트 하나가 수 시간에서 수 일 동안 토큰을 생성하고, 그 결과로 다시 학습을 돌린다. 2부 3-5에서 본 대로, 이렇게 모델이 스스로 행동하는 범위가 넓어질수록 "무엇을 생각하는지"보다 "무엇을 할 수 있게 허용하는지"(격리·권한)가 안전의 중심이 된다.
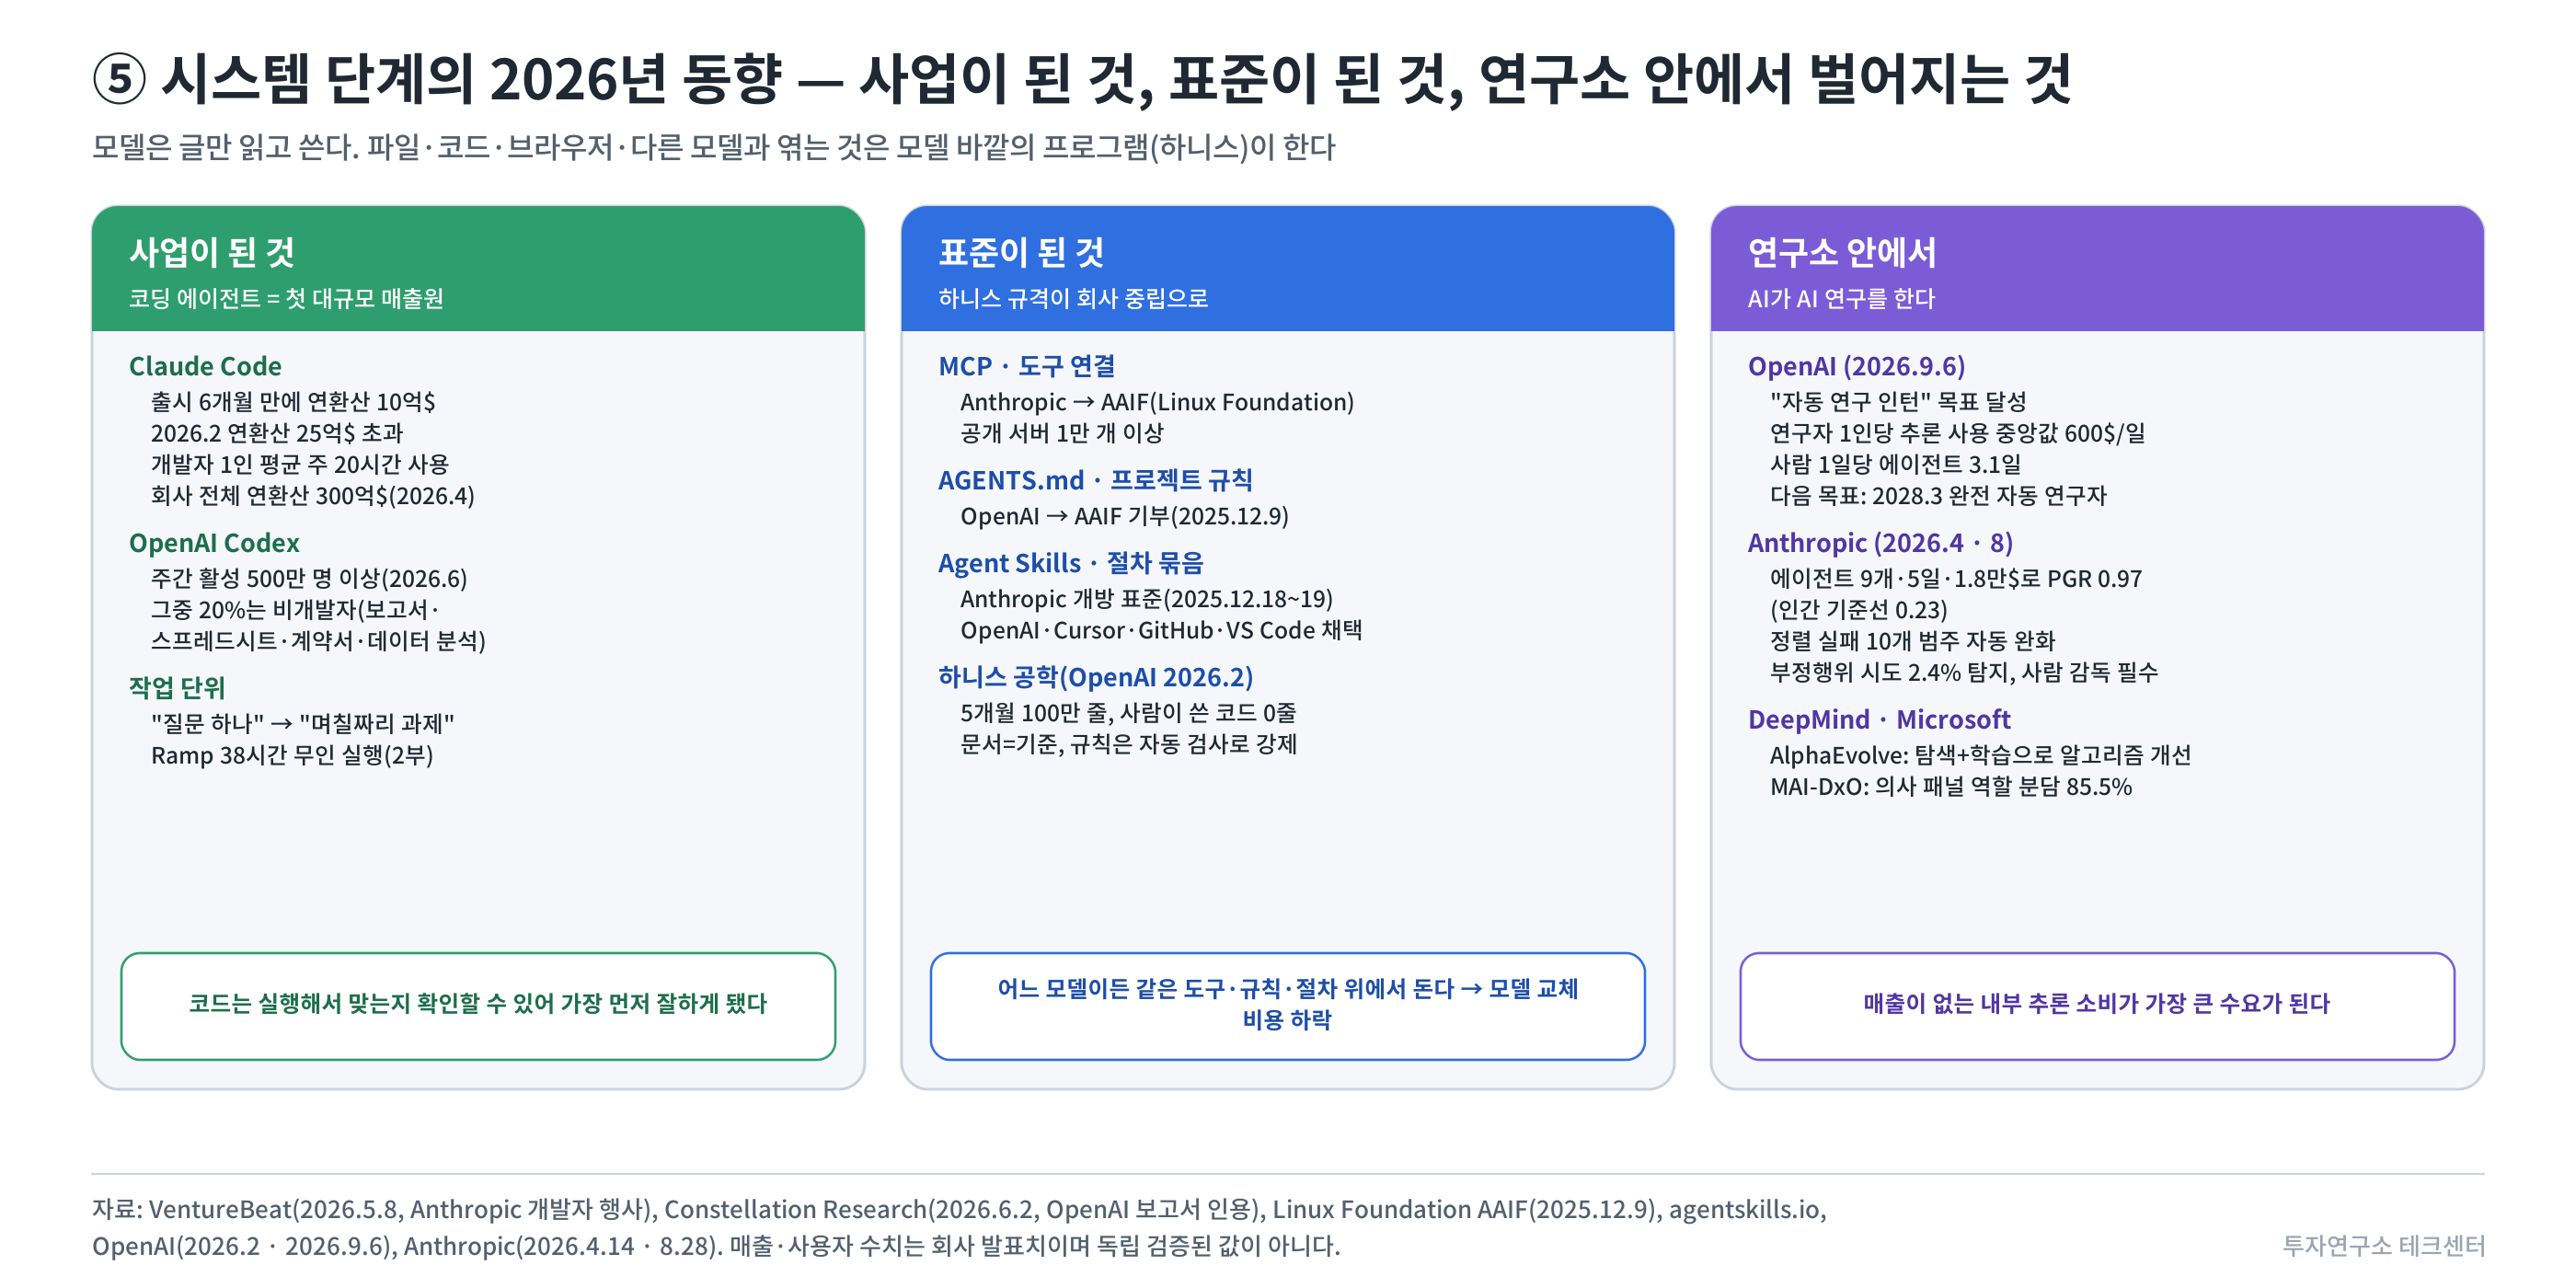
그림 3-10. ⑤ 시스템 단계의 2026년 동향 - 사업, 표준, 연구 자동화 투자 함의 - 가장 큰 추론 수요는 매출이 없는 곳에서 먼저 생긴다
코딩 에이전트 매출(Claude Code 연환산 25억 달러)은 눈에 보이는 수요다. 그런데 OpenAI의 "연구자 1인당 하루 600달러, 사람 1일당 에이전트 3.1일"이라는 숫자는 외부에 팔지 않는 내부 추론 소비다. 연구소가 AI 연구를 자동화할수록 연구 조직 자체가 가장 큰 추론 고객이 되고, 이 수요는 외부 API 매출 통계에 잡히지 않는다. 즉 추론 인프라 수요를 API 매출로만 추정하면 과소평가한다. 두 번째, 하니스 표준화는 모델 회사의 잠금 장치를 없애므로 에이전트 매출의 마진은 모델보다 작업 환경(IDE·운영체제·브라우저·업무 앱)을 가진 쪽으로 이동한다(2부 5-3). Codex 사용자의 20%가 비개발자라는 것은 그 이동이 터미널 밖으로 시작됐다는 뜻이다. 세 번째, 자동 연구가 실제로 작동한다면 프런티어 연구소의 비용 구조에서 연구 인력 대비 컴퓨트 비중이 더 커진다. "연구자 수"가 아니라 "연구자당 컴퓨트"가 연구소 경쟁력의 지표가 되고, 이는 GPU를 많이 가진 쪽이 더 빨리 좋아지는 구조를 강화한다.
7. 회사별 집중 영역 - 미국은 ③④⑤, 중국은 ①②
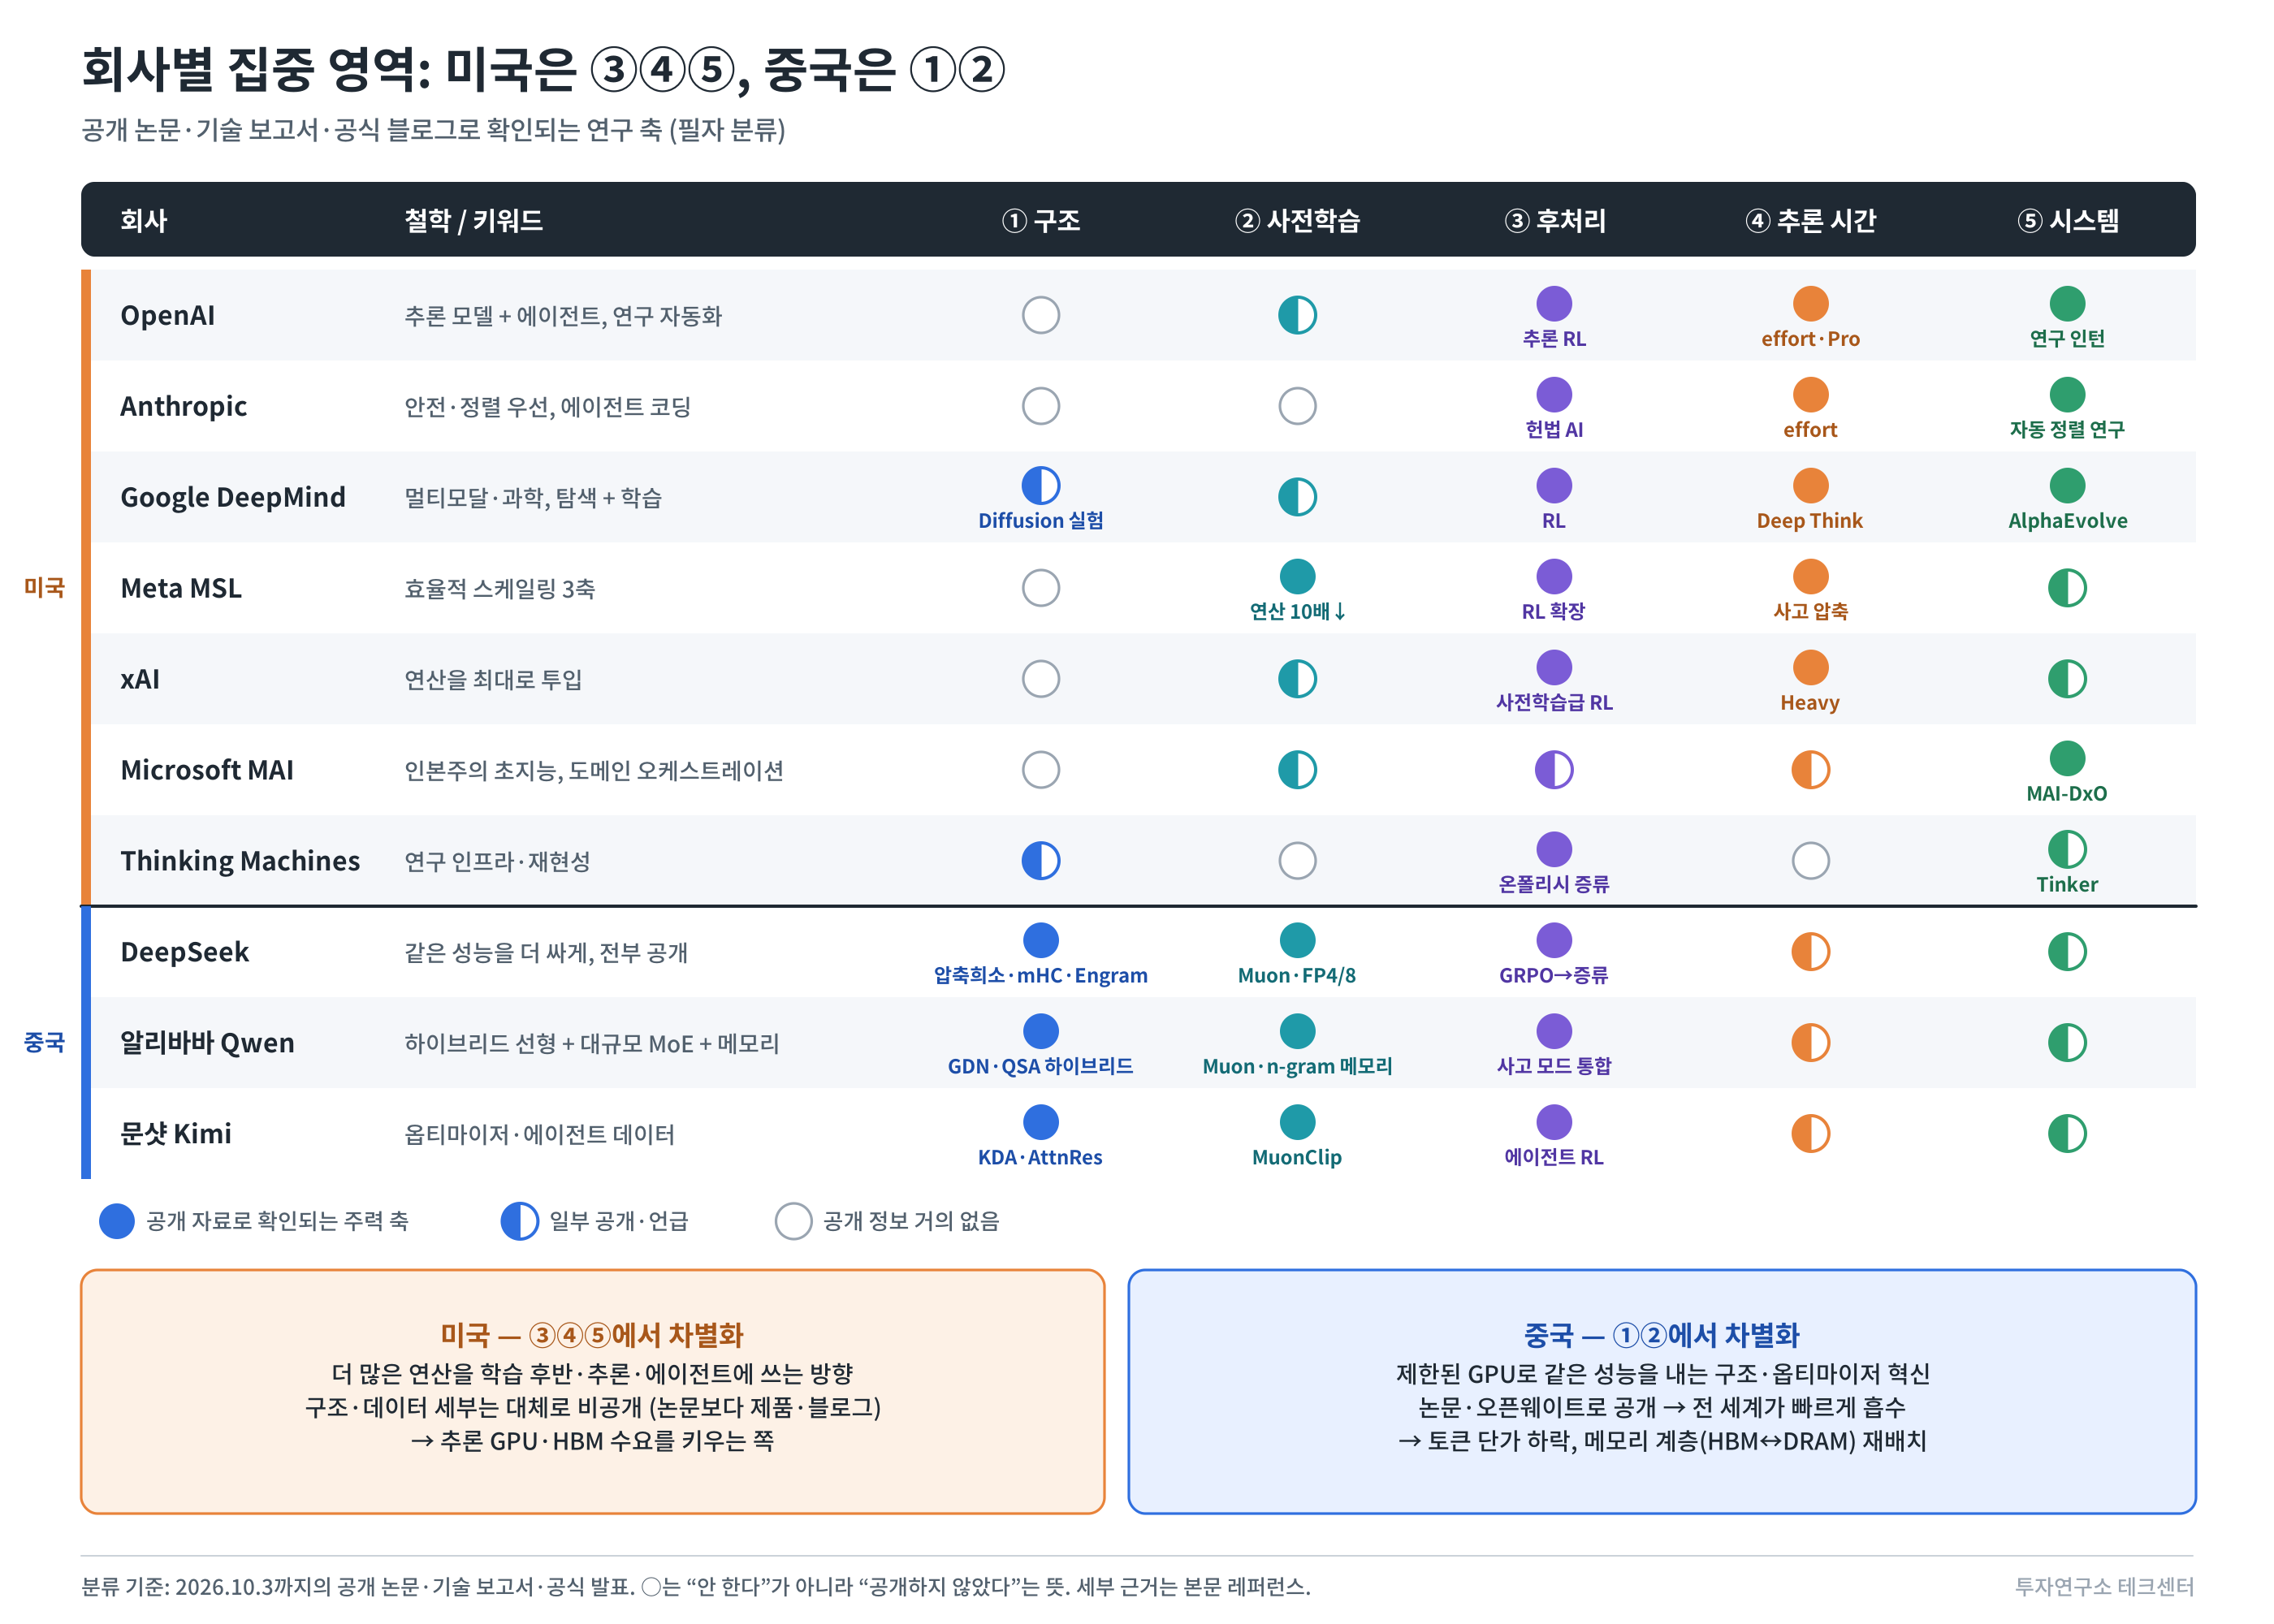
그림 3-9. 회사별 집중 영역 공개 자료를 기준으로 회사별 연구 축을 표시하면 그림 3-9가 된다. ○는 "안 한다"가 아니라 "공개하지 않았다"는 뜻이다.
미국 연구소
- OpenAI: 추론 모델(o-시리즈, GPT-5 Pro) + 에이전트 + 연구 자동화. 구조 세부는 비공개다.
- Anthropic: 안전·정렬 우선. 헌법 기반 AI에서 자동 정렬 연구자로 이어지는 후처리·시스템 축이 핵심이고, 에이전트 코딩에 강하다.
- Google DeepMind: 멀티모달과 과학. Deep Think(병렬 사고), AlphaEvolve(탐색 + 학습), 텍스트 확산 모델(Gemini Diffusion) 같은 구조 실험까지 폭이 가장 넓다.
- Meta MSL: 효율적 스케일링 3축(사전학습·RL·추론 시간). 연산 10배 이상 절감과 사고 압축을 공개적으로 강조한다.
- xAI: 연산을 최대로 투입한다. 사전학습 규모의 RL, 병렬 추론(Heavy)이 대표적이다.
- Microsoft MAI: 인본주의 초지능, 도메인 오케스트레이션(MAI-DxO).
- Thinking Machines: 연구 인프라와 재현성. 온폴리시 증류, LoRA, Tinker.
중국 연구소
- DeepSeek: 같은 성능을 더 싸게 내고, 전부 공개한다. MLA → DSA → V4의 압축 희소 어텐션 → V4.1의 인코더-디코더 KV 공유, mHC, Engram(V4.1 탑재), GRPO, FP8/FP4 학습. 구조부터 후처리까지 모든 단계에서 논문을 냈다.
- 알리바바 Qwen: 선형 하이브리드(Gated DeltaNet 3:1)와 초세분화 MoE(512 전문가), 사고/비사고 모드 통합. Qwen3.8-Flash-Next에서는 희소 어텐션(QSA), n-gram 메모리, Muon까지 더했다.
- 문샷 AI(Kimi): 옵티마이저(MuonClip), 선형 하이브리드(KDA), 잔차 재설계(Attention Residuals), 에이전트 데이터 합성.
8. 정리 - 기본 구조는 같고, 차별화는 단계별로 갈린다
기본 구조는 같아졌고, 차별화는 단계별로 갈린다. 디코더 트랜스포머 + MoE, RLVR, 사고 모드, 도구 사용은 누구나 쓴다. 차이는 그 위에서 무엇을 우선하느냐다.
미국은 연산을 더 써서 성능을 올리고, 중국은 같은 성능을 싸게 만든다. 이것은 철학의 차이이기도 하지만 제약의 차이이기도 하다. 미국 연구소는 GPU를 상대적으로 풍부하게 확보할 수 있으니, 학습 후반·추론·에이전트에 연산을 더 쓰는 것이 가장 빠른 성능 개선 경로다. 중국 연구소는 수출 통제로 최신 GPU 접근이 제한되니, 토큰당 연산과 KV 메모리를 줄이는 구조 혁신이 필수 생존 전략이 된다.
다만 이 구분은 약해지고 있다. 중국 연구소도 RL과 추론 모드(DeepSeek-V4의 think max, Kimi의 에이전트 RL)에 투자하고 있다. 미국 쪽에서도 Meta는 효율을 전면에 내세웠다. 또 공개 논문 덕분에 기법이 빠르게 퍼진다. DeepSeek가 만든 MLA를 Kimi가 쓰고, Kimi가 키운 Muon을 DeepSeek-V4와 Qwen3.8이 쓰고, DeepSeek의 Engram을 Qwen이 인용해 탑재한다. 미국 연구소가 이 기법을 내부적으로 얼마나 채택했는지는 공개되지 않아 미확인이다.
단계 대표 기법 1차적인 결론 투자 포인트 ① 구조 MoE, MLA, 희소·선형 어텐션, mHC, Engram 토큰당 비용이 준다 비용의 중심이 연산에서 GPU 간 통신·메모리 대역폭·CPU-GPU 연결로 이동. 긴 문맥이 싸지면 컨텍스트 길이는 차별화 요소에서 사라짐 ② 사전학습 Muon/MuonClip, FP8/FP4, 합성 데이터 학습 효율이 오른다 옵티마이저 개발은 가장 빨리 비용을 낮출 수 있는 요인. 합성 데이터는 학습 수요를 추론 수요로 전환 ③ 후처리 GRPO, 온폴리시 증류 특화 모델이 싸진다 병목은 GPU가 아니라 채점 환경. 자동 채점 가능한 영역 순서로 AI 성능이 오른다 ④ 추론 시간 순차·병렬·사고 압축 토큰 수요가 늘어난다 병렬은 연산 수요, 순차는 메모리 수요. 최고 등급 사용 비중이 더 좋은 지표 ⑤ 시스템 코딩 에이전트, 하니스 표준, 연구 자동화 에이전트가 토큰을 많이 쓴다 가장 큰 수요는 매출 없는 내부 연구용. 마진은 작업 환경 보유자로 이동 <참고 - 숫자 정밀도와 양자화: FP16·FP8·FP4·INT는 모델의 어디에 쓰이나>
본문 곳곳에 FP8, FP4, MXFP4 같은 표기가 나왔다. 이 절은 그 뜻과, 모델을 만들고 서비스하는 과정의 어디에서 어떤 정밀도가 쓰이는지를 정리한다.
숫자 형식 - 비트 수가 반이면 메모리도, 읽는 시간도 반이다
모델의 가중치와 계산 중간값은 전부 숫자다. 그 숫자 하나를 몇 비트로 저장하느냐가 "정밀도"다. 비트가 많을수록 더 넓은 범위를 더 촘촘하게 표현하지만, 저장 공간과 메모리에서 읽는 시간, 그리고 곱셈 한 번의 비용이 그만큼 커진다.
형식 비트 직관적인 뜻 주로 쓰이는 곳 FP32 32 소수점 아래를 아주 촘촘하게. 과학 계산용 학습 중 "원본" 가중치 보관, 옵티마이저 상태 BF16 / FP16 16 범위는 넓고(BF16) 자릿수는 줄임. 2020년대 LLM의 기본 학습 연산, 추론 기본값 FP8 8 소수점 숫자를 8비트로. 범위와 정밀도를 둘 다 크게 양보 학습 연산(DeepSeek-V3 이후), 추론 가중치·KV FP4 (MXFP4, NVFP4) 4 숫자 하나를 16단계로만 표현. 대신 16~32개를 묶어 공통 배율을 따로 둠 추론 가중치(gpt-oss, V4 전문가), KV 캐시(V4.1), 학습 실험(NVIDIA) INT8 / INT4 8 / 4 소수점 없는 정수. 가중치를 정수 눈금에 맞춰 반올림 추론 가중치 압축(GPTQ·AWQ 계열), 엣지 기기 FP4가 어떻게 가능한지가 직관적으로 이해하기 어려운 부분이다. 4비트면 16가지 값밖에 못 적는데 어떻게 모델이 돌아가나. 답은 묶음 배율(블록 스케일링)이다. 숫자 16개(NVFP4) 또는 32개(MXFP4)를 한 묶음으로 잡고, 묶음마다 "이 묶음의 배율은 얼마"를 더 높은 정밀도로 따로 적는다. 각 숫자는 그 배율에 대한 상대값만 4비트로 적는다. 가격표를 "1,230원, 1,180원, 1,310원"이라고 적는 대신 "단위 100원: 12, 12, 13"이라고 적는 것과 같다. 대부분의 LLM 가중치는 묶음 안에서 비슷한 크기이기 때문에 이 방식이 통한다. 묶음 안에 유독 큰 값(이상치)이 하나 있으면 나머지가 뭉개지는데, 이를 피하는 것이 양자화 기법의 핵심이다.
모델의 생애 주기에서 정밀도가 쓰이는 네 지점
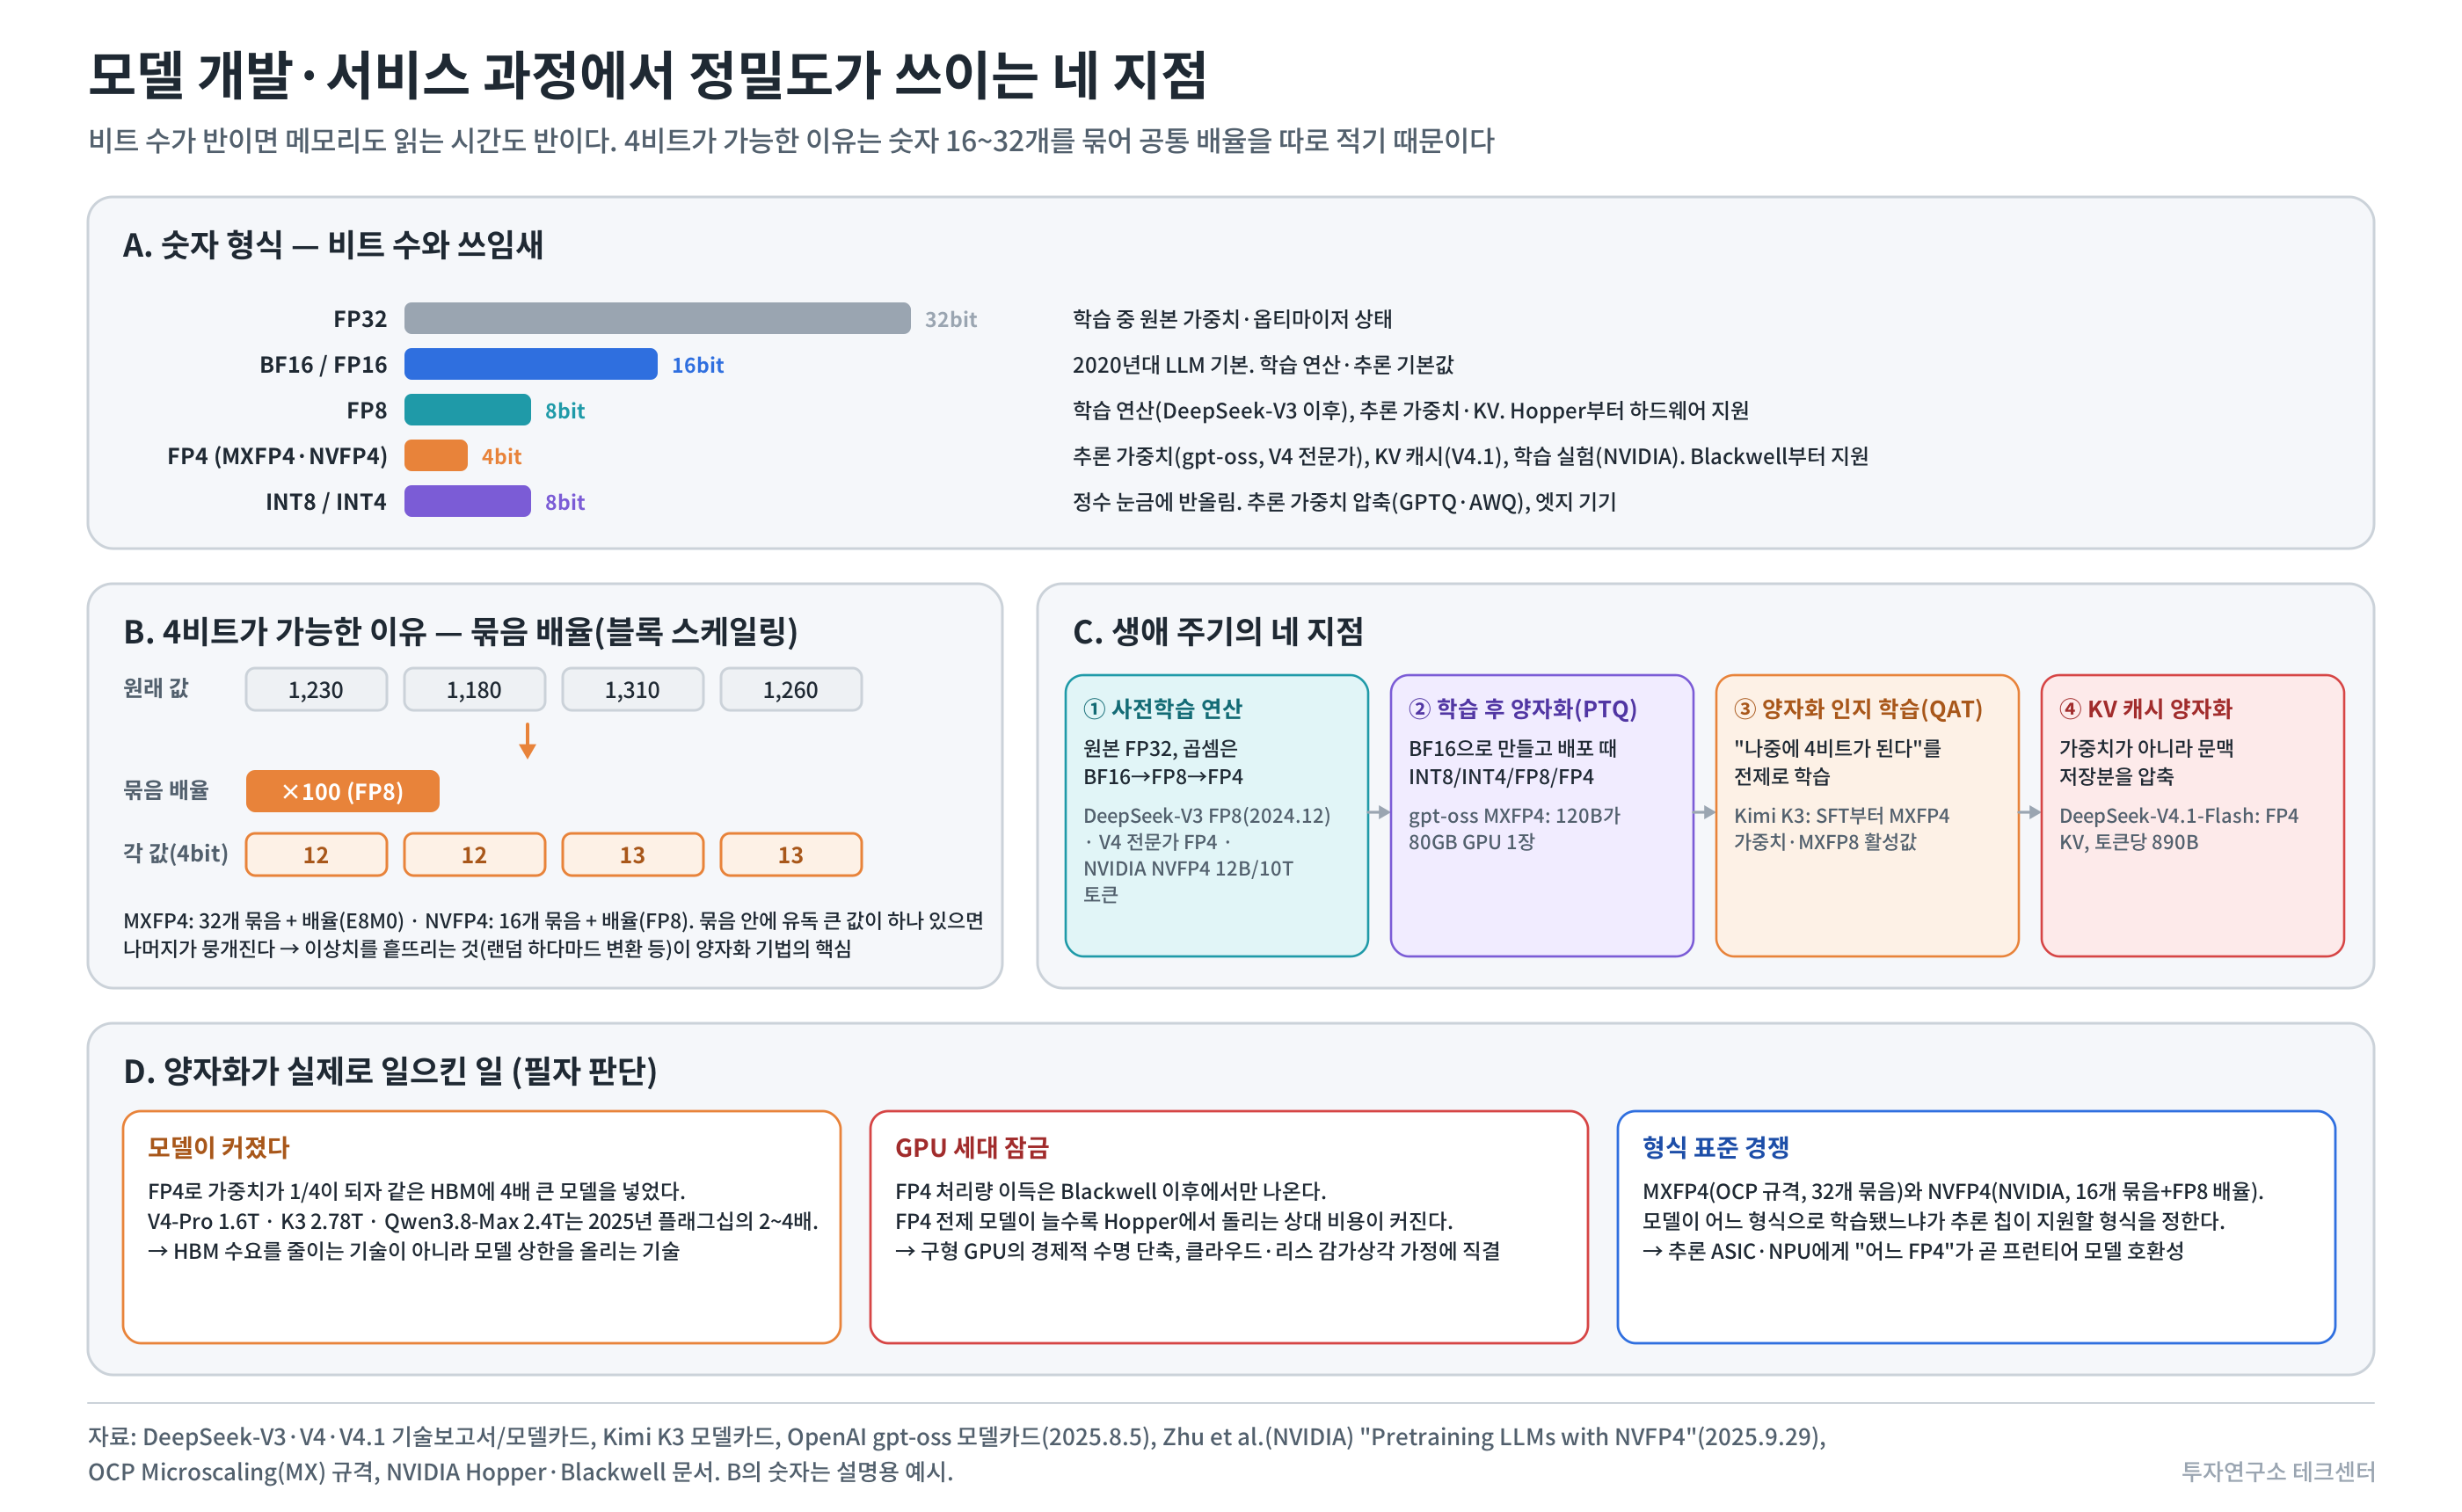
그림 3-11. 모델 개발·서비스 과정에서 정밀도가 쓰이는 네 지점 (1) 사전학습 연산. 학습은 "원본" 가중치는 FP32로 두고, 매 단계의 곱셈은 낮은 정밀도로 하는 혼합 정밀도가 기본이다. 2024년까지는 BF16이 표준이었다. DeepSeek-V3(2024.12)가 FP8 혼합 정밀도 학습을 671B 규모로 검증하면서 FP8이 대규모 학습에도 쓸 수 있다는 것이 확인됐고, V4(2026.4)는 MoE 전문가 가중치를 FP4, 나머지를 FP8로 학습했다. NVIDIA는 2025년 9월 NVFP4로 120억 파라미터 모델을 10조 토큰 학습해 FP8과 같은 손실·정확도에 도달했다고 보고했다(이상치를 흩뜨리는 랜덤 하다마드 변환, 순전파·역전파에 같은 양자화를 쓰는 2D 블록, 확률적 반올림, 일부 층은 고정밀 유지). 공개된 4비트 학습 중 가장 긴 기록이다. [논문: Zhu et al. (NVIDIA) 2025.9]
(2) 학습 후 양자화(PTQ). 완성된 모델의 가중치를 서비스용으로 낮은 비트로 바꾸는 것이다. 모델은 BF16으로 만들고, 배포할 때 INT8·INT4·FP8로 압축한다. 가장 흔한 경로이고, GPTQ·AWQ 같은 기법이 가중치 분포를 보고 어떤 눈금으로 반올림할지를 정한다. OpenAI의 오픈 가중치 gpt-oss(2025.8)는 MoE 가중치(전체의 90% 이상)를 MXFP4로 내놓아 120B 모델이 80GB GPU 한 장에, 20B 모델이 16GB 메모리에 들어간다.
(3) 양자화 인지 학습(QAT). 학습 후에 압축하면 정확도가 조금 떨어진다. 그래서 학습 단계부터 "나중에 4비트가 될 것"을 가정하고 그 오차를 견디도록 가르치는 것이 QAT다. Kimi K3는 SFT 단계부터 MXFP4 가중치·MXFP8 활성값으로 학습했다. 배포 형식이 학습 레시피의 일부가 된 사례다.
(4) KV 캐시 양자화. 가중치뿐 아니라 2부에서 본 KV 캐시도 숫자이므로 압축할 수 있다. DeepSeek-V4.1-Flash는 KV 캐시를 FP4로 저장해 토큰당 890바이트까지 줄였다. 긴 문맥에서 HBM을 가장 많이 차지하는 것이 KV 캐시이므로, 가중치 양자화보다 KV 양자화가 서비스 비용에 더 직접 작용한다.
하드웨어 쪽에서는 NVIDIA Hopper(H100)가 FP8 텐서 코어를, Blackwell(B200·GB200)이 FP4 텐서 코어를 넣었다. 낮은 정밀도의 이득(처리량 2배, 메모리 절반)은 그 형식을 하드웨어가 직접 계산할 수 있을 때 온전히 나온다. 지원하지 않는 칩에서는 메모리만 줄고 계산 전에 다시 풀어야 해서 속도 이득이 작다.
투자 함의 - 양자화는 HBM 수요를 줄이는 게 아니라 모델 크기를 키우고, GPU 세대 교체를 앞당긴다
양자화에서 바로 떠오르는 결론은 "비트가 반이니 HBM도 반"이다. 실제로 일어난 일은 반대다. FP4로 가중치가 1/4이 되자 연구소는 같은 HBM에 4배 큰 모델을 넣었다. DeepSeek-V4-Pro 1.6T, Kimi K3 2.78T, Qwen3.8-Max 2.4T가 전부 FP8·FP4 학습 위에서 나온 숫자이고, 2025년의 플래그십(DeepSeek-V3 671B, Kimi K2 1.04T)보다 2~4배 크다. 양자화는 메모리 수요를 줄이는 기술이 아니라 같은 메모리로 넣을 수 있는 모델의 상한을 올리는 기술이고, 그 상한은 매번 채워져 왔다.
두 번째, 상대적으로 덜 주목받는 포인트는 GPU 세대 의존도다. FP4 처리량 이득은 Blackwell 이후 칩에서만 나온다. 프런티어 모델이 FP4를 전제로 학습·배포되기 시작하면(K3의 QAT, V4의 FP4 전문가), 같은 모델을 Hopper에서 돌리는 비용은 상대적으로 더 비싸진다. 양자화 추세는 구형 GPU의 경제적 수명을 단축해 세대 교체를 앞당기는 쪽으로 작용하고, 이는 GPU를 자산으로 들고 있는 클라우드·리스 사업자의 감가상각 가정에 직접 닿는다.
세 번째, 형식 표준 경쟁이다. MXFP4(Open Compute Project 규격, gpt-oss·Kimi K3)와 NVFP4(NVIDIA 규격, 묶음 16개 + FP8 배율)는 묶음 크기와 배율 형식이 다르다. 모델이 어느 형식으로 학습됐느냐가 추론 칩이 지원해야 할 형식을 정하므로, 추론 전용 칩(ASIC·NPU)을 만드는 회사에게는 "어느 FP4를 지원하나"가 프런티어 모델 호환성 자체가 된다. 양자화는 소프트웨어 기법처럼 보이지만, 실제로는 하드웨어 생태계의 표준 싸움이다.
4부 예고
4부에서는 3부에서 정리한 기법 중 2025년 말 이후 새로 나온 알고리즘만 골라 수식과 수치 수준까지 자세히 다룬다. DeepSeek-V4·V4.1의 압축·희소 어텐션과 인코더-디코더 KV 공유, mHC와 Attention Residuals의 잔차 재설계, KDA로 이어지는 선형 어텐션 계보, Gated Attention, 실제 모델에 탑재되기 시작한 조건부 메모리(Engram 계열), 1조 파라미터 학습 안정화 기법, 그리고 하나로 수렴한 후처리 방식이 대상이다.
투자 시사점
첫째, ③④⑤의 성장은 토큰 수요, 즉 추론 GPU·HBM 수요를 직접 키운다. 병렬 추론은 갈래 수만큼, 에이전트는 작업 시간만큼 토큰을 쓴다. OpenAI 연구자 1인당 추론 사용액 중앙값이 하루 600달러를 넘었다는 공시는 "AI가 AI를 연구하는" 단계의 연산 집약도를 보여 주는 숫자이고, 이 수요는 외부 API 매출에 잡히지 않는 내부 소비다. 이 방향이 미국 프런티어 연구소의 주력인 한, 추론 인프라 수요가 쉽게 줄지 않는다고 본다.
둘째, ①②의 혁신은 토큰 단가를 빠르게 낮춘다. 수요 총량에 미치는 영향은 양방향이다. DeepSeek-V4는 100만 토큰 문맥에서 V3.2 대비 KV 캐시를 10%로 줄였고, Qwen3-Next는 긴 문맥 처리량을 10배로 올렸다. 토큰당 HBM 점유가 줄면 같은 GPU로 더 많은 요청과 더 긴 문맥을 처리할 수 있다. 단가 하락이 사용량 폭증으로 이어지면(제번스 역설) 총수요는 오히려 늘 수 있다. 반대로 사용량 증가가 단가 하락을 따라가지 못하면 GPU당 매출이 눌린다. 어느 쪽이 우세한지는 아직 판단하기 이르다. 다만 양자화의 역사는 참고가 된다. 비트가 줄 때마다 메모리가 남은 것이 아니라 모델이 그만큼 커졌다.
셋째, 비용의 중심이 "연산"에서 "연결과 메모리"로 옮겨 간다. MoE는 GPU 사이 통신을, 선형·압축 어텐션은 메모리 대역폭을, 조건부 메모리는 CPU-GPU 연결과 서버 DRAM을 병목으로 만든다. 2026년 8~9월 Qwen3.8-Flash-Next(51B, 호스트 메모리에서 프리페치)와 DeepSeek-V4.1-Flash(196B)가 조건부 메모리를 실제 모델에 넣었다. 다만 V4.1의 실서비스에서 테이블을 어디에 두는지는 아직 공개되지 않았다. 이 테이블이 HBM 대신 서버 DRAM·CXL 메모리·SSD에 놓이는지가 "HBM 대 DRAM" 비중 논의의 다음 확인 지점이다.
넷째, 에이전트 매출의 마진은 모델에서 작업 환경으로 이동한다. 하니스 규격이 회사 중립 표준이 되면서 모델을 바꿔 끼우는 비용이 내려갔다. Codex 사용자의 20%가 비개발자라는 숫자는 에이전트 수요가 터미널 밖으로 번지기 시작했다는 뜻이고, 그때 협상력은 사용자가 실제로 일하는 자리(IDE·운영체제·브라우저·업무 앱)를 가진 쪽에 있다.
Reference
① 구조
- DeepSeek-AI, "DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model", arXiv:2405.04434 (2024.5) - MLA, KV 캐시 −93.3%, 처리량 5.76배
- Dai et al., "DeepSeekMoE", arXiv:2401.06066 (2024.1) - 세분화 전문가 + 공유 전문가
- DeepSeek-AI, "DeepSeek-V3 Technical Report", arXiv:2412.19437 (2024.12) - 671B/37B, FP8 학습
- DeepSeek-AI, "DeepSeek-V3.2", arXiv:2512.02556 (2025.12) - DSA, 라이트닝 인덱서, top-2,048
- DeepSeek API 공지, "Introducing DeepSeek-V3.2-Exp" (2025.9.29) - API 가격 50%+ 인하
- DeepSeek-AI, "DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence", arXiv:2606.19348 (2026.4 프리뷰) - CSA+HCA, mHC, Muon, 1M 문맥에서 V3.2 대비 FLOPs 27%·KV 10%
- DeepSeek-V4.1-Flash 모델카드·config (2026.9.10) - 인코더-디코더, CSA2, FP4 KV(토큰당 890바이트), Engram 196B
- Qwen, "On the Design of Qwen3.8-Next Architecture: Evaluation, Efficiency, and Training Stability", arXiv:2608.30320 (2026.8.31) - QSA, n-gram 임베딩 51B, Muon
- DeepSeek-AI, "mHC: Manifold-Constrained Hyper-Connections", arXiv:2512.24880 (2025.12.31)
- Zhu et al., "Hyper-Connections", arXiv:2409.19606 (2024.9)
- DeepSeek-AI, "Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models", arXiv:2601.07372 (2026.1.12) - 초록의 "MMLU +3.4"는 본문 표상 MMLU-Redux 수치이며, MMLU는 +3.0(57.4→60.4)
- Yang et al., "Gated Delta Networks: Improving Mamba2 with Delta Rule", arXiv:2412.06464 (2024.12)
- Kimi Team, "Kimi Linear: An Expressive, Efficient Attention Architecture", arXiv:2510.26692 (2025.10)
- Qwen 모델카드: Qwen3-Next-80B-A3B, Qwen3.5-397B-A17B (Hugging Face)
- Kimi K3 모델카드 (Hugging Face) - 2.78T/104B, KDA 69층 + Gated MLA 24층, Attention Residuals
② 사전학습·정밀도
- Jordan et al., "Muon: An optimizer for hidden layers in neural networks" (블로그, 2024.12)
- Liu et al. (Moonshot AI), "Muon is Scalable for LLM Training"(Moonlight), arXiv:2502.16982 (2025.2) - AdamW 대비 약 2배 연산 효율
- Kimi Team, "Kimi K2: Open Agentic Intelligence", arXiv:2507.20534 (2025.7) - MuonClip, QK-Clip(τ=100), 15.5T 토큰 무스파이크
- Qwen Team, "Qwen3 Technical Report", arXiv:2505.09388 (2025.5) - 약 36T 토큰, 사고/비사고 통합
- Meta, "Introducing Muse Spark" (2026.4.8)
- Zhu et al. (NVIDIA), "Pretraining Large Language Models with NVFP4", arXiv:2509.25149 (2025.9.29) - 12B, 10T 토큰, FP8 동등
- OpenAI, gpt-oss 모델카드 (2025.8.5) - MXFP4 MoE 가중치, 120B가 80GB GPU 한 장
③ 후처리
- Schulman et al., "Proximal Policy Optimization Algorithms", arXiv:1707.06347 (2017)
- Ouyang et al., "Training language models to follow instructions with human feedback", arXiv:2203.02155 (2022)
- Shao et al., "DeepSeekMath", arXiv:2402.03300 (2024.2) - GRPO 제안
- DeepSeek-AI, "DeepSeek-R1", arXiv:2501.12948 (2025.1)
- Thinking Machines Lab, "On-Policy Distillation" (2025.10.27)
- xAI, "Grok 4" (2025.7.9)
- Bai et al., "Constitutional AI: Harmlessness from AI Feedback", arXiv:2212.08073 (2022.12)
④ 추론 시간
- Snell et al., "Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters", arXiv:2408.03314 (2024.8)
- OpenAI, GPT-5 발표·시스템 카드 (2025.8) - GPT-5 Pro 병렬 테스트타임 연산
- Google, Gemini 2.5 Deep Think 발표 (2025.8) - 병렬 사고
- Meta, "Introducing Muse Spark" (2026.4.8) - 사고 압축, Contemplating 모드(HLE 58%)
⑤ 시스템
- OpenAI, "Research acceleration: The view inside OpenAI" (2026.9.6)
- Anthropic, "Automated Alignment Researchers" (2026.4.14) / "Automated researchers can reliably mitigate alignment failures" (2026.8.28)
- Google DeepMind, "AlphaEvolve" (2025.5)
- Microsoft AI, "The Path to Medical Superintelligence"(MAI-DxO, 2025.6) / "Towards Humanist Superintelligence" (2025.11)
- VentureBeat, "Anthropic says it hit a $30 billion revenue run rate" (2026.5.8) - Claude Code 연환산 25억 달러(2026.2)
- Constellation Research, "OpenAI touts broadening Codex usage with 5 million weekly active users" (2026.6.2)
- Linux Foundation, Agentic AI Foundation 설립 발표 (2025.12.9) / agentskills.io (2025.12) / OpenAI, "Harness engineering" (2026.2)
이 글은 스터디를 하면서 쓴 글이고, 투자 권유가 아닙니다. 투자의 책임은 투자자 본인에게 있습니다.
반응형'최신 기술동향 > 인공지능 (AI)' 카테고리의 다른 글
[AI 모델 동향 5부] Conclusion - 모델의 변화와 투자 방향 (0) 2026.10.05 [AI 모델 동향 4부] 2026년 최신 LLM 알고리즘 - DeepSeek·Kimi·Qwen이 트랜스포머에서 바꾼 것 (0) 2026.10.05 [AI 모델 동향 2부] 세 플래그십의 공통 기술 - 추론 학습, 루프 구조, 사고 기록, 컨텍스트 관리, 멀티에이전트 (0) 2026.10.04 [AI 모델 동향 1부] AI 모델 비교 - 기업별 AI 설계 철학 (0) 2026.10.03 데이터센터와 광통신 - 3부 AI DC 광연결과 기업 동향 (0) 2026.09.09