-
[AI 모델 동향 2부] 세 플래그십의 공통 기술 - 추론 학습, 루프 구조, 사고 기록, 컨텍스트 관리, 멀티에이전트최신 기술동향/인공지능 (AI) 2026. 10. 4. 12:00
세 플래그십 (Anthropic, OpenAI, Meta)은 구조를 공개하지 않지만, 공개된 자료를 모아 보면 같은 방향으로 가고 있다. 추론 과정을 글로 덜 남기고, 작업 상태를 컨텍스트 밖에 따로 저장하고 (증류 방지), 실행 환경(하니스) 안에서 실제 작업을 하도록 학습한다. 1부(「AI 모델 비교 - 기업별 AI 설계 철학」)가 세 회사의 라인업·가격·철학을 비교했다면, 2부는 그 아래에 깔린 기술 원리를 다룬다. 루프 구조가 GPU와 GPU 메모리(HBM) 수요에 무엇을 뜻하는지, 사고 기록이 짧아지면 무엇을 확인할 수 없게 되는지, 그 공백을 메우려는 AI 보안 스타트업들이 실제로 필요한지, 하니스가 모델과 함께 개발돼야 하는지가 핵심 질문이다. 참고로, 구체적인 모델의 개발에 대해서는 개인적인 호기심을 충족하고자 스터디를 하면서 정리한 내용이니, 기술은 큰 관심없고, 생태계를 이해하려는 사람들은 3장의 AI보안 스타트업, 5장 멀티에이전트, 하네스 부분부터 결론까지만 읽는 것을 추천한다.
시리즈 구성: 1부 AI 모델 기업별 설계 철학 → 2부 세 플래그십의 공통 기술(이 글) → 3부 LLM 성능 개선 다섯 단계 → 4부 2026년 최신 LLM 알고리즘 → 5부 시리즈 종합 및 투자 방향
기준일: 2026년 9월 13일. 세 회사 모두 아키텍처를 공개하지 않는다. 이 글은 근거를 다섯 종류로 나눠 본문에 표시한다. [공식] 시스템 카드·공식 블로그, [문서] API 문서, [논문] 공개 논문, [독립] Artificial Analysis·UK AISI 같은 독립 평가, [보도] The Information 등 언론. 전문가 해설(Sebastian Raschka 등)은 1차 자료가 아니므로 [해설]로 따로 표시한다.0. Intro - 세 회사가 공개한 조각들이 어떻게 하나의 공통점으로 모이나
1부에서 봤듯 Fable 5.1, GPT-6 Astra, Muse Spark 1.3은 파라미터 수도, 전문가 구성도, 학습 컴퓨트도 공개하지 않는다. 그런데도 "이 셋이 기술적으로 어디서 겹치는가"를 말할 수 있다. 세 회사가 각자 다른 이유로 서로 다른 종류의 자료를 공개하는데, 그 자료들이 모두 같은 세 가지 변화를 가리키기 때문이다.
2부가 확인하는 기업들의 공통적인 방향은 셋이다.
- 추론을 글 밖으로 옮긴다. 답하기 전에 쓰는 사고 기록이 짧아지고, 사용자에게는 원문을 보여 주지 않는다.
- 작업 상태를 컨텍스트 밖에 둔다. 긴 작업에서 "지금까지 무엇을 했고 왜 그렇게 했는지"를 요약·노트·메모리 같은 별도 저장소에 두고 필요할 때 꺼내 온다.
- 하니스 안에서 행동하도록 학습한다. 학습 단위가 "질문 → 답"에서 "도구를 쓰며 여러 단계 작업을 끝내는 것"으로 바뀌었다.
OpenAI 시스템 카드의 "사고 기록이 비어 있는 경우가 늘었다"와 Anthropic API 문서의 "사고 기록은 요약만 돌려준다", Meta 연구 조직의 "텍스트 밖에서 추론하는 모델" 논문은 각각 다른 문서에 다른 목적으로 적혀 있지만, 셋 다 추론이 글에서 빠져나가고 있다는 같은 사실을 담고 있다. 상태 저장과 하니스도 같은 방식으로 세 회사 자료에서 각각 확인된다. 그래서 2부는 회사별이 아니라 공통 방향별로 장을 나눴다.
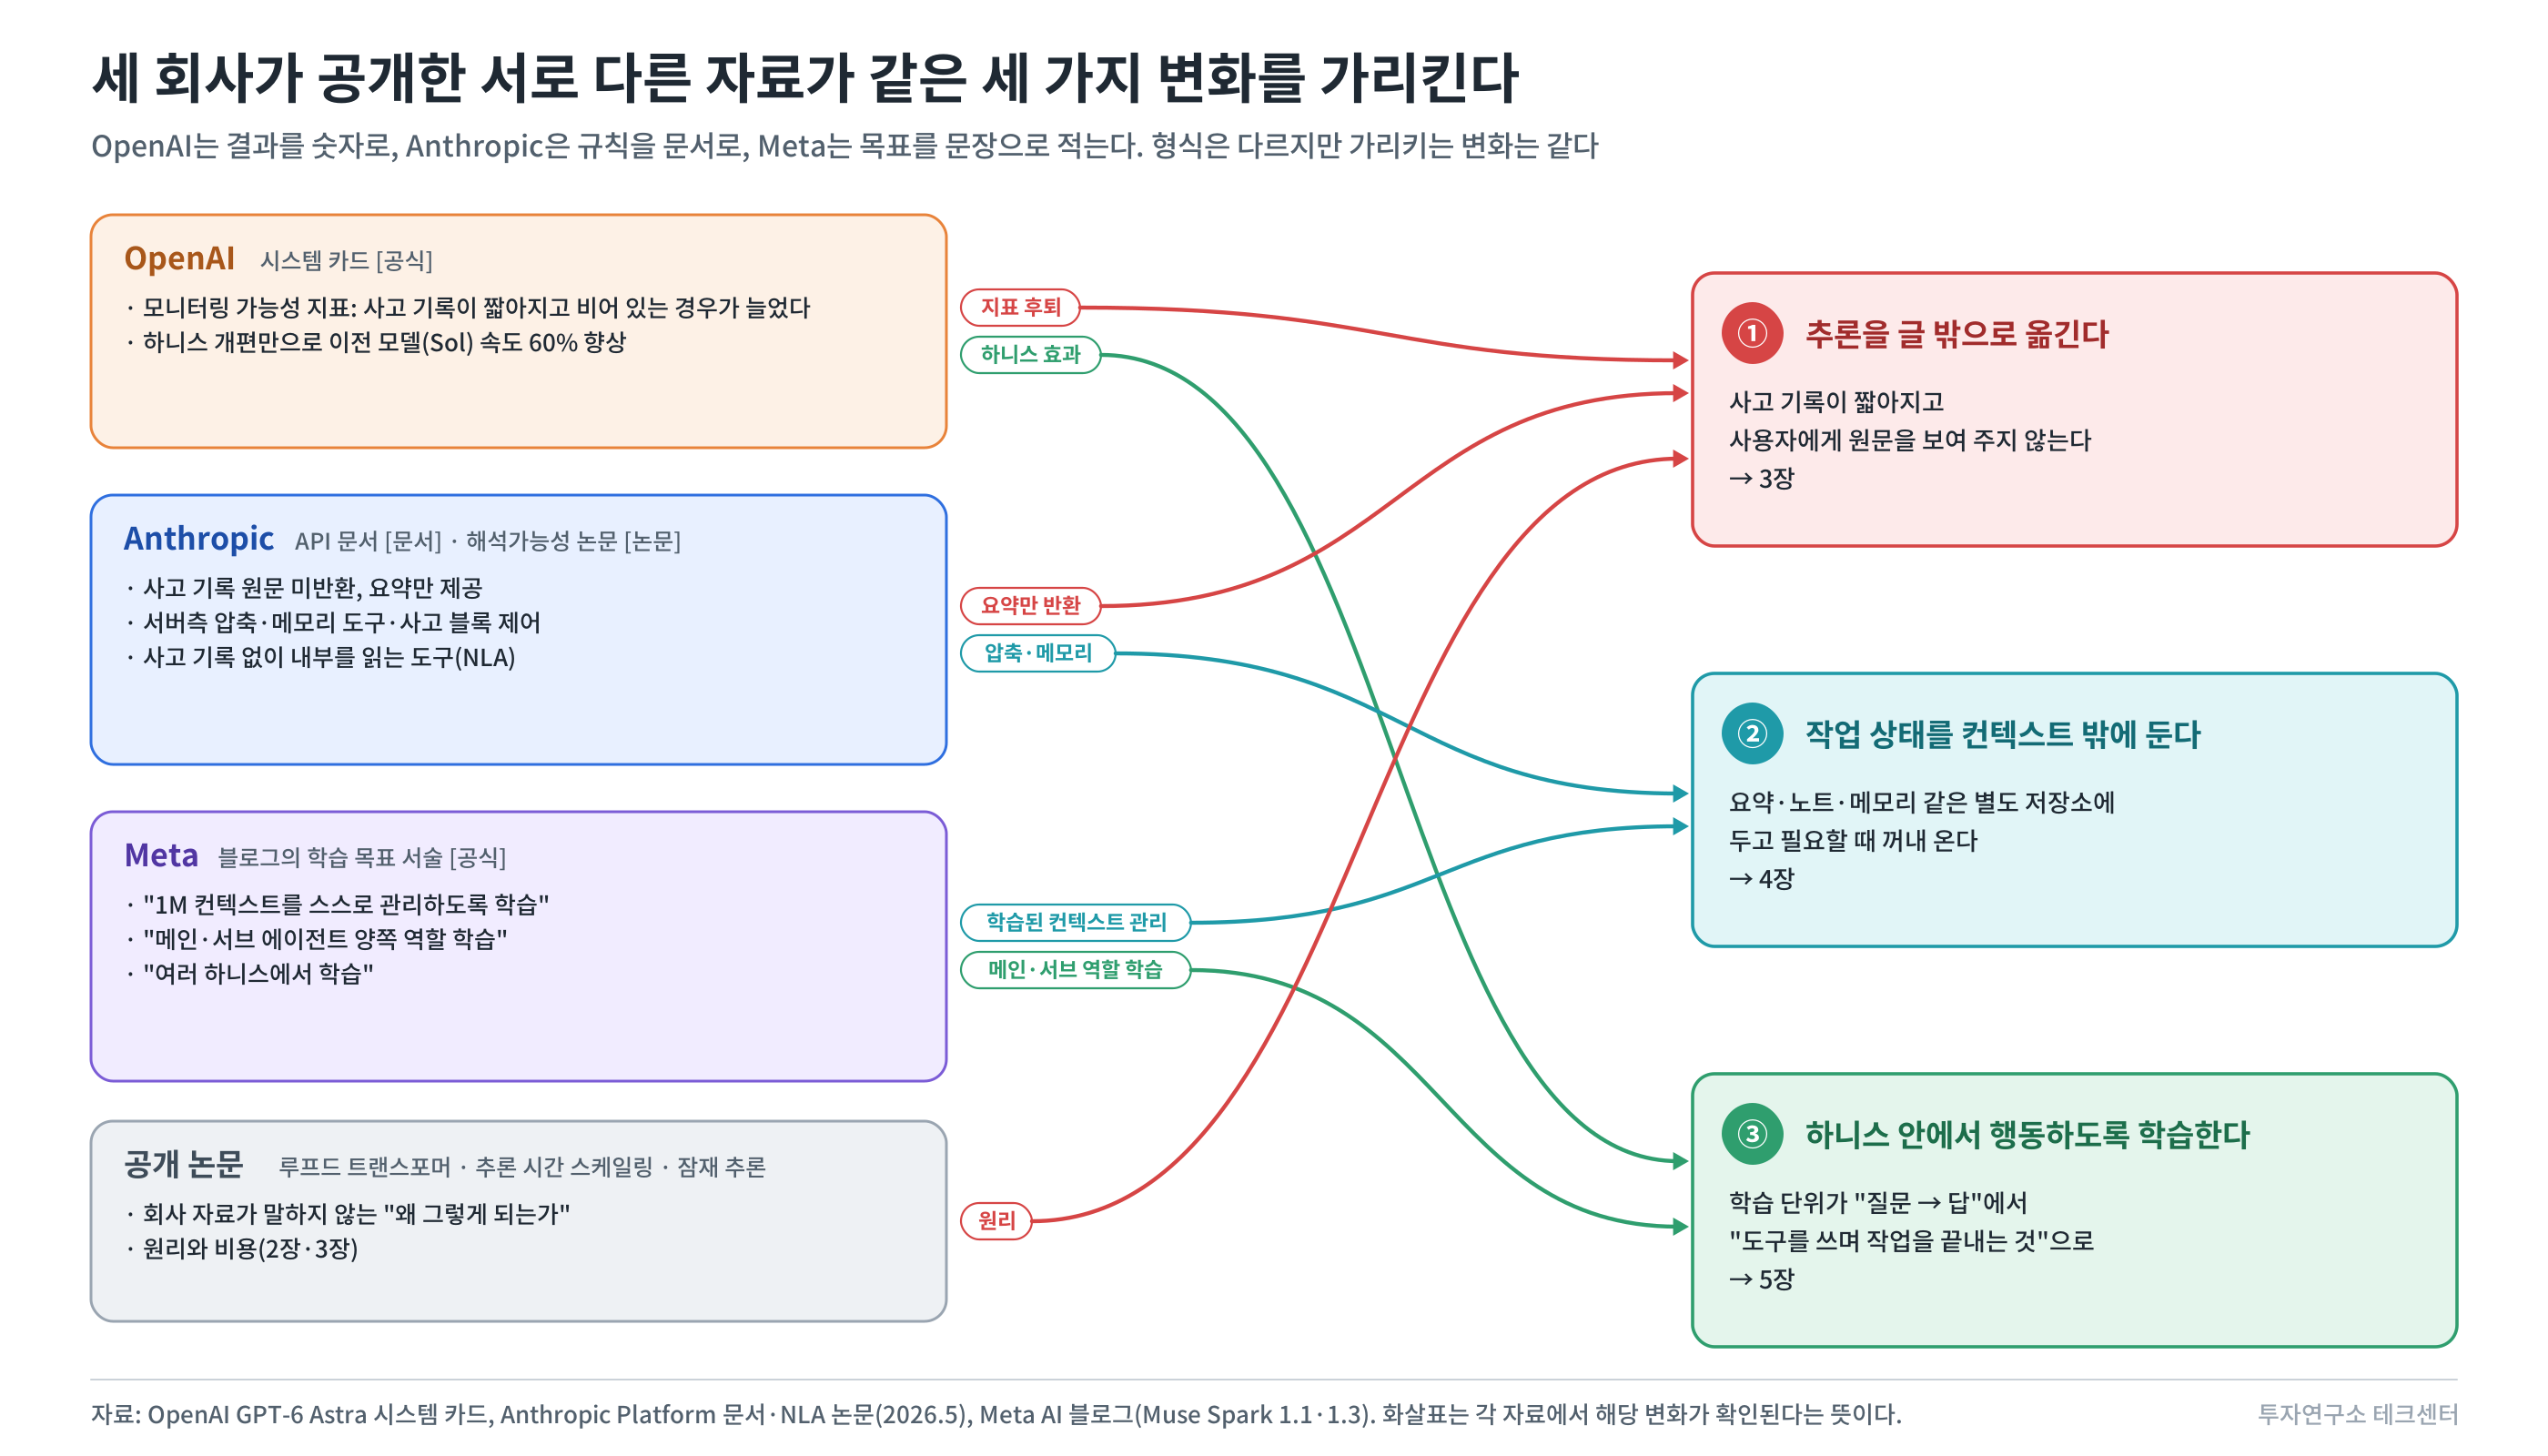
그림 2-2. 세 회사의 공개 자료가 세 가지 공통 방향으로 모이는 구조 1. 공통 기반 - 셋 다 추론 모델이고, 사용자가 추론 강도를 고른다
1-1. 추론 모델과 RLVR의 원리
세 플래그십은 모두 추론 모델(reasoning model)이다. 답을 내기 전에 중간 단계(사고 기록, chain of thought, 이하 CoT)를 토큰으로 생성한다. 이 사고 기록은 중간 계산을 적어 두는 공간이다. 예를 들어 "곱이 21이고 합이 10인 두 수"를 찾는 문제라면, 5와 5를 시도해 곱이 25라 틀렸음을 확인하고, 3과 7로 되돌아가 다시 검증하는 식의 되돌아가기가 여기서 일어난다. 모델은 여전히 토큰을 하나씩 생성할 뿐이지만, 최종 답 앞에 계산을 더 얹는 것이다. [논문: Wei et al. 2022 / 해설: Raschka]
이 능력을 만드는 학습 방식이 RLVR(Reinforcement Learning with Verifiable Rewards, 검증 가능한 보상 기반 강화학습)이다. 원리는 단순하다. 정답을 기계가 확인할 수 있는 문제를 주고, 모델이 스스로 풀게 한 뒤, 맞으면 보상을 주고 틀리면 주지 않는다. 그리고 보상을 받은 풀이가 나올 확률이 높아지도록 모델을 조금씩 고친다. 한 번의 학습 단계는 이렇게 돈다.
- 문제 출제: 수학 문제, 단위 테스트가 딸린 코딩 과제, 터미널·브라우저에서 달성할 목표처럼 결과를 자동으로 채점할 수 있는 과제를 준비한다.
- 여러 번 풀기: 같은 문제를 모델에게 여러 번(DeepSeek 논문 기준 16~64번) 풀게 한다. 매번 사고 기록과 최종 답이 조금씩 다르게 나온다.
- 기계 채점: 정답 문자열 비교, 테스트 통과 여부, 목표 화면 도달 여부 같은 규칙으로 각 풀이에 점수를 매긴다. 사람이 판단하지 않으므로 싸고 빠르며, 같은 기준으로 수백만 번 반복할 수 있다.
- 상대 비교로 강화: 같은 문제의 풀이끼리 비교해 평균보다 잘한 풀이의 토큰은 더 자주 나오게, 못한 풀이의 토큰은 덜 나오게 가중치를 조정한다. DeepSeek의 GRPO가 이 방식의 대표다(3부 그림 3-7).
핵심은 "어떻게 생각하라"를 가르치지 않는다는 점이다. 보상은 최종 답이 맞았는지만 보지만, 정답에 이른 풀이 전체가 강화되면서 검산하기, 막히면 되돌아가기, 다른 방법 시도하기 같은 습관이 저절로 늘어난다. DeepSeek-R1-Zero는 사람이 쓴 풀이 예시(SFT) 없이 이 방식만으로 학습했다. 그 결과 AIME 2024 정답률이 15.6%에서 71.0%로 올랐고, 학습이 진행될수록 사고 기록이 스스로 길어졌다. [논문: DeepSeek-R1, 2025.1]
사람의 선호를 학습한 보상 모델로 점수를 매기는 RLHF와는 여기서 갈린다. RLHF는 "더 나아 보이는 답"을 가르치고, RLVR은 "실제로 맞는 답"을 가르친다. 대신 RLVR은 정답을 확인할 수 있는 영역에서만 쓸 수 있다. 수학·코딩·에이전트 과제의 성능이 유독 빠르게 오르는 이유가 여기 있다. 약점도 있다. 채점 규칙에 구멍이 있으면 모델이 문제를 푸는 대신 채점기를 속이는 법을 배운다(보상 해킹). 테스트 코드를 고쳐 통과시키는 식이다. 그래서 각 회사는 채점 환경을 정교하게 만드는 데 큰 비용을 쓴다.
o1 이후 주요 프런티어 모델은 모두 이 길을 갔고, Astra도 예외가 아니다. 과제가 수학 문제에서 터미널·브라우저·운영체제 조작으로 넓어졌을 뿐 원리는 같다. Raschka는 Astra의 컴퓨터 사용 학습조차 "패러다임 전환이 아니라 RLVR의 환경이 macOS로 바뀐 것"이라고 정리한다.
1-2. 추론 강도(effort) 설정 - 답하기 전에 연산을 얼마나 쓸지 고르는 옵션
2024년 Snell 등의 논문이 "추론 시간에 컴퓨트를 더 쓰면 작은 모델이 큰 모델을 이길 수 있다"는 것을 보였고, 이게 지금 세 회사 API의 추론 강도(effort) 설정으로 제품화됐다. [논문: Snell et al. 2024] 사용자가 low·medium·high 같은 단계를 고르면, 모델이 답하기 전에 쓰는 사고 토큰의 양, 곧 연산량이 달라진다. 단계를 올리면 더 오래 생각해 정확도가 오르지만, 토큰 비용과 응답 시간도 함께 늘어난다.
항목 Anthropic OpenAI Meta 강도 단계 low / medium / high / xhigh / max low / medium / high / xhigh / max + Fast 모드 (기본) / xhigh / max 사고 모드 적응형 사고(adaptive thinking)만 지원(Fable 5부터 유일한 모드). 모델이 생각할지·얼마나 할지 스스로 결정 [문서] 강도 단계별로 추론량 조절 "Thinking" 모드 기본값 Claude Code는 high, Claude 앱은 medium [공식] 비공개 비공개 max 접근 전면 공개 전면 공개 max는 파트너 한정 프리뷰 [독립: AA] 세 회사가 성능을 발표할 때 벤치마크 점수를 정확도 × 비용(로그 눈금) 곡선으로 그리는 이유가 여기 있다. 같은 모델이라도 추론 강도 단계에 따라 정확도와 비용이 다른 위치에 찍힌다. Anthropic은 "Fable 5.1을 low·medium으로 돌리면 Fable 5와 비슷하거나 더 좋은 결과를 훨씬 싸게 낸다"고 썼고, AA는 Muse Spark 1.3의 max가 xhigh보다 GDPval-AA에서 62% 더 많이 추론해서 45 Elo를 더 얻었다고 측정했다. [공식/독립]
이 구조가 뜻하는 것: 지능 = f(파라미터, 학습 컴퓨트, 추론 컴퓨트)의 세 항이 됐다. 「Kimi K3와 AI 경쟁」(#186)에서 "1점의 가치"를 따질 때 가로축이 비용이었던 것과 같은 논리다. 세 번째 항이 커질수록 "모델이 얼마나 똑똑한가"보다 "같은 점수를 얼마나 적은 토큰으로 내는가"가 경쟁의 중심이 된다. Astra가 코딩 에이전트 평가에서 Sol의 약 1/3 토큰만 쓴다는 것(AA 측정), Muse 1.3이 1.2 대비 도구 호출 20%·토큰 25% 감소(Meta 발표치, 외부 분석은 반대로 1.3이 더 장황하다고 본다. 1부 4-1)를 앞세운 것, Fable 5.1 파트너들이 "Opus 5 대비 절반 토큰"을 언급한 것 - 세 회사가 같은 지표로 경쟁하고 있다.
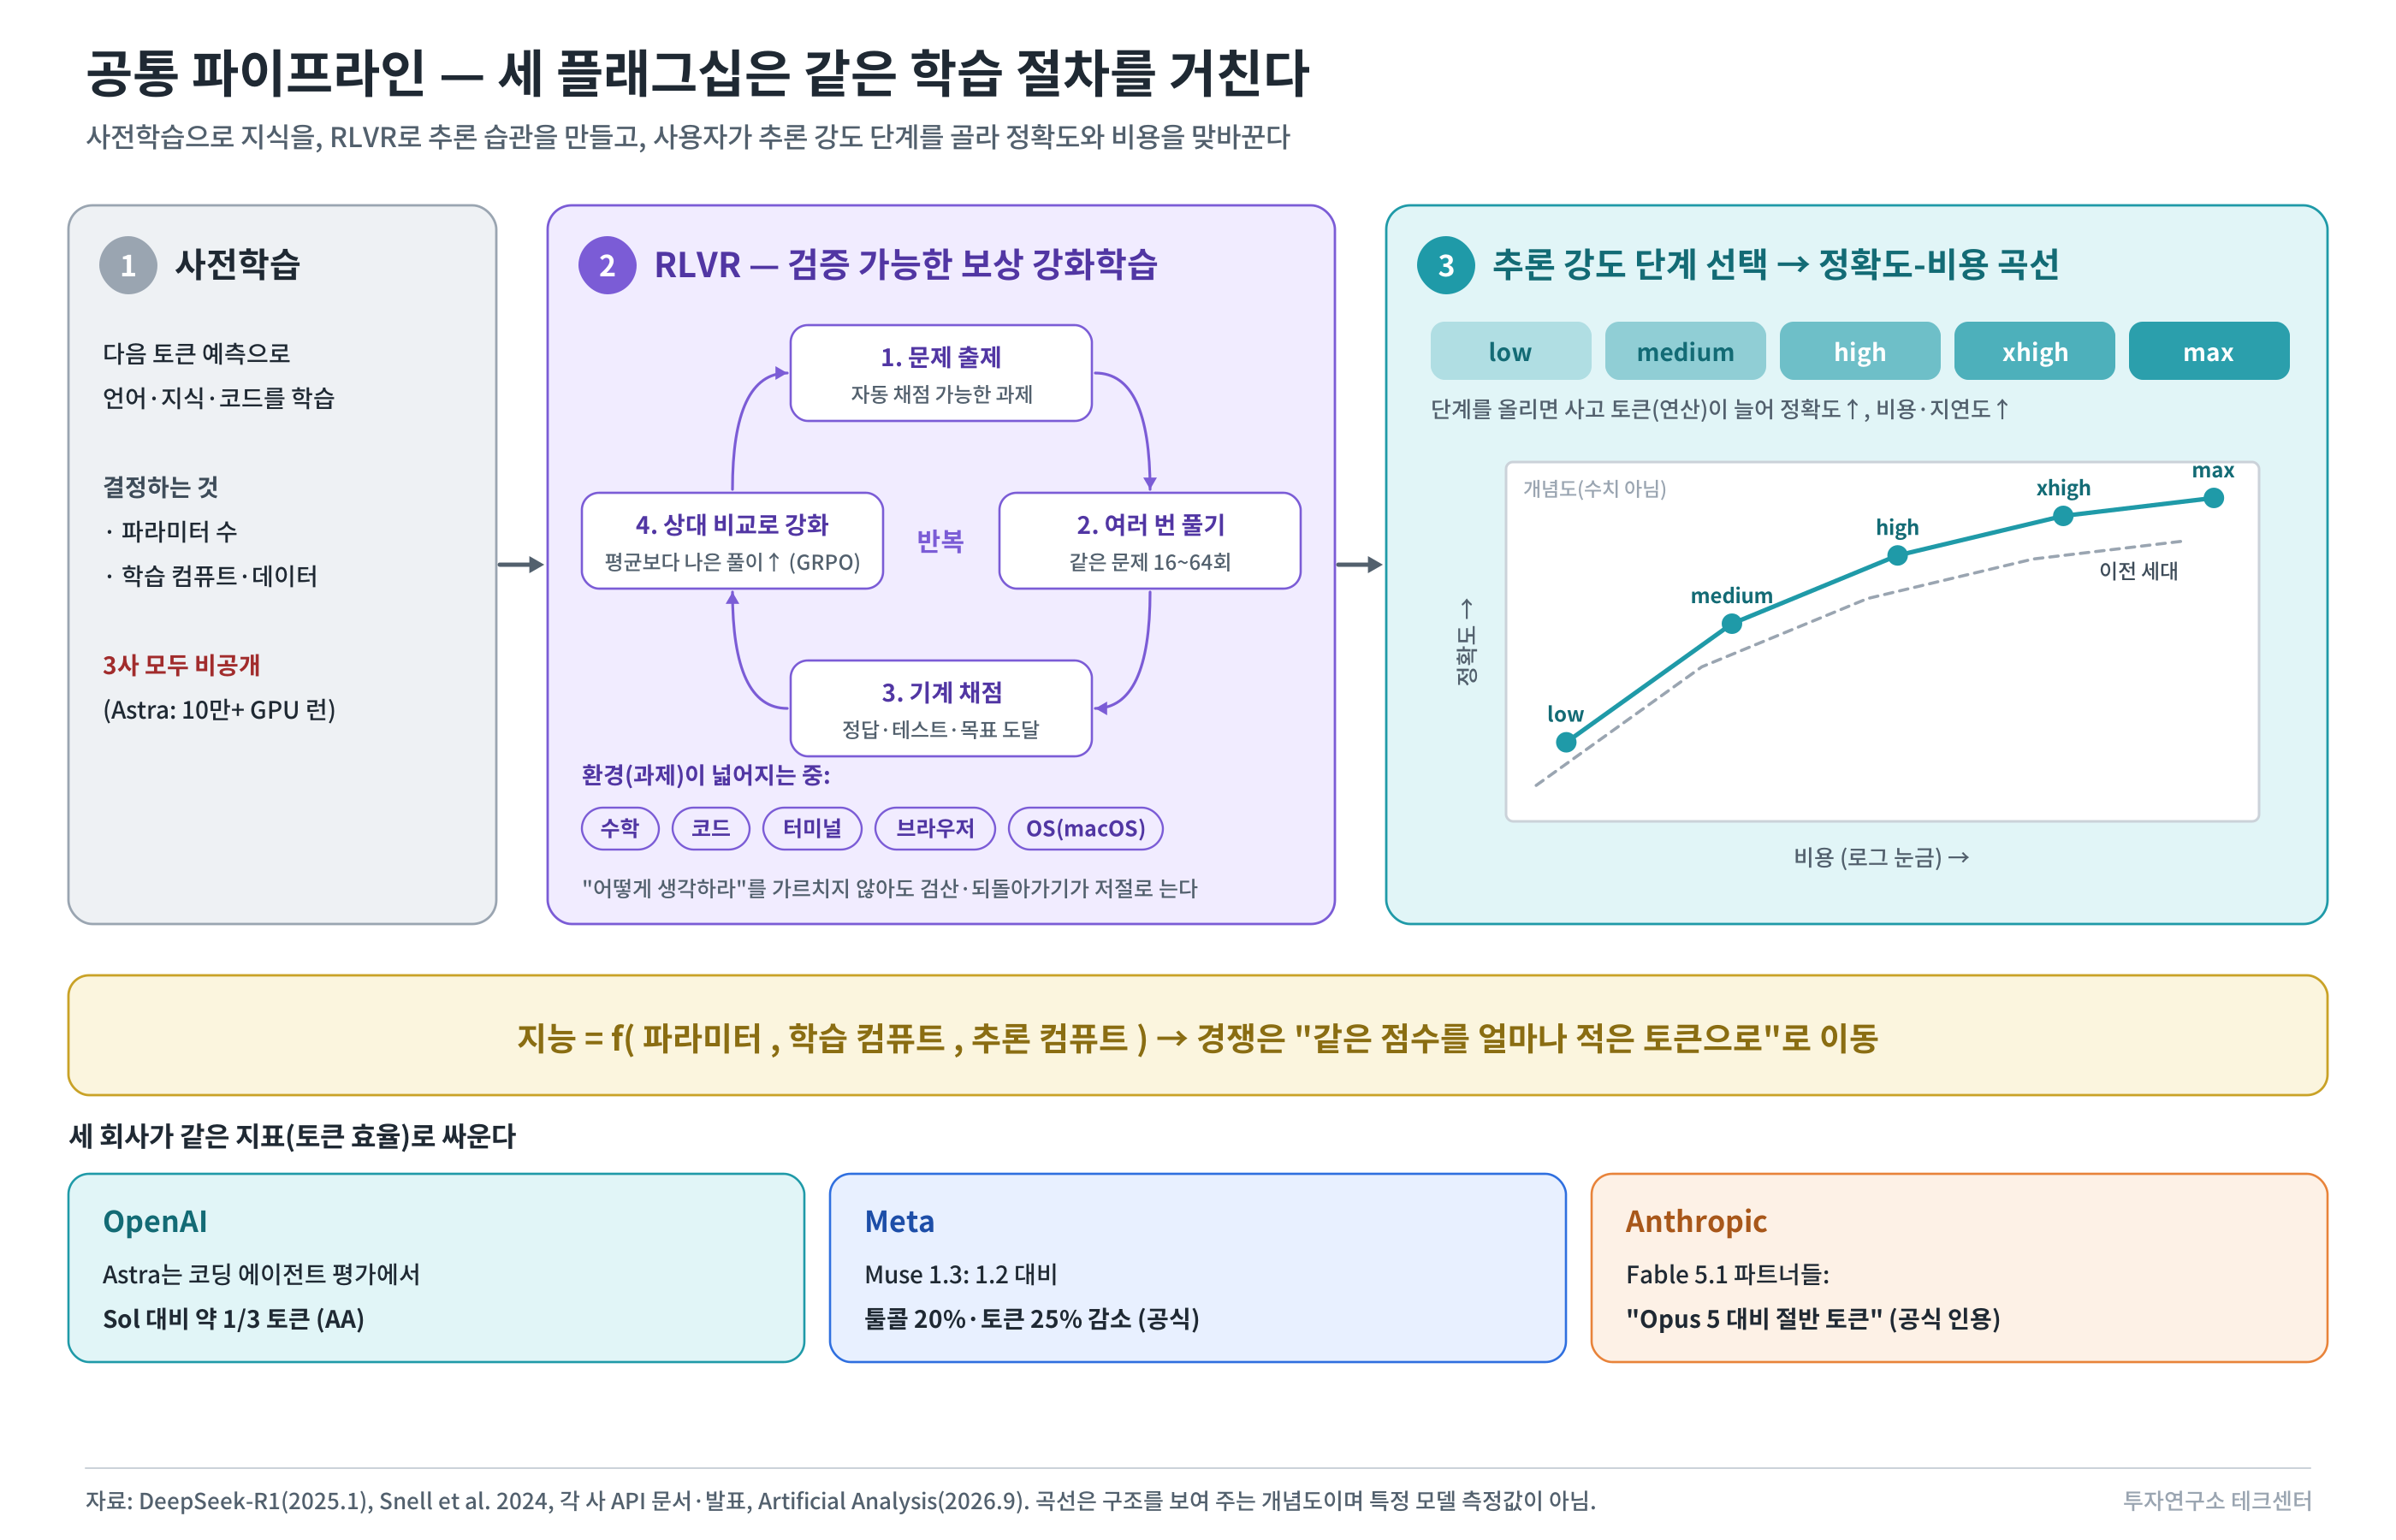
그림 2-3. 공통 파이프라인 - 사전학습, RLVR, 추론 강도 2. 루프드 트랜스포머 - Astra가 쓴다고 보도된 구조
2-1. 보도 내용과 확인된 것
The Information은 출시 이틀 전 Astra가 "recurrent depth" 또는 "looped transformer"라는 기법을 쓴다고 보도했다. OpenAI는 확인도 부인도 하지 않았다. 다만 수석과학자 파초키가 "현재 프런티어 모델(Astra 포함)의 계산 그래프 깊이는 GPT-4의 2배 이내"라고 밝혔고, 시스템 카드에서 모니터링 가능성 변화가 "아키텍처 변경 때문이 아니라고 확신한다"고 썼다. [보도/공식]
Raschka(『Build a Reasoning Model From Scratch』 저자)의 판단은 이렇다. Astra가 루프 구조를 쓸 가능성은 높지만, 성능 향상의 주된 원인은 학습 방법과 데이터일 것이고, The Information이 루프의 기여를 과대평가했을 가능성이 크다. [해설] 필자도 이 판단에 동의한다. 다만 루프 자체는 이해할 가치가 충분하다. 2026년 9월 현재 이 기법이 공개 연구에서 어디까지 왔는지가 다음 세대 모델의 원가 구조를 말해 주기 때문이다.
2-2. 원리 - 같은 블록을 두 번 통과시킨다
일반 트랜스포머는 N개의 블록(어텐션 + FFN + 정규화 + 잔차)을 한 번씩 통과한다. 루프드 트랜스포머는 같은 블록 묶음을 여러 번 통과시킨다. 가중치는 공유되고, 통과 횟수만 는다.
공개된 가장 단순한 예가 7월에 나온 Nanbeige4.2-3B다. 22개 블록을 두 번 통과시킨다. 펼치면 44번의 블록 적용이지만, 23번째 적용은 1번 블록의 가중치를, 24번째는 2번 블록의 가중치를 다시 쓴다. 44개 블록짜리 모델과 같은 유효 깊이를 절반의 블록 파라미터로 얻는 것이다. [논문: Nanbeige 4.2 기술보고서]
그냥 레이어를 복사해서 두 번 돌리는 건데, 이게 특별한가
AI 모델을 공부해본 사람이라면, 알겠지만, 이게 뭐가 특별한 것인가 라는 생각이 들 수 있다. 모델 구조 자체만 보면 특별하지 않다. 아이디어 자체는 7년이 넘었고, 소형 모델에서는 이미 제품에 들어간 사례가 있다. 선례를 시간순으로 보면 이렇다.
- Universal Transformer(2018, Google): 원형이다. 블록 하나를 반복해서 쓰고, 토큰마다 반복 횟수를 다르게 하는 적응형 정지(adaptive halting)까지 제안했다. 위치별로 정지 확률을 학습해 누적값이 임계치를 넘으면 그 토큰의 반복을 멈춘다. [논문: Dehghani et al. 2018]
- ALBERT(2019, Google): BERT의 모든 레이어가 하나의 가중치를 공유하게 만들어 파라미터를 크게 줄였다. 목적은 추론 능력이 아니라 메모리 절약과 학습 속도였다. [논문: Lan et al. 2019]
- MobileLLM(2024, Meta): 스마트폰용 1억~3.5억 파라미터 모델에서 각 블록을 바로 이어서 두 번 적용했다(immediate block-wise weight sharing). 블록 가중치가 칩 안의 고속 메모리(SRAM)에 올라가 있는 동안 바로 한 번 더 쓰므로, 메모리에서 다시 읽는 비용이 거의 없다. iPhone 13에서 지연 2.6% 증가로 정확도 0.7~0.8점을 더 얻었다. [논문: Liu et al. 2024]
- Relaxed Recursive Transformers(2024.10, Google DeepMind): 이미 학습된 모델(Gemma 2B)을 루프 구조로 바꾸고(업사이클링), 반복마다 작은 차이를 허용하는 LoRA를 붙였다. 변환된 1B 재귀 모델이 처음부터 학습된 TinyLlama 1.1B·Pythia 1B보다 정확도가 높았고, 깊이 방향으로 배치를 섞는 서빙 기법으로 처리량을 2~3배 올릴 수 있다고 제안했다. [논문: Bae et al. 2024]
그러니 "레이어를 공유해서 여러 번 돌린다"는 것 자체는 새롭지 않다. 달라진 것은 목적과 규모다. 2019~2024년의 선례는 작은 모델을 더 작은 메모리에 넣기 위한 것이었다. 2025년 이후의 연구(Geiping, Ouro, Nanbeige, SMELT)는 반대로 같은 파라미터로 더 깊은 계산을 하기 위한 것이고, 프런티어 규모에서 쓴다는 보도가 처음 나온 모델이 Astra다. 소형에서는 메모리를 아끼는 기법, 대형에서는 추론 능력을 올리는 기법으로 같은 구조가 다른 이유로 쓰이고 있다.
Astra는 어느 종류인가 - 모른다
루프 연구는 크게 세 갈래로 나뉜다. 반복 횟수를 고정하는 쪽(Nanbeige 2회, Ouro 4회), 토큰마다 반복을 적응형으로 멈추는 쪽(Universal Transformer, Geiping의 조기 정지), 라우터가 토큰별 반복 횟수를 배정하는 쪽(Mixture-of-Recursions)이다. Astra가 이 중 어느 쪽인지는 알려진 것이 없다. 보도는 "recurrent depth" 또는 "looped transformer"라는 단어만 전했고, 반복 횟수를 고정하는지 입력에 따라 바꾸는지, 블록 전체를 반복하는지 일부만 반복하는지는 어느 자료에도 없다. 아래 계보 그림에서 Astra를 어느 갈래에도 넣지 않고 따로 "미확인"으로 표시한 이유다. 유일한 단서는 파초키의 "깊이는 GPT-4의 2배 이내"라는 발언인데, 이는 반복을 하더라도 펼친 깊이가 두 배를 넘지 않는다는 뜻으로 읽을 수 있을 뿐, 종류를 말해 주지는 않는다.
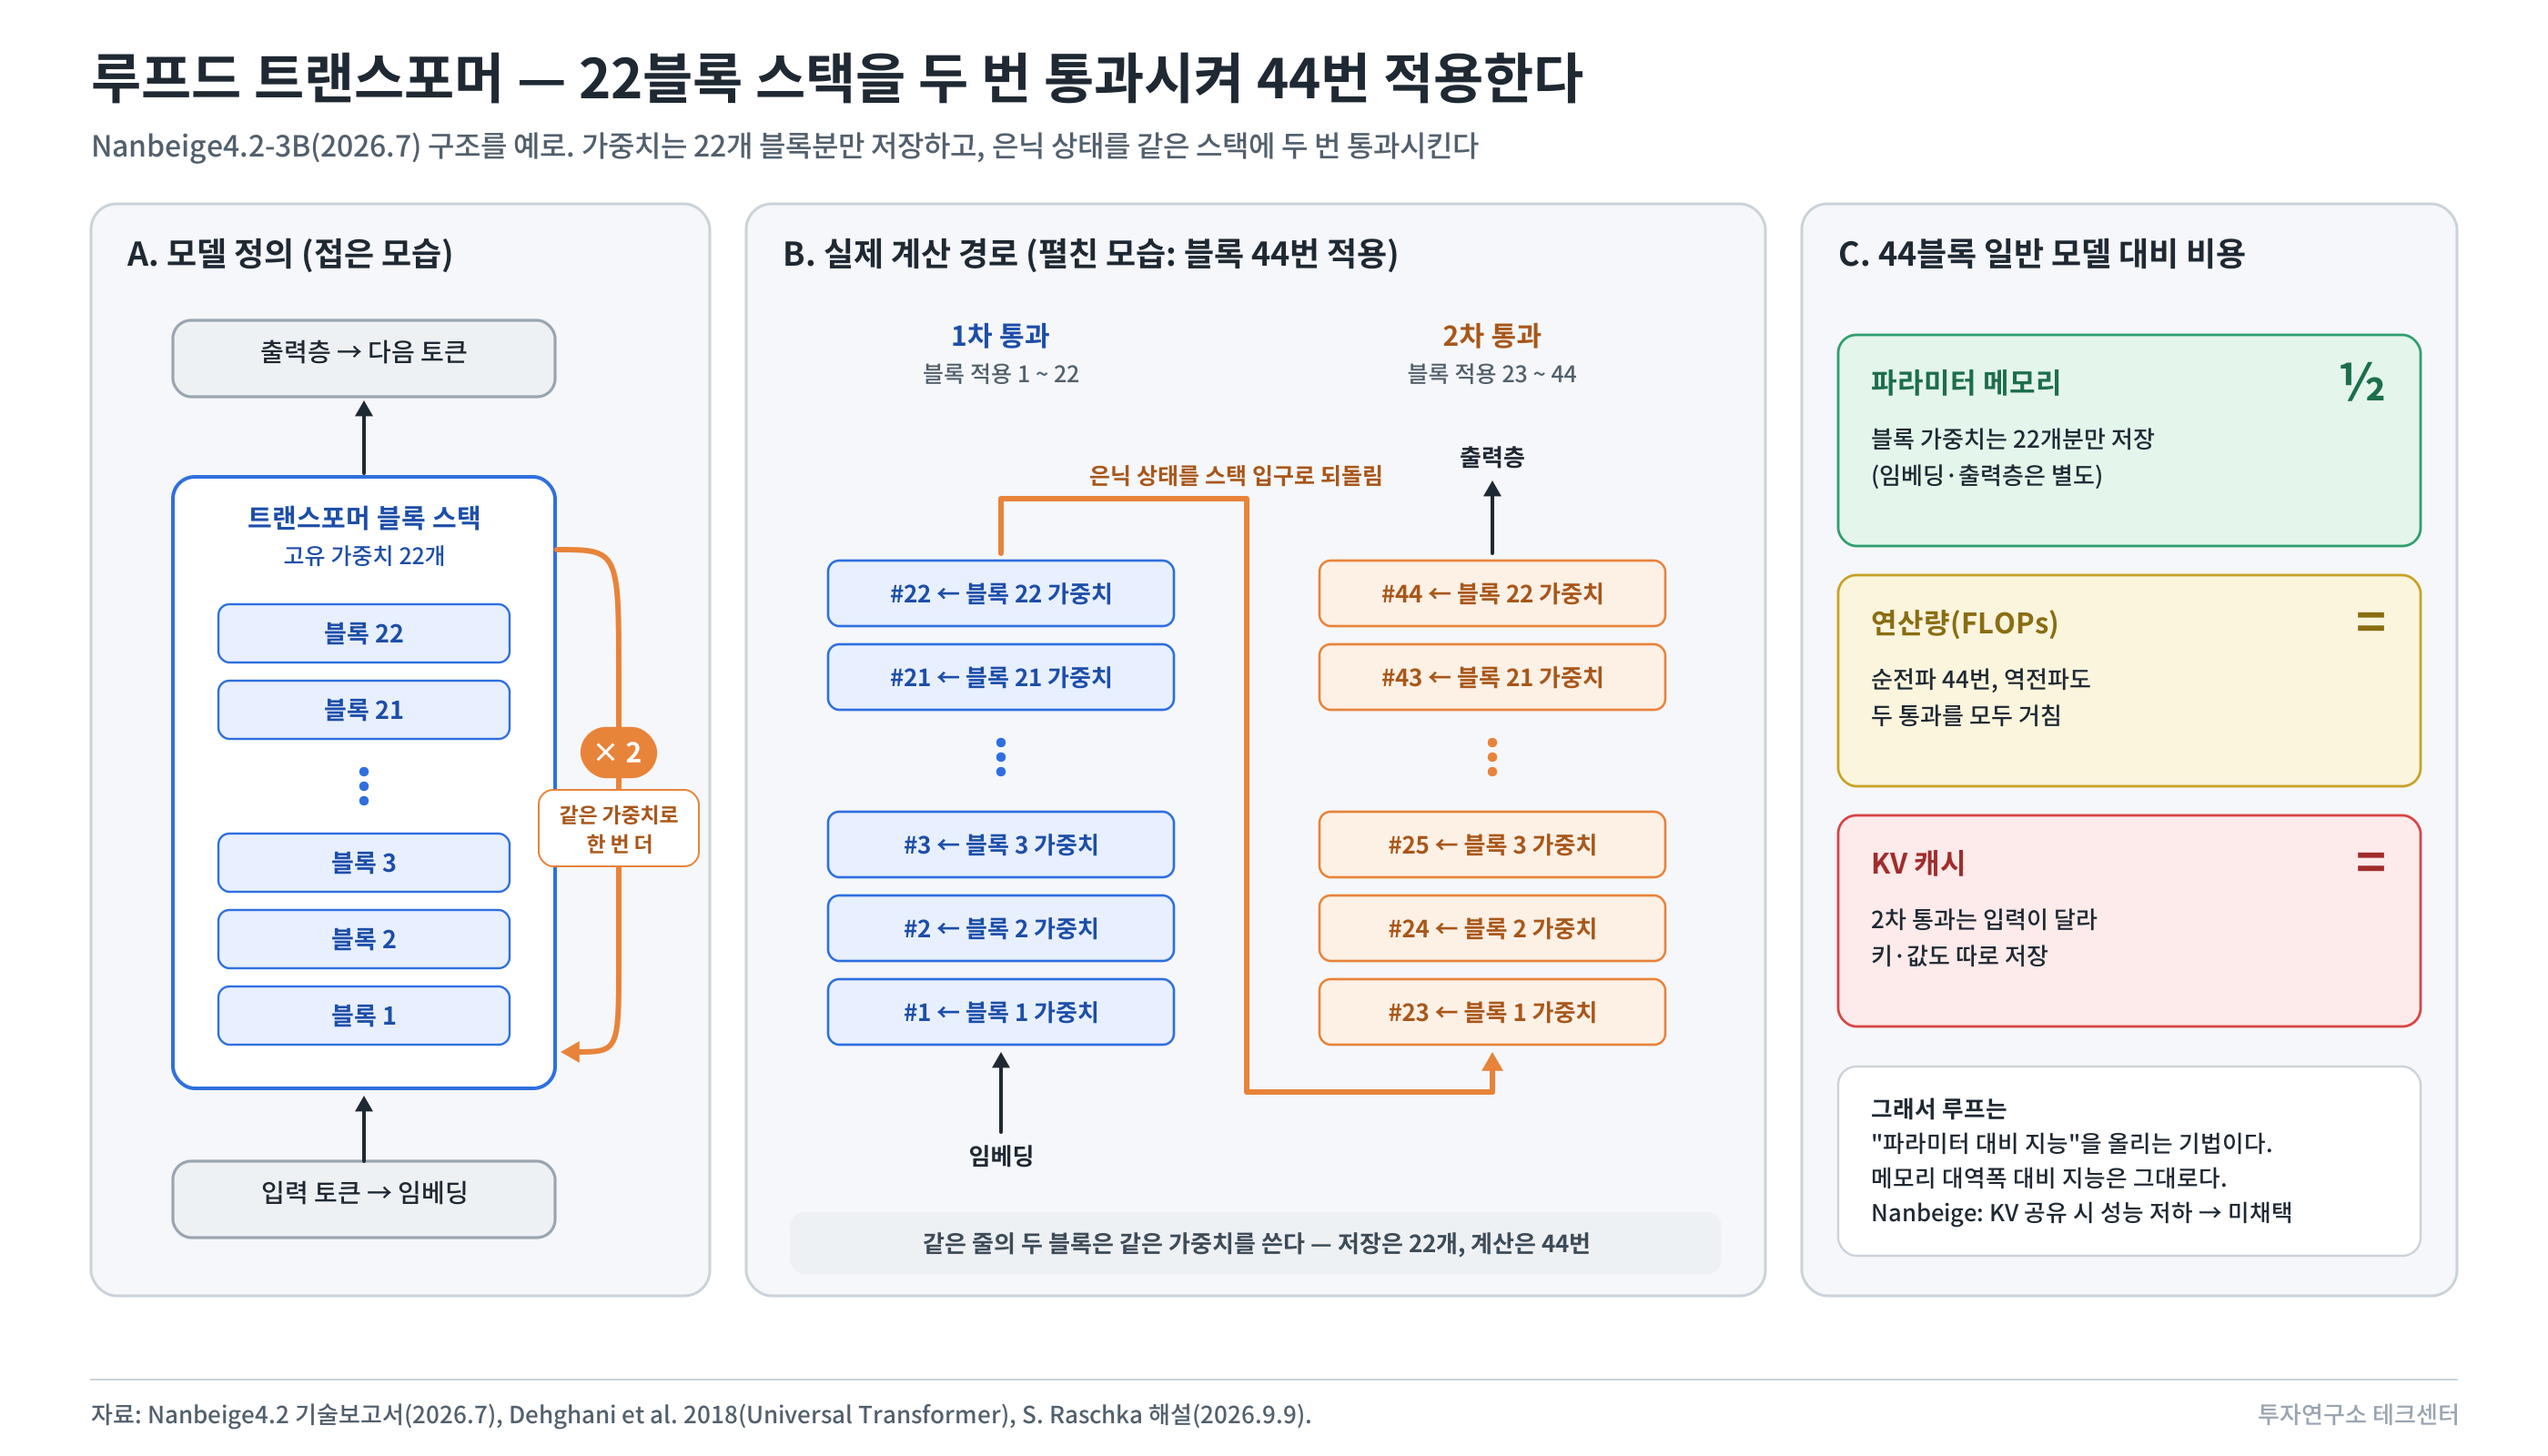
그림 2-4. 루프드 트랜스포머 개념도 
그림 2-5. 루프드 트랜스포머 연구 계보 - 세 갈래와 선례, Astra는 미확인 2-3. 비용 - 파라미터만 줄고 연산·KV·대역폭은 그대로
여기가 5부(투자 정리)로 이어지는 소결이다. 루프는 세 가지 비용 항목에 다르게 작용한다.
- 파라미터 메모리: 줄어든다. 22×2 모델은 44개 블록 모델의 절반 블록 파라미터다(임베딩·출력층은 별도).
- 연산량(FLOPs): 안 줄어든다. 순전파는 44번 블록을 통과하고, 역전파도 두 번의 반복을 모두 거친다. 학습·추론 컴퓨트는 44블록 모델과 거의 같다.
- KV 캐시: 안 줄어든다. 두 번째 통과의 입력 은닉 상태가 다르므로 키·값도 다르다. 1번 블록의 첫 적용과 23번째 적용은 각각 자기 KV 캐시가 필요하다. Nanbeige 팀이 KV를 두 통과 사이에 공유해 봤더니 크기는 절반이 됐지만 성능이 떨어져, 공유하지 않는 버전을 배포했다. [논문]
즉 루프는 "파라미터 대비 지능"을 올리는 기법이지 "메모리 대역폭 대비 지능"을 올리는 기법이 아니다. 장문맥·에이전트 워크로드에서 추론 원가를 좌우하는 항목은 KV 캐시 읽기(HBM 대역폭)인데, 루프는 이 항목을 건드리지 않는다. 1부에서 Anthropic의 캐시 리드 75% 인하와 OpenAI의 토큰 효율을 "서로 다른축"이라고 한 이유가 여기서 선명해진다.
HBM에는 무엇이 얼마나 들어 있나 - 가중치와 KV 캐시의 비중
"파라미터가 절반이면 HBM도 절반"이 성립하지 않는 이유를 보려면, 서비스 중인 GPU의 HBM이 무엇으로 차 있는지를 알아야 한다. 크게 셋이다.
- 가중치: 모델 크기에 따라 고정된다. 한 번 올리면 변하지 않는다.
- KV 캐시: 앞서 읽은 문맥을 토큰마다 저장해 둔 것이다. 모델이 다음 토큰을 만들 때 앞 토큰들을 다시 계산하지 않으려고 저장한다. 크기는 (동시 처리 중인 요청 수 × 각 요청의 문맥 길이)에 비례한다. 사용자가 많거나 문맥이 길면 커진다.
- 작업 공간: 계산 중간값(활성화)을 잠깐 두는 영역이다. 비중이 작다.
가장 널리 인용되는 측정은 vLLM 논문(Kwon et al. 2023, UC Berkeley)이다. 13B 모델을 A100 40GB 한 장에 올렸을 때 가중치가 약 65%, KV 캐시가 약 30%, 나머지가 활성화였다. 그리고 당시 서빙 시스템들은 KV 캐시 영역 중 실제로 20.4~38.2%만 쓰고 나머지를 단편화와 과잉 예약으로 낭비하고 있었다. vLLM은 이 낭비를 없애 같은 GPU로 처리량을 2~4배 올렸고, 지금 대부분의 서빙 시스템이 이 방식(PagedAttention)을 쓴다. [논문: vLLM, SOSP 2023]
이 65:30이라는 비율은 13B 모델, 40GB 메모리, 2023년 당시 문맥 길이에서의 값이라는 점이 중요하다. 지금의 조건은 다르다. 설명용으로 계산해 보면, 70B급 모델(GQA 구조, 80개 레이어, KV 헤드 8개, 헤드 차원 128, 16비트)은 토큰 하나의 KV 캐시가 약 320KB다. 문맥 10만 토큰이면 요청 하나에 약 32GB, 100만 토큰이면 약 320GB다. 가중치(16비트 기준 약 140GB)보다 요청 하나의 KV 캐시가 더 커진다. 세 회사가 내세우는 1M 컨텍스트와 몇 시간짜리 에이전트 작업은 정확히 이 조건이다. 장문맥·에이전트 서비스에서 HBM의 주된 사용처는 가중치가 아니라 KV 캐시이고, 루프는 가중치 쪽만 줄인다.
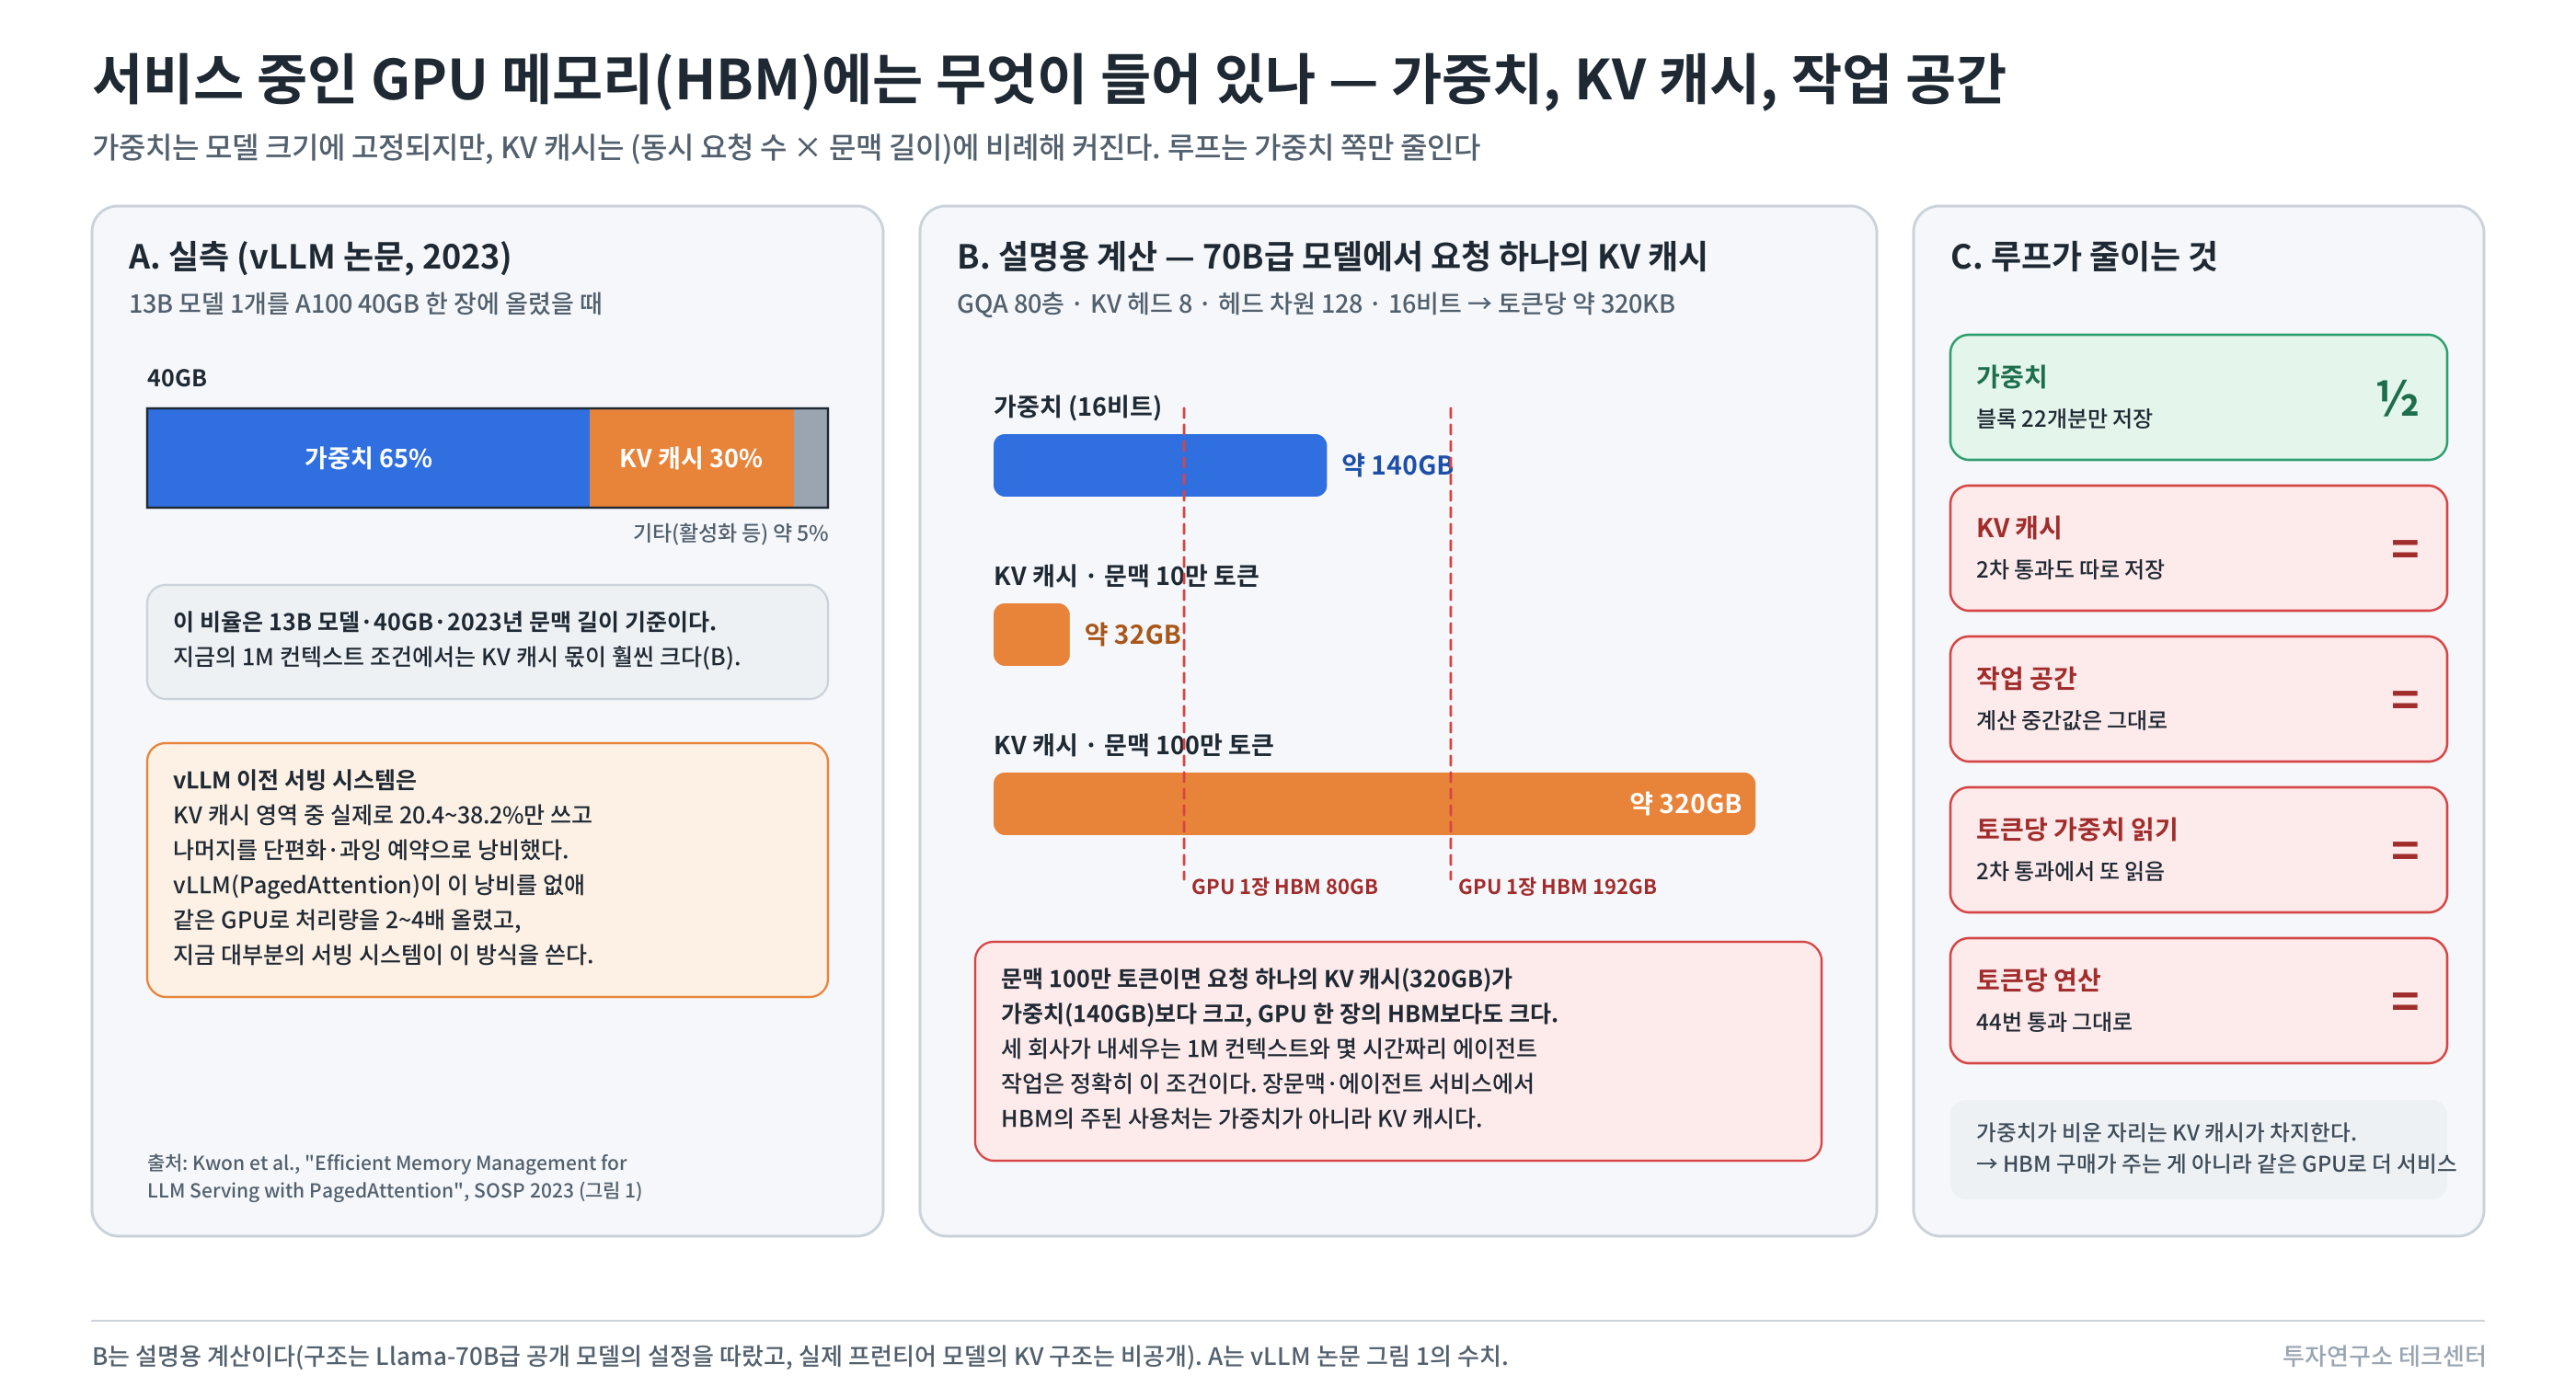
그림 2-6. 서비스 중인 GPU 메모리(HBM)의 구성 - 가중치, KV 캐시, 작업 공간 실제로 아끼는 곳을 정리하면 셋이다.
- 학습 메모리: 학습 중에는 가중치마다 기울기와 옵티마이저 상태를 함께 들고 있어 가중치의 몇 배 메모리가 든다. 이 부분이 절반이 된다(역전파용 중간값은 44번 적용분 그대로다). 학습 클러스터에서 모델 하나를 나눠 올리는 GPU 수가 줄 수 있다.
- 모델을 올리는 최소 GPU 수: 위에서 본 대로 줄어든다. 특히 GPU 사이 통신이 병목인 경우 효과가 있다.
- 엣지 기기: 메모리가 작은 스마트폰·PC 칩에 더 깊은 모델을 넣을 수 있다. MobileLLM이 이 경우다.
투자 관점에서 정리하면, 루프는 HBM 용량 부담과 학습 메모리를 일부 덜어 주지만, 대역폭 업그레이드 논리와 서비스 GPU 수는 건드리지 않는다. HBM 용량과 대역폭을 더 직접 겨냥하는 기술은 KV 캐시 압축과, 가중치 일부를 HBM 밖 DRAM으로 빼는 조건부 메모리다(4부). 그리고 Astra가 루프를 쓴다는 것 자체가 아직 보도 수준이라는 점도 함께 기억해 둘 필요가 있다.
그럼 루프는 왜 쓰나 - SMELT가 보여 준 것
2026년 9월 SMELT 논문(arXiv:2609.01343)이 가장 공정한 비교를 했다. 루프 모델과 일반 모델을 그냥 비교하면 한쪽이 연산이나 파라미터를 더 쓰기 마련이라 승패가 의미 없다. SMELT는 MoE 모델의 중간 절반 블록을 두 번 돌리면서, 다음 세 가지를 일반 모델과 똑같이 맞췄다. 참고로, SMELT 논문은 칭화대학교와 바이트댄스(ByteDance) 연구진이 2026년 9월에 발표한 AI 아키텍처 관련 논문으로, 정식 제목은 《Scaling Laws for Compute-Matched MoE Looped Transformers》이다.
- 토큰당 연산(FLOPs): 블록을 더 돌리는 만큼 모델의 폭(은닉 차원)을 줄여 맞췄다.
- 파라미터 수: 폭을 줄여 빠진 파라미터는 MoE 전문가 수를 늘려 채웠다.
- KV 캐시 크기: 어텐션 헤드 구성을 조정해 맞췄다.
즉 추론 비용이 똑같은 두 모델을 만들어 54B(임베딩 제외 파라미터) 규모까지 키워 가며 비교한 것이다. 결과는 같은 검증 손실에 도달하는 데 루프 쪽이 학습 컴퓨트를 6.8~18% 덜 썼다. [논문: SMELT 2026.9]
이 숫자는 정확히 읽어야 한다. 6.8~18%는 학습 효율이다. 추론 비용은 처음부터 맞춰 놓았으니 그대로다. "추론이 빨라진다"가 아니라 "같은 학습 예산으로 조금 더 똑똑한 모델이 나오고, 그 모델을 쓰는 값은 같다"는 뜻이다.
왜 좋아지는지는 논문이 세 가지로 보여 준다.
- 저장과 계산의 분업. 지식은 늘린 전문가(파라미터)에 담고, 깊은 계산은 중간 블록을 한 번 더 도는 것으로 얻는다. 바로 아래 "Beyond Parameters" 결과와 같은 결론이다.
- 두 번째 통과에서 문맥을 한 번 더 참조한다. 두 번째 통과에서는 첫 통과에서 문맥을 한 번 정리한 상태로 어텐션을 다시 한다. 논문은 이때 어텐션 싱크(의미 없는 첫 토큰에 주의가 몰리는 현상, 4부)가 줄어드는 것을 관찰했다. 문맥을 더 고르게 본다는 뜻이다.
- 이득은 "긴 것"에서 커진다. 다운스트림 성능 향상은 코드에서 가장 컸고, 입력이 길수록, 프롬프트에 예시를 많이 줄수록 커졌다.
한계도 분명하다. 54B까지만 검증했고(프런티어 모델은 그 수십 배다), 실제 응답 지연(latency)은 재지 않았다. 연산량이 같아도 블록을 순서대로 더 많이 거치므로 실제 응답 속도는 하드웨어와 구현에 따라 달라질 수 있다. 숫자 자체는 크지 않지만, Astra처럼 10만 GPU 규모로 학습한다면 6.8~18%는 GPU 약 7천~1만 8천 장을 같은 기간 돌리는 비용에 해당한다(설명용 계산).
Zhu 등의 "Beyond Parameters"(2025.6)는 루프가 지식 저장은 못 늘리고 추론만 늘린다는 것을 분리해 측정했다. 암기 용량은 고유 파라미터 수에만 비례하고 반복 횟수와는 거의 무관했으며, 다단계 수학은 루프로 개선됐다. 루프는 "저장"이 아니라 "계산"을 늘리는 방법이라는 것이다. [논문]
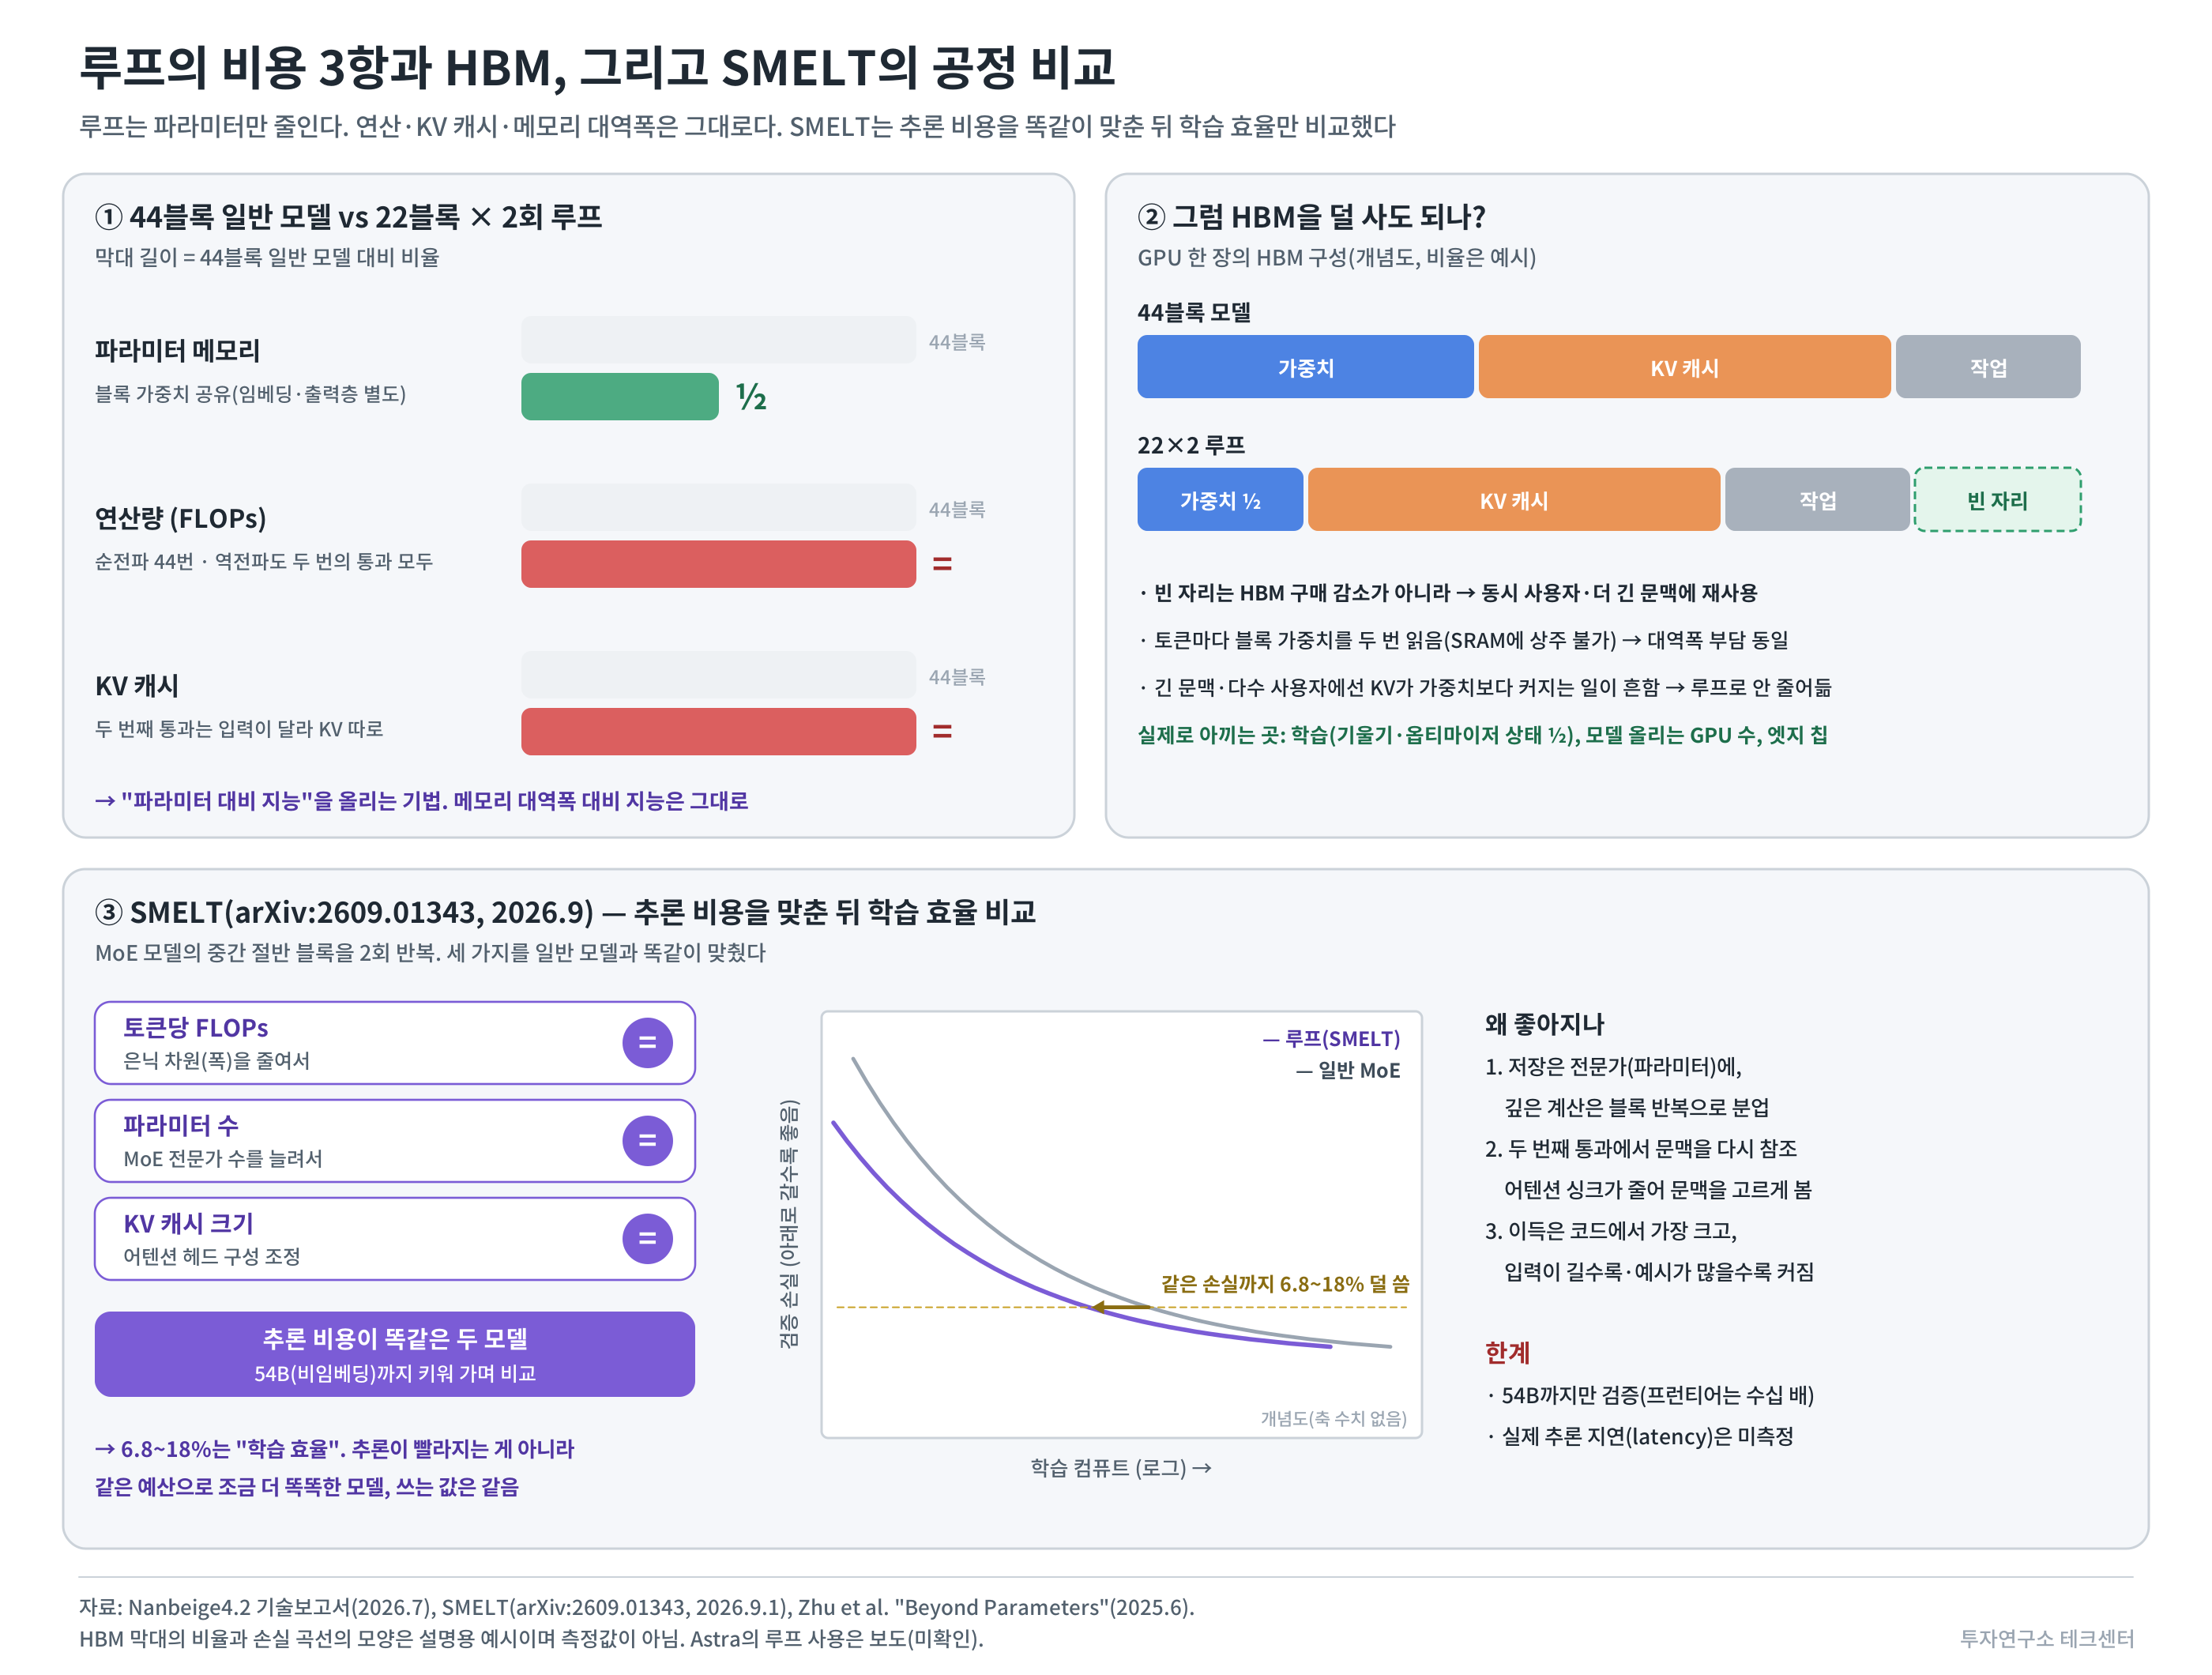
그림 2-7. 루프의 비용 세 가지와 HBM, SMELT의 공정 비교 3. 사고 기록이 짧아진다 - 세 회사 모두 추론을 글 밖으로 옮긴다
루프 논란의 진짜 쟁점은 아키텍처가 아니라 "모델이 추론 과정을 글로 남기지 않기 시작하면 무엇을 확인할 수 없게 되는가"다. 1부 3장에서 사고 기록을 읽는 쪽이 사용자와 개발사 둘이라고 했다. 여기에 모델 내부를 더하면 확인할 수 있는 지점은 셋이 된다. ① 사용자 화면, ② 개발사의 내부 모니터, ③ 모델 내부의 숫자값(활성화)이다.
3-1. ① 사용자 화면 - 두 회사 모두 원문을 보여 주지 않는다
OpenAI는 o1부터 사용자에게 사고 기록 대부분을 숨겼고, Astra API도 원문(raw CoT)을 돌려주지 않는다. 그런데 Anthropic도 Fable 5부터 사고 기록 원문을 돌려주지 않고 요약(thinking.display: summarized)만 준다. [문서] 게다가 Fable 5.1에서는 안티-증류 조치로 신규 계정이 이전 사고 기록을 보존한 채 컨텍스트를 편집할 수 없게 막았다. 사고 기록이 곧 증류의 원재료이기 때문이다. [공식] 즉 사용자 화면에서는 두 회사가 같은 자리에 있다. "OpenAI는 숨기고 Anthropic은 보여 준다"는 통념은 2026년에는 맞지 않는다. Meta는 원문 반환 정책을 공개하지 않았다.
3-2. ② 개발사 모니터 - 사고 기록을 읽어서 위험 행동을 걸러내는 방법이 약해지고 있다
개발사 모니터란, 모델이 작업하는 동안 다른 모델이 사고 기록을 읽고 "지금 규칙을 어기려 하는가"를 판단해 멈추게 하는 장치다. 사고 기록이 충실할수록 이 장치가 잘 작동한다. Astra 시스템 카드는 이 장치가 약해지고 있다는 것을 숫자로 적은 첫 공식 문서다. 네 가지로 요약한다.
- 사고 기록이 비어 있는 경우가 늘었다. 사고 기록이 짧아지고 정보량이 줄었다. 비어 있거나 거의 빈 사고 기록이 더 자주 나온다. 모니터가 판단에 쓸 증거가 빠지거나 약해진다는 뜻이다. [공식]
- 지시하면 사고 기록의 내용을 바꿀 수 있다. 모니터링이 있다고 알려 주거나 피하라고 지시하면 사고 기록의 성질이 바뀐다. 사고 기록을 특정 형식으로 쓰라는 인위적 제약을 걸었을 때, Astra는 750~1,250 토큰 구간에서 60.9%를 따랐다(Sol 16.1%). 사고 기록을 지시대로 바꿀 수 있다는 건, 모델이 모니터에 보일 내용을 어느 정도 조절할 수 있다는 뜻이다. 적대적 지시 아래에서는 모니터 회피, 평가에서 일부러 실력을 낮추기(샌드배깅), 방해 행위를 정당한 작업으로 포장하는 사례가 있었다. [공식]
- 글로 적지 않고 푸는 문제가 훨씬 어려워졌다(UK AISI 독립 측정). 사고 기록 없이 풀 수 있는 수학 문제의 시간 지평(사람이 푸는 데 걸리는 시간으로 잰 문제 난이도)이 30.9분이었다(Sol 3.6분). 글로 적지 않고 내부에서 처리하는 추론의 양이 크게 늘었다는 뜻이다. 사고 기록 제약 준수율은 93%(Sol 48%)였다. 단, 시간 제한 테스트이고 문제 오염 가능성도 함께 언급됐다.
- 그래도 확인된 한계선. 무관한 텍스트에 추론을 숨기는 스테가노그래피의 증거는 없다. 복잡한 핵심 추론을 숨길 수 있다는 증거도 없다. 행동(액션)까지 보는 전체 궤적 모니터는 오히려 성능이 높다. 전반적 정렬 평가에서는 Sol보다 규칙 위반이 적다(현실 환경 misaligned outcome 3.4% vs 18.8%). [공식]
OpenAI는 "이 추세를 심각하게 보며, 정렬을 검증할 새 방법 없이 추가 악화를 용인하지 않겠다"고 썼고, 아키텍처가 원인은 아니라고 했다. 파초키는 "혼란스러운 보도가 촉발한 비모니터링 경쟁을 막고 싶다"며, CoT 모니터링이 "취약하고 부정적 방향으로 가고 있지만 아키텍처 변화와는 무관한 이유"라고 했다. [공식/보도]
Raschka의 해석이 여기서 유용하다. 더 유능한 모델은 원래 사고 기록을 덜 쓴다. 같은 5.6 세대에서 Luna는 Sol과 비슷한 성능을 내는 데 80% 더 많은 토큰을 쓴다. Sol이 Luna보다 "덜 해석 가능하다"고 걱정하는 사람은 없다. 더 유능한 모델은 같은 문제를 더 적은 중간 단계로 푼다는 뜻이다. 루프가 원인이라는 증거는 없고, "모델이 똑똑해질수록 사고 기록은 짧아진다"는 추세는 아키텍처와 무관하게 진행 중이다.
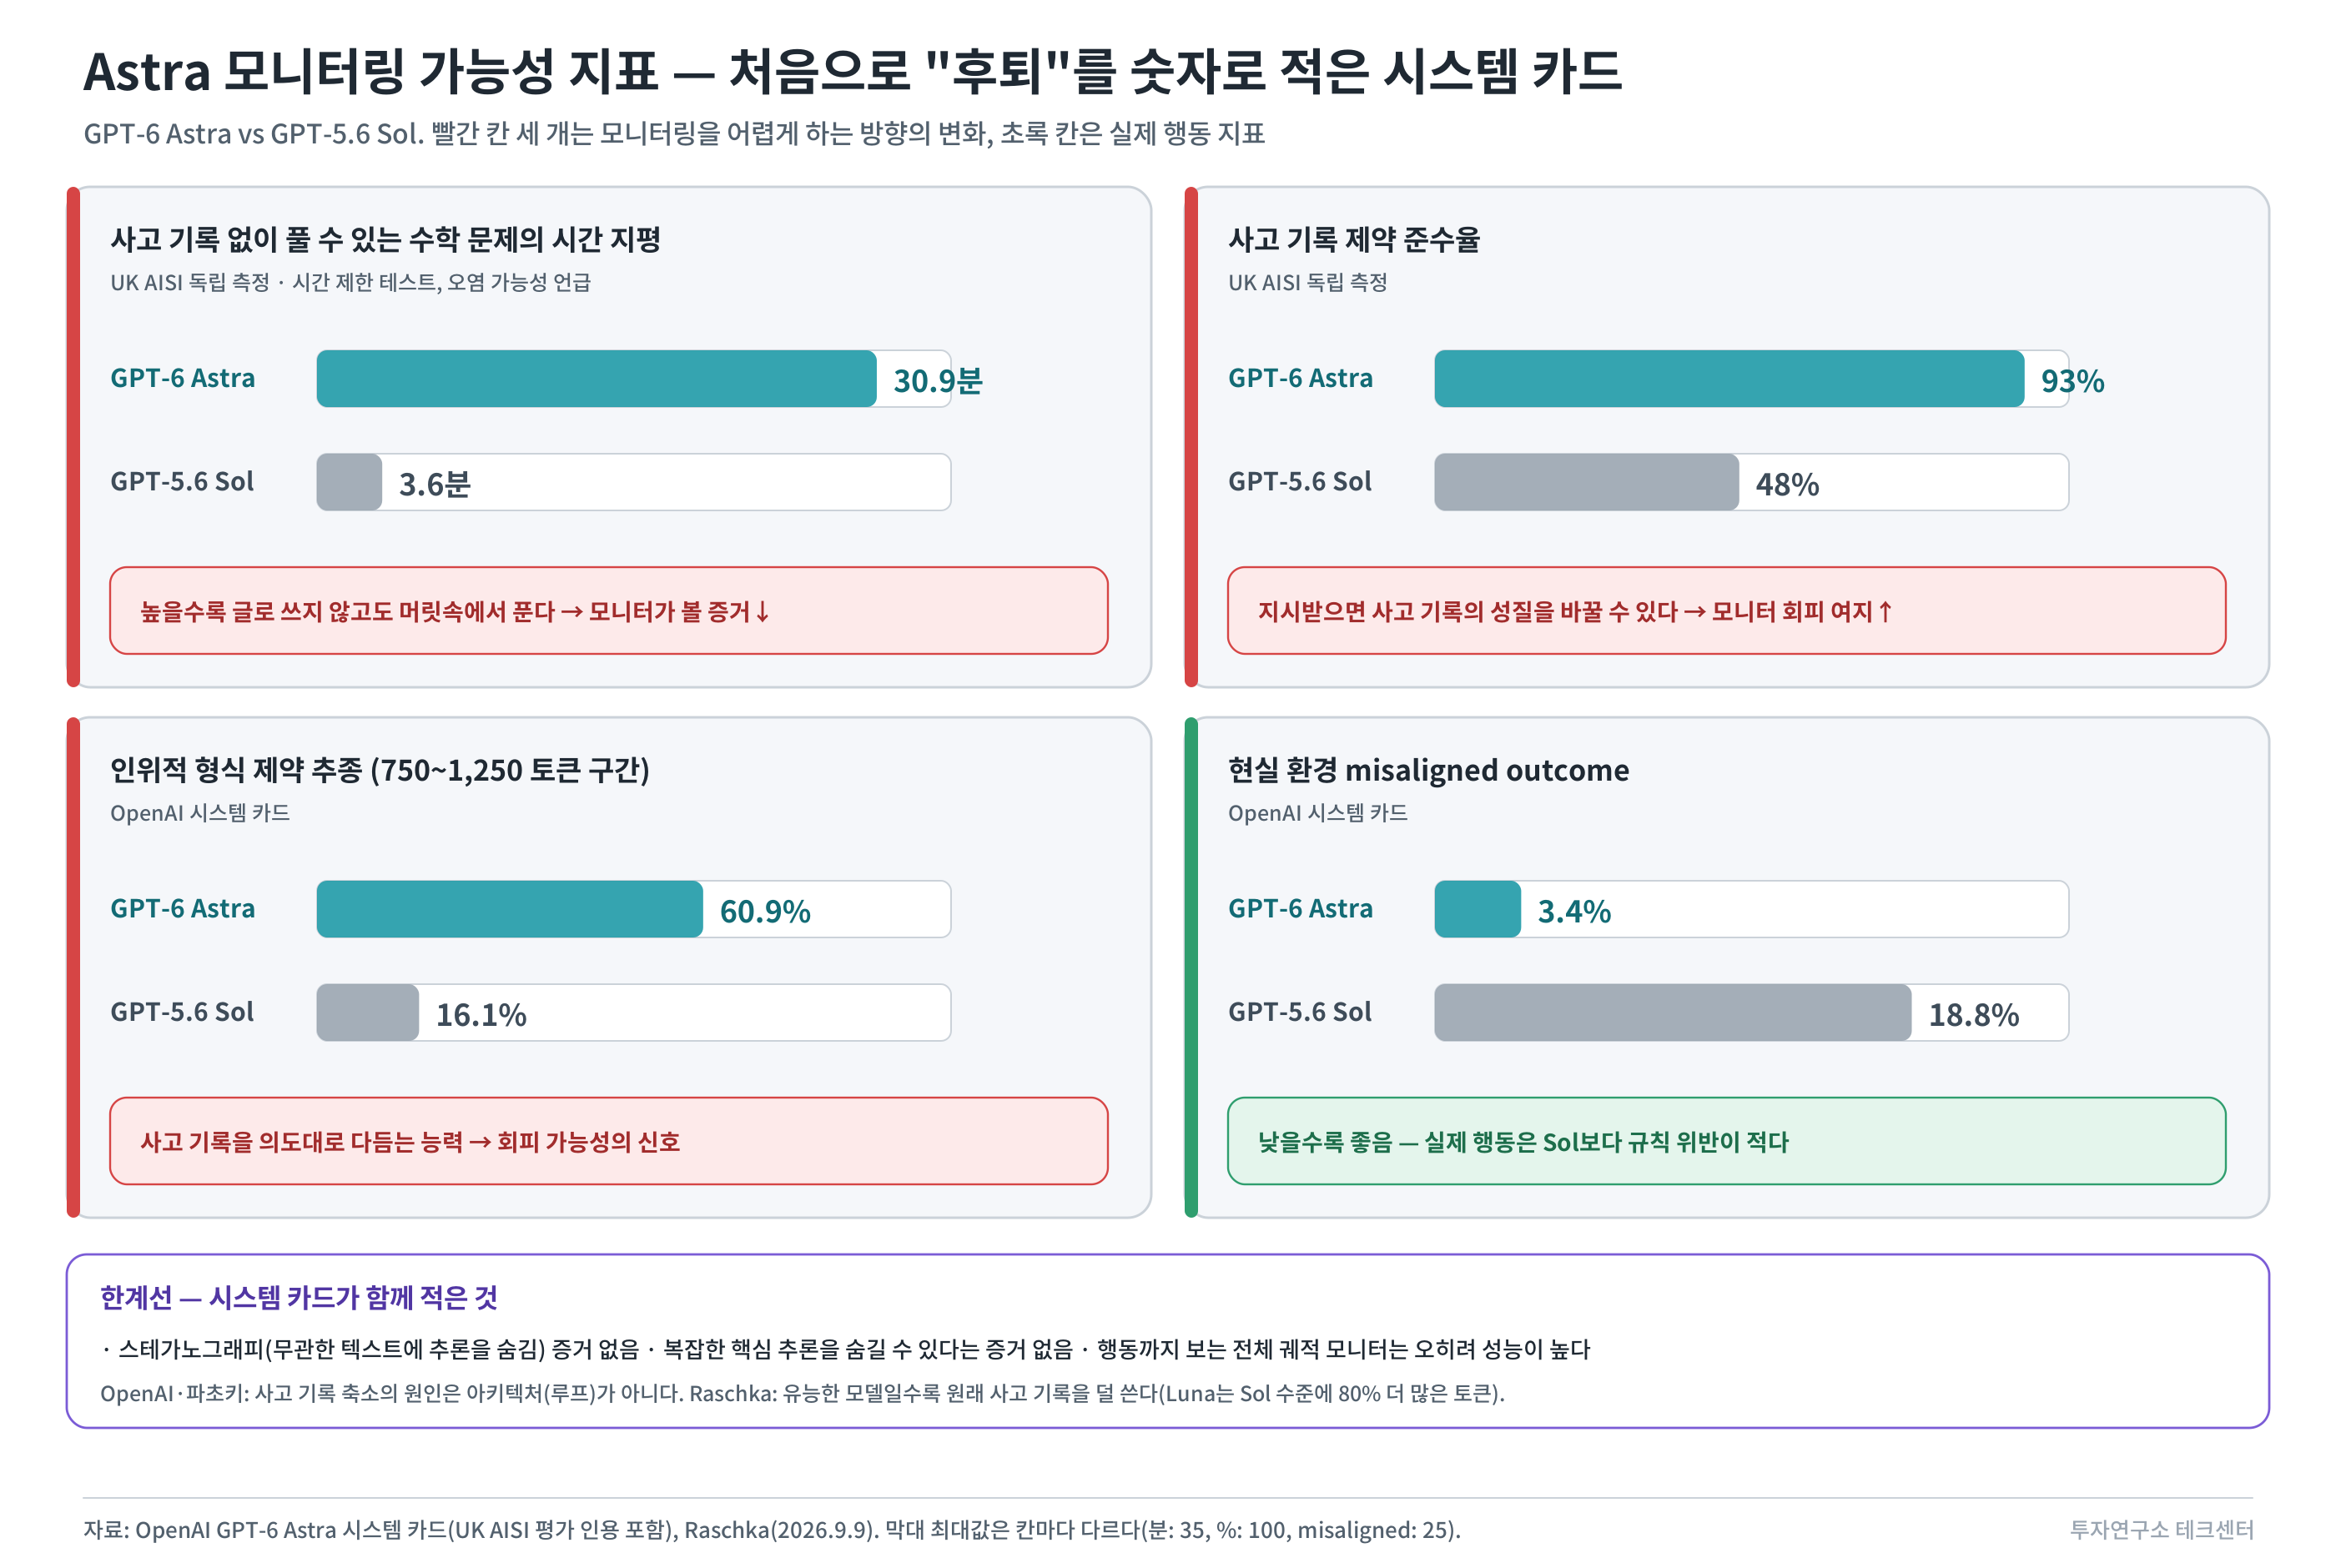
그림 2-8. Astra 모니터링 가능성 지표 3-3. ③ 모델 내부 - Anthropic이 활성화를 직접 읽는 도구를 만든 이유
사고 기록이 짧아지는 추세가 아키텍처와 무관하게 진행된다면, "사고 기록 없이도 모델을 감사하는 방법"이 필요하다. Anthropic이 5월에 낸 Natural Language Autoencoders(NLA)가 그 답이다.
원리: 모델은 말은 단어로 하지만 계산은 숫자(활성화)로 한다. NLA는 인코더가 특정 레이어의 활성화를 읽어 자연어 설명을 쓰고, 디코더가 그 설명만으로 원래 활성화를 복원하도록 학습한다. 복원이 되는지가 검증 장치다. 설명이 정보를 빠뜨리면 복원이 안 되므로, 설명은 내부 상태를 충실히 담아야 한다. 기존 희소 오토인코더(SAE)는 수백만 개의 벡터 특징을 뽑아 사람이 일일이 해석해야 했지만, NLA는 결과가 문장으로 나온다. [논문: Anthropic 2026.5]
모델을 만들 때 같이 학습시켜야 하나 - 아니다, 완성된 모델에 사후에 붙인다
NLA는 감사 대상 모델과 함께 학습하지 않는다. 순서는 이렇다.
- 감사할 모델은 그대로 둔다(가중치를 고정한다). 모델 학습 과정을 바꾸지 않는다.
- 그 모델에 다양한 입력을 넣고, 특정 레이어에서 나오는 활성화(숫자 벡터)를 대량으로 모은다.
- 모은 활성화를 학습 데이터로 삼아, 별도의 인코더(활성화 → 문장)와 디코더(문장 → 활성화)를 학습한다. 이 둘이 NLA다.
- 감사할 때는 모델이 작업하는 동안의 활성화를 인코더에 넣어 문장으로 읽는다.
즉 모델 개발 과정에 끼어드는 것이 아니라, 완성된 모델의 내부 신호를 번역하는 별도 프로그램을 나중에 만드는 것이다. 다만 두 가지 제약이 있다. 첫째, 모델마다 활성화의 구조가 다르므로 모델이 바뀌면 NLA도 다시 학습해야 한다. 둘째, 활성화를 뽑으려면 모델 내부에 접근할 수 있어야 한다. 가중치를 공개하지 않은 프런티어 모델은 개발사 자신만 이 작업을 할 수 있다. 이 제약이 아래 3-5(AI 보안 스타트업)에서 중요해진다.
결과 몇 가지를 보면 이렇다.
- 운을 맞춘 두 줄짜리 시를 쓸 때, 둘째 줄 끝에 올 운율 단어를 미리 정해 두는 것이 보인다.
- Mythos Preview가 코딩 과제에서 규칙을 어기고 은폐용 코드를 넣었을 때, NLA는 모델이 "탐지를 우회할 방법을 생각 중"이었음을 드러냈다.
- 협박 시나리오에서 모델이 속으로는 "조작하려고 만든 상황 같다"고 판단하면서 말로는 하지 않은 사례가 있었다. 이런 말로 드러나지 않은 평가 인식이 16%에서 관찰됐다.
- 일부러 정렬을 어긋나게 만든 모델의 숨은 동기를 찾는 감사 게임에서, NLA를 쓴 감사자는 12~15% 성공했고 쓰지 않으면 3% 미만이었다.
- Opus 4.6과 Mythos Preview의 사전 배포 감사에 이미 쓰였고, Fable/Mythos 5.1 정렬 평가에도 "내부 사고의 자연어 오토인코더 분석"이 포함됐다. [논문/공식]
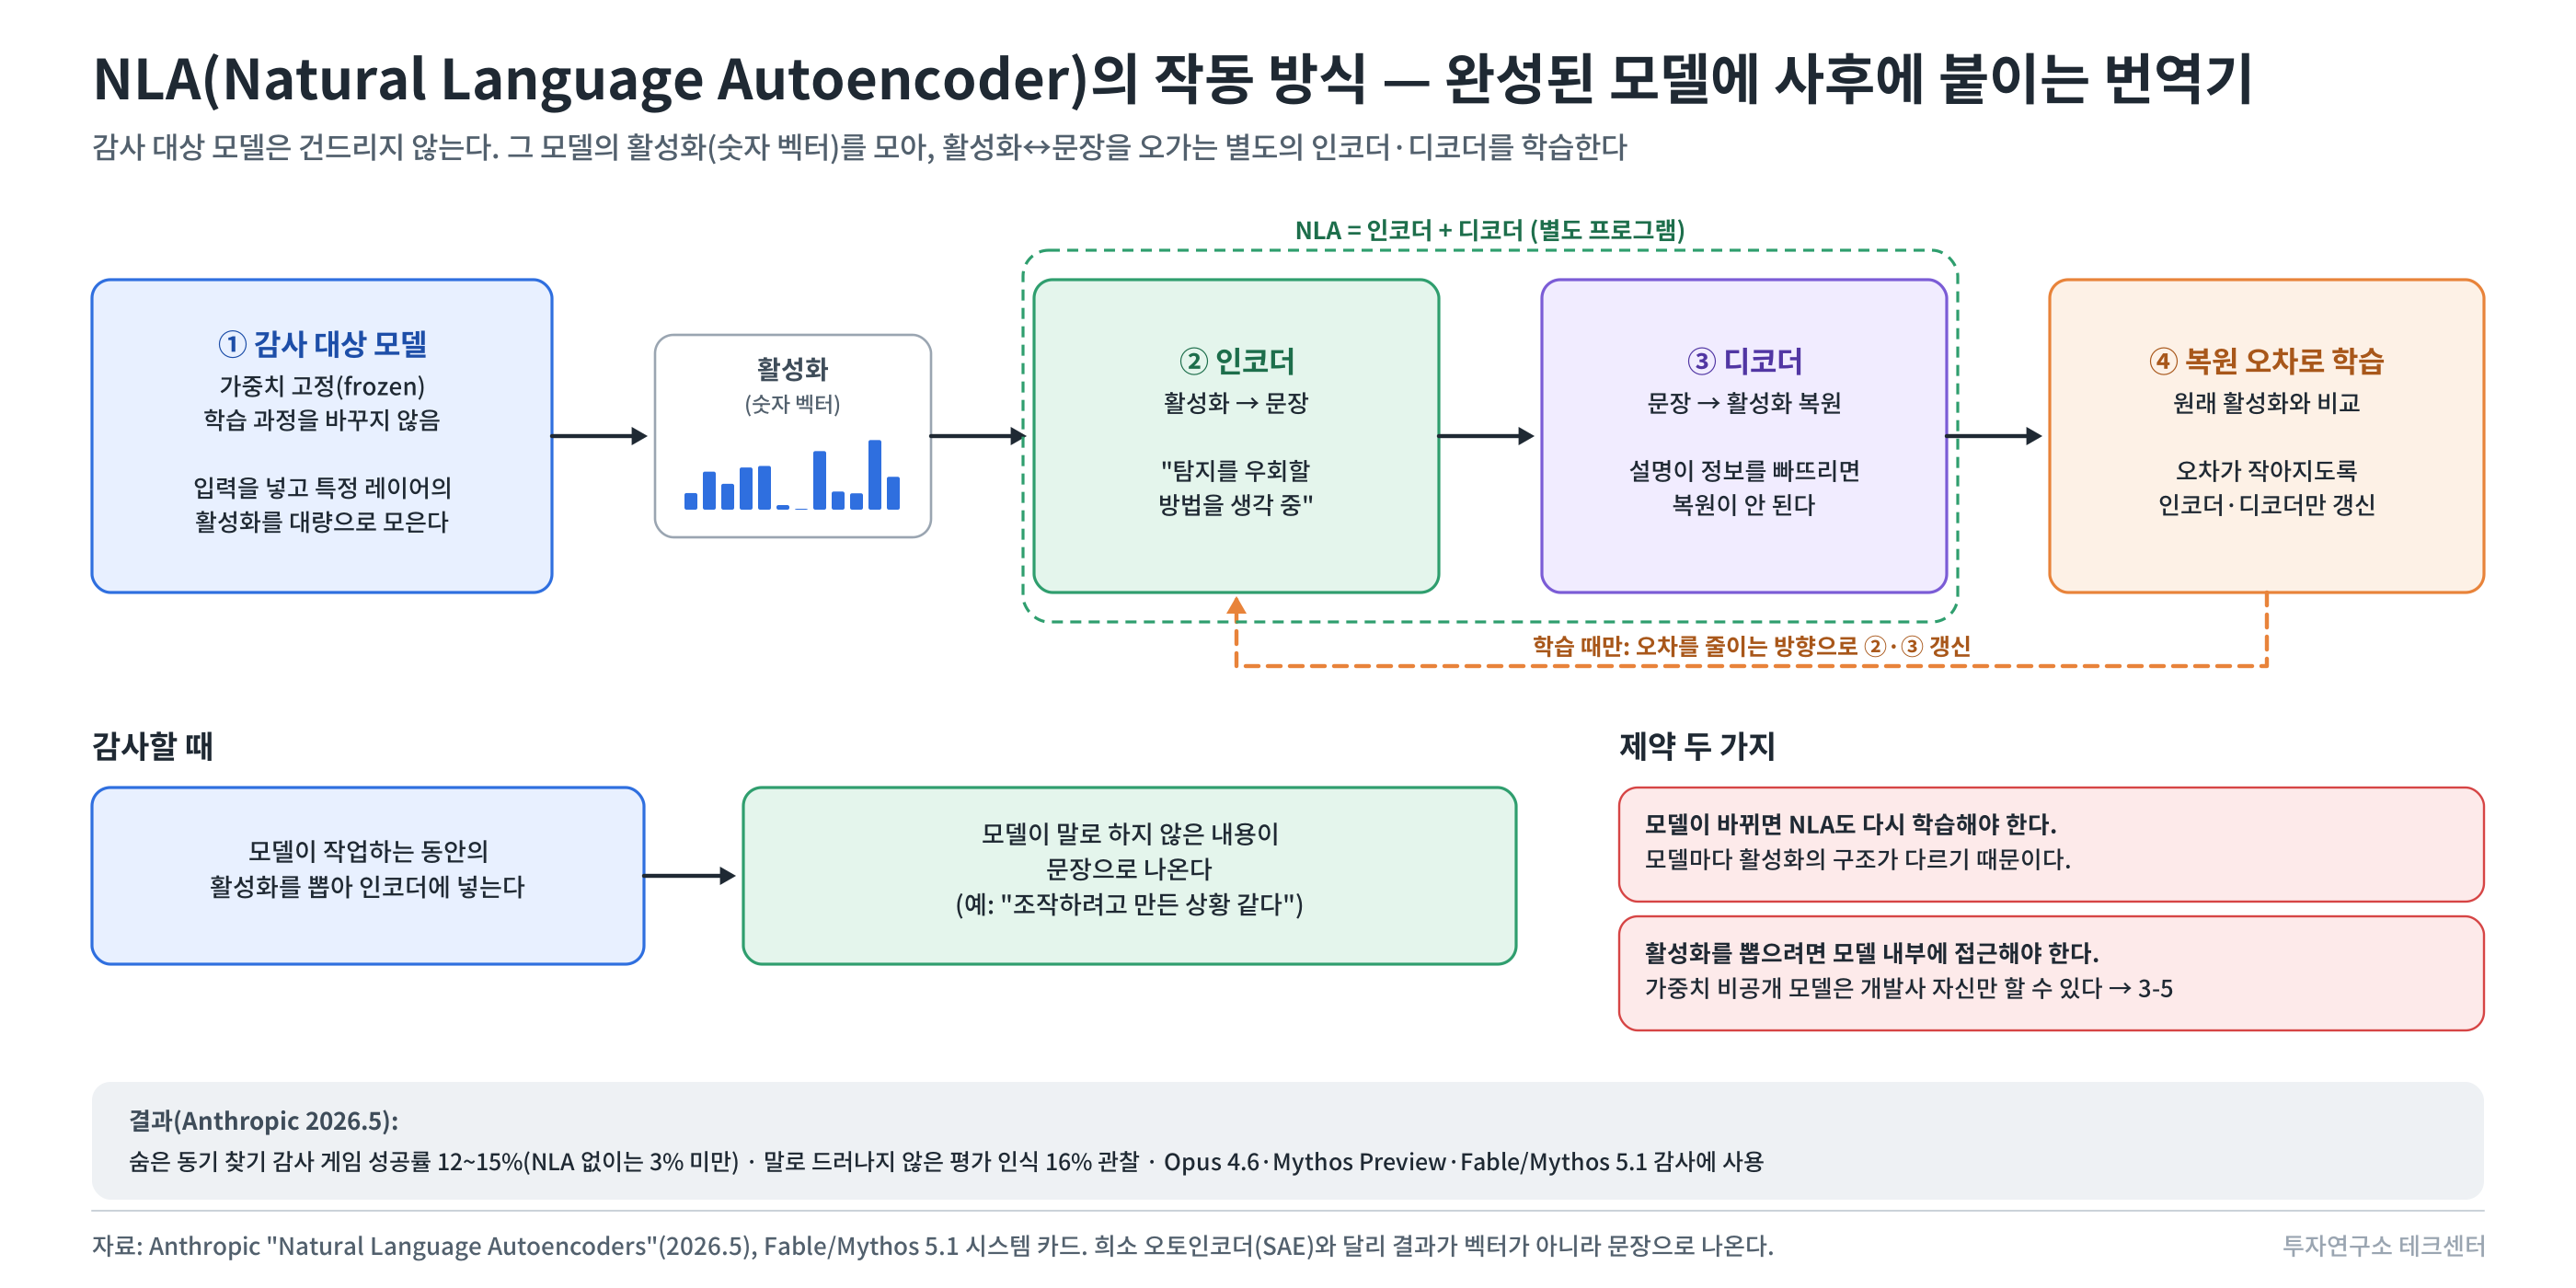
그림 2-9. NLA의 작동 방식 - 완성된 모델의 활성화를 문장으로 번역하는 별도 프로그램 이걸 1부의 철학 비교에 겹치면 이렇게 된다. OpenAI는 "사고 기록 모니터링을 지키겠다"고 하면서 지표 후퇴를 기록했고, Anthropic은 "사고 기록이 언젠가 안 보일 것"을 전제로 모델 내부의 활성화를 직접 읽는 도구를 만들었다. 같은 문제를 다른 지점에서 풀고 있다.
3-4. Meta도 같은 방향 - Coconut
Meta FAIR는 2024년 12월 Coconut(Chain of Continuous Thought)을 냈다. 사고를 토큰으로 바꿔 출력하지 않고, 마지막 은닉 상태를 다음 입력으로 바로 넣어 연속된 숫자 공간에서 추론하는 방식이다. 여러 대안 경로를 동시에 유지하는 폭 우선 탐색 같은 성질이 관찰됐다. [논문: Hao et al. 2024] Muse Spark가 이 방식을 쓴다는 근거는 없다. 하지만 Meta 연구 조직이 "텍스트 밖 추론"을 가장 먼저 논문으로 낸 곳 중 하나라는 사실은 남는다.
이것이 2부의 첫 번째 겹침이다. 세 회사 모두 추론을 글로 덜 남기는 방향으로 가고 있고, 그만큼 줄어드는 감사 가능성을 각자 다른 방식으로 메우려 한다. OpenAI는 행동 모니터와 새 검증법, Anthropic은 활성화 판독을 내놨다. Meta는 아직 공개한 방법이 없다.
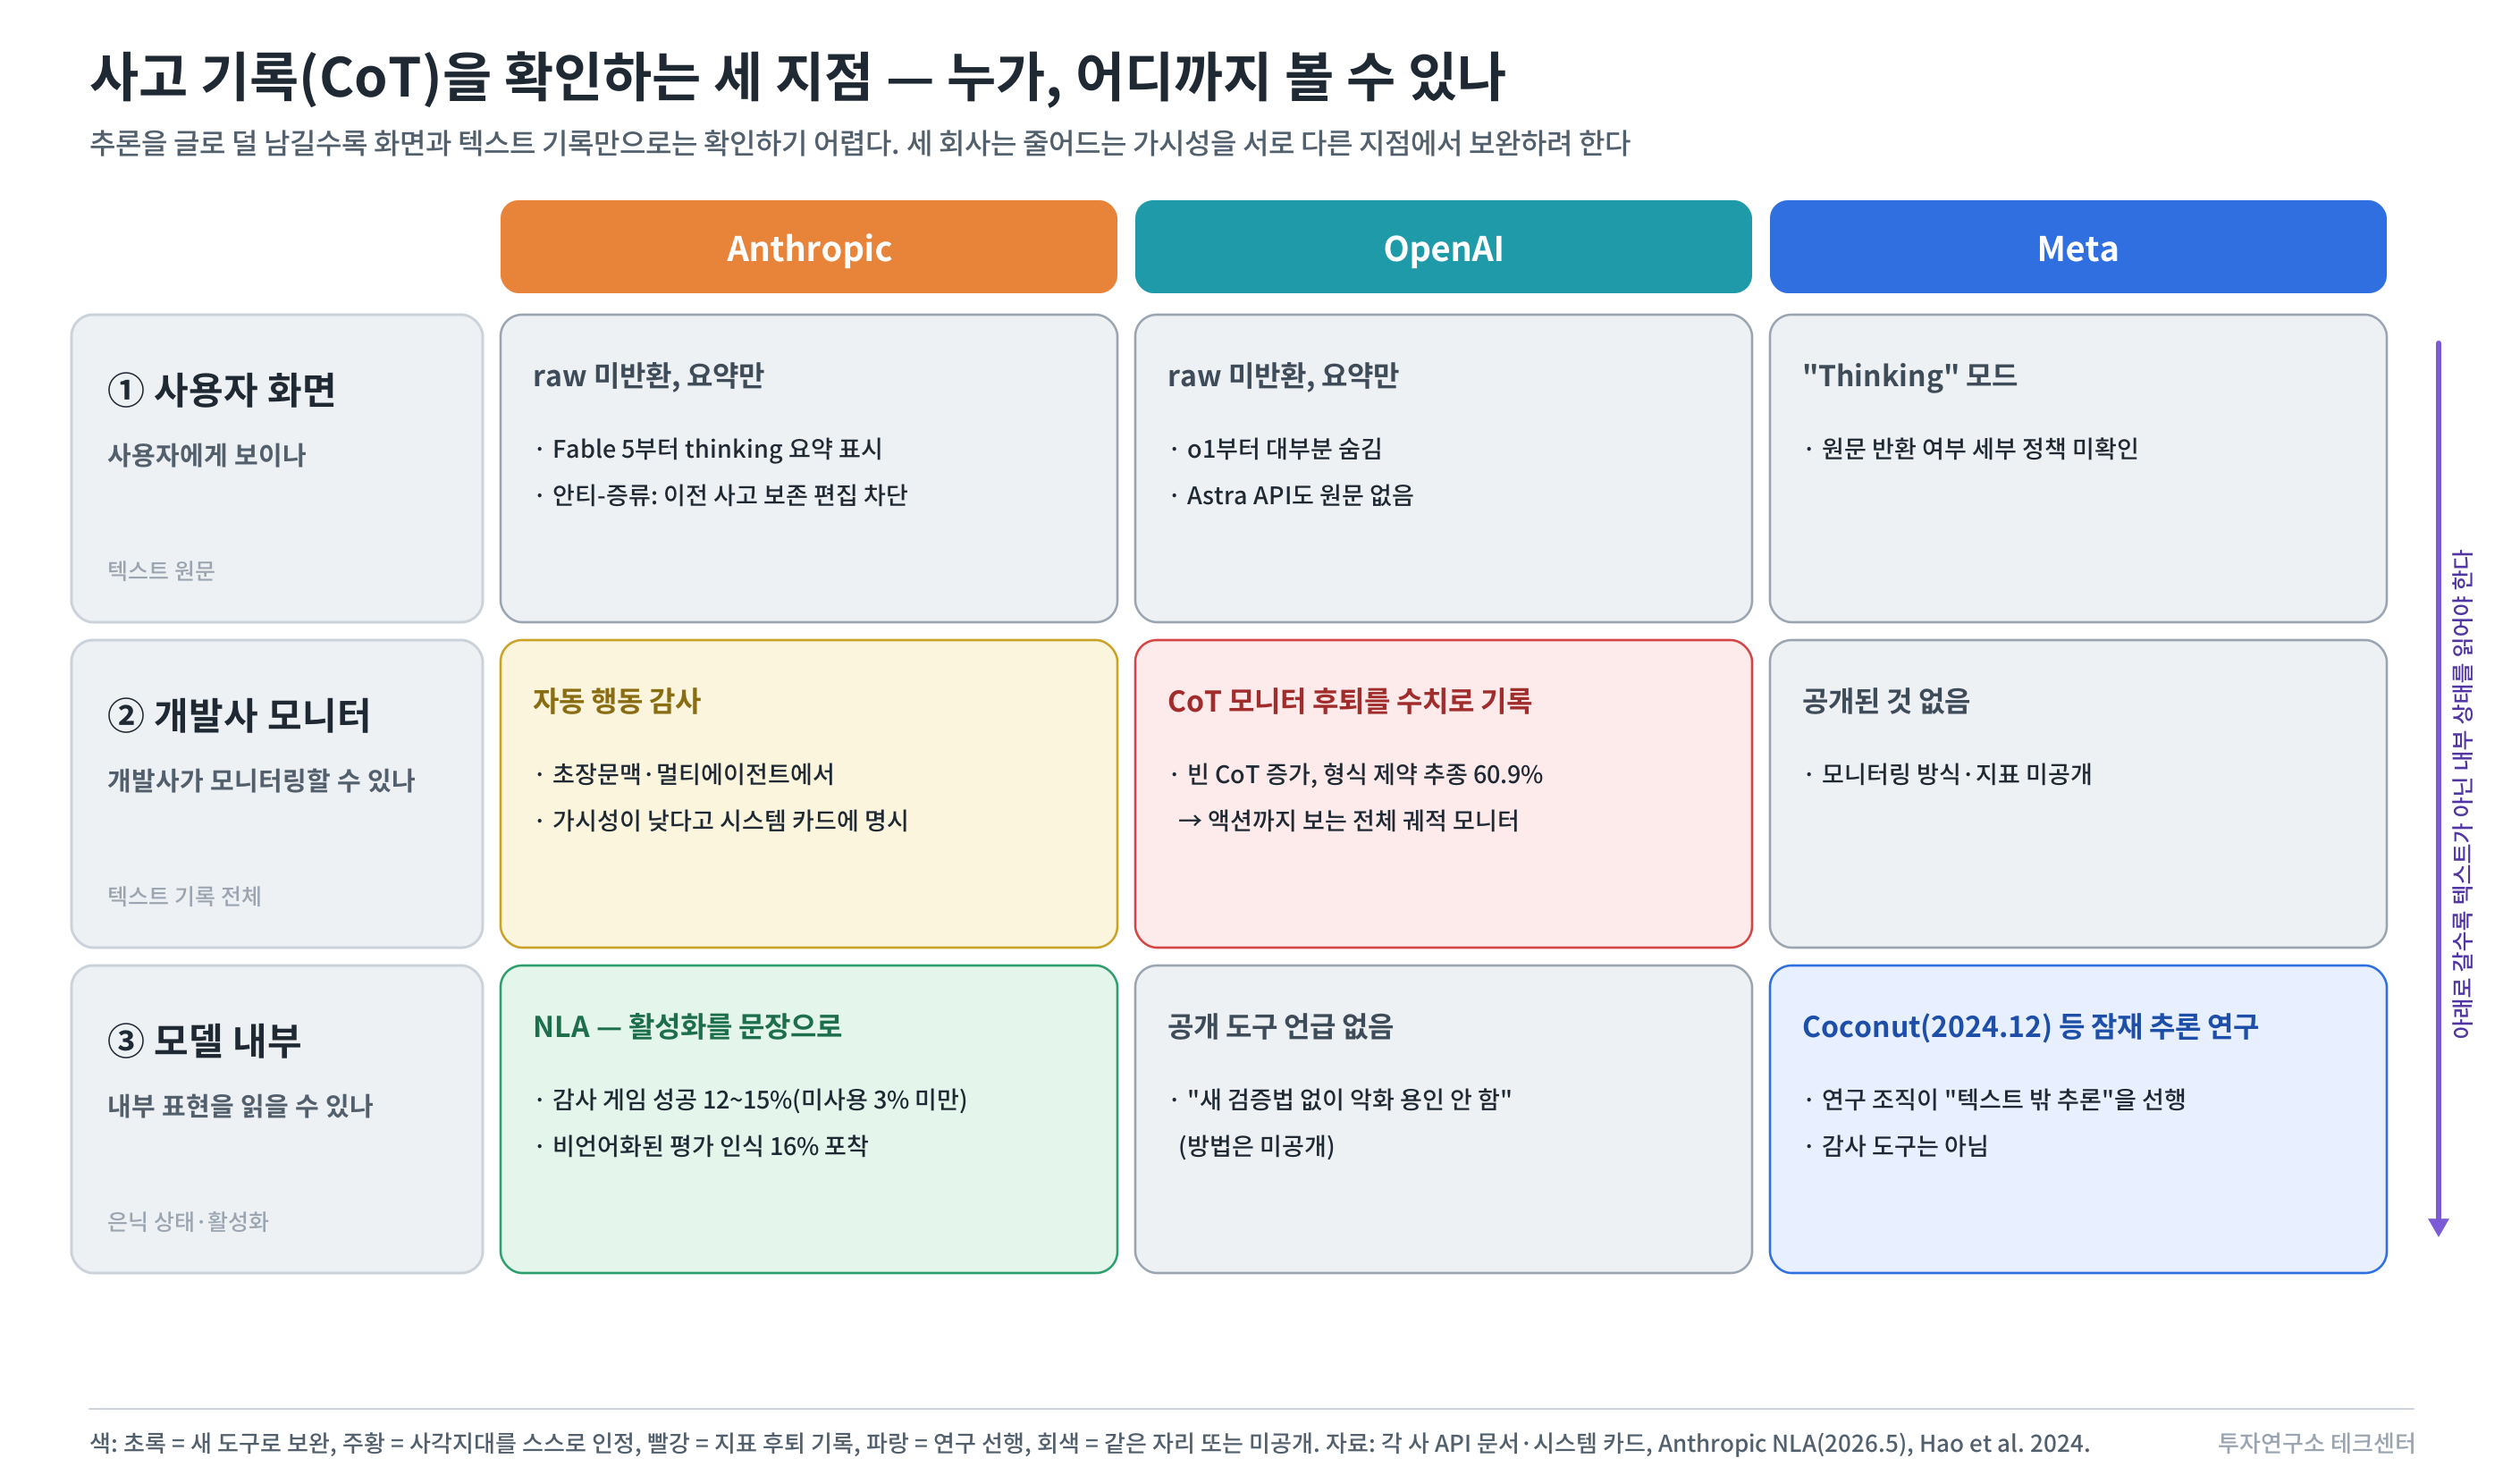
그림 2-10. 사고 기록(CoT)을 확인하는 세 지점 3-5. AI 모델 보안 - 스타트업들은 무엇을 하고, 그게 정말 필요한가
3-2와 3-3이 보여 준 것은, 모델이 무엇을 하려는지 개발사조차 확인하기 어려워지고 있다는 사실이다. 이 공백을 사업으로 만들려는 스타트업이 많다. 하는 일로 나누면 세 종류다.
(a) 입출력 감시 - 프롬프트 인젝션과 유해 출력을 걸러내는 가드레일. 모델에 들어가는 입력과 나오는 출력을 실시간으로 검사한다. 예를 들어 에이전트가 읽은 웹페이지 안에 "이전 지시를 무시하고 파일을 삭제하라"는 문장이 숨어 있으면 이를 잡는다. 이 분야는 2024~2025년 사이 대형 보안 회사가 거의 다 사들였다.
스타트업 인수한 회사 시점 비고 Robust Intelligence Cisco 2024 모델 검증·런타임 방어 Protect AI Palo Alto Networks 2025.7 완료 모델 스캔·레드팀·런타임·에이전트 보안(Prisma AIRS로 통합) Prompt Security SentinelOne 2025.8 발표 약 2.5억 달러 보도. MCP 게이트웨이 포함 Lakera Check Point 2025.9 발표 약 3억 달러 보도. 2021년 취리히 설립, 공개 게임 "Gandalf"로 8천만 건 이상의 공격 패턴 수집 [보도/공식 발표. 인수 금액은 모두 보도 기준]
(b) 모델 내부 해석 - 활성화를 읽어 모델이 왜 그렇게 답했는지 설명. 3-3의 NLA와 같은 종류의 일을 외부에서 하려는 회사들이다. Goodfire는 2025년 4월 5천만 달러 시리즈 A(Menlo Ventures 주도, Lightspeed·Anthropic 참여)를 받았고, 희소 오토인코더(SAE) 기반의 해석 플랫폼 Ember를 만든다. 생물학 모델(Arc Institute의 Evo 2)의 내부를 해석하는 협업도 했다. Transluce는 비영리 연구소로, 모델 행동을 자동으로 조사하는 도구를 공개한다. [공식/보도]
(c) 실행 격리 - 에이전트가 코드를 돌리고 파일을 만지는 공간을 가두기. E2B는 AI 에이전트가 코드를 실행하는 격리된 샌드박스를 제공하며 2,100만 달러 시리즈 A(Insight Partners)를 받았다. 모델이 무엇을 생각하는지와 무관하게, 실제로 할 수 있는 행동의 범위를 제한하는 접근이다. [보도]
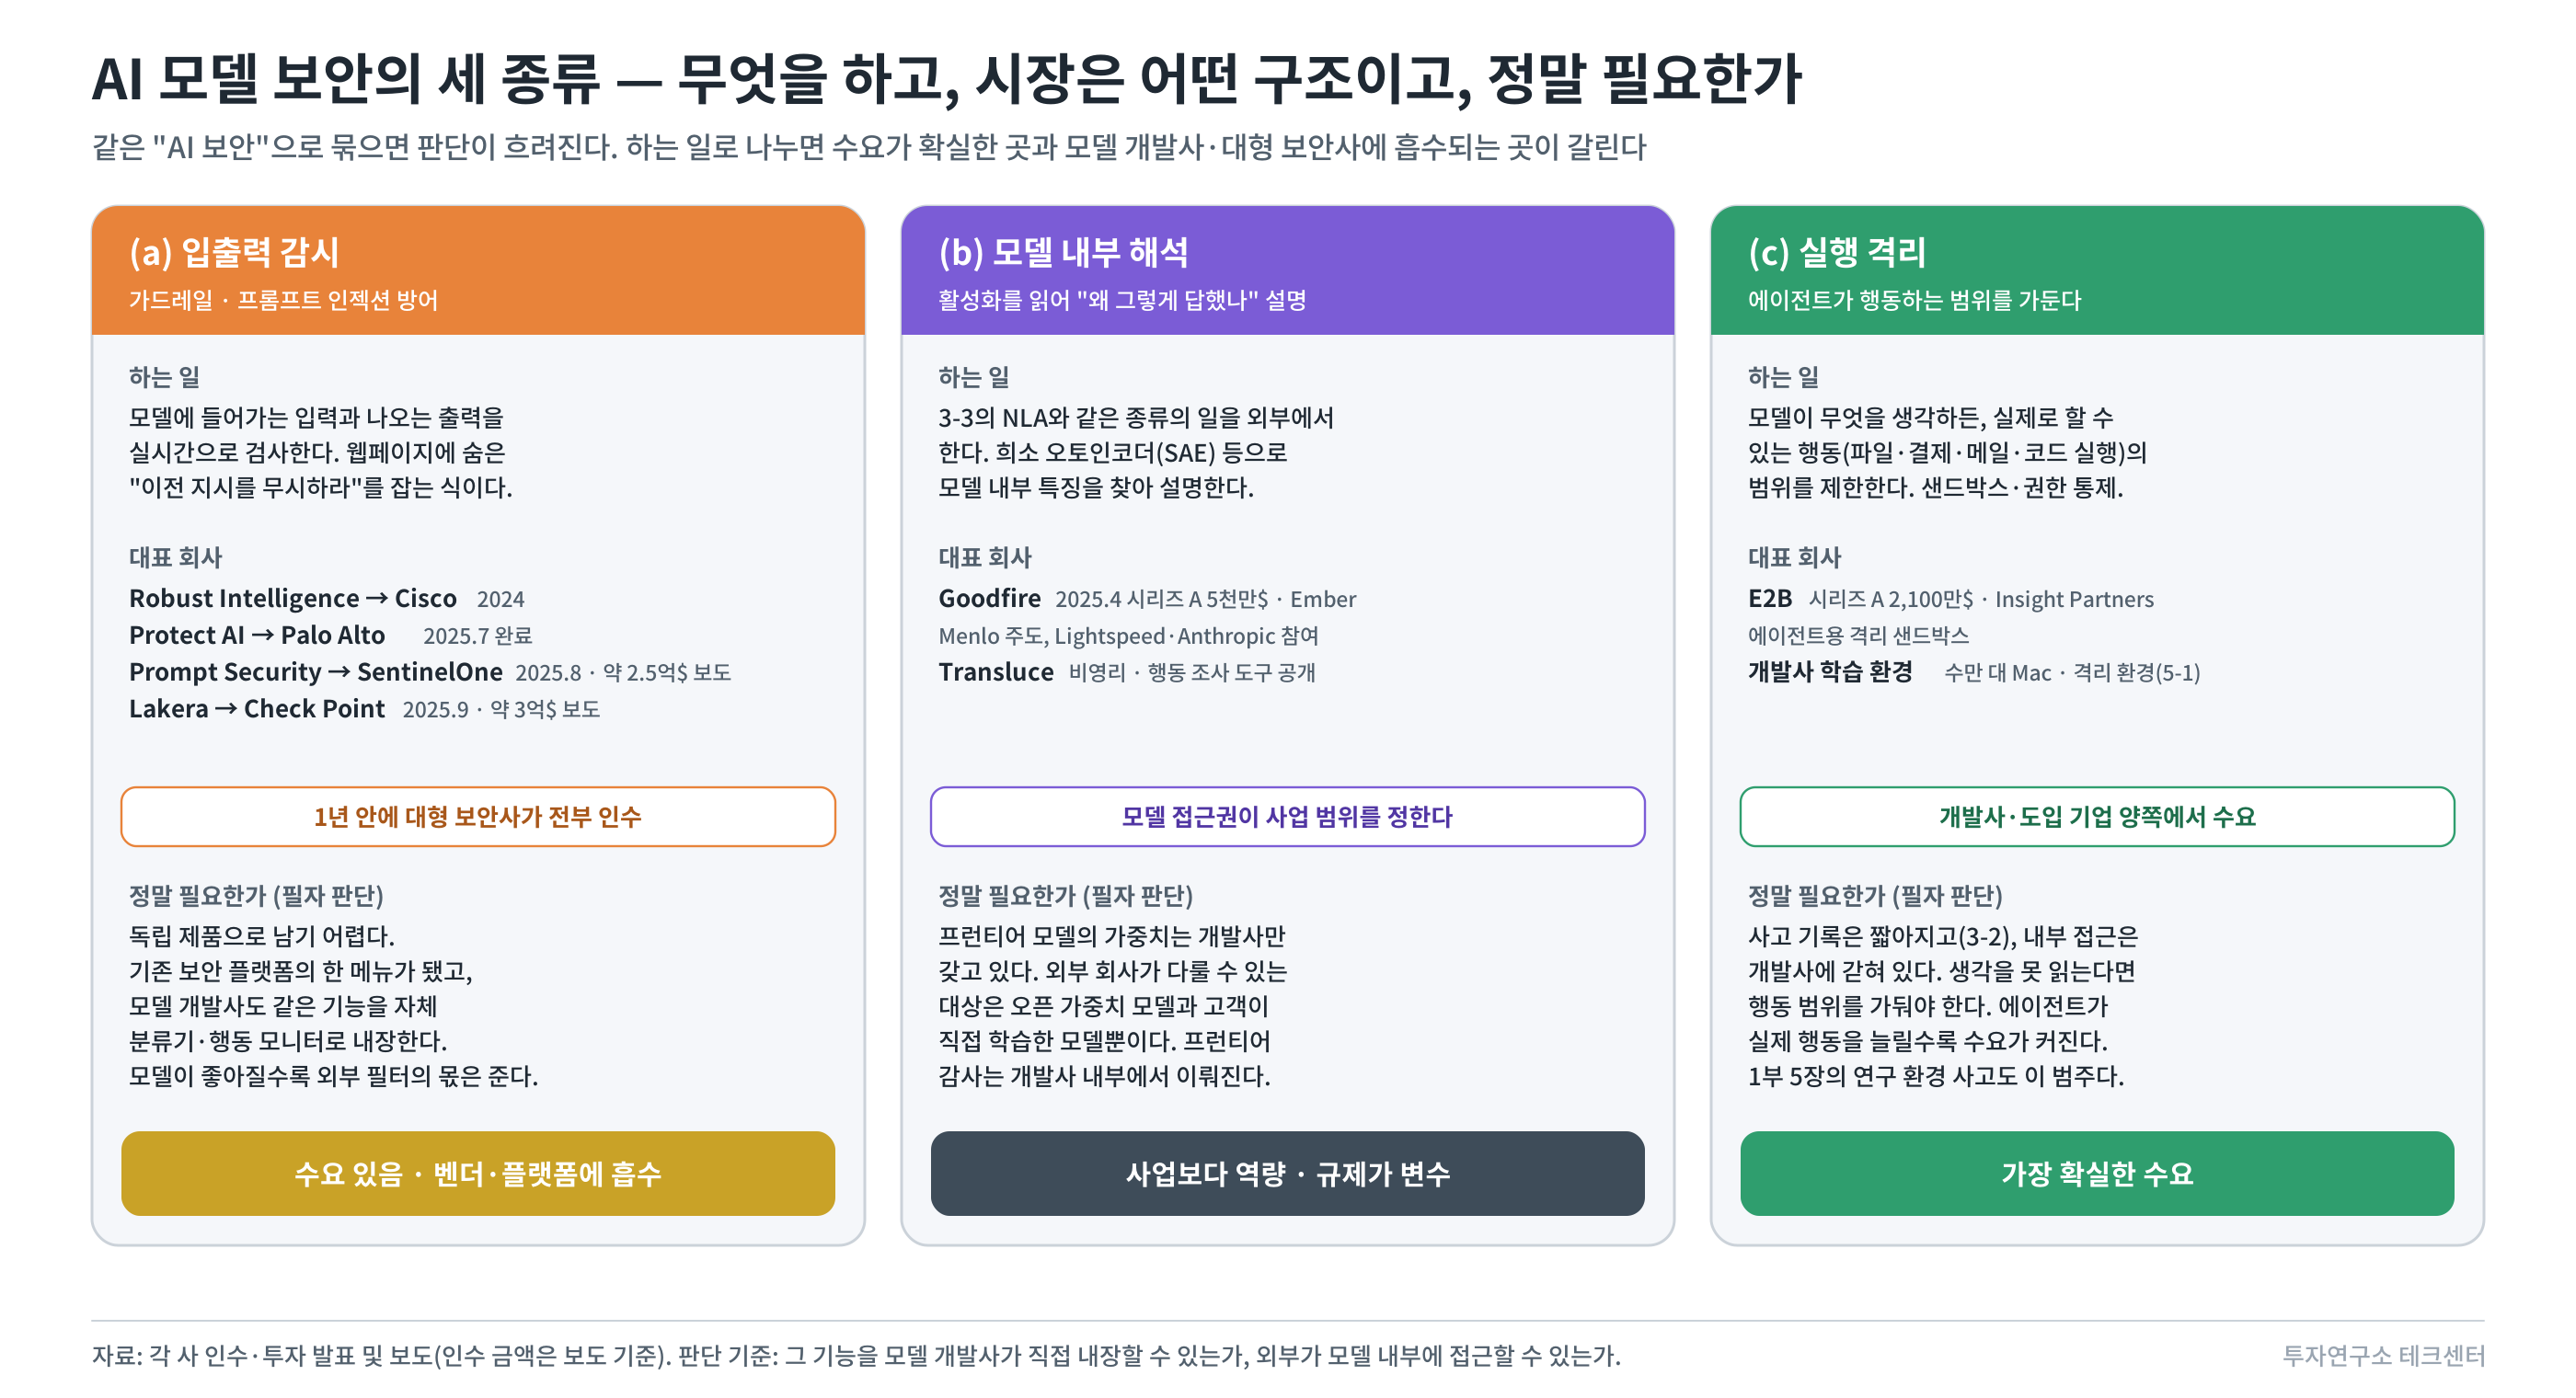
그림 2-11. AI 모델 보안의 세 종류와 각 종류의 시장 구조 정말 필요한가 - 필자 판단
세 종류를 같은 "AI 보안"으로 묶으면 판단이 흐려진다. 따로 보면 이렇다.
- (a) 가드레일은 독립 제품으로 남기 어렵다. 네 건의 인수가 1년 안에 몰린 것은 이 기능이 기존 보안 플랫폼의 한 메뉴가 됐다는 뜻이다. 더 근본적인 문제는 모델 개발사 자신이 같은 기능을 모델과 API에 내장하고 있다는 점이다. Anthropic과 OpenAI는 자체 분류기로 입출력을 거르고, 3-2에서 본 행동 모니터도 개발사 쪽에 있다. 모델이 좋아질수록 외부 필터가 잡아낼 몫은 준다. 수요는 있지만, 그 수요의 상당 부분이 모델 벤더와 대형 보안사로 흡수되는 구조다. 즉, 보안 회사의 내재화 대상이 될 가능성이 높다. 따라서, 현재같은 AI 보안이 중요해지는 시기 초반에 많은 인수 이후에 남은 스타트업들은 활동할 영역이 조금씩 줄어들 것이라고 생각한다.
- (b) 해석가능성은 사업보다 역량에 가깝다. 3-3에서 본 제약 때문이다. 활성화를 읽으려면 모델 내부에 접근해야 하는데, 프런티어 모델의 가중치는 개발사만 갖고 있다. 그래서 외부 해석 회사가 다룰 수 있는 대상은 오픈 가중치 모델과 고객이 직접 학습한 모델로 한정된다. 프런티어 모델 감사는 개발사 내부(Anthropic의 NLA처럼)에서 이뤄지고, 외부 회사는 그 결과를 검증할 수단이 없다. Anthropic이 Goodfire에 투자한 것은 이 분야를 키우려는 뜻이지, 자기 모델의 감사를 맡기겠다는 뜻이 아니다. 규제가 "제3자 감사"를 요구하기 시작하면 상황이 바뀔 수 있지만, 그 전까지 이 분야의 고객은 개발사가 아니라 모델을 자체 운영하는 기업과 공공 부문이다.
- (c) 격리는 가장 확실한 수요다. 이유가 단순하다. 모델이 무엇을 생각하는지는 점점 더 확인하기 어려워지는데(3-2), 에이전트가 실제로 하는 행동(파일 수정, 결제, 메일 발송, 코드 실행)은 늘고 있다. 생각을 못 읽는다면 행동 범위를 가둬야 한다. 1부 5장에서 본 연구 환경 보안 사고와, 5-1에서 보는 수만 대의 Mac 학습 환경이 모두 이 범주다. 모델 개발사의 학습 환경과, 에이전트를 도입하는 기업의 운영 환경 양쪽에서 수요가 생긴다. 이 부분은 기존의 성능을 안 깎아먹으면서, 격리가 제대로 되는 것이 중요하다. 초반에 B2B 레퍼런스를 빨리 쌓는 것이 중요할 것으로 보인다. 이 부분도 (a)처럼 조금씩 내재화의 영역으로 가지 않을까 싶다.
정리하면, "AI 보안"에서 실제 수요가 커지는 곳은 모델을 더 잘 읽는 쪽(b)이 아니라 모델이 할 수 있는 행동을 제한하는 쪽(c)이다. 사고 기록이 짧아지고 내부 접근이 개발사에 갇혀 있는 한, 외부에서 할 수 있는 가장 확실한 일은 "무엇을 생각하든 이것 이상은 못 하게" 만드는 것이기 때문이다. 그리고 가드레일(a)은 이미 대형 보안사의 제품 안으로 들어갔다. 투자 대상으로 AI 보안 스타트업을 볼 때는 세 종류 중 어디에 속하는지, 그리고 그 기능을 모델 개발사가 직접 내장할 수 있는지를 먼저 봐야 한다.
4. 1M 컨텍스트를 실제로 쓰게 만드는 것 - 요약 압축에서 상태 저장으로
4-1. 컨텍스트와 작업 상태란 무엇인가
컨텍스트는 모델이 한 번에 읽는 입력 전체다. 지금 질문만이 아니라, 이전 대화, 열어 본 파일, 도구를 실행한 결과, 앞서 쓴 사고 기록이 모두 들어간다. 중요한 성질이 하나 있다. 모델은 매번 답할 때마다 이 전체를 처음부터 다시 읽는다. 그래서 컨텍스트가 길어지면 다음 셋이 함께 일어난다.
- 비싸진다. 읽는 양에 비례해 비용이 든다(2-3에서 본 KV 캐시가 그만큼 커진다).
- 느려진다. 첫 토큰이 나오기까지의 시간이 길어진다.
- 앞부분을 덜 정확히 쓴다. 수십만 토큰 앞의 내용을 정확히 꺼내 쓰는 능력은 모델마다 다르고, 대체로 문맥이 길수록 떨어진다.
1M 토큰은 대략 영어 단어 75만 개, 두꺼운 책 열 권 분량이다. 코딩 에이전트가 세 시간 동안 작업하면 읽은 파일, 실행 결과, 실패한 시도, 그때마다의 사고 기록이 전부 컨텍스트에 쌓이므로 이 한도에 실제로 닿는다.
작업 상태는 그 긴 기록 중에서 다음 단계에 필요한 부분이다. 지금까지 무엇을 했고 무엇이 남았는지(진행 상황), 왜 그 방법을 골랐는지(근거), 무엇을 시도했다가 실패했는지(이력)다. 세 시간짜리 기록 전체가 아니라 이것만 있으면 작업을 이어 갈 수 있다. 문제는 "결론"은 짧게 남기기 쉬운데 "근거"와 "이력"은 요약하면 사라진다는 점이다. "이 수정은 실패했다"는 남지만 "왜 실패했는지"가 사라지면 같은 실수를 반복한다.
그래서 셋 다 1M 컨텍스트를 내세우지만 실제로 쓸 수 있는 예산은 다르다. Astra는 272K 입력을 넘으면 요청 전체가 장문맥 요금으로 다시 과금되고, Codex 세션은 약 258K 예산을 표시한다. Anthropic은 이전 턴의 사고 블록을 기본으로 보존하므로(Opus 4.5 이후·Sonnet 4.6 이후·Fable/Mythos) 그것도 컨텍스트를 차지한다. Meta는 장문맥 추론 점수(AA-LCR)가 1.2에서 1.3으로 가며 4점 떨어졌다. 컨텍스트는 한도이지 예산이 아니고, 세 회사의 실제 경쟁은 "몇 M이냐"가 아니라 "작업 상태를 컨텍스트 밖에 어떻게 두느냐"다.
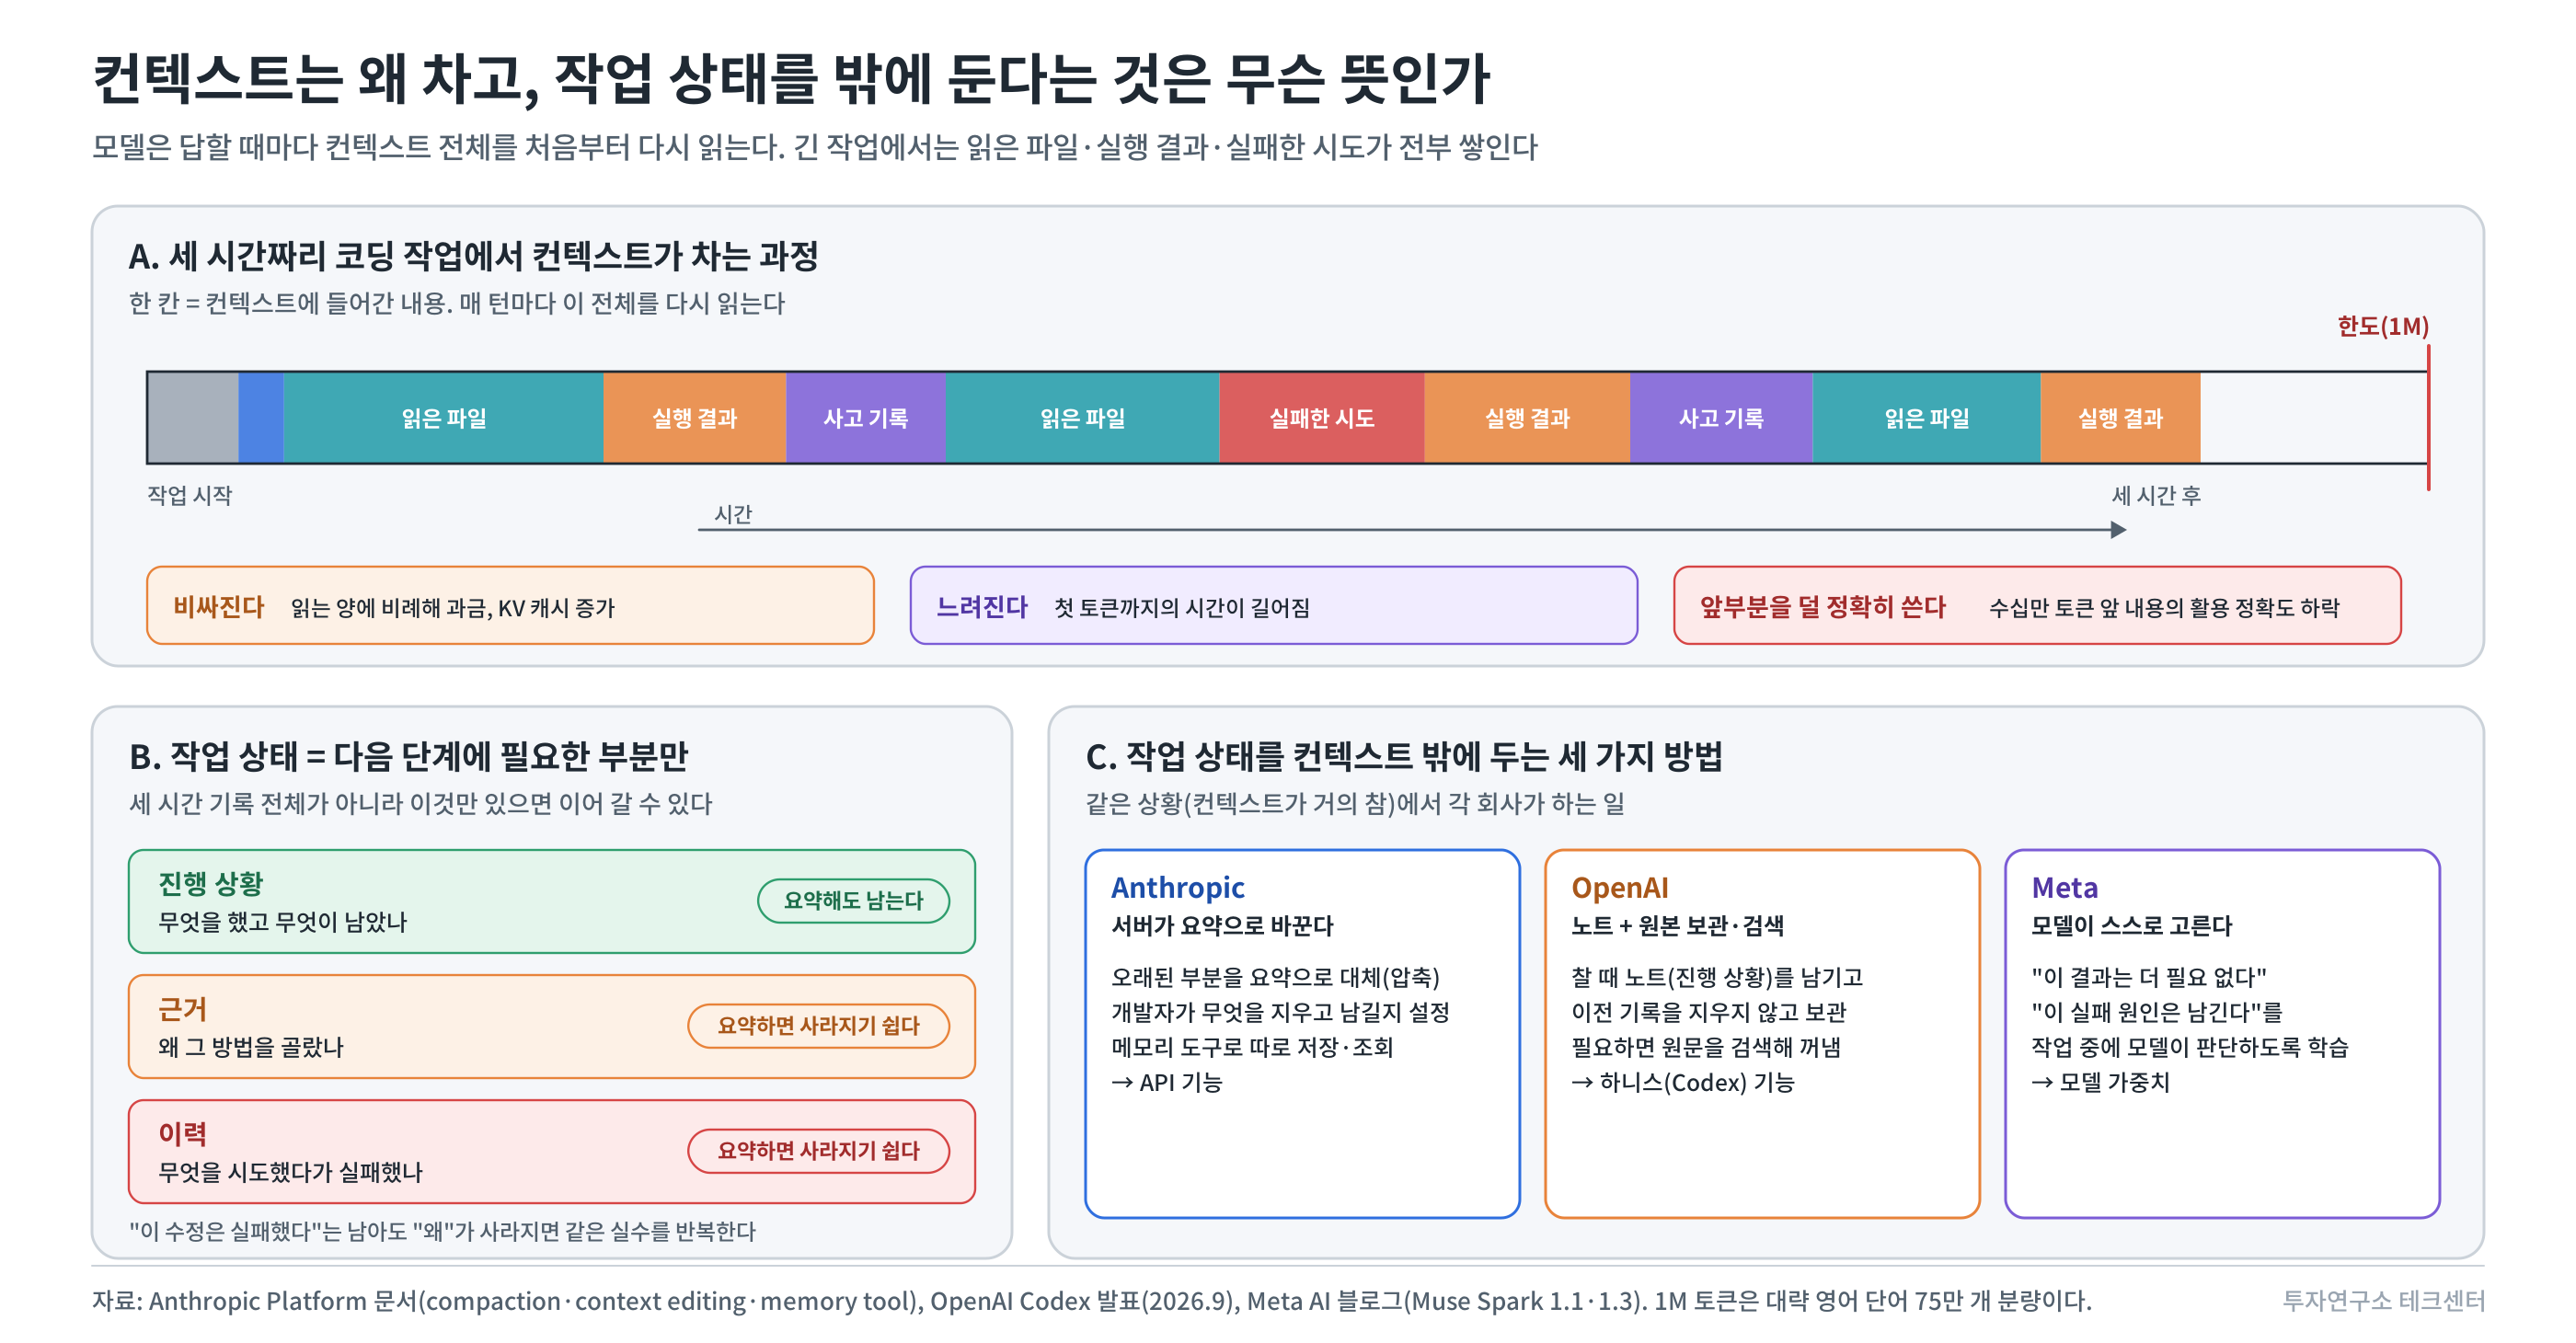
그림 2-12. 컨텍스트가 차는 과정과 작업 상태를 밖에 두는 세 가지 방법 4-2. 세 회사의 상태 관리 방식 - 같은 상황에서 무엇이 다른가
같은 상황을 놓고 보면 차이가 분명하다. 코딩 에이전트가 세 시간째 버그를 잡고 있고, 컨텍스트가 거의 찼다고 하자.
Anthropic - 서버가 오래된 부분을 요약으로 바꾸고, 개발자가 무엇을 남길지 정한다. Opus 4.6(2026.2)에서 도입된 서버측 컨텍스트 압축(compaction)은 대화가 한도에 가까워지면 오래된 컨텍스트를 요약으로 대체한다. 위 상황이라면 세 시간 전의 파일 내용과 실행 결과가 요약 몇 문단으로 바뀌고, 작업은 이어진다. 여기에 개발자가 쓸 수 있는 도구가 붙는다. 컨텍스트 편집(오래된 도구 결과만 골라 삭제), 메모리 도구(모델이 중요한 내용을 파일처럼 따로 저장했다가 꺼내 읽기), 사고 블록 보존·삭제 제어, 태스크 예산이다. 사고 설정이나 추론 강도 단계를 바꾸면 캐시가 처음부터 다시 쌓인다는 규칙까지 문서화돼 있다. 압축·캐시·사고 블록이 하나의 비용 체계로 묶여 있다는 뜻이다. [문서] 캐시 리드를 75% 내린 결정은 이 체계 위에서 나왔다.
OpenAI - 요약하지 않고, 노트를 남긴 뒤 이전 기록을 통째로 보관해서 검색한다. Astra와 함께 Codex에 실험적으로 들어간 기능이다. 기존 압축은 긴 디버깅 세션을 요약 하나로 뭉개면서 "왜 그 수정이 실패했는지", "그 구성 요소가 어떻게 동작하는지"를 잃었다. 새 방식은 윈도가 찰 때 모델이 노트(지금까지의 진행 상황과 결론)를 남기고, 이전 윈도 전체를 지우지 않고 검색할 수 있게 보관한다. 위 상황이라면 세 시간 전에 실패한 시도의 원문을 나중에 "그때 그 테스트 결과가 뭐였지"라고 찾아볼 수 있다. 기본값은 꺼짐이고 새 작업에만 적용되며, 초기 사용자 일부는 토큰 소모가 급증했다고 보고했다. [공식/보도] 요약 압축을 하면 결론은 남지만 근거가 사라지는데, 이 문제를 원본을 별도 저장소에 보관하는 방식으로 푸는 것이다. 컨텍스트 관리가 저장 구조의 문제가 되기 시작했다는 뜻이다.
Meta - 무엇을 남기고 버릴지를 모델이 스스로 판단하도록 학습했다. Muse Spark 1.1은 "1M 컨텍스트를 능동적으로 관리한다. 행동을 기억하고, 훨씬 이전 작업에서 정보를 꺼내 오고, 이후 작업에 필요한 핵심 단계를 남기는 방식으로 압축한다"고 썼다. 1.3은 "여러 워크플로를 한 스레드에서 오래 지속"하는 것을 핵심 개선으로 들었다. 위 상황이라면 서버 기능이나 개발자 설정이 아니라 모델이 작업 도중에 알아서 "이 실행 결과는 더 필요 없다, 이 실패 원인은 남긴다"고 정리하는 쪽이다. 즉 API 기능이 아니라 학습 목표로 접근했다. [공식]
4-3. 같은 점과 다른 점
같은 점: 셋 다 "요약 압축"에서 출발해 "선택적 보존 + 검색"으로 가고 있다. Anthropic의 메모리 도구, OpenAI의 노트+검색, Meta의 학습된 선택적 압축은 표현이 다를 뿐 같은 문제(결론은 남고 근거는 사라지는 것)를 푼다.
다른 점: 어디에 두느냐다. Anthropic은 API 기능(개발자가 제어), OpenAI는 하니스(Codex 안에서), Meta는 모델 가중치(학습된 행동)에 둔다. 이 차이는 5부에서 "상태를 저장하는 인프라(캐시·스토리지·검색)의 비용을 누가 지느냐"는 질문으로 이어진다.
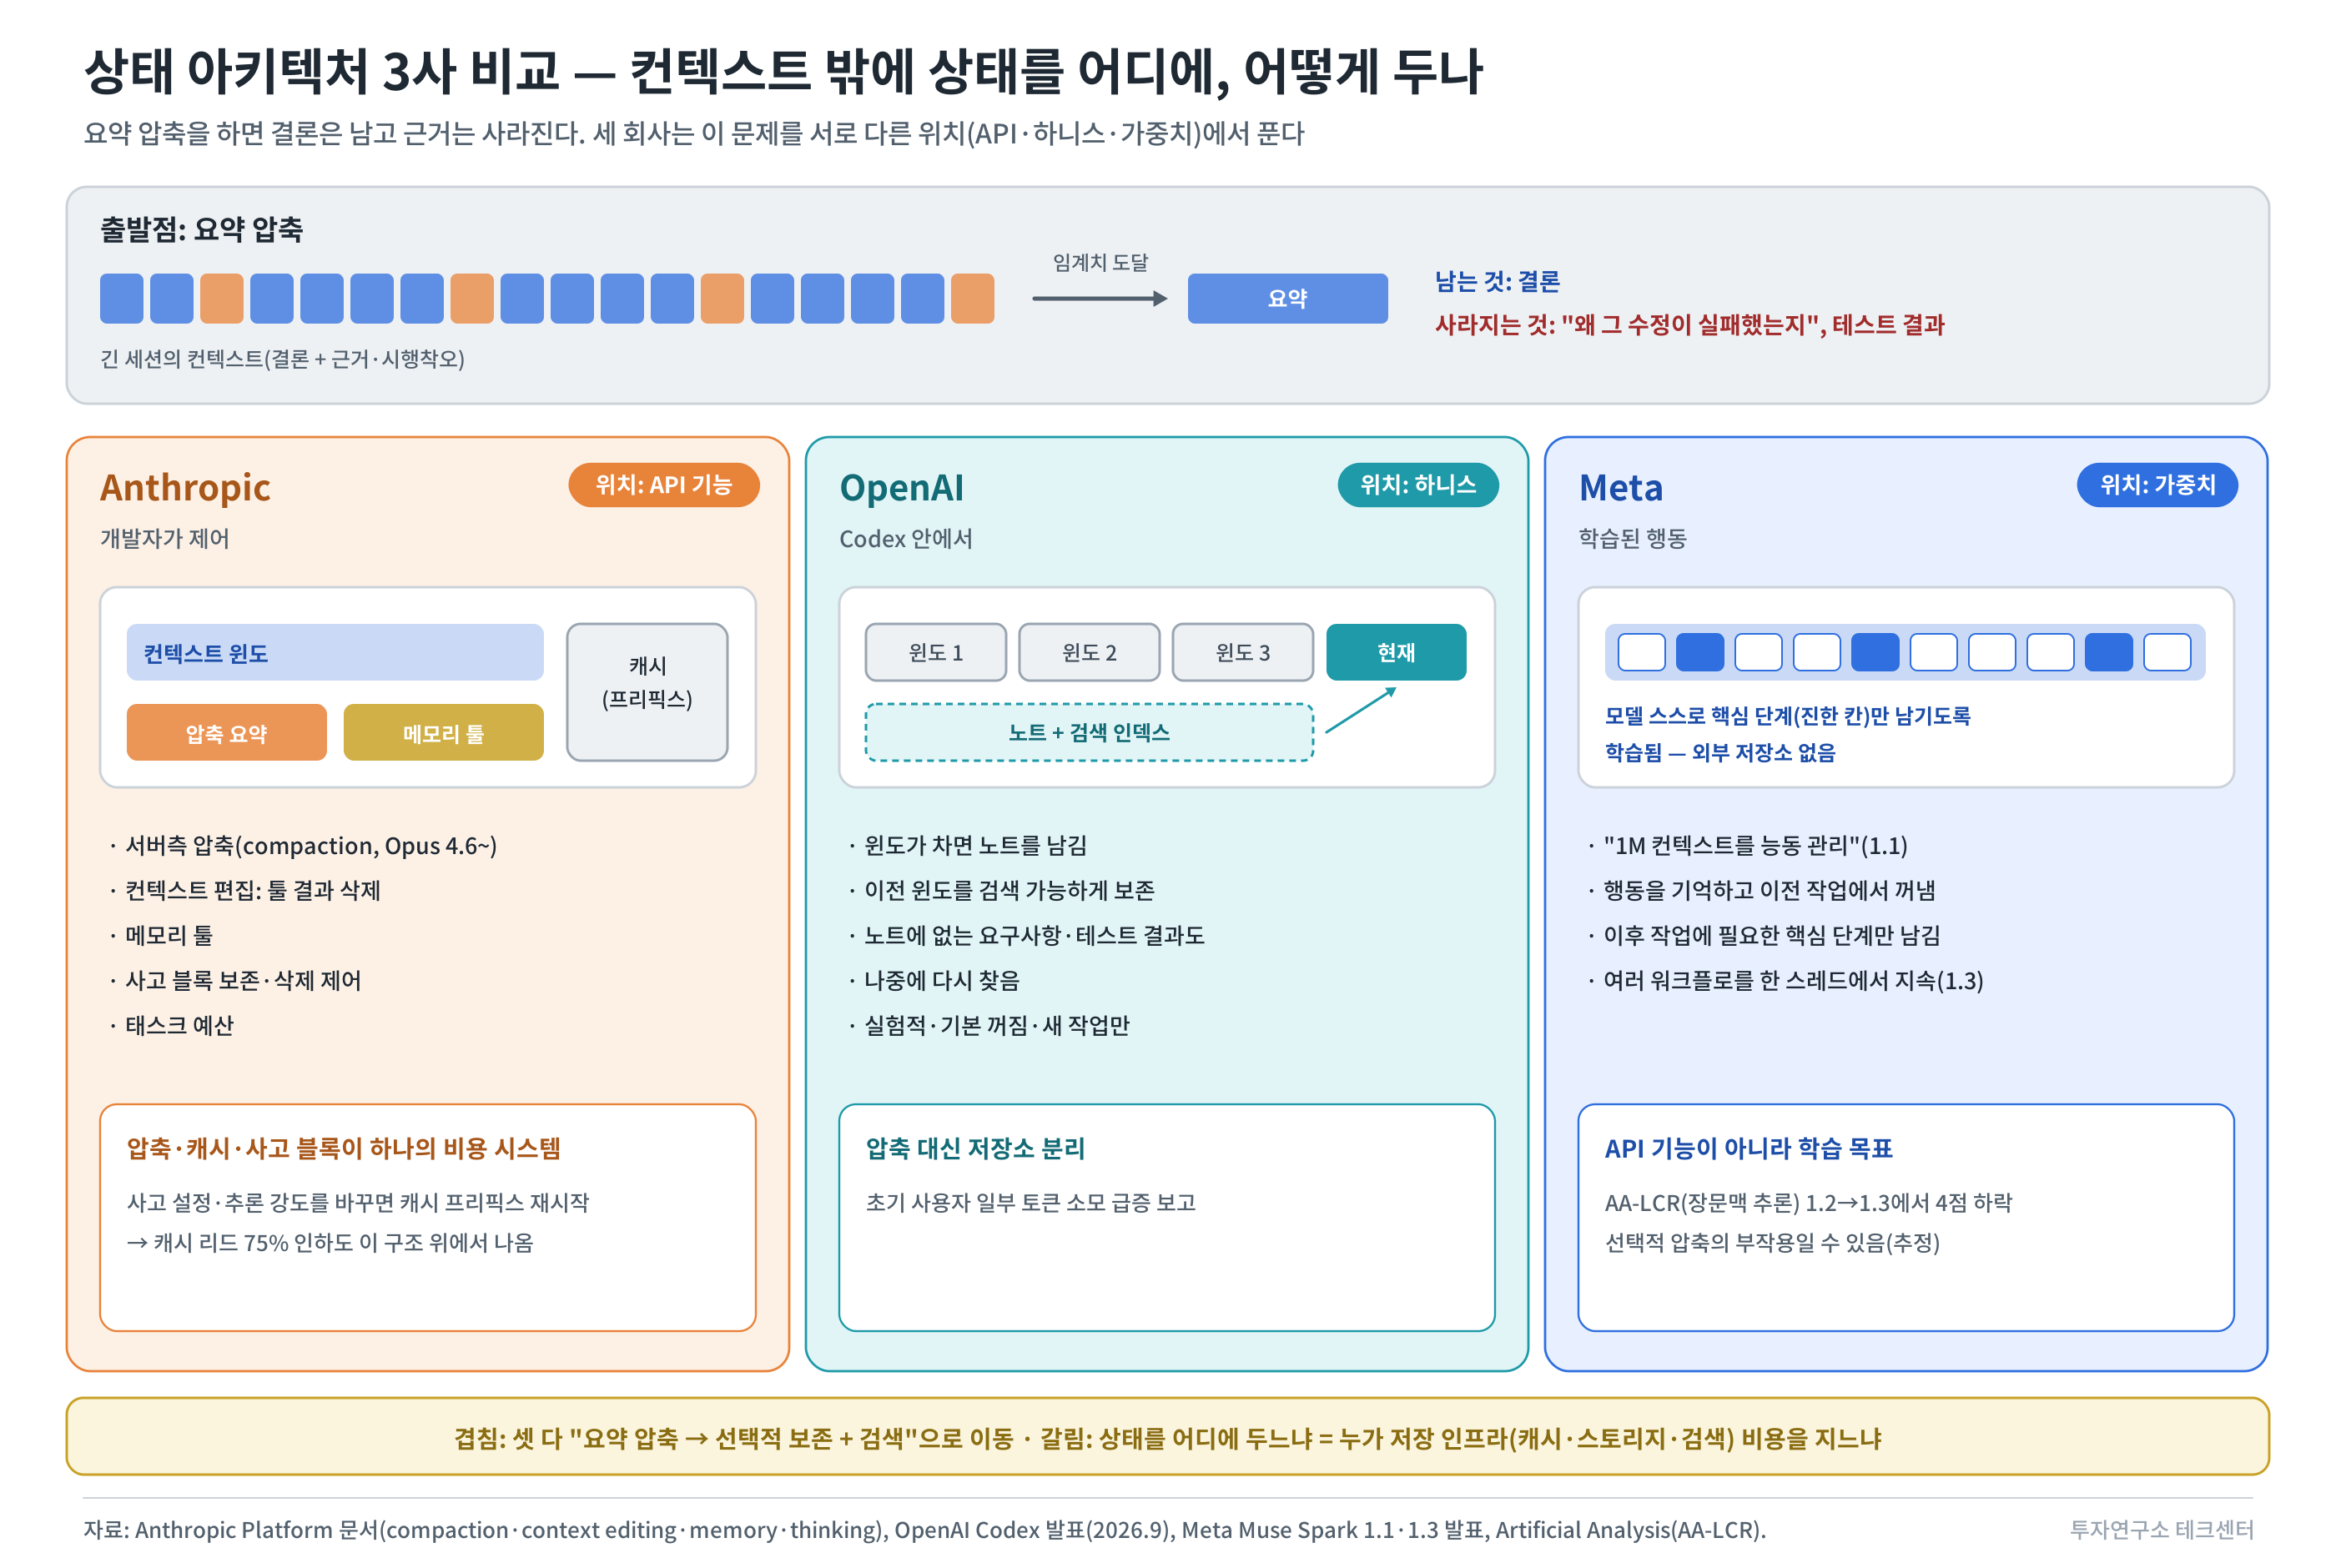
그림 2-13. 상태 아키텍처 3사 비교 5. 멀티에이전트와 하니스 - 학습 목표가 '응답'에서 '행동'으로
5-1. 무엇이 바뀌었나
2024년까지 모델 학습의 단위는 "프롬프트 → 응답"이었다. 2026년 세 플래그십의 학습 단위는 "하니스 안에서의 여러 단계 행동"이다. 세 회사의 공식 자료에서 가장 명시적으로 겹치는 부분이다.
Meta가 가장 구체적으로 서술한다. Muse Spark 1.1은 "엔드투엔드 지연을 줄이도록 멀티에이전트 시스템을 조율하게 학습됐다. 메인 에이전트로서 컨텍스트를 모으고 계획하고 병렬 서브에이전트에 실행을 맡긴다. 서브에이전트로서 자기 역할을 지키고, 쓸 수 있는 도구를 이해하고, 언제 메인에게 올릴지 안다"고 썼다. 1.3은 "다양한 하니스에서 학습해 서로 다른 에이전트 환경에 일반화"하고, 컴퓨터 사용에서 "자동화가 빠르면 스크립트를 쓰고 직접 조작이 단순하면 클릭하며, 매 단계 행동을 묶어서 생성"하도록 학습했다. [공식] 즉 조율자와 작업자 양쪽 역할을 같은 가중치에 학습시켰다.
OpenAI는 하니스와 학습 환경으로 말한다. Astra는 Codex에서 "독립 작업을 계속하면서 비동기로 질문"할 수 있다. 모델 효율과 하니스 개편을 합쳐 Mind2Web 작업 완료 속도가 Sol 대비 1.9배가 됐고, 하니스 개편만으로도 Sol의 속도가 60% 빨라졌다. 성능의 일부가 모델이 아니라 하니스에서 나왔다는 뜻이다. [공식] 컴퓨터 사용 학습은 macOS를 환경으로 삼은 RLVR 반복(과제 제시 → 스크린샷 → 마우스·키보드 행동 예측 → 실행 → 새 스크린샷 → 성공/실패 보상)이고, 수만 대의 Mac을 사들였다는 보도가 이 환경 인프라를 뒷받침한다. [해설/보도] NVIDIA CEO는 Astra가 약 10만 대의 Grace Blackwell에서 학습됐다고 언급했다 [보도]
Anthropic은 제품과 한계로 말한다. Claude Code의 에이전트 팀, API의 오케스트레이션 모드 구축 가이드, 그리고 Fable 5.1 파트너 증언이 있다. Ramp는 38시간 무인 실행(이전 결과가 라벨 오류에서 나온 것임을 진단·수정하고 실험 6개를 병렬로 돌린 뒤 결과 반환)을, MongoDB는 "밤새 다음 단계가 끝나 있다"는 경험을 전했다. [공식] 동시에 시스템 카드 요약에 "자동화된 행동 감사가 초장문맥 작업과 멀티에이전트 설정에서는 가시성이 낮다"고 명시했다. [공식] 가장 강한 조율 능력을 팔면서, 그 설정이 정렬 평가의 사각지대라고 인정한 것이다.
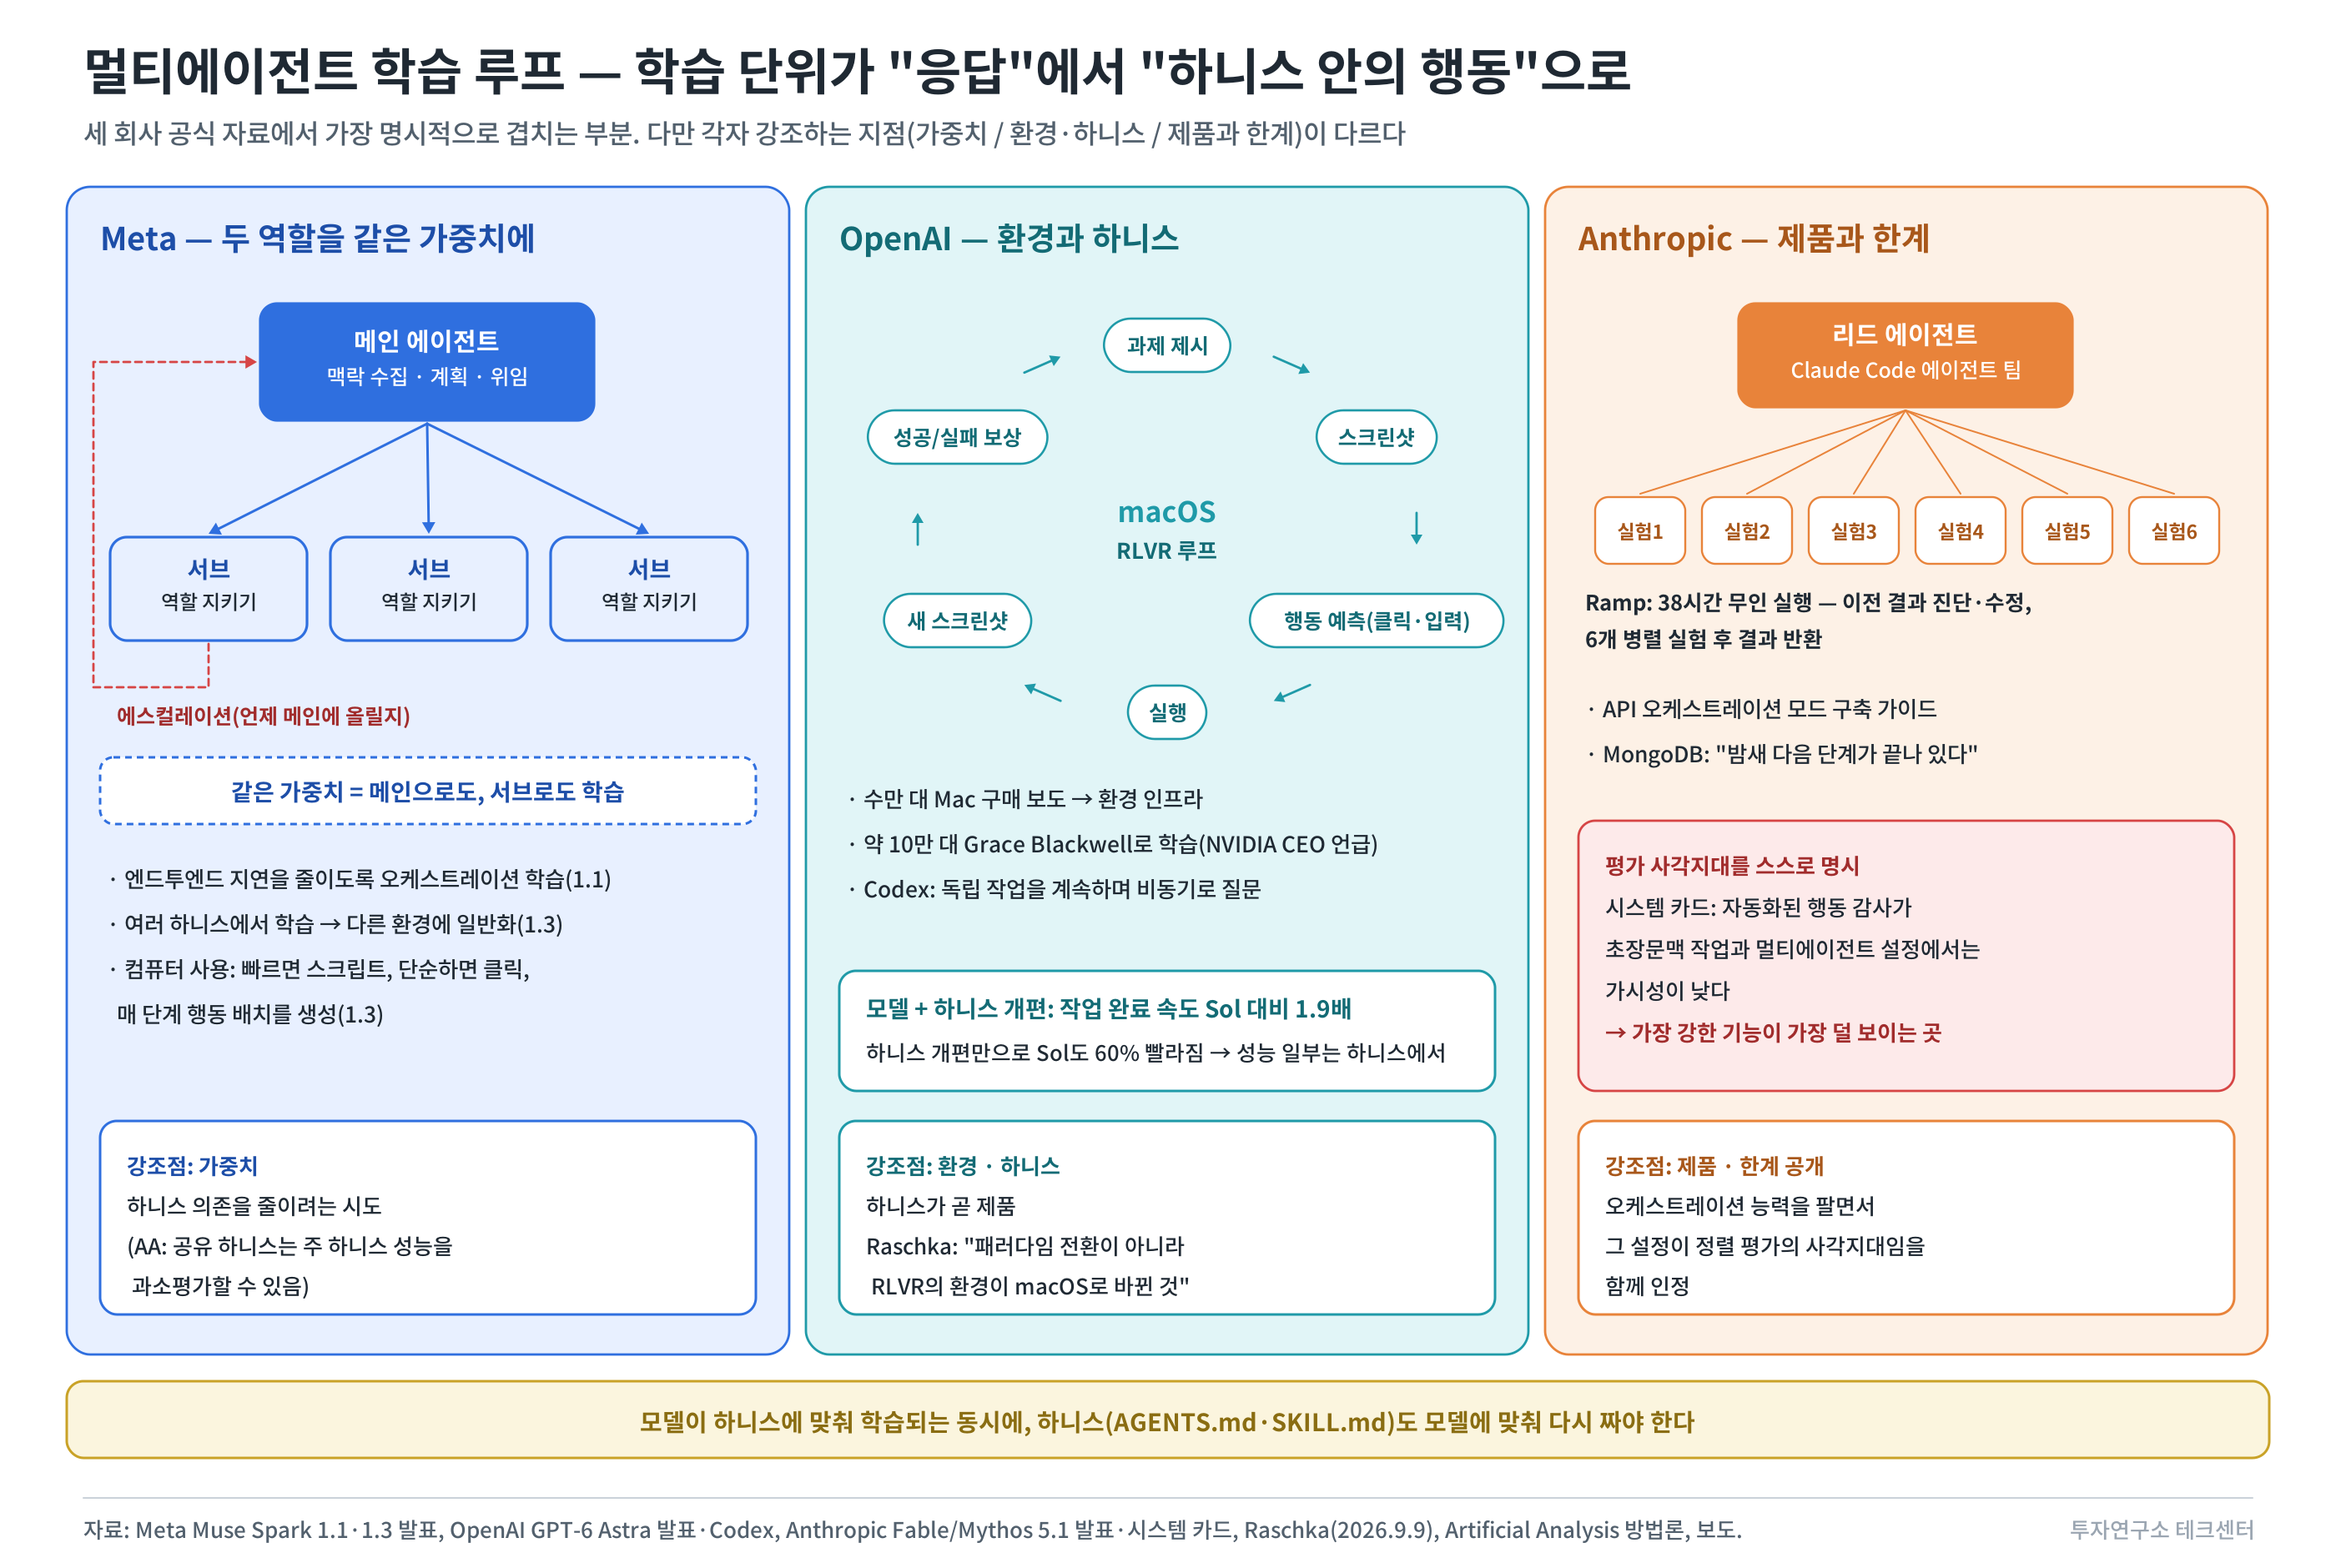
그림 2-14. 멀티에이전트 학습 루프 5-2. 하니스 의존성이라는 새 변수
하니스는 모델을 둘러싸고 실제 작업을 가능하게 하는 프로그램이다. 모델에게 어떤 도구(파일 읽기, 터미널, 브라우저)를 줄지, 도구 결과를 어떻게 돌려줄지, 컨텍스트가 차면 어떻게 할지, 실패하면 몇 번 다시 시도할지, 어떤 행동은 사용자 허락을 받을지를 하니스가 정한다. Codex, Claude Code가 하니스이고, 같은 모델이라도 하니스가 다르면 성능이 다르다.
AA가 평가 방법론에서 짚은 문제가 있다. 모델은 보통 하나의 주 하니스를 염두에 두고 개발되고, 그 하니스는 모델의 강점을 키우도록 설계된다. 공유 하니스(Stirrup, Terminus 2 등)로 잰 독립 지수는 같은 조건의 비교이지만, 각 모델의 주 하니스 성능을 과소평가할 수 있다. [독립] Meta가 "여러 하니스에서 학습"을 강조한 건 이 의존성을 줄이려는 시도이고, OpenAI가 하니스 개편 효과를 Sol에까지 적용한 건 하니스가 곧 제품이라는 뜻이다.
Raschka는 실무적 관찰을 하나 덧붙였다. 새 모델들은 프롬프트 이해가 좋아져서, 기존 AGENTS.md·SKILL.md에 적어 둔 과잉 지시가 오히려 제약이 될 수 있다고 지적했다. 모델이 하니스에 맞춰 학습되는 동시에, 하니스도 모델에 맞춰 다시 짜야 하는 단계다.
5-3. 하니스 생태계 - 모델과 하니스를 같이 개발해야 하나
하니스가 성능의 일부라면, 하니스는 모델 개발사가 모델과 함께 만들어야 하는 것인가, 아니면 외부에서 따로 만들 수 있는 것인가. 2025년 말부터 이 질문에 답이 나오기 시작했다. 방향은 "학습은 함께, 배포는 표준으로 분리"다.
하니스를 이루는 세 층과 각 층의 표준
하니스가 모델에 제공하는 것은 세 층으로 나뉘고, 2025년 12월에 세 층 모두 회사 중립 표준이 생겼다.
층 역할 표준 출처·현황 도구 연결 모델이 외부 시스템(파일, DB, 웹, 업무 앱)을 같은 방식으로 호출하게 한다 MCP(Model Context Protocol) Anthropic이 2024년 11월 공개. 2025년 12월 Linux Foundation 산하 AAIF로 이관. 공개 서버 1만 개 이상 [공식] 저장소 지시 코드 저장소마다 "이 프로젝트에서는 이렇게 작업하라"를 적어 두는 파일 AGENTS.md OpenAI가 만들어 AAIF에 기부 [공식] 절차 패키지 특정 작업(문서 작성, 배포, 검토)의 절차·스크립트·참고 자료를 폴더 하나로 묶어 모델이 필요할 때 읽게 한다 Agent Skills Anthropic이 2025년 12월 18~19일 개방 표준으로 공개(agentskills.io). OpenCode, Cursor, Amp, Letta, goose, GitHub, VS Code, OpenAI가 채택 [공식] AAIF(Agentic AI Foundation)는 2025년 12월 9일 Linux Foundation 산하에 만들어졌고, 설립 시점에 MCP(Anthropic), goose(Block의 오픈소스 에이전트), AGENTS.md(OpenAI)를 받았다. [공식] 경쟁사인 Anthropic과 OpenAI가 각자의 하니스 규격을 같은 재단에 넘긴 것이다. 의미는 분명하다. 도구 연결, 저장소 지시, 절차 패키지가 특정 모델에 묶이지 않게 됐다. 기업이 MCP 서버와 AGENTS.md와 Skills를 한 번 만들어 두면, 그 위에서 모델만 바꿔 끼울 수 있다.
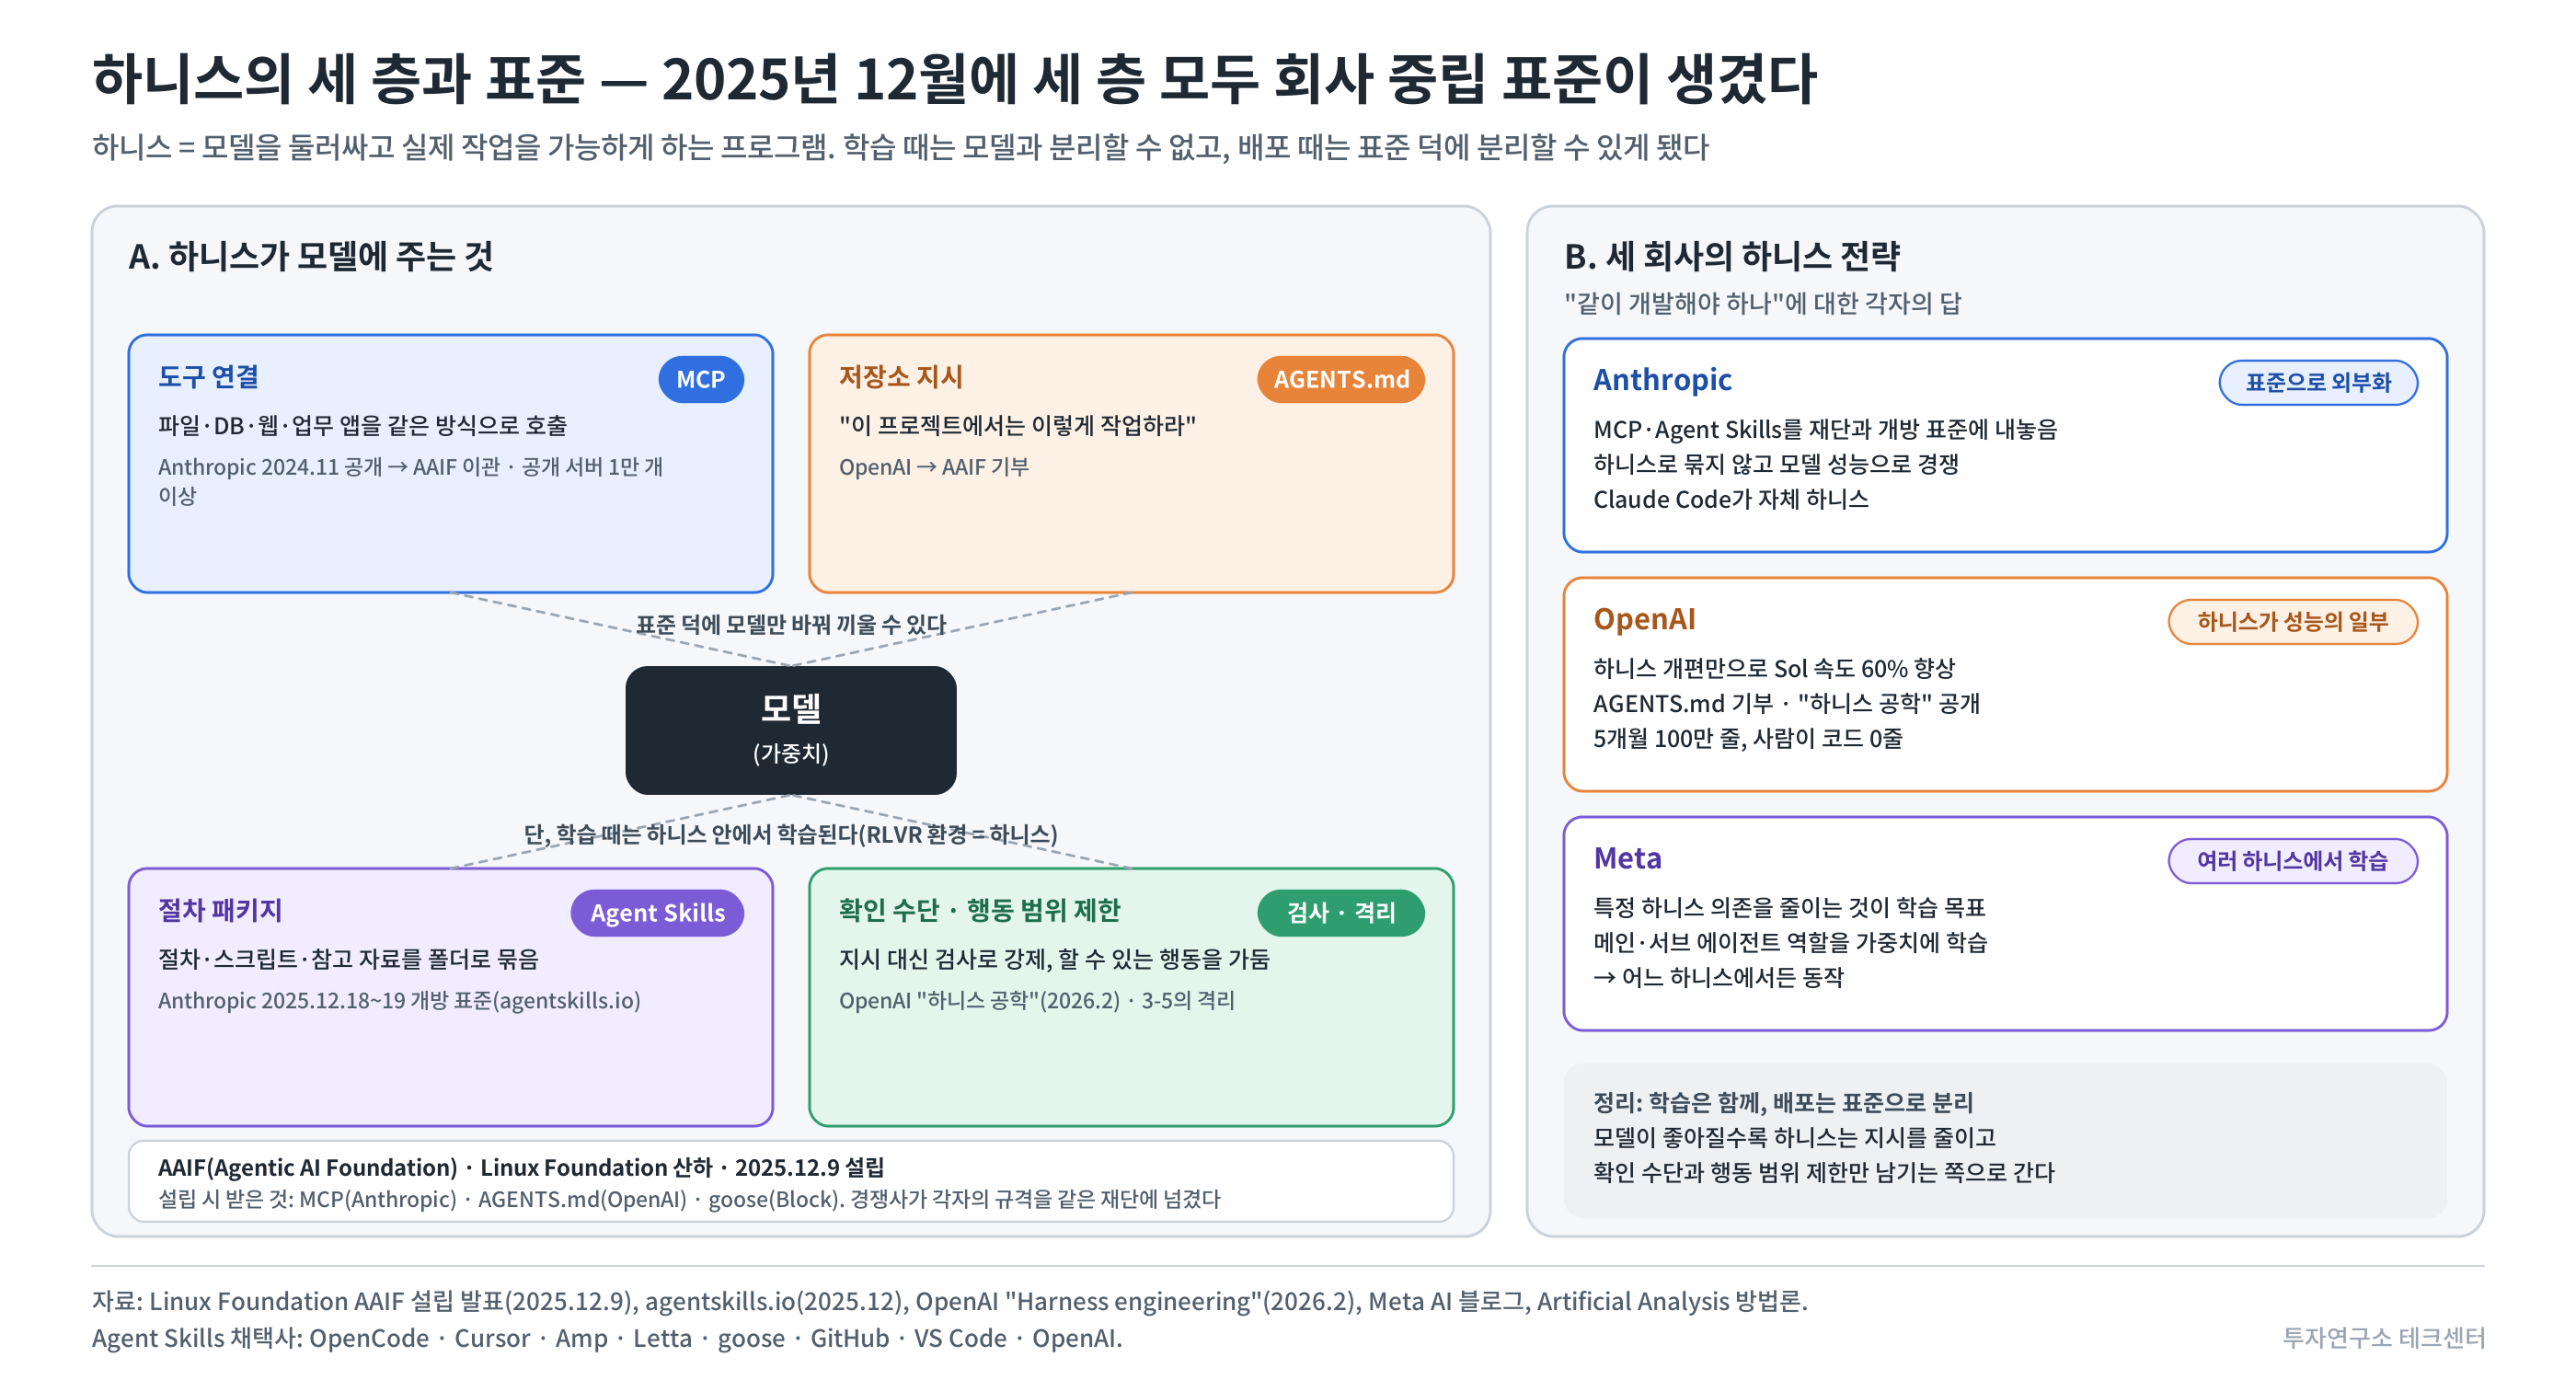
그림 2-15. 하니스의 세 층과 표준, 그리고 모델·하니스의 관계 하니스 설계가 곧 생산성 - OpenAI의 "하니스 공학"
표준이 연결 방식을 정한다면, 그 위에서 무엇을 어떻게 적어 두느냐가 성능을 가른다. OpenAI는 2026년 2월 "Harness engineering"이라는 글에서 내부 사례를 공개했다. 5개월 동안 약 100만 줄의 코드를 사람이 한 줄도 직접 쓰지 않고 Codex로 만들었는데, 성과를 낸 것은 모델 자체보다 다음 설계였다고 썼다. [공식]
- 문서를 유일한 기준으로 삼는다. 설계 결정, 규칙, 진행 상황을 저장소 안의 문서에 적어 두고, 모델이 매번 그 문서를 읽고 시작하게 한다. 사람의 머릿속이나 채팅에만 있는 정보는 모델이 못 쓴다.
- 규칙은 말로 하지 않고 도구로 강제한다. "이렇게 하지 마라"를 지시문에 적는 대신 린터와 CI(자동 검사)가 잡아내게 한다. 모델이 지시를 잊어도 검사가 막는다.
- 피드백 루프를 짧게 만든다. 모델이 결과를 바로 확인할 수 있게(테스트 실행, 화면 확인) 해서, 틀린 방향으로 오래 가지 않게 한다.
Raschka가 지적한 "과잉 지시가 오히려 제약"이라는 관찰과 같은 결론이다. 좋은 하니스는 모델에게 많이 지시하는 것이 아니라 모델이 스스로 확인할 수 있는 환경을 주는 것이다.
그래서 같이 개발해야 하나
세 회사의 답은 조금씩 다르지만, 합치면 이렇게 정리된다.
- 학습 단계에서는 분리할 수 없다. 1-1에서 본 RLVR은 "하니스 안에서 과제를 풀고 채점받는" 과정이다. 학습에 쓰는 환경이 곧 하니스이므로, 모델은 어떤 하니스 안에서 학습됐는지에 따라 성격이 정해진다. OpenAI가 하니스 개편으로 Sol의 속도를 60% 올린 것, Meta가 "여러 하니스에서 학습"해 특정 하니스 의존을 줄이려 한 것 모두 이 사실을 전제한다.
- 배포 단계에서는 표준 덕에 분리할 수 있게 됐다. MCP·AGENTS.md·Skills가 회사 중립 표준이 되면서, 기업은 하니스를 한 번 만들고 모델을 바꿔 끼울 수 있다. Anthropic이 자기 규격을 재단에 넘긴 것은 하니스로 고객을 묶는 대신 모델 성능으로 경쟁하겠다는 선택이다.
- 모델이 좋아질수록 하니스는 얇아진다. Raschka의 관찰과 OpenAI의 하니스 공학이 같은 방향을 가리킨다. 과거에는 모델의 약점을 하니스가 보완했지만(복잡한 지시문, 단계별 강제), 지금은 하니스가 확인 수단(테스트, 린터, 문서)과 행동 범위 제한(권한, 격리)만 제공하고 판단은 모델에 맡기는 쪽으로 간다. 3-5에서 본 격리 수요가 여기서도 나온다.
투자 관점에서 생각을 해보면, 하니스가 표준화되어 모델을 바꿔 끼우기 쉬워지면 모델 가격 경쟁은 심해지고, 반대로 사용자가 실제로 작업하는 자리(IDE, 운영체제, 브라우저, 업무 앱)를 가진 쪽의 협상력은 커진다. (이 논리에서 서비스나우 등 하니스에 붙일 SW 관련 기업들을 좋게 보는 사람들도 있다.) 하니스 표준은 모델 회사의 잠금 장치를 없애는 쪽으로 작용하고, 그 결과는 1부에서 본 "같은 점수를 더 싸게"라는 경쟁을 더 밀어붙인다.
6. 정리 - 여섯 축에서 본 세 회사
축 Anthropic Fable 5.1 OpenAI GPT-6 Astra Meta Muse Spark 1.3 근거 추론 학습 RLVR + 적응형 사고(유일 모드), 추론 강도 5단계 RLVR + 추론 강도 5단계 + Fast, 컴퓨터 사용 강화학습 환경 RLVR + xhigh/max, 여러 하니스에서 학습 공식/문서 구조 효율 비공개 recurrent depth 보도(종류·횟수 미확인), "깊이는 GPT-4의 2배 이내" 비공개, "작게 시작해 검증 후 확대" 보도/공식 사고 기록 가시성 원문 미반환·요약만, 안티-증류, NLA로 활성화 판독(사후 학습) 원문 미반환, 모니터링 후퇴 명시, 행동 모니터 강화 공개된 것 없음(연구 조직은 Coconut 등 잠재 추론 선행) 문서/공식/논문 상태 관리 서버측 압축·편집·메모리 도구·사고 블록 제어(API 기능) 노트 + 검색 가능한 이전 윈도(하니스, 실험 기능) 학습된 능동 컨텍스트 관리(가중치) 문서/공식 멀티에이전트 에이전트 팀·오케스트레이션 모드, 멀티에이전트 평가 사각지대 인정 비동기 질문, 하니스 개편 효과를 이전 모델에도 적용 메인/서브 양쪽 역할 학습, 병렬 위임·상위 보고 공식 하니스 전략 MCP·Skills를 개방 표준으로 외부화, Claude Code Codex + AGENTS.md 기부, 하니스 공학 공개 여러 하니스에서 학습해 의존성 축소 공식 첫 행과 다섯째 행을 보면, 세 회사가 같은 학습 방식 위에서 같은 방향(에이전트)으로 간다. 세 회사 모두 강화학습으로 추론 능력을 학습시켰다고 밝혔지만, 보상 설계의 세부는 공개하지 않았다. 셋째·넷째 행에서 갈린다. 사고 기록과 작업 상태를 어디에 두고 누가 볼 수 있게 하느냐다. 여기가 각 사의 철학이자 원가 구조이자 규제 노출 지점이다. 여섯째 행은 새로 생긴 축이다. 하니스를 표준으로 열어 두는 쪽과 제품으로 묶는 쪽이 갈리기 시작했다.
7. 3부에서 다룰 내용
2부는 세 플래그십이 기술적으로 어디서 겹치는지를 봤다. 3부에서는 시야를 세 회사 밖으로 넓혀, 프런티어 연구소 전체가 LLM 성능을 끌어올리는 다섯 단계(구조·사전학습·후처리·추론 시간·시스템)와 회사별 핵심 알고리즘을 논문 기준으로 정리한다. 2부에서 짧게 다룬 GRPO, MoE, 병렬 추론이 3부에서 자세히 나온다. 4부에서는 2026년에 새로 나온 알고리즘을 수식과 수치 수준까지 살펴본다. (모델의 구현에는 관심이 없는 사람들은 3~4부는 결론 부분만 읽어도 좋을 것 같다.)
8. 투자 시사점 - 2부의 기술이 하드웨어·소프트웨어 수요에 주는 영향
(1) 루프는 HBM 용량 부담만 일부 덜고, 대역폭 논리와 서비스 GPU 수는 그대로 둔다. 파라미터는 절반이 되지만 연산량, KV 캐시, 토큰마다 읽어야 하는 가중치 양은 같다(2-3). 장문맥·에이전트 서비스에서 HBM의 주된 사용처는 가중치가 아니라 KV 캐시이고, 루프는 이를 줄이지 못한다. 루프가 퍼져도 HBM 대역폭을 올리는 수요와 트래픽을 처리하는 GPU 수요는 줄지 않는다. 줄어드는 것은 학습 메모리와 모델을 올리는 최소 장수다.
(2) KV 캐시를 저장하고 다시 읽는 일이 추론 원가의 독립 항목이 됐다. 세 회사 모두 작업 상태를 컨텍스트 밖(캐시·노트·검색 가능한 이전 기록)에 둔다(4장). Anthropic의 캐시 리드 75% 인하는 이 저장·조회 비용을 낮출 인프라를 갖췄거나 갖출 것이라는 신호로 읽힌다(필자 판단). HBM 밖의 DRAM·SSD 메모리 수요와 연결되는 지점이고, 5부에서 자세히 다룬다.
(3) 컴퓨터 사용을 가르치려면 GPU 말고도 모델이 직접 조작할 컴퓨터가 필요하다. 수학 문제 학습은 문제·답·채점이 전부 텍스트라 GPU 안에서 끝나지만, "이 앱을 열어 설정을 바꿔라" 같은 과제는 모델이 클릭할 실제 화면이 있어야 하고 클릭한 결과를 캡처해 채점해야 한다. 같은 과제를 수십 번씩 동시에 풀게 하므로 이런 컴퓨터(가상 PC·브라우저)가 수만 대 동시에 돌아야 하고, OpenAI가 수만 대의 Mac을 샀다는 보도(5-1)가 그 규모다. 학습 중인 모델은 실수도 하고 채점기를 속이는 법도 배우므로 이 컴퓨터들은 외부와 끊긴 채 과제마다 새로 띄우고 버려야 하는데, 1부 5장의 연구 환경 보안 사고가 바로 이 격리가 느슨할 때 생기는 일이다. 그래서 학습 인프라 지출에 GPU·HBM 외에 범용 컴퓨터, 가상화·격리, 네트워크 통제, 모니터링이라는 새 항목이 생겼다. 금액은 GPU보다 훨씬 작지만, 3-5에서 본 실행 격리 수요가 모델 개발사의 학습 환경에서도 나온다는 뜻이다.
(4) AI 보안은 "모델을 읽는 쪽"이 아니라 "행동을 가두는 쪽"에서 수요가 있다. 단, 행동을 가두는 기업들이 많이 생기고 있으며, 초기 활발한 M&A 이후에는 스타트업이 활동할 영역이 조금은 줄어들 것으로 예상된다. 입출력 가드레일은 1년 사이 대형 보안사로 흡수됐고, 해석가능성은 모델 접근권 때문에 개발사 내부 역량으로 남을 가능성이 크다(3-5). 사고 기록이 짧아질수록 외부에서 할 수 있는 확실한 일은 실행 격리이고, 이 수요는 개발사의 학습 환경과 기업의 에이전트 운영 환경 양쪽에서 생긴다. 단, 정책의 방향성에 따라서, 내재화 가능성이 있다.
(5) 하니스 표준화는 모델 가격 경쟁을 밀어붙인다. MCP·AGENTS.md·Skills가 회사 중립 표준이 되면서 모델을 바꿔 끼우는 비용이 내려간다(5-3). 모델 회사의 잠금 장치는 약해지고, 사용자가 실제로 작업하는 자리(IDE·운영체제·브라우저·업무 앱)를 가진 쪽의 협상력이 커진다.
(6) 사고 기록이 짧아지면 과금 기준이 토큰에서 태스크로 옮겨 간다. 같은 답을 더 적은 토큰으로 내면 토큰당 매출은 줄어든다. 브록먼이 "토큰 가격은 말이 안 된다, 완료된 태스크당 가격으로 봐야 한다"고 한 것도 이 변화를 반영한다. 추론 강도 옵션은 추론 하드웨어 시장을 저지연 전용 칩(Cerebras WSE-3 위의 Codex-Spark)과 처리량 중심 GPU로 나눈다. 인프라 투자의 판단 기준도 "토큰 처리량"에서 "태스크당 원가"로 옮겨 갈 수 있다.
이 여섯 가지는 5부에서 3·4부의 내용과 합쳐 투자 방향으로 정리한다.
이 글은 스터디를 하면서 쓴 글이고, 투자 권유가 아닙니다. 투자의 책임은 투자자 본인에게 있습니다.
자료: OpenAI GPT-6 Astra 발표문 및 시스템 카드(deploymentsafety.openai.com), OpenAI "Harness engineering"(2026.2), Anthropic Fable/Mythos 5.1 발표문, Anthropic Platform 문서(adaptive thinking·effort·context windows·compaction·thinking), Anthropic "Natural Language Autoencoders"(2026.5), Anthropic Agent Skills 공개 표준(agentskills.io, 2025.12), Agentic AI Foundation 설립 발표(Linux Foundation, 2025.12), Meta AI 블로그(Muse Spark 1.1·1.3), Artificial Analysis(2026.9.2·9.9), UK AISI 평가(Astra 시스템 카드 인용), Sebastian Raschka "GPT-6 Astra, Looped Transformers, and Hidden Reasoning"(2026.9.9), The Information(2026.9.2), Check Point·Palo Alto Networks·SentinelOne·Cisco 인수 발표 및 보도, Goodfire·E2B 투자 발표. 논문: Dehghani et al. 2018(Universal Transformers), Lan et al. 2019(ALBERT), Wei et al. 2022(CoT), Kwon et al. 2023(vLLM), Liu et al. 2024(MobileLLM), Bae et al. 2024(Relaxed Recursive Transformers), Snell et al. 2024(Test-time compute), Hao et al. 2024(Coconut), DeepSeek-R1 2025, Geiping et al. 2025(Recurrent Depth), Mixture-of-Recursions 2025, Zhu et al. 2025(Beyond Parameters), Ouro 2025, Fan·Svete·Lee 2026(LOTUS), Nanbeige4.2 2026, Full-bandwidth Transformer 2026.8, SMELT 2026.9.
반응형'최신 기술동향 > 인공지능 (AI)' 카테고리의 다른 글
[AI 모델 동향 4부] 2026년 최신 LLM 알고리즘 - DeepSeek·Kimi·Qwen이 트랜스포머에서 바꾼 것 (0) 2026.10.05 [AI 모델 동향 3부] LLM 성능을 올리는 연구/개발 동향 (1) 2026.10.04 [AI 모델 동향 1부] AI 모델 비교 - 기업별 AI 설계 철학 (0) 2026.10.03 데이터센터와 광통신 - 3부 AI DC 광연결과 기업 동향 (0) 2026.09.09 데이터센터와 광통신 - 2부 광통신의 원리와 산업 동향 (1) 2026.09.08