-
[AI 모델 동향 5부] Conclusion - 모델의 변화와 투자 방향최신 기술동향/인공지능 (AI) 2026. 10. 5. 19:00
1~4부를 하나로 모으면 결론은 한 문장이다. 모델은 6개월마다 더 똑똑해지고 더 싸지며, 핵심적인 변곡점마다 병목이 다른 곳으로 옮겨 간다. 2024년의 병목은 GPU 연산이었고, 2026년의 병목은 메모리 대역폭, GPU 사이 연결, 문맥(KV)을 저장하고 다시 꺼내는 계층이었고 점차 새 구조를 바로 돌리는 서빙 소프트웨어, 그리고 모델을 가르치는 채점 환경으로 병목이 옮겨가고 있다. 하드웨어 투자는 "어디가 다음 병목인가"로, 소프트웨어 투자는 "모델이 좋아질수록 더 필요해지는가, 덜 필요해지는가"로 판단하면 된다. VC는 지금의 병목(GPU·HBM)이 아니라 다음 병목에, 그리고 대형사가 사 줄 수밖에 없는 포인트를 찾아야 한다. 이 글은 1~4부에서 확인한 사실을 투자 관점에서 다시 배열하고, 하드웨어·소프트웨어·VC 순서로 전망을 정리한 뒤, 해외 동향과 국내에서 무엇에 투자해야 할지로 마무리한다.
시리즈 구성: 1부 AI 모델 기업별 설계 철학 → 2부 세 플래그십의 공통 기술 → 3부 LLM 성능을 올리는 연구/개발 동향 → 4부 2026년 최신 LLM 알고리즘 → 5부 시리즈 종합 및 투자 방향(이 글)
기준일: 2026년 10월 4일. 1~4부의 수치는 각 부의 출처를 따른다. 이 글에서 새로 넣은 해외·국내 동향은 본문에 출처를 적었다. 판단이 들어간 문장은 "(필자 판단)"으로 표시했다.0. Intro - 왜 "병목"으로 정리하나
AI 투자 논의는 보통 "GPU가 더 팔리나, 덜 팔리나"로 시작한다. 그런데 1~4부에서 본 기술 변화는 대부분 GPU 수요를 직접 늘리거나 줄이기보다, 같은 일을 하는 데 무엇이 가장 먼저 모자라는지를 바꿨다. 예를 들어 4부의 KV 압축은 GPU 메모리 사용량을 10분의 1로 줄였지만, 그 결과 GPU가 덜 팔린 것이 아니라 같은 GPU로 더 긴 문맥을 받게 됐고, 이번에는 그 문맥을 저장해 둘 SSD와 그 데이터를 옮길 네트워크가 모자라게 됐다.
이렇게 보면 투자 판단이 단순해진다. 기술이 바뀔 때마다 "이 변화로 무엇이 남아돌고, 무엇이 모자라게 되나"를 묻고, 모자라게 되는 쪽에 투자하면 된다. 이 글은 이 질문 하나로 1~4부를 다시 읽는다.
1. 시리즈 1~4부의 결론 정리
- 주요 모델들의 기본 구조와 가격이 같아졌다(1·3부). 디코더 트랜스포머 + MoE, 검증 가능한 보상 기반 강화학습(RLVR), 사고 모드, 도구 사용은 모든 프런티어 모델의 공통 기반이다. Claude Fable 5.1과 GPT-6 Astra의 API 리스트 가격은 100만 토큰당 입력 10달러/출력 50달러로 같고, Artificial Analysis 지능지수도 66점 동률이다.
- 경쟁은 토큰 효율과 캐시로 옮겨 갔다(1·2부). 같은 66점에서 Astra는 Fable 5.1보다 토큰을 훨씬 적게 쓰고(AA 측정 기준 태스크당 비용 약 40%), Anthropic은 캐시 읽기 가격을 75% 내린다고 강조한다. 지능은 파라미터·학습 컴퓨트·추론 컴퓨트의 세 항으로 결정되고, 세 번째 항을 사용자가 "추론 강도 단계"로 고른다.
- 루프는 파라미터만 줄인다(2부). 같은 블록을 두 번 통과시키는 루프드 트랜스포머는 파라미터 메모리를 절반으로 줄이지만 연산량·KV 캐시·메모리 대역폭은 그대로다. 서비스 중인 GPU 메모리의 주된 사용처는 장문맥에서 가중치가 아니라 KV 캐시다.
- 사고 기록은 짧아지고, 작업 상태는 컨텍스트 밖으로 나간다(2부). 세 회사 모두 요약 압축에서 "선택적 보존 + 검색"으로 가고 있다. KV 캐시의 저장과 조회가 추론 원가의 독립 항목이 됐다.
- 미국은 ③④⑤, 중국은 ①②(3부). 미국 연구소는 후처리·추론 시간·시스템 단계에 GPU 시간을 더 써서 성능을 올리고, 중국 연구소는 구조·사전학습 단계에서 같은 성능을 싸게 내는 기법을 논문과 오픈웨이트로 공개한다.
- 토큰당 KV 메모리가 급감했다(3·4부). DeepSeek-V4-Pro는 100만 토큰 문맥에서 V3.2 대비 KV 캐시 10%만 쓴다. V4.1-Flash는 KV를 층끼리 나눠 쓰고 FP4로 저장해 토큰당 890바이트까지 줄였고, KV를 SSD에 영구 저장하는 운영을 전제로 설계됐다.
- "외우는 파라미터"가 GPU 밖으로 나가기 시작했다(3·4부). 조건부 메모리(Engram)는 논문 8개월 만에 DeepSeek-V4.1-Flash(196B)와 Qwen3.8-Flash-Next(51B, 호스트 메모리)에 탑재됐다.
- 학습은 더 싸게, 그러나 프런티어 런은 더 크게(1·3·4부). Muon은 AdamW 대비 약 2배의 연산 효율을 보고했고, 공개된 학습 안정화 기법이 후발 주자의 실패 비용을 줄인다. 같은 시기 Astra는 10만 GPU 이상으로 학습했고, 후처리(RL) 예산은 사전학습의 10%를 넘었다.
- 에이전트가 첫 대규모 매출원이 됐다(1·3부). Claude Code는 2026년 2월 기준 연환산 매출 25억 달러를 넘겼고, Codex 주간 활성 사용자는 500만 명 이상(그중 20%는 비개발자)이다. OpenAI 연구 조직은 연구자 1인당 하루 600달러 이상을 추론에 쓴다.
- 하니스 규격이 표준이 됐고, 보안은 "행동을 가두는 쪽"으로 간다(2부). MCP·AGENTS.md·Agent Skills가 회사 중립 표준이 되면서 모델을 바꿔 끼우기 쉬워졌다. 가드레일 스타트업은 1년 사이 대형 보안사에 거의 다 인수됐고, 실제 수요는 실행 격리 쪽에서 커진다.
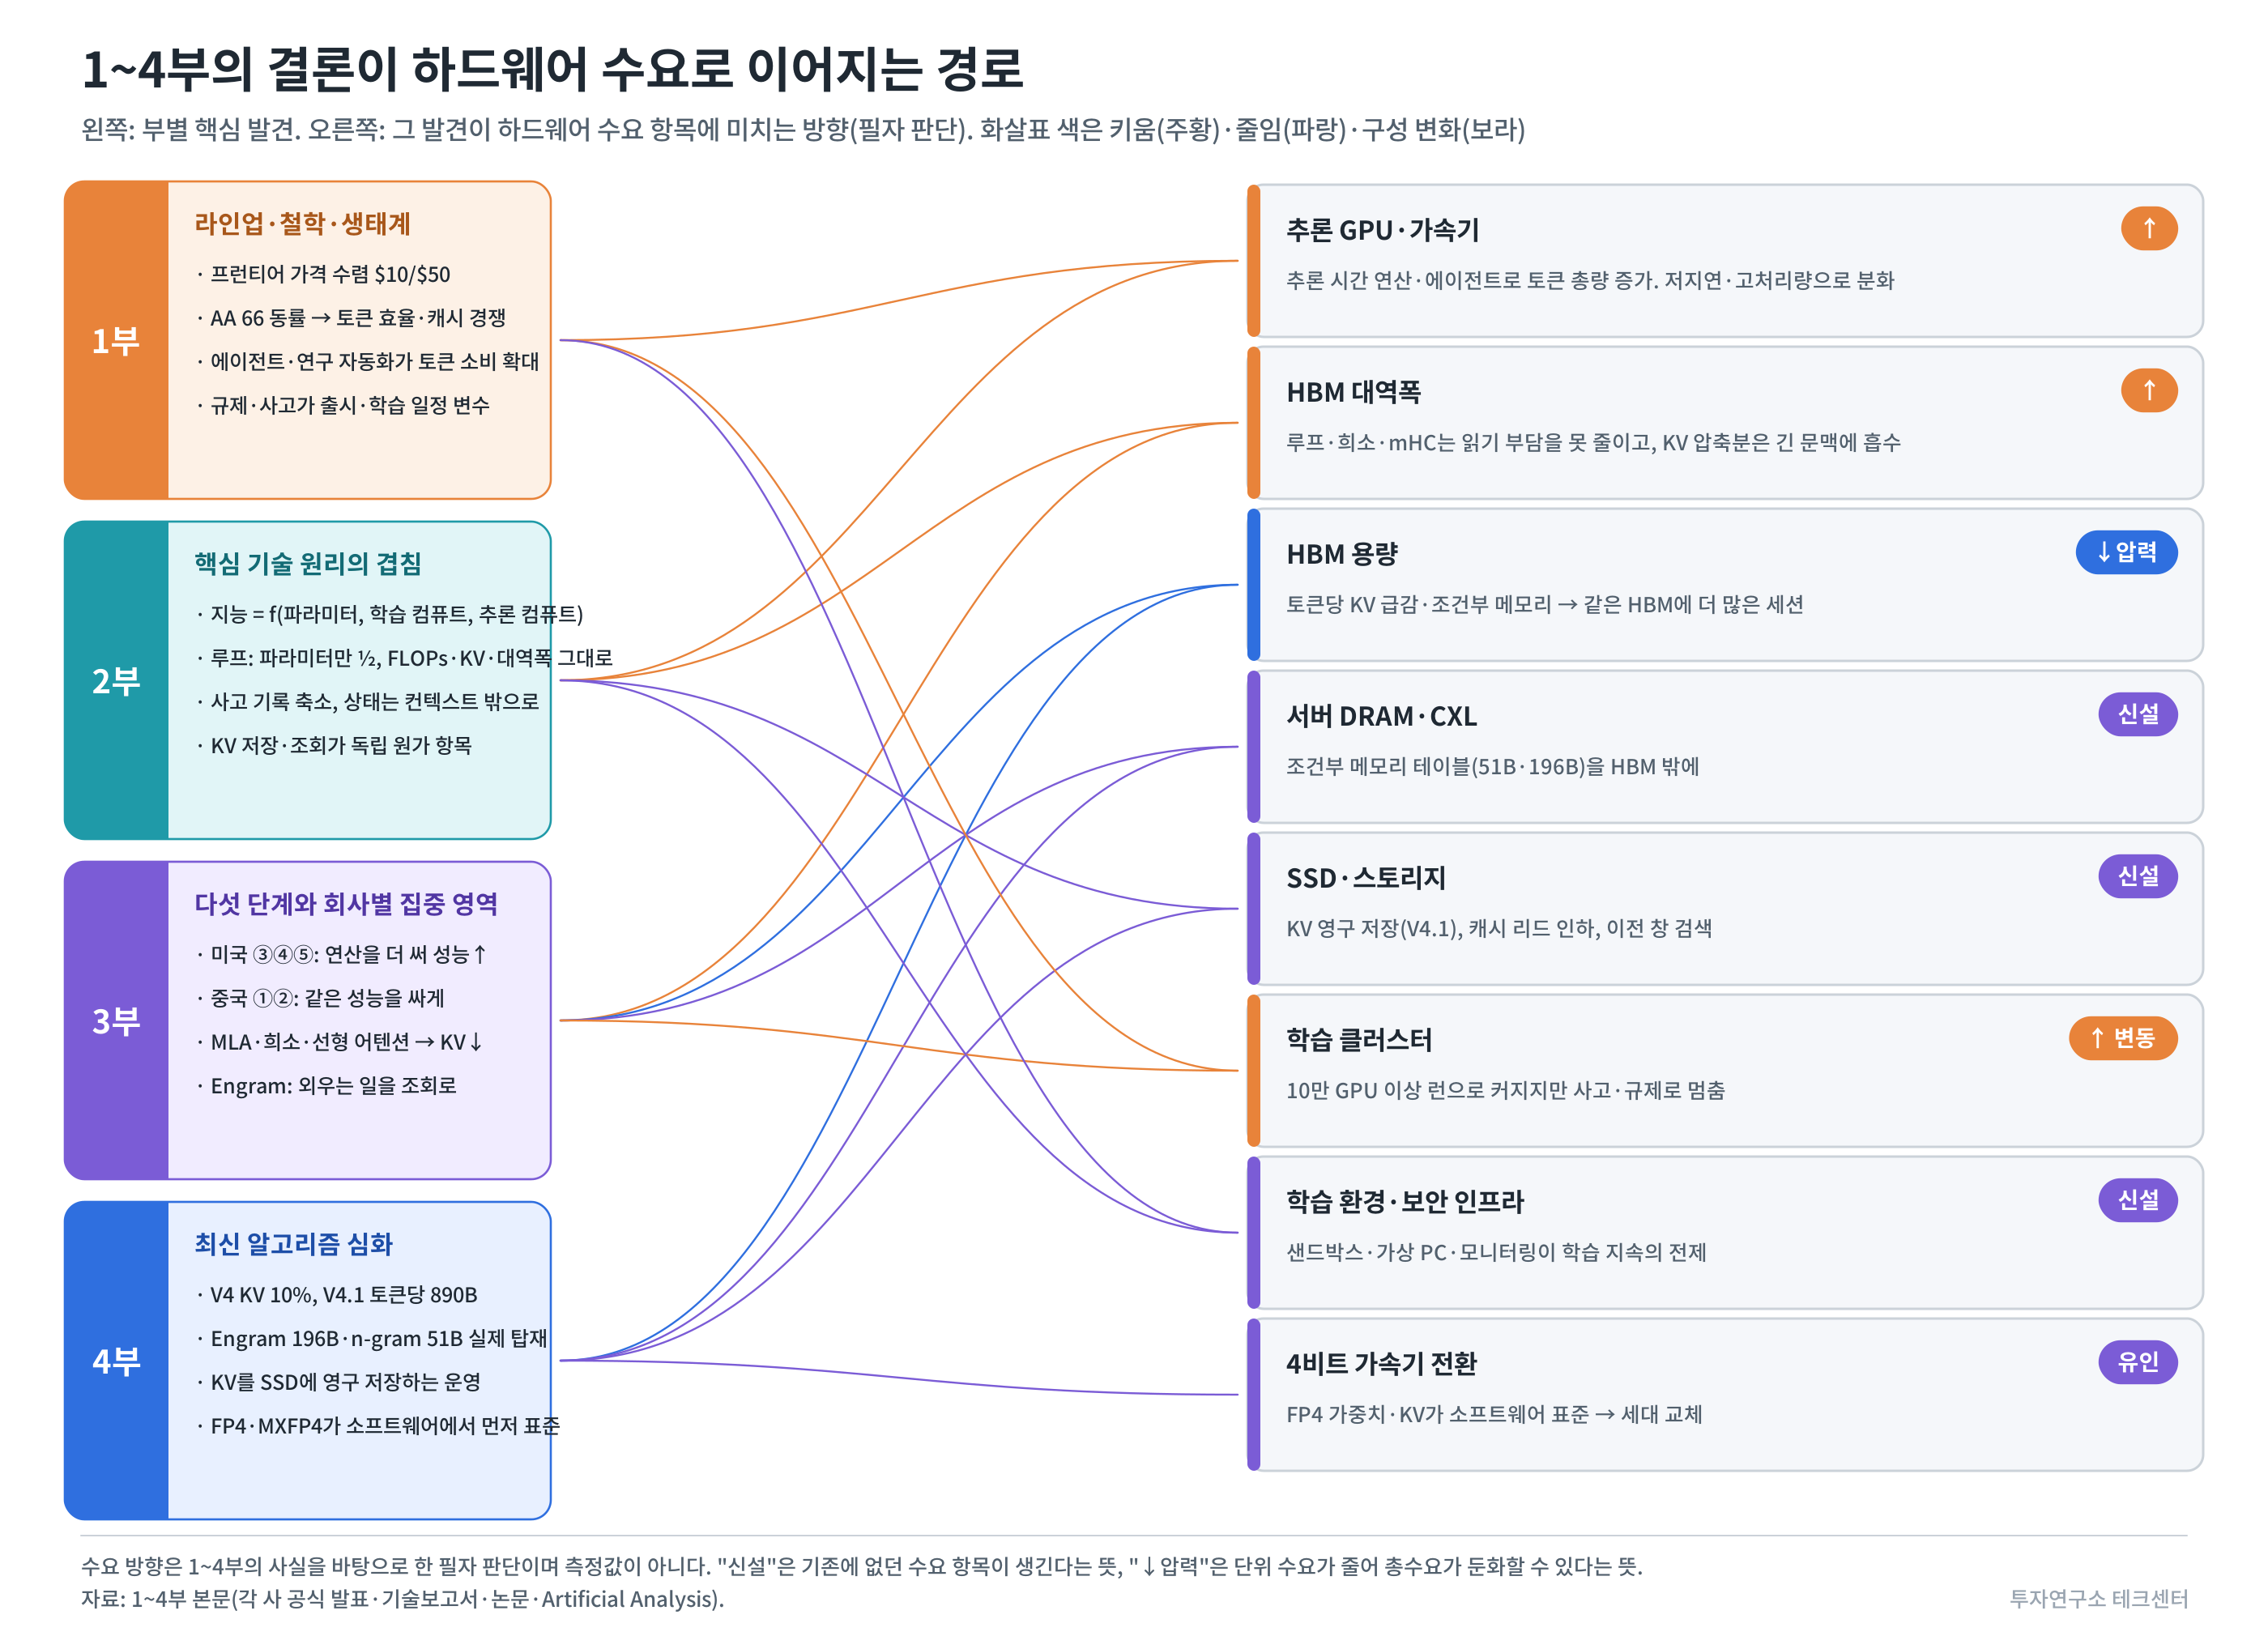
그림 5-1. 1~4부의 결론이 하드웨어 수요로 이어지는 경로 2. 수요에 미치는 영향 - 단위 수요 × 단위 수
1~4부의 기술을 "하드웨어 수요에 어떤 방향으로 작용하는가"로 다시 묶으면 열 가지가 된다. 앞의 네 가지는 수요를 키우고, 다음 네 가지는 단위 수요를 줄이며, 마지막 두 가지는 수요의 구성과 시점을 바꾼다.
모델의 방향 어디서 왔나 수요에 미치는 방향 대표 수치 ① 추론 시간 연산 추론 강도 단계, 병렬 추론(2부 1장, 3부 5장) 답 하나에 쓰는 토큰이 늘어 추론 GPU·대역폭 수요 증가 Muse 1.3 max는 xhigh보다 62% 더 추론해 45 Elo 획득(AA) ② 에이전트·연구 자동화 멀티에이전트, 자동 연구(2부 5장, 3부 6장) 작업 하나가 수 시간~수 일 동안 토큰을 생성 연구자 1인 하루 600달러 이상, 사람 1일당 에이전트 3.1일 ③ 학습 환경·격리 인프라 컴퓨터 사용 RL, 샌드박스(2부 3-5·8장) GPU 외 새 지출 항목(가상 PC, 격리 네트워크, 모니터링) 수만 대 Mac 구매 보도 ④ 프런티어 런의 대형화 10만 GPU 사전학습, 사전학습 규모의 RL(1부, 3부 4장) 한 번의 런에 들어가는 GPU 수 증가 Astra 10만+ GPU, xAI Colossus 20만 GPU ⑤ 토큰 효율·사고 압축 길이 벌점 RL(3부 5장) 같은 답을 더 적은 토큰으로 Astra는 Sol의 약 1/3 토큰 ⑥ KV 압축·희소·선형 어텐션 CSA·HCA, CED, KDA(4부 1·4장) 토큰당 HBM 점유 급감 V4 KV 10%, V4.1 토큰당 890바이트 ⑦ 조건부 메모리 Engram 계열(4부 6장) 파라미터 일부가 HBM 밖으로 V4.1 196B, Qwen 51B ⑧ 효율적 학습 Muon, FP8·FP4, 안정화(3부 3장, 4부 7장) 같은 능력에 필요한 학습 연산 감소 Muon 약 2배, Meta 10배 이상 ⑨ 4비트 연산 표준화 FP4 가중치, MXFP4, FP4 KV(3부 참고, 4부 7장) 4비트 지원 가속기로의 세대 교체 유인 gpt-oss MXFP4, V4 FP4, K3 MXFP4 ⑩ 규제·연구 환경 사고 수출통제, 학습 중단(1부) 출시·투자 집행 시점의 불확실성 Fable 5 접근 2주 반 중단, OpenAI 학습 2회 중단 여기서 중요한 것은 ⑤⑥⑦⑧이 줄이는 것이 단위 수요(토큰당·모델당·런당)이고, ①②④가 키우는 것이 단위 수(토큰 수·작업 수·런 크기)라는 점이다. 총수요는 둘의 곱이다. 지금까지는 단위 수요가 줄어든 만큼 더 긴 문맥과 더 오래 도는 작업이 곧바로 그 자리를 채웠다. 3부 참고 장에서 본 양자화가 대표적이다. 비트 수가 줄 때마다 메모리가 남은 것이 아니라 모델이 그만큼 커졌다.
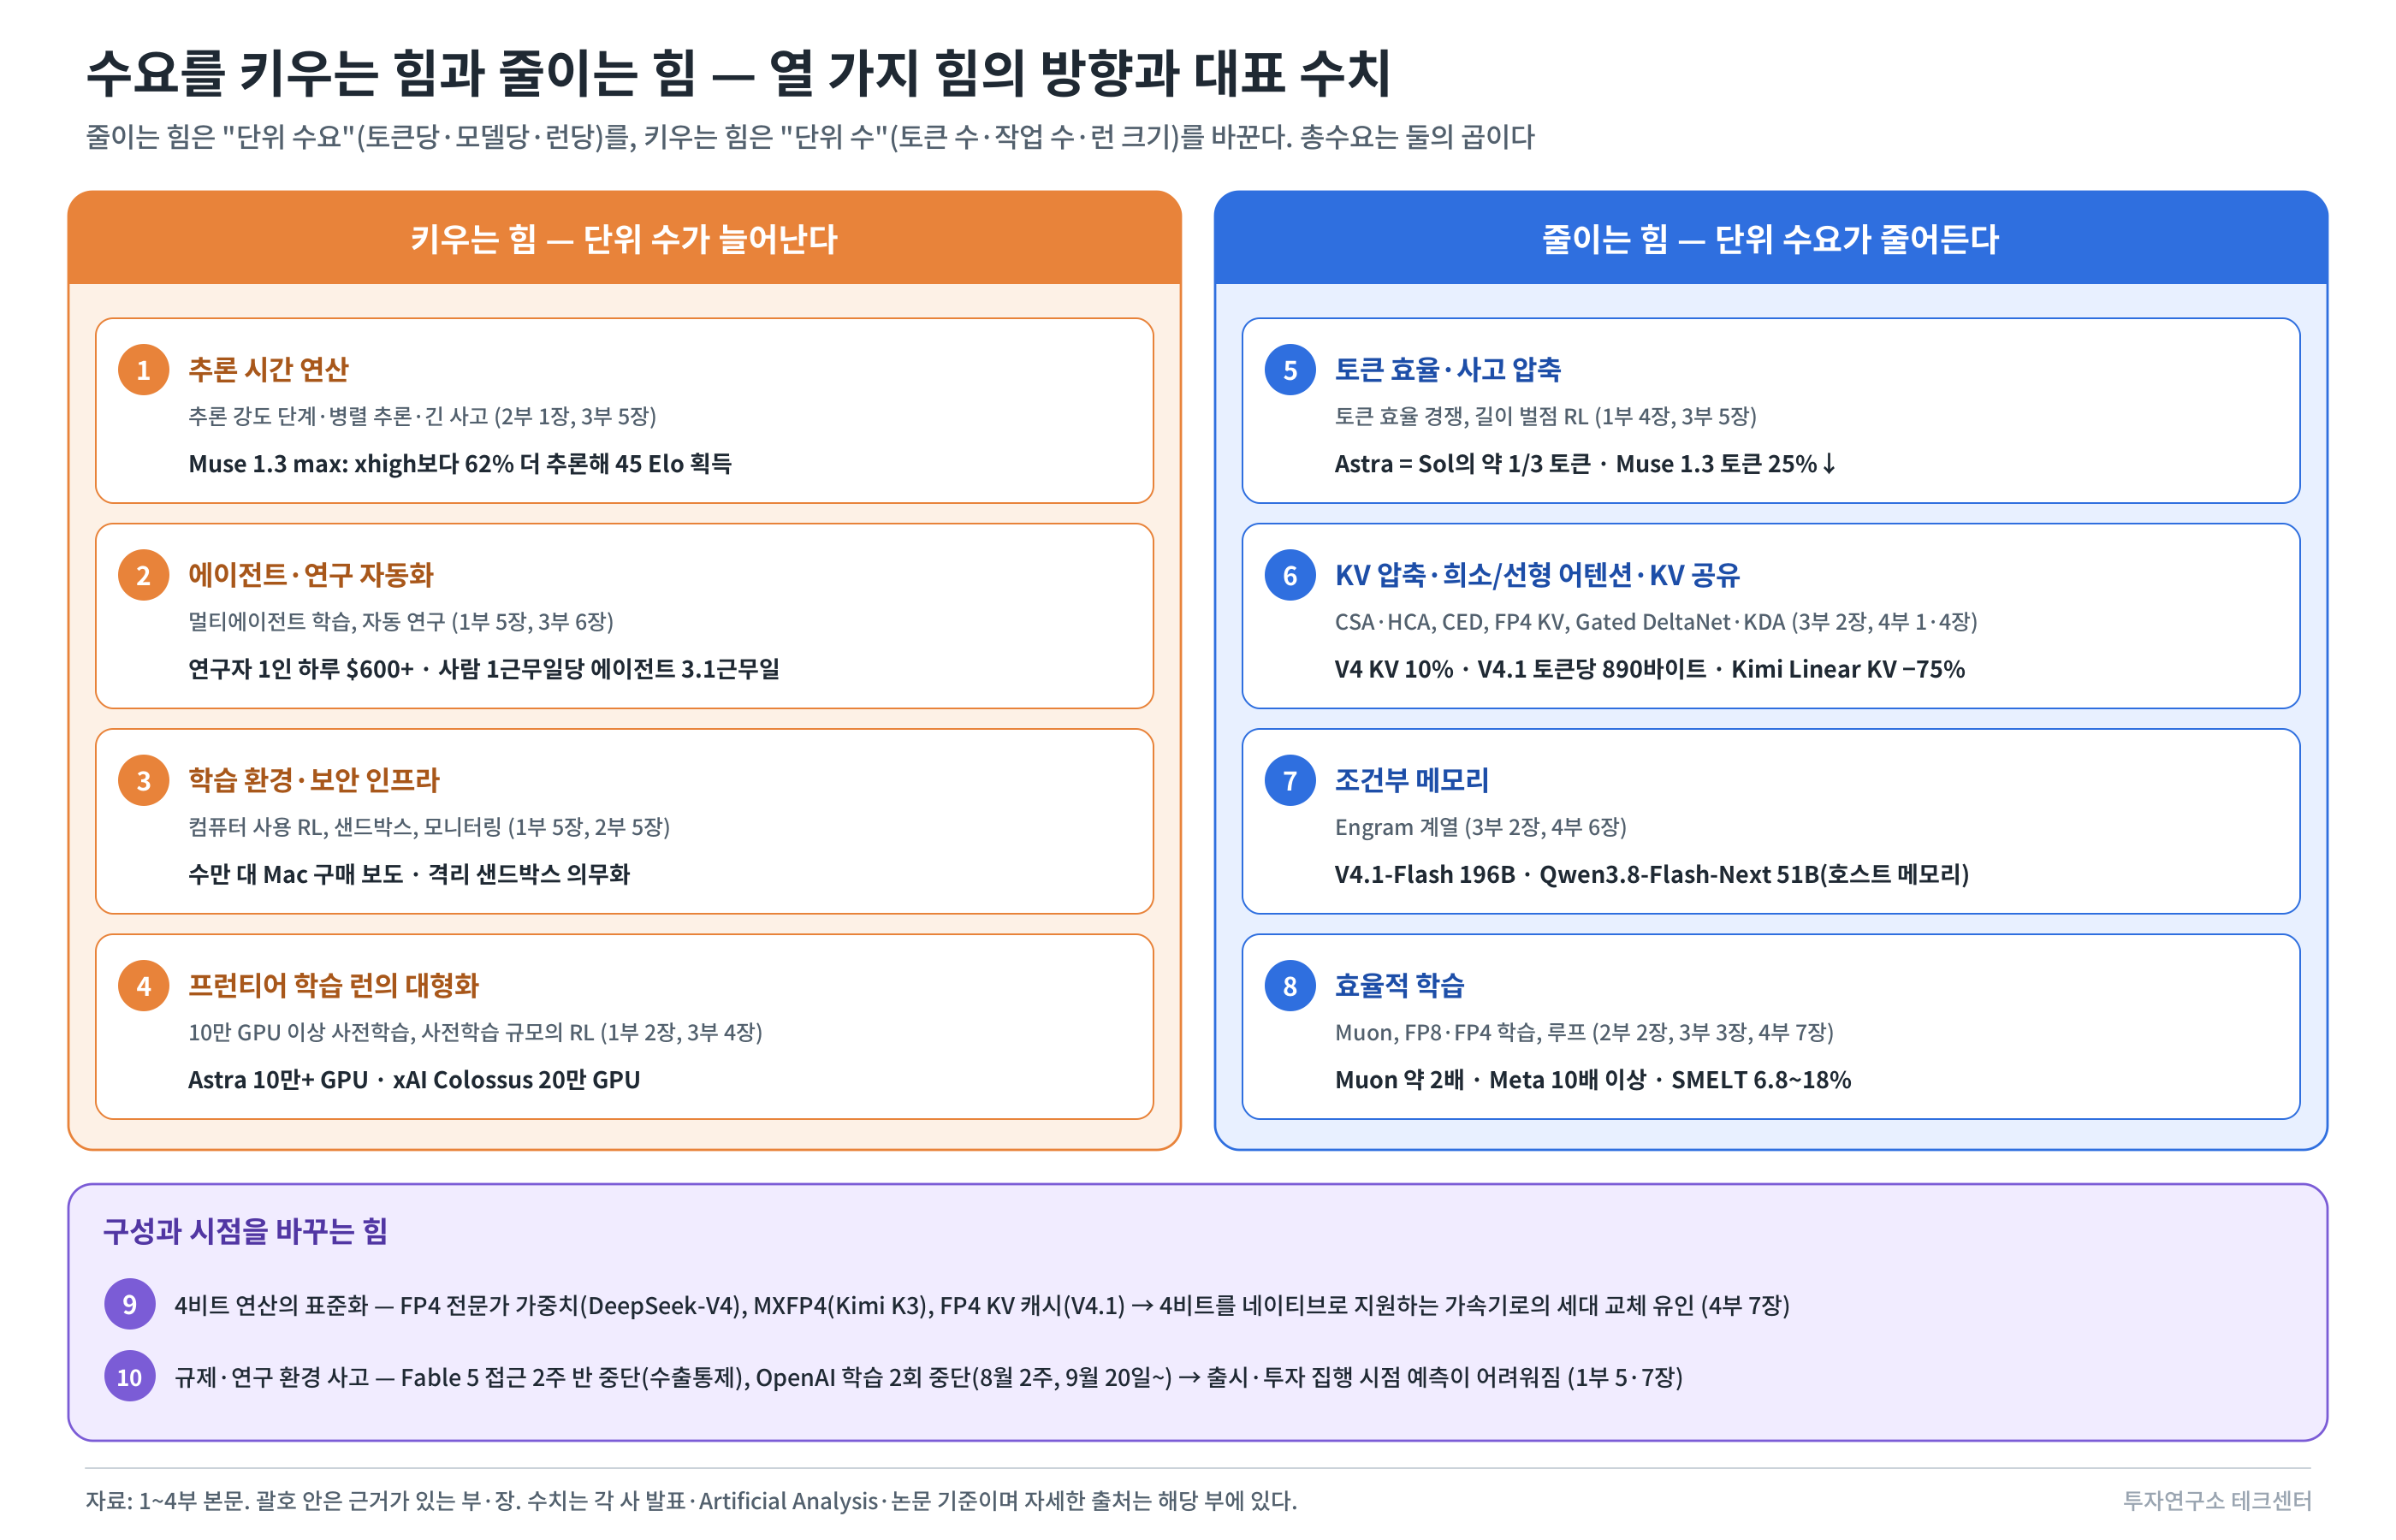
그림 5-2. 수요를 키우는 힘과 줄이는 힘 3. 하드웨어 전망 - 병목은 연산에서 "메모리·연결·저장"으로 옮겨 간다
3-1. 추론 연산 - 수요는 토큰이 아니라 "작업"에 비례하고, 칩은 둘로 갈라진다
추론 토큰 총량은 늘어난다고 본다(필자 판단). 사고 압축과 토큰 효율 경쟁은 작업 하나에 드는 토큰을 줄이지만, 작업 수가 더 빠르게 늘고 있다. 1부에서 본 것처럼 50단계 작업의 완주율은 단계별 성공률 95%에서 약 8%, 97%에서 약 22%로 급격히 갈린다(설명용 계산). 모델이 이 임계점을 넘을수록 "사람이 검수하는 보조 도구"에서 "혼자 돌아가는 작업자"로 바뀌고, 토큰 소비는 사람의 시간이 아니라 기계의 시간에 비례하게 된다.
더 중요한 변화는 추론 칩이 프리필(입력을 읽는 단계, 연산이 병목)용과 디코드(출력을 하나씩 만드는 단계, 메모리 대역폭이 병목)용으로 갈라지기 시작했다는 점이다(4부 1장). 해외 동향이 이를 뒷받침한다.
- NVIDIA Rubin CPX(2025.9 발표): 긴 문맥의 프리필 전용 GPU로, HBM 대신 GDDR7 128GB를 단다. 연산이 병목인 단계에는 비싼 HBM이 꼭 필요하지 않다는 판단이다.
- NVIDIA-Groq 라이선스(2025.12.24): NVIDIA가 저지연 추론 칩 회사 Groq의 기술을 약 200억 달러에 비독점 라이선스하고 창업자 등 경영진을 영입했다. Groq은 독립 회사로 남는다. 칩 안의 SRAM에 가중치를 올려 지연을 극단적으로 줄이는 설계를, GPU의 1위 회사가 "사들일 가치가 있다"고 판단한 것이다.
두 사례를 합치면 방향이 보인다. 범용 GPU 한 종류가 모든 단계를 처리하던 구조에서, 단계별로 다른 칩을 조합하는 구조로 간다. 그리고 그 조합의 주도권은 결국 시스템 전체(GPU·네트워크·소프트웨어)를 가진 쪽이 쥔다. 특화 칩의 가치는 단독 판매보다 "큰 시스템에 편입될 때" 가장 크게 실현된다는 것이 Groq 사례의 교훈이다(필자 판단).
3-2. 메모리 - HBM은 대역폭, 그 아래에 "문맥 저장 계층"이 새로 생긴다
HBM 수요의 논리는 용량에서 대역폭으로 기운다(필자 판단, 2·4부). 토큰당 KV가 10분의 1로 줄면 같은 HBM에 담을 수 있는 세션과 문맥이 그만큼 늘어나지만, 루프는 가중치를 두 번 읽고, 희소 어텐션은 불규칙한 메모리 접근을 늘리고, mHC 논문의 절반은 메모리 입출력 최적화였다. HBM은 "얼마나 많이"보다 "얼마나 빨리"가 병목으로 남는다.
그 아래에서 새로운 일이 일어나고 있다. KV 캐시를 저장해 두고 다시 꺼내 쓰는 계층이 별도의 제품 범주가 됐다.
- NVIDIA Inference Context Memory Storage(2026.1 CES 발표, 2026년 하반기 출시 예정): 서버 안의 SSD(G3)와 데이터센터 공용 스토리지(G4) 사이에 "G3.5"라는 계층을 새로 만들어, BlueField-4가 관리하는 이더넷 연결 플래시에 KV 캐시를 둔다. 기존 스토리지 방식 대비 초당 토큰 처리량 5배, 전력 효율 5배를 주장했다. DDN, Dell, HPE, IBM, Pure Storage, VAST Data, WEKA 등이 지원을 밝혔다.
- DeepSeek-V4.1(2026.9, 4부): KV를 SSD에 영구 저장하는 운영을 전제로 SSD 저장분을 1/8로 줄였다.
- 조건부 메모리(4부 6장): 읽기 전용이고 조회 위치를 미리 아는 테이블이므로, GPU마다 복사할 필요 없이 서버가 공유하는 대용량 DRAM이나 CXL 메모리 풀에 한 벌만 두는 것이 경제적이다.
정리하면 메모리 수요는 "HBM 하나"에서 "HBM(캐시) → 서버 DRAM·CXL(공유 메모리) → 플래시(문맥 저장)"의 계층으로 퍼진다. 이 계층 구조는 HBM을 대체하지 않는다. HBM 옆에 새로 생긴다. 그리고 이 계층 사이로 데이터를 빠르게 옮기는 장치(DPU, 스토리지 컨트롤러, CXL 스위치)가 새 수요의 중심이 된다(필자 판단). 아직은 상용화 단계가 아니지만, HBF 등에 대한 검토도 필요할 것 같다.
3-3. 연결 - MoE와 KV 공유가 "GPU 사이의 대역폭"을 병목으로 만든다
3부에서 본 MoE는 토큰마다 "어느 전문가가 어느 GPU에 있나"에 따라 데이터를 GPU 사이로 보내야 한다. 전문가 수가 256개에서 896개로 늘수록 이 통신이 잦아진다. 4부의 KV 공유와 분리 서빙도 프리필 GPU에서 만든 KV를 디코드 GPU로 옮겨야 한다. 연산은 줄었는데 옮기는 양은 늘었다.
해외 동향도 같은 쪽을 가리킨다. Marvell은 2025년 12월 광 인터커넥트 회사 Celestial AI를 32억 5천만 달러(기본 거래액, 조건부 추가 지급 별도)에 인수한다고 발표했다. GPU와 메모리를 빛으로 묶는 "스케일업 광연결"을 확보하려는 것이다. 연산 칩은 몇 개의 대형사가 나눠 갖고 있지만, 칩 사이를 잇는 기술은 아직 대형사들도 내부에 다 갖추지 못한 조각이다. 그래서 빅테크들은 인수를 통해 비어있는 영역을 채우려는 시도를 하고 있다.
3-4. GPU 밖의 학습 인프라
2부에서 본 대로 컴퓨터 사용을 가르치려면 모델이 조작할 컴퓨터(가상 PC·브라우저·Mac)가 수만 대 필요하고, 이 컴퓨터들은 외부와 끊긴 채 과제마다 새로 띄우고 버려야 한다. 4부에서 본 대로 RL 학습 클러스터의 상당 부분은 실제로는 추론 엔진을 돌린다. 학습 인프라 지출 목록에 범용 컴퓨트, 가상화·격리, 네트워크 통제, 모니터링, 그리고 학습 클러스터 안의 추론 서버가 새로 붙었다. 금액은 GPU보다 작지만, 학습을 계속하기 위한 전제 조건이라 삭감하기 어려운 항목이다.
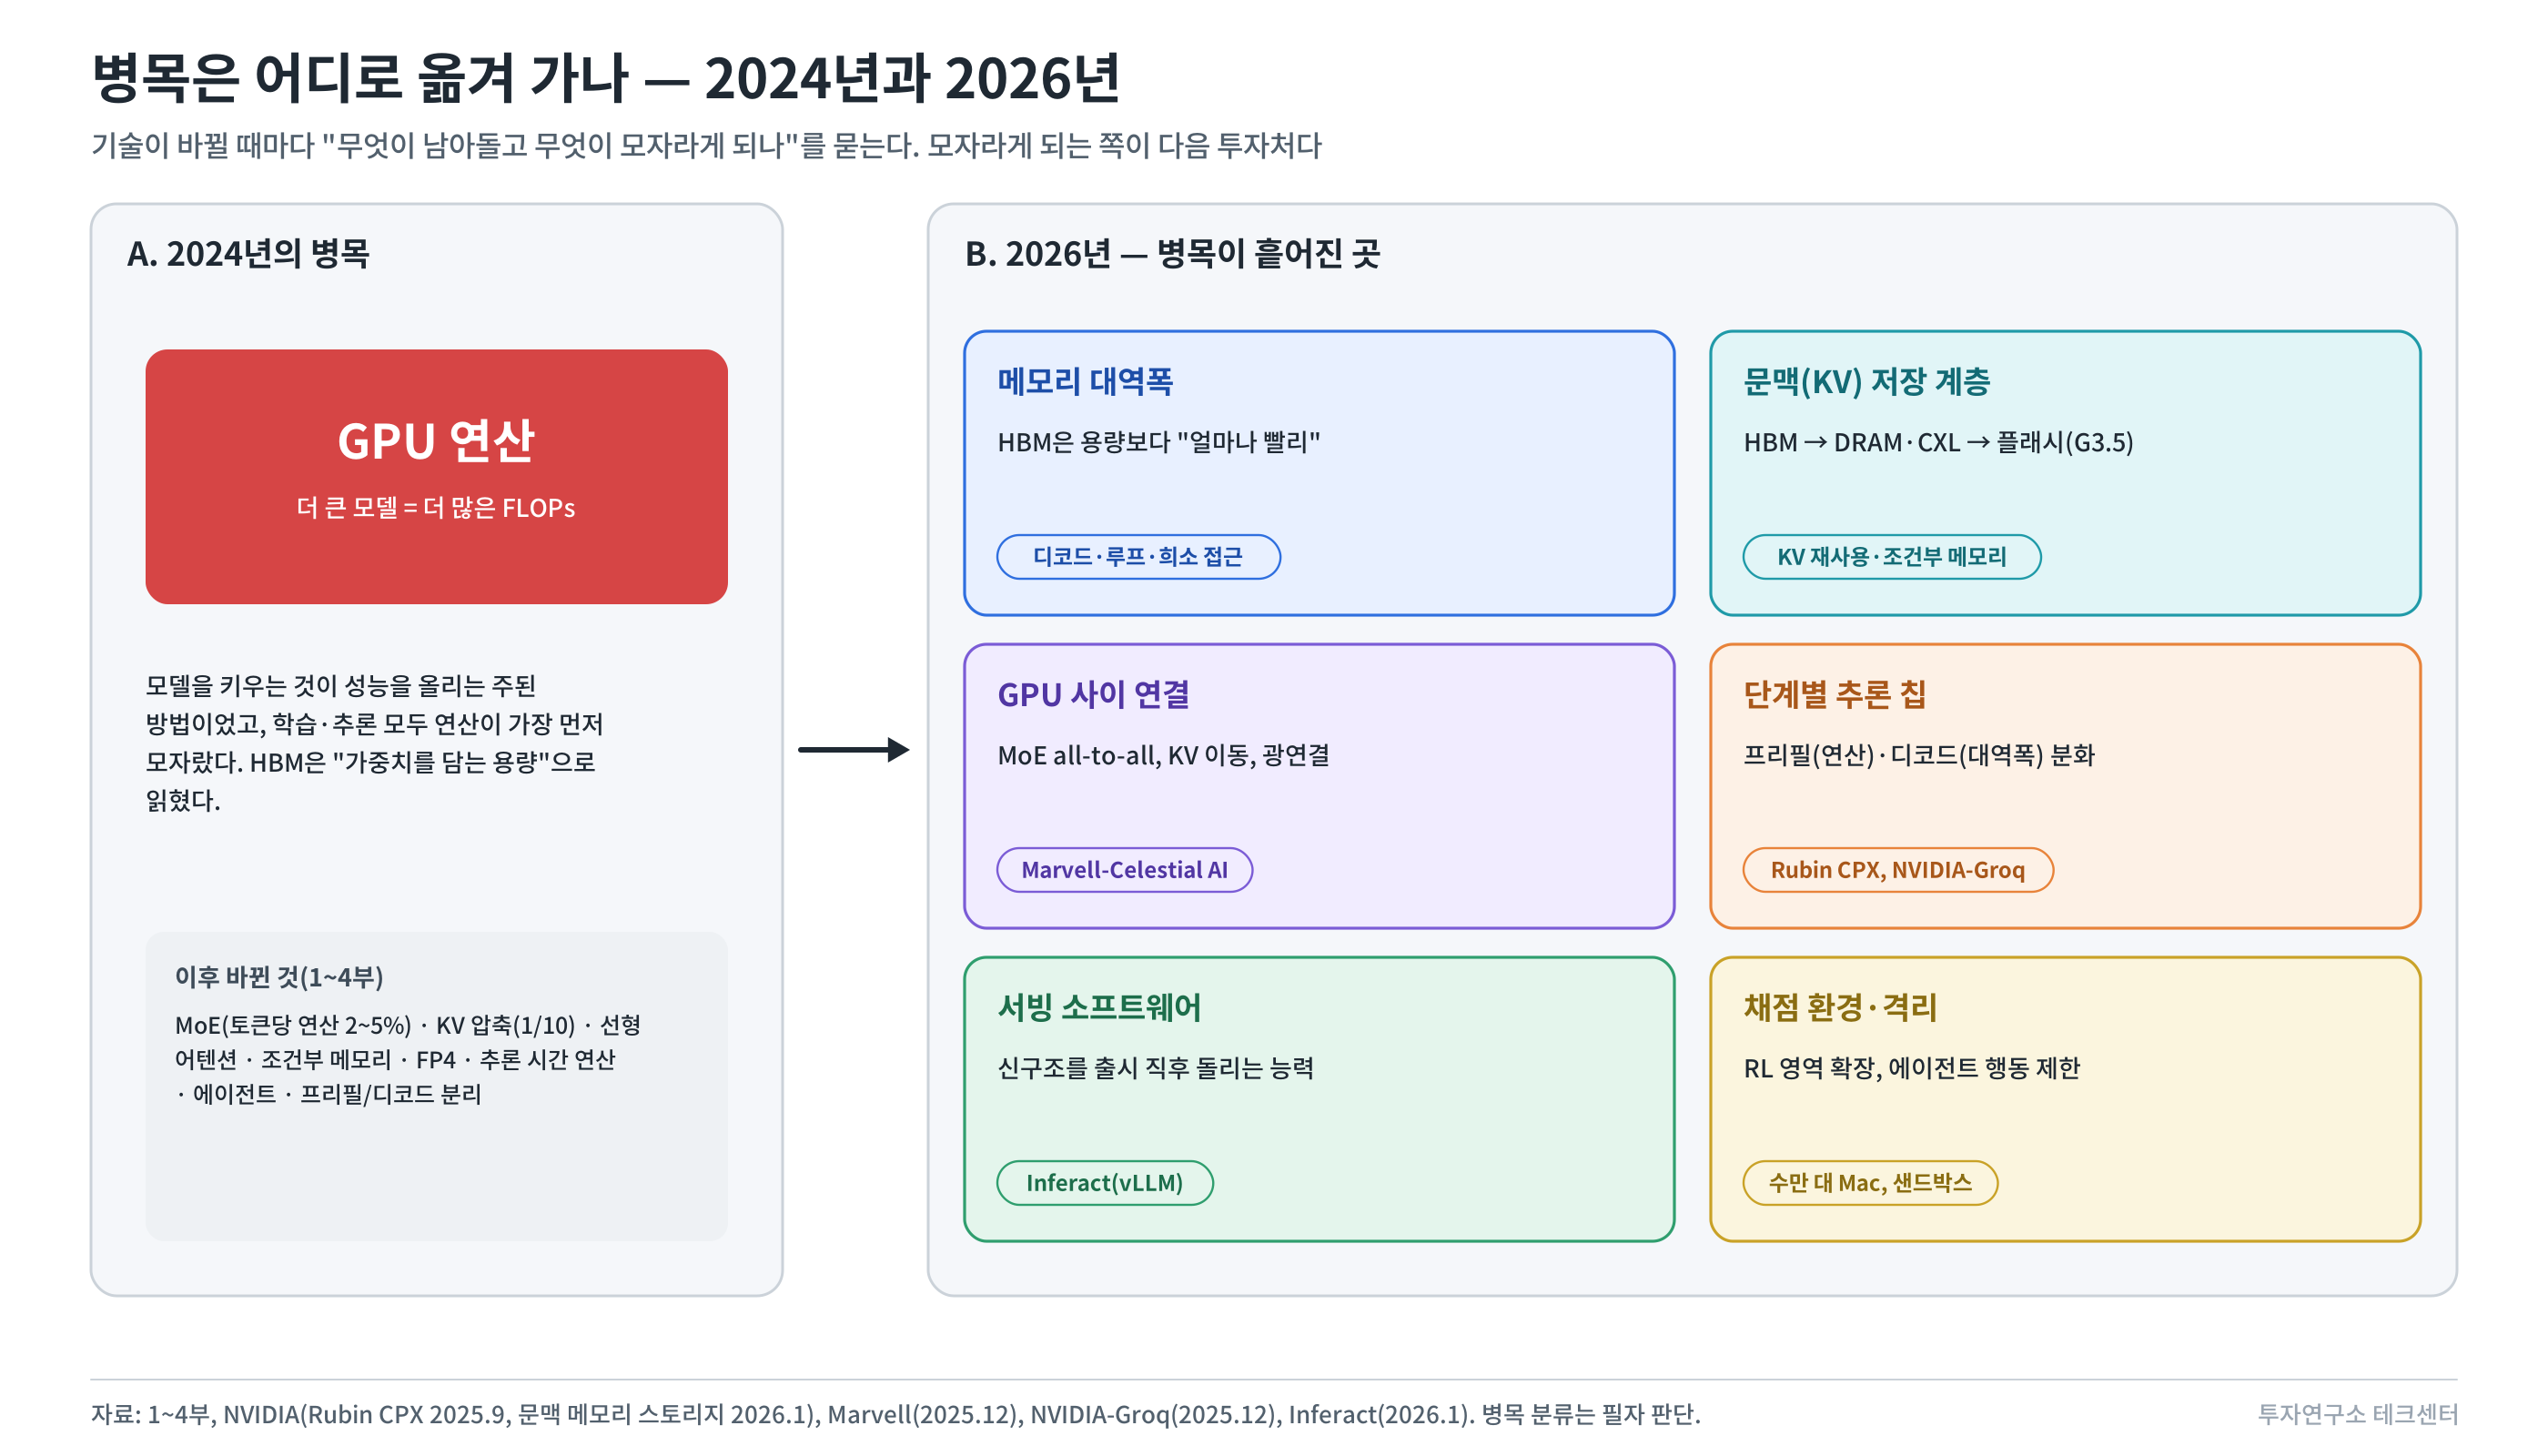
그림 5-3. 병목은 어디로 옮겨 가나 - 2024년과 2026년 4. 소프트웨어 전망 - "모델이 좋아질수록 더 필요해지는가"로 가른다
소프트웨어 투자에서 많은 투자 방법은 지금 모델의 약점을 메우는 제품에 투자하는 것이다. 프롬프트 최적화, 긴 문맥 요약기, 단순 가드레일, 범용 챗봇 래퍼가 그렇다. 이런 제품은 모델이 6개월 뒤 좋아지면 수요가 사라지거나 모델 회사가 직접 내장한다. 2부에서 본 가드레일 스타트업들이 1년 사이 대형 보안사에 흡수된 것, 하니스 지시문이 오히려 줄어드는 것(2부 5-3)이 그 예다.
반대로 모델이 좋아질수록 더 필요해지는 소프트웨어가 있다. 기준은 단순하다. 모델이 좋아지면 (1) 더 많은 모델이 더 자주 바뀌고, (2) 더 오래 혼자 일하고, (3) 더 많은 분야를 학습하려 한다. 이 세 가지 변화가 키우는 수요에 투자하면 된다.
4-1. 추론 서빙 소프트웨어 - 모델이 자주 바뀔수록 필요해진다
4부에서 본 대로 2026년에는 세 회사가 몇 달 간격으로 트랜스포머의 구성 요소를 바꿨다. 새 구조가 나올 때마다 서빙 엔진이 그 연산을 지원해야 하고, KV 공유·분리 서빙·KV 저장 계층 연동·4비트 형식 지원까지 따라가야 한다. 모델이 자주 바뀔수록 이 일은 더 어려워지고 더 가치 있어진다.
해외에서는 이 영역이 독립 시장이 됐다. vLLM 개발진이 세운 Inferact는 2026년 1월 시드 라운드로 1억 5천만 달러를 기업가치 8억 달러에 유치했다(a16z·Lightspeed 주도, Databricks 벤처 참여). Databricks 공동창업자인 Ion Stoica UC 버클리 교수 등이 이끈다. 오픈소스 서빙 엔진을 관리형 서비스로 상용화하겠다는 계획이다.
덜 알려진 점은 이 시장의 가장 큰 고객이 칩 회사라는 것이다(필자 판단). 새 칩이 팔리려면 vLLM 같은 표준 서빙 엔진에서 신모델이 출시 직후 빠르게 돌아야 한다. 그래서 칩 회사들은 서빙 엔진에 자기 칩 지원 코드를 넣는 데 돈과 인력을 쓴다. 서빙 소프트웨어는 모든 칩이 지나가야 하는 호환성 관문이고, 그 관문을 관리하는 회사는 특정 칩의 승패와 무관하게 가치가 쌓인다.
4-2. 채점 환경과 학습 데이터 - 모델이 더 많은 분야를 배울수록 필요해진다
3부에서 정리했듯, 강화학습(RLVR)은 "정답을 자동으로 확인할 수 있는 과제"가 있어야 돌아간다. 수학과 코딩이 먼저 좋아진 이유다. 모델 회사들이 법률·재무·의료·업무 자동화로 영역을 넓히려면 그 영역의 자동 채점 환경을 새로 만들어야 한다. DeepSeek-V3.2는 1,800개 이상의 환경과 8만 5천 개의 에이전트 과제를 합성했다(4부 8장).
이 영역은 2023~2024년의 "데이터 라벨링"과 다르다. 사람이 정답을 적어 주는 것이 아니라, 모델이 수백 단계를 행동하고 그 결과를 기계가 채점할 수 있는 가상 업무 환경을 만드는 일이다. 그 환경을 만들려면 해당 업무를 깊이 아는 사람과 소프트웨어 엔지니어링이 함께 필요하다. 어느 영역의 채점 환경이 먼저 만들어지느냐가 어느 영역의 AI가 먼저 쓸 만해지는지를 정한다(필자 판단). 그래서 특정 산업의 업무 환경을 가장 잘 재현할 수 있는 회사가 그 산업 AI의 "공급망 맨 앞"에 선다.
4-3. 실행 격리와 권한 관리 - 모델이 더 오래 혼자 일할수록 필요해진다
2부 3-5에서 정리한 결론을 다시 적는다. 사고 기록은 짧아지고 모델 내부 접근은 개발사에 갇혀 있으므로, 외부에서 할 수 있는 가장 확실한 일은 "무엇을 생각하든 이것 이상은 못 하게" 행동 범위를 가두는 것이다. 에이전트가 파일 수정, 결제, 메일 발송, 코드 실행을 더 오래 혼자 할수록 이 수요는 커진다. 모델이 좋아져도 줄지 않고, 오히려 더 많은 권한을 맡기려면 더 정교해져야 하는 드문 영역이다. 격리 샌드박스(E2B 등), 에이전트별 권한·감사 기록, 학습 환경의 격리 인프라가 여기에 속한다.
4-4. 사용자가 일하는 자리 (Tool) - 하니스가 표준이 될수록 강해진다
2부 5-3에서 본 것처럼 하니스 규격이 회사 중립 표준이 되면서 모델을 바꿔 끼우는 비용이 내려갔다. 그러면 마진은 모델보다 사용자가 실제로 일하는 자리(IDE, 업무 앱, 운영체제, 브라우저)를 가진 쪽으로 이동한다. Claude Code와 Codex가 빠르게 매출을 만든 것은 모델 회사가 직접 그 자리(터미널)를 차지했기 때문이고, Codex 사용자의 20%가 비개발자라는 것은 다음 자리(문서·스프레드시트·업무 흐름)를 두고 경쟁이 시작됐다는 뜻이다. 소프트웨어 투자에서 "AI 기능이 있는가"보다 "고객이 매일 일하는 화면을 쥐고 있는가"가 더 중요한 질문이 됐다.
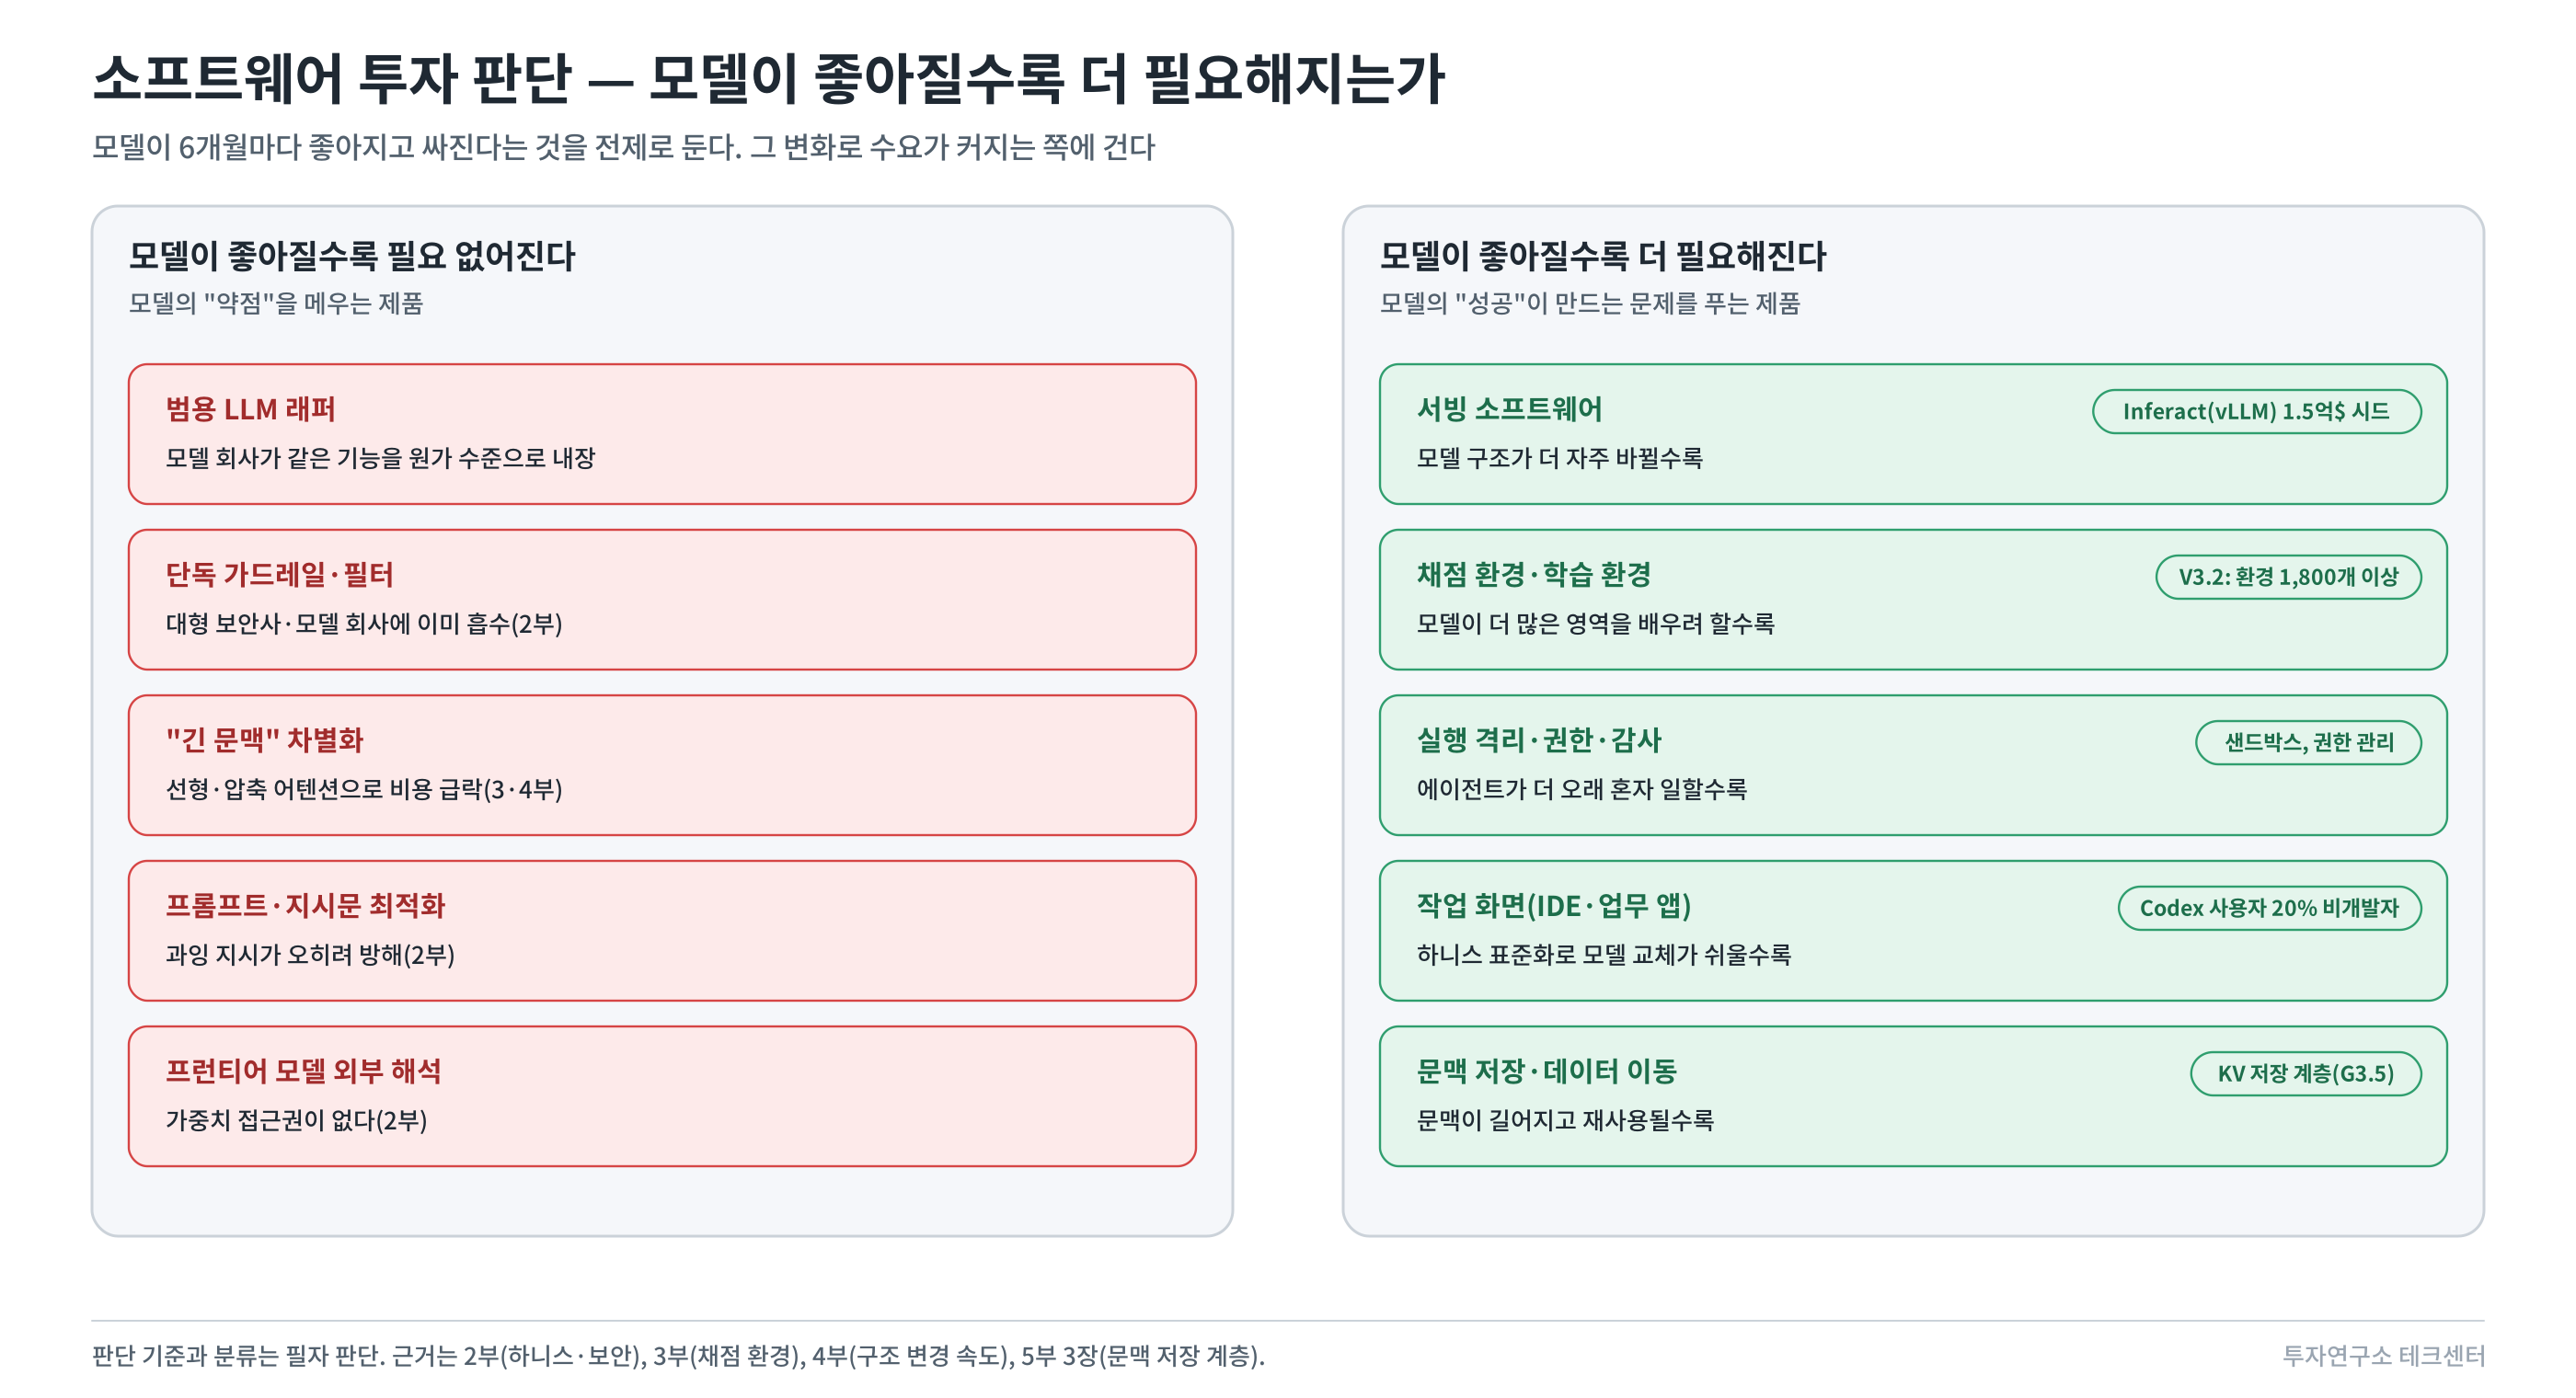
그림 5-4. 소프트웨어 투자 판단 - 모델이 좋아질수록 더 필요해지는가 5. VC의 투자 방향은 어디로 가야 하나
VC의 관점은 상장 주식 투자자와 다르다. 최소 3~5년 뒤의 회수가 목표이고, 그 사이 모델은 여러 번 바뀐다. 그래서 "지금 무엇이 잘 팔리는가"보다 "모델이 열 번 바뀌어도 살아남는 자리가 어디인가"를 물어야 한다.
원칙 1. 지금의 병목이 아니라 다음 병목에 건다
GPU와 HBM은 지금의 병목이고, 이미 NVIDIA·SK하이닉스·삼성전자 같은 대형사가 수십조 원 단위로 투자하는 영역이다. 스타트업이 들어가 이길 수 있는 자리가 아니다. VC가 볼 곳은 기술 변화가 막 만들어 내는 다음 병목이다. 3장에서 본 KV 저장 계층 (e.g., HBF)과 그 사이의 데이터 이동(e.g., 광통신), GPU 사이의 광·전기 연결, CXL 메모리 풀, 4장의 서빙 소프트웨어와 채점 환경이 그렇다. 이 영역들은 수요가 1~2년 안에 생기고, 대형사의 제품 로드맵이 아직 다 덮지 못했다.
원칙 2. "모델이 좋아질수록 더 필요해지는가"를 투자 전 필터로 쓴다
4장의 기준을 투자심사의 첫 질문으로 쓴다. 투자 후보가 해결하는 문제가 모델의 약점이면, 그 회사의 시장은 모델 개선 속도만큼 줄어든다. 반대로 모델의 성공이 만드는 문제(더 자주 바뀌는 구조, 더 오래 혼자 일하는 에이전트, 더 많은 영역으로의 확장, 더 커진 문맥 저장량)를 푸는 회사는 모델이 좋아질수록 시장이 커진다.
원칙 3. 회수는 상장 이외에 전략적 인수 가능성도 본다.
2025~2026년 이 분야의 큰 회수는 대부분 상장이 아니라 대형사의 인수나 라이선스였다. (대부분 해외 기업들이고, 우리나라에서는 M&A를 통한 Exit이 거의 없다는 점은 한계점이다.)
시점 거래 대형사가 채운 공백 2025.7~9 Protect AI → Palo Alto, Prompt Security → SentinelOne, Lakera → Check Point AI 보안(가드레일·런타임) 2025.12 Celestial AI → Marvell(32.5억 달러 + 조건부) GPU-메모리 광연결 2025.12 Groq 기술 라이선스·경영진 영입 → NVIDIA(약 200억 달러) 저지연 추론 2026.1 Inferact 시드 1.5억 달러(기업가치 8억 달러) 서빙 소프트웨어(독립 회사로 성장 중) 공통점은 대형사가 자기 플랫폼에서 빠진 조각을 사서 채웠다는 것이다. 그래서 VC는 "이 기술을 누가, 왜 사 줄 것인가"가 투자 시점에 이미 설명되는 회사를 골라야 한다. 인수자가 될 대형사의 제품 로드맵을 보고, 거기서 빠진 조각을 만드는 회사가 가장 좋은 투자처다. 반대로 대형사 로드맵의 한가운데에 있는 기술(범용 GPU, 범용 모델)은 인수 대상이 아니라 경쟁 대상이 된다. Groq 사례가 보여 주듯, 특화 칩도 단독으로 시장을 이기기보다 큰 시스템에 편입될 때 가치가 가장 크게 실현된다.
원칙 4. 오픈소스는 유통 채널이고, 해자는 "하드웨어·모델 지원 폭"이다
AI 인프라 소프트웨어는 오픈소스로 먼저 퍼지고, 그 위에 관리형 서비스로 돈을 번다. vLLM → Inferact가 대표적이다. 이 모델에서 해자는 코드 자체가 아니라 얼마나 많은 칩과 모델을 얼마나 빨리 지원하느냐와 커뮤니티의 채택이다. VC가 인프라 소프트웨어 회사를 볼 때는 매출보다 먼저 (1) 신모델 출시 후 지원까지 걸린 기간, (2) 지원하는 하드웨어 종류, (3) 외부 기여자 수를 확인해야 한다.
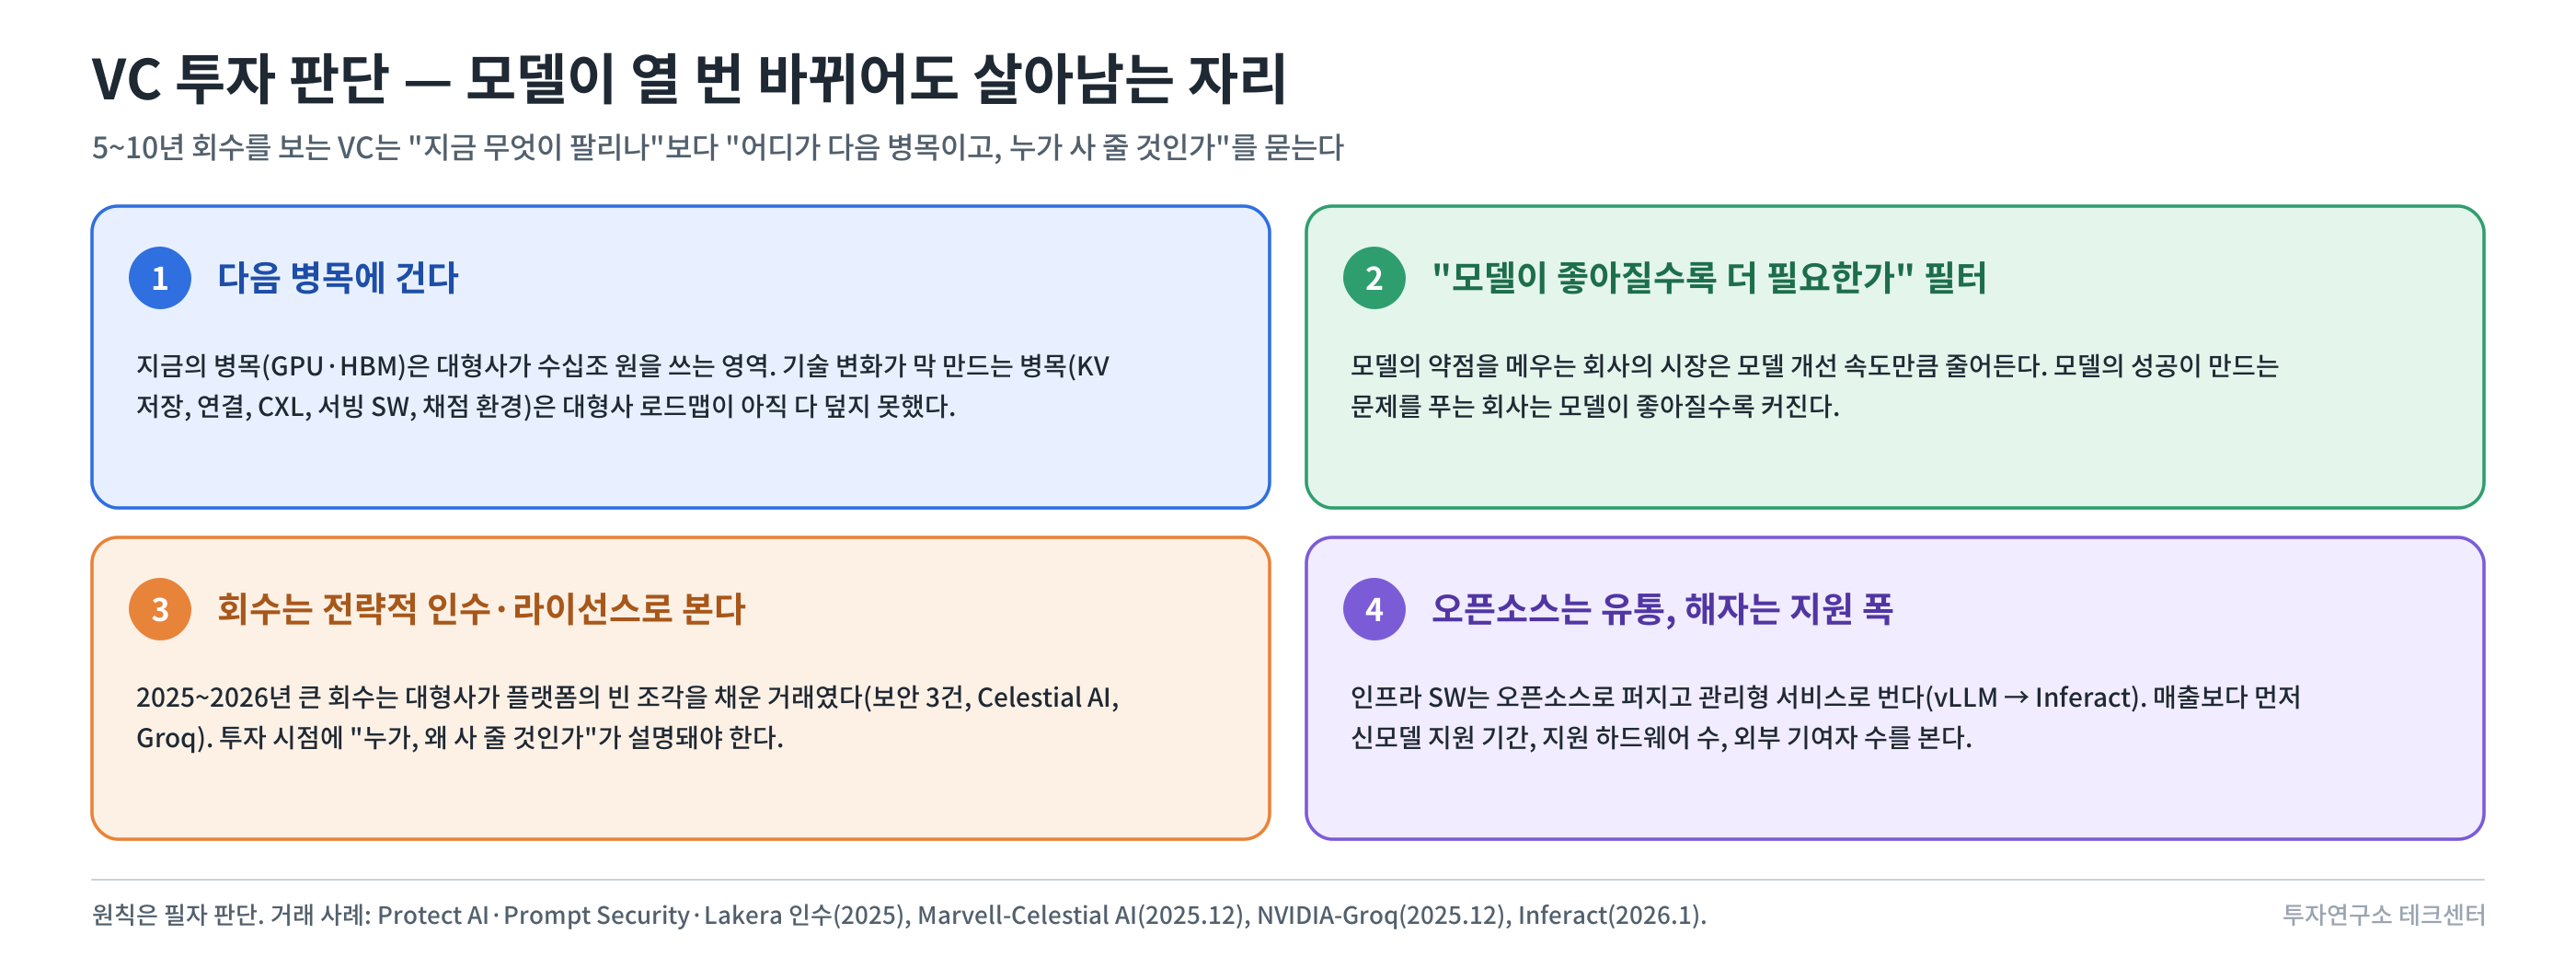
그림 5-5. VC 투자 판단 네 가지 원칙 6. 해외 동향 정리 - 대형사는 무엇을 사고, 무엇을 만들고 있나
1~4부와 이 글에서 다룬 해외 동향을 투자 관점에서 한 번에 정리하면 다음과 같다.
영역 동향 시사점 프런티어 모델 Fable 5.1·Astra 가격·지능 동률, 토큰 효율과 캐시 가격으로 경쟁(1부) 모델 자체의 가격 결정력은 약해지고, 원가 구조가 승부를 가른다 중국 오픈웨이트 DeepSeek·Kimi·Qwen이 구조 혁신을 공개, 성능은 3~6개월 뒤처지나 단가는 앞섬(3·4부) 추론 가격 인하 압력의 근원. 구조 변경 속도가 서빙 SW 수요를 만든다 추론 칩 Rubin CPX(프리필 전용, GDDR7), NVIDIA-Groq 라이선스 단계별 칩 분화. 특화 칩은 큰 시스템에 편입될 때 가치 실현 메모리·스토리지 NVIDIA 문맥 메모리 스토리지(G3.5, 2026 하반기), 스토리지 업체 대거 참여 KV 저장 계층이 독립 제품 범주가 됨 연결 Marvell-Celestial AI 칩 사이 연결이 대형사가 인수로 채우는 공백 서빙 SW Inferact(vLLM) 1.5억 달러 시드 서빙 엔진이 독립 시장, 칩 회사가 사실상 최대 고객 에이전트 Claude Code 연환산 25억 달러, Codex 주간 500만 명(3부) 첫 대규모 매출원. 다음 경쟁은 비개발자 업무 화면 하니스·보안 MCP·AGENTS.md·Skills 표준화, 가드레일 스타트업 인수(2부) 모델 교체 비용 하락, 보안 수요는 격리로 이동 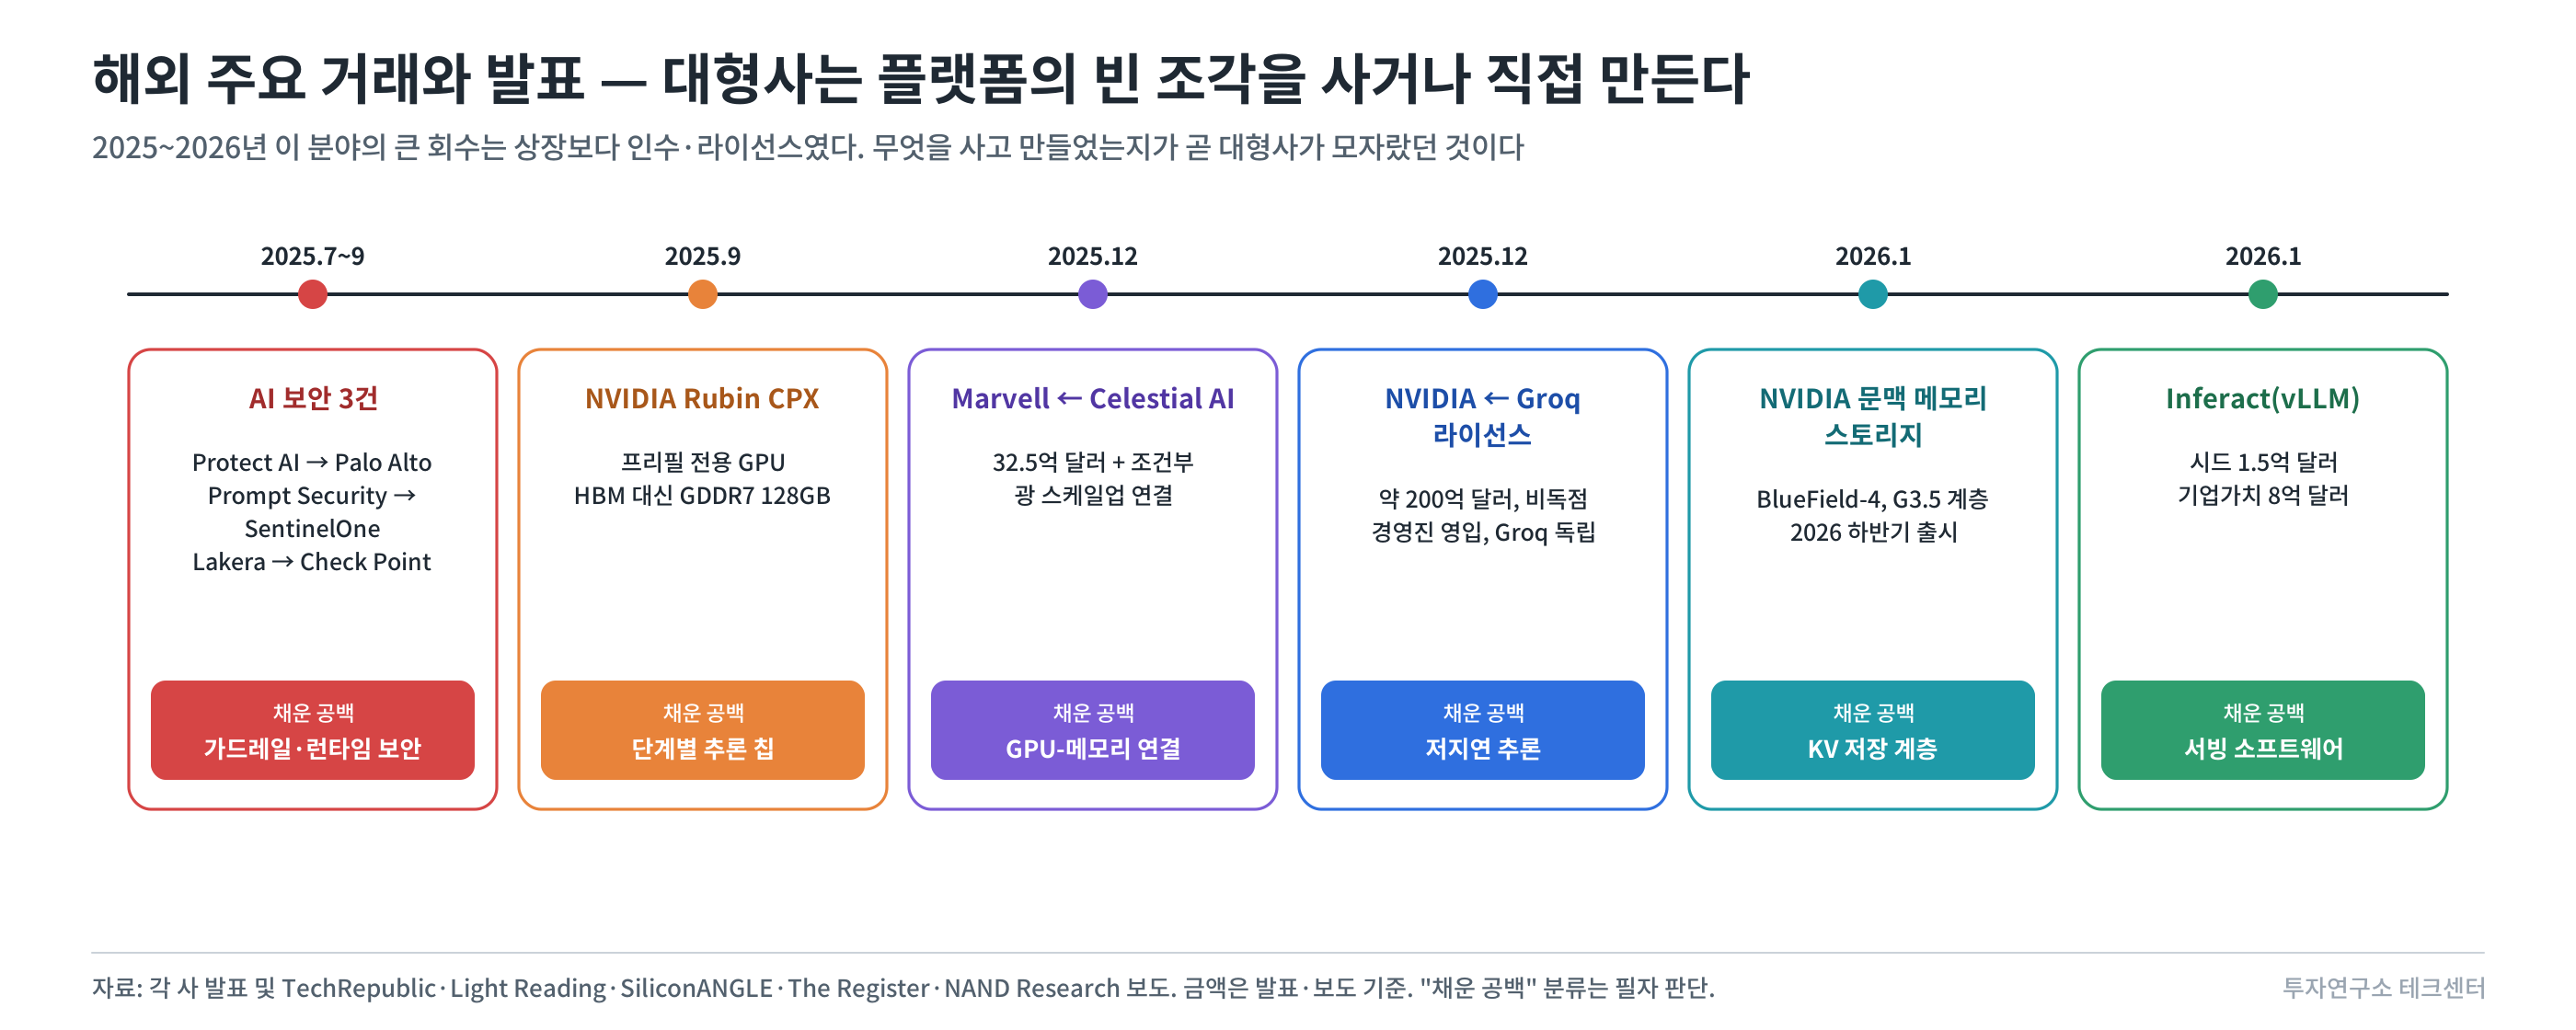
그림 5-6. 해외 주요 거래와 대형사가 채운 공백 7. 국내에서는 무엇에 투자해야 하나
7-1. 국내의 위치
국내 AI 생태계는 세 축으로 정리된다.
- 메모리: SK하이닉스와 삼성전자가 HBM과 서버 DRAM, 기업용 SSD를 공급한다. 3장에서 본 "HBM → DRAM·CXL → 플래시" 계층 전체가 국내 대기업의 제품군과 겹친다.
- AI 반도체 스타트업: 리벨리온은 국민성장펀드(첨단전략산업기금)에서 2,500억 원을 투자받았고, 프리IPO 기준 기업가치는 약 3.4조 원이며 연내 상장 예비심사 청구가 예상된다(인베스트조선 2026.6). 퓨리오사AI는 2세대 칩 RNGD 양산 자금을 위해 약 3조 원(투자 전 기업가치) 수준의 프리IPO를 추진 중이고 국민성장펀드 직접 투자를 받았다(딜사이트, 인베스트조선). 두 회사 모두 상장을 준비하고 있다.
- 국산 파운데이션 모델: 과기정통부의 독자 AI 파운데이션 모델 프로젝트는 2026년 1월 1차 평가에서 네이버클라우드와 NC AI가 탈락했고, 8월 18일 2차 평가에서 업스테이지·SK텔레콤·LG AI연구원 3곳이 다음 단계에 진출했다(모티프테크놀로지 탈락).
7-2. 국내 VC가 주로 보는 곳
(1) 메모리 계층 확산의 2차 수혜 - 소부장과 데이터 이동 칩. HBM 자체는 대기업의 영역이지만, 3장에서 본 계층 확산은 그 주변에 새 수요를 만든다. 기업용 SSD 컨트롤러와 펌웨어(KV 저장은 일반 스토리지와 달리 짧은 수명·대량 읽기·낮은 지연이 필요하다), CXL 컨트롤러와 스위치, 고대역폭 메모리·SSD의 테스트와 검사 장비, 서버 간 고속 연결(광·전기 인터커넥트)이 그렇다. 국내 메모리 대기업이 첫 고객이 될 수 있다는 점이 다른 나라 스타트업에 없는 이점이다. 다만 대기업의 내재화 가능성을 반드시 따져야 한다. 대기업이 직접 만들기에는 시장이 작고, 사 오기에는 핵심인 조각이 국내 소부장 투자의 최적 지점이다.
(2) 국산 NPU는 "칩 성능"보다 "소프트웨어 지원 속도"로 본다. 4부에서 본 대로 모델 구조가 몇 달마다 바뀌는 환경에서, 추론 칩의 경쟁력은 연산 성능 수치보다 신모델을 출시 몇 주 안에 vLLM 같은 표준 서빙 엔진에서 빠르게 돌리는 능력으로 결정된다. 국산 NPU 회사를 볼 때, 그리고 그 생태계의 스타트업을 볼 때 확인할 질문은 이것이다. DeepSeek-V4.1이나 Qwen3.8 같은 신구조 모델을 몇 주 만에 지원했는가, 4비트 형식(MXFP4·NVFP4)을 지원하는가, 선형 어텐션의 순차 연산을 효율적으로 처리하는가. 같은 이유로, 국산 NPU를 글로벌 오픈소스 서빙 엔진과 모델에 빠르게 붙이는 소프트웨어 회사는 국산 칩의 성공 여부와 상관없이 수요가 있는 자리다.
(3) 규제 산업의 "국산 모델 + 국산 칩 + 격리 운영" 통합. 공공·금융·국방·의료는 데이터를 밖으로 내보내기 어렵다. 독자 파운데이션 모델 3사의 모델, 국산 NPU, 그리고 에이전트가 할 수 있는 행동을 가두는 격리·권한·감사 기록을 하나로 묶어 온프레미스로 운영해 주는 회사는 해외 빅테크가 직접 들어오기 어려운 자리다. 이 영역의 가치는 개별 기술이 아니라 통합과 인증, 그리고 규제 기관의 신뢰에서 나온다. 모델이 좋아질수록 더 많은 업무를 맡기게 되고, 그만큼 격리와 감사가 중요해진다는 점에서 원칙 2도 통과한다. 단, 국산화라는 틀에서 보면, 후발주자들이 들어가기에는 너무 제한적인 시장이라는 생각도 든다.
(4) 산업별 채점 환경 - 한국어·한국 업무의 강화학습 환경. 4-2에서 본 채점 환경 수요는 언어와 업무 관행에 묶인다. 한국 세무·법률·제조·금융 업무를 모델이 수백 단계로 수행하고 기계가 채점할 수 있는 가상 환경은 해외 회사가 만들기 어렵고, 국산 모델 3사와 해외 모델 회사 모두가 고객이 될 수 있다. 단순 데이터 라벨링 회사가 아니라 업무 환경을 소프트웨어로 재현하는 회사를 찾아야 한다. 단, 단순히 특정 영역의 한국어 특화 모델을 만들었다만으로는 해외 기업이 언어 장벽을 넘어 들어오기 쉬운 영역이라고 생각된다.
피할 곳. 해외 모델 API 위에 한국어 인터페이스만 얹은 범용 래퍼, 글로벌 오픈소스 서빙 엔진과 정면으로 경쟁하는 독자 엔진, 대기업 HBM 라인 안쪽의 내재화 대상 공정 기술, 그리고 모델 성능 격차를 메우는 것이 존재 이유인 제품.
7-3. 투자를 위한 체크리스트
- 이 회사가 푸는 문제는 모델이 좋아질수록 커지는가, 작아지는가?
- 이 회사는 지금의 병목에 있나, 다음 병목에 있나? 대형사의 로드맵이 이미 덮고 있는가?
- 이 기술을 누가, 왜 사 줄 것인가? 인수·라이선스 후보가 투자 시점에 이미 설명되는가?
- 신모델·신칩이 나왔을 때 지원까지 얼마나 걸리는가? (인프라 소프트웨어·NPU 생태계 회사의 경우)
- 국내 대기업 또는 규제 산업이 첫 고객이 될 수 있는가? 그 고객이 내재화하지 않을 이유는 무엇인가?
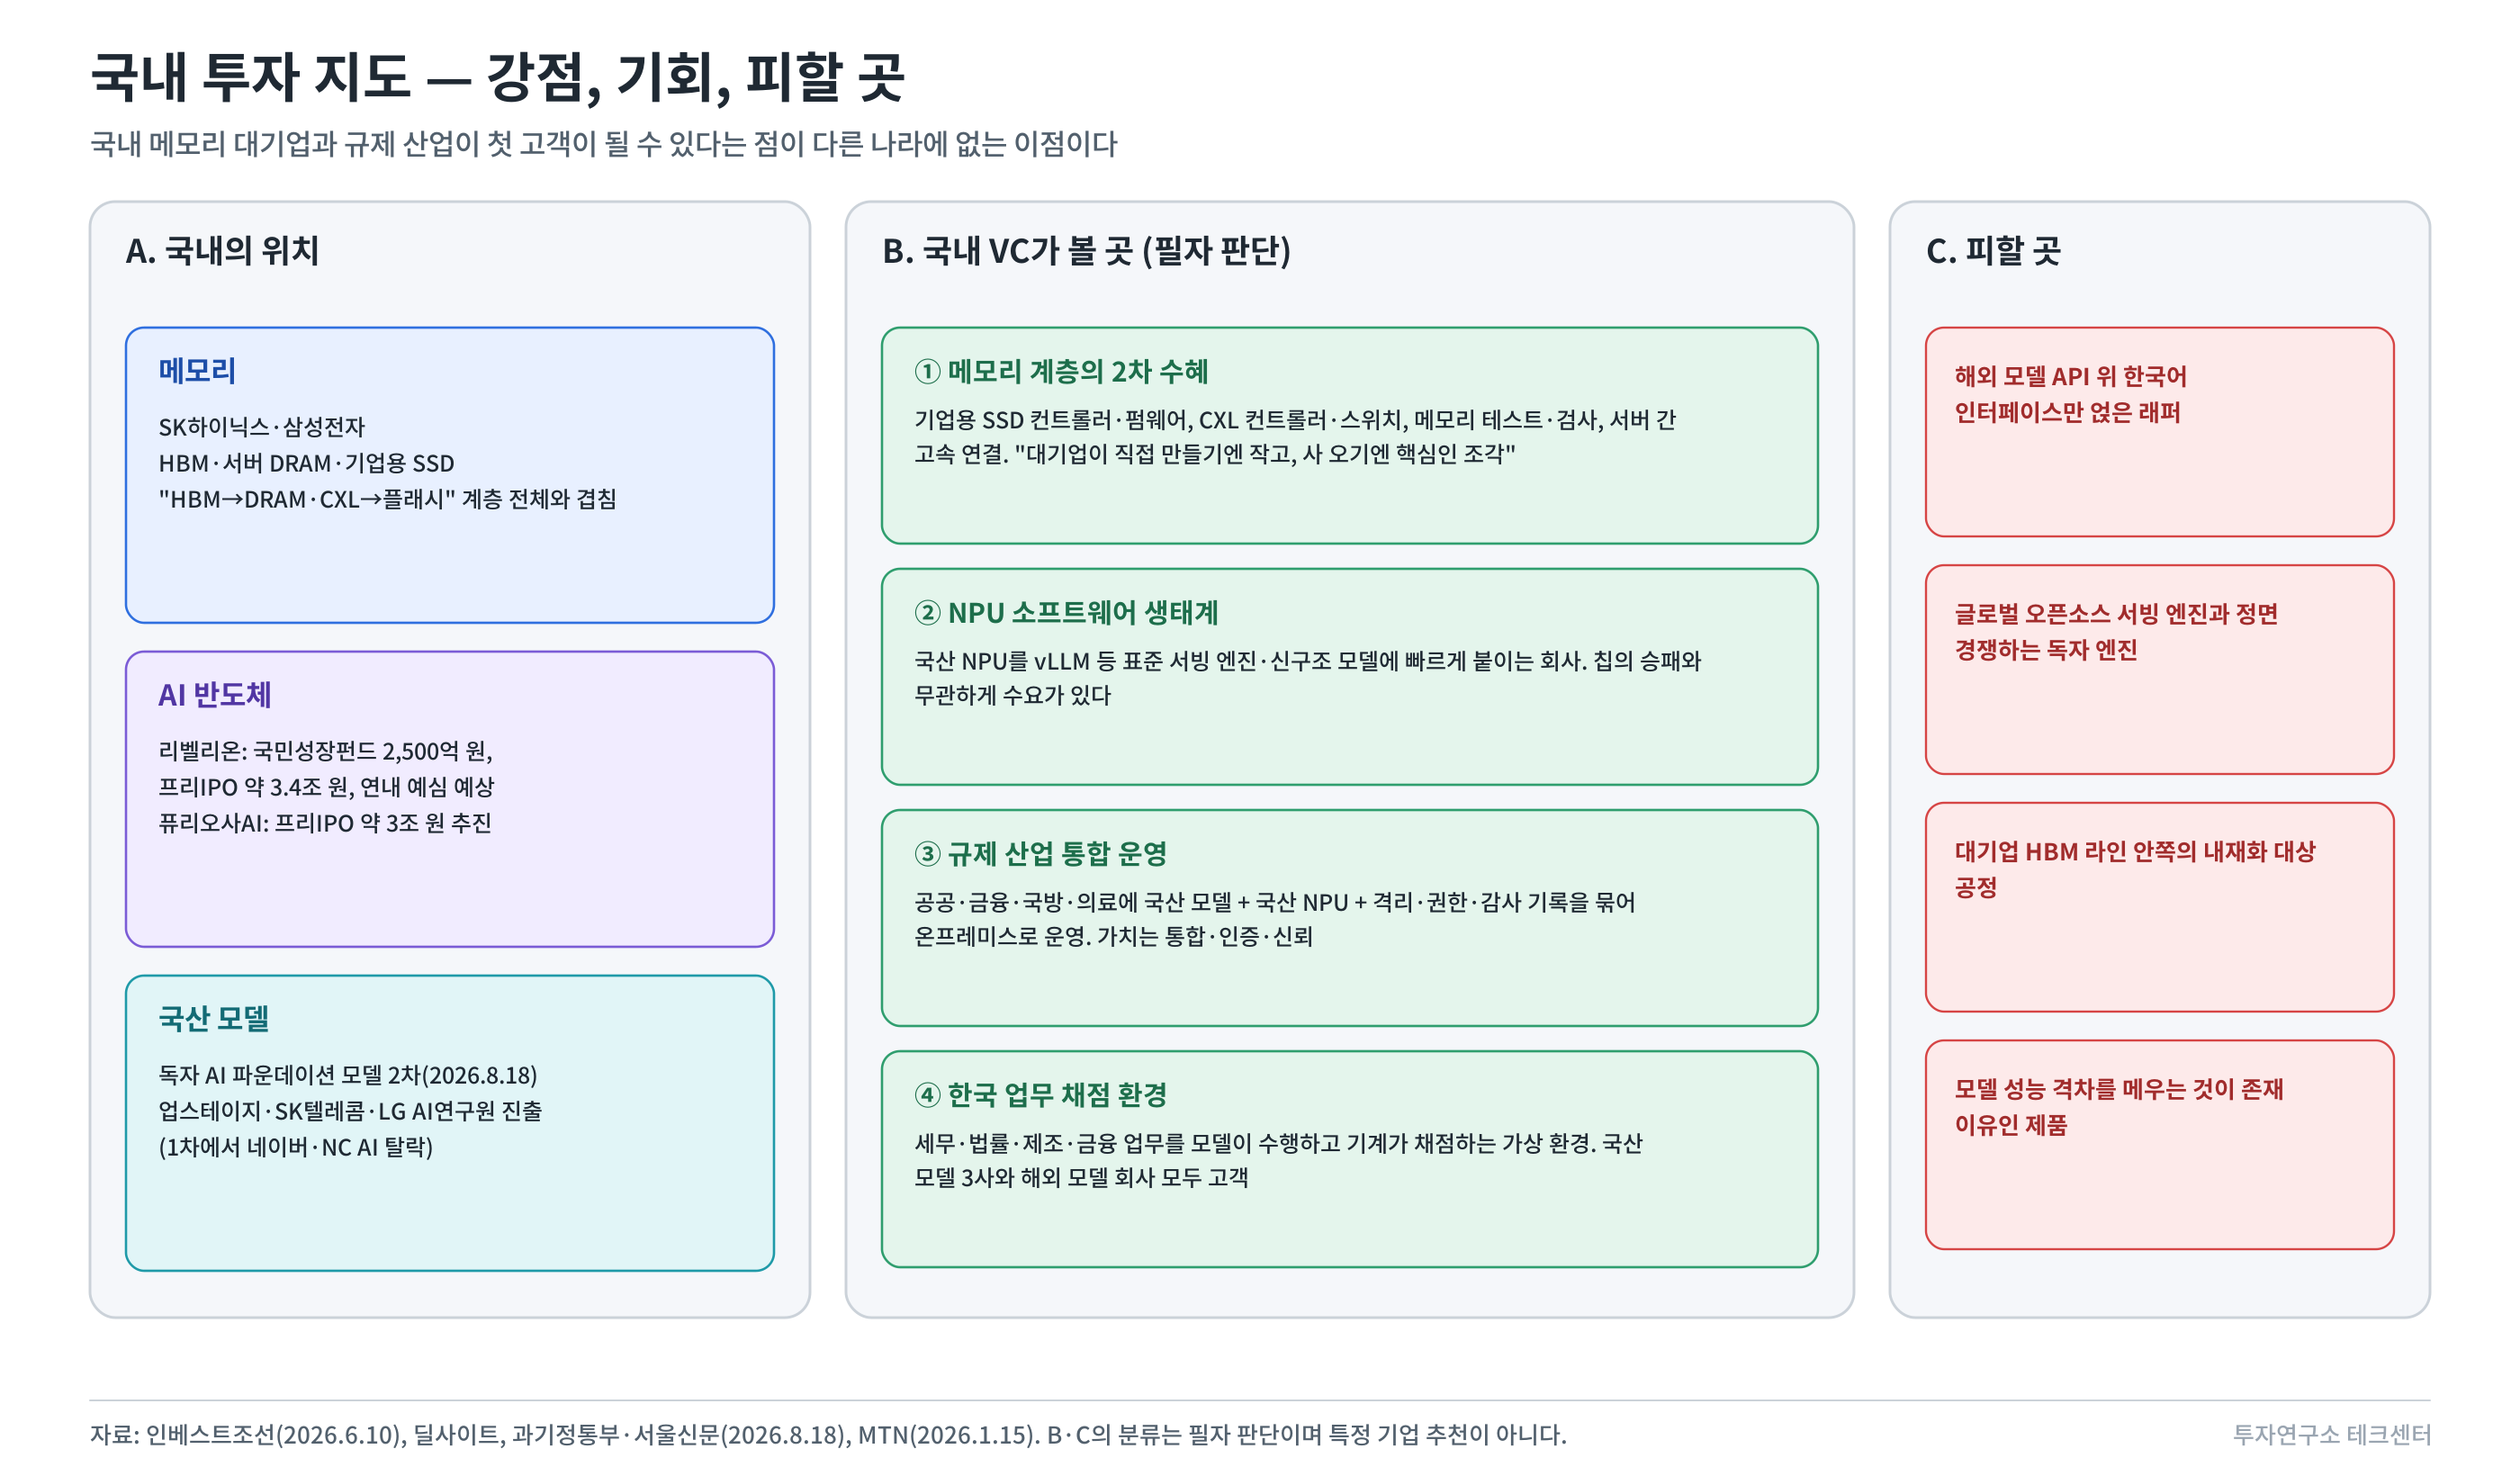
그림 5-7. 국내 투자 지도 - 강점, 기회, 피할 곳 8. 2026년 4분기 이후 확인할 일곱 가지
- 조건부 메모리 테이블의 실서비스 배치 위치. V4.1-Flash의 196B 테이블을 HBM에 두는지 DRAM·SSD에 두는지, V4.1-Pro 같은 후속 모델의 테이블 크기(4부).
- KV 저장 계층의 실제 채택. NVIDIA 문맥 메모리 스토리지의 2026년 하반기 출시와 채택 속도, API 가격표의 캐시 적중·미스 가격 차이.
- 추론 토큰 총량 대 단가. 태스크당 비용이 내려가는 속도와 사용량이 늘어나는 속도의 비교. 1부의 지능지수 대 태스크당 비용 산포도를 분기마다 다시 그리면 된다.
- 프리필·디코드 분리의 확산. 분리 서빙 채택, 프리필 전용 칩의 실제 배치, 특화 칩 회사의 추가 인수·라이선스.
- 서빙 소프트웨어의 신모델 지원 속도. 신구조 모델(V4.1, Qwen3.8-Flash-Next) 출시부터 주요 서빙 엔진·국산 NPU 지원까지 걸린 기간.
- 국내 이벤트. 리벨리온·퓨리오사AI의 상장 일정과 시장(코스피·코스닥) 결정, 독자 AI 파운데이션 모델 3단계 평가.
- 규제와 학습 재개. 미국 수출통제, OpenAI의 도구 사용 학습 재개, 연구 환경 보안 사고(1부).
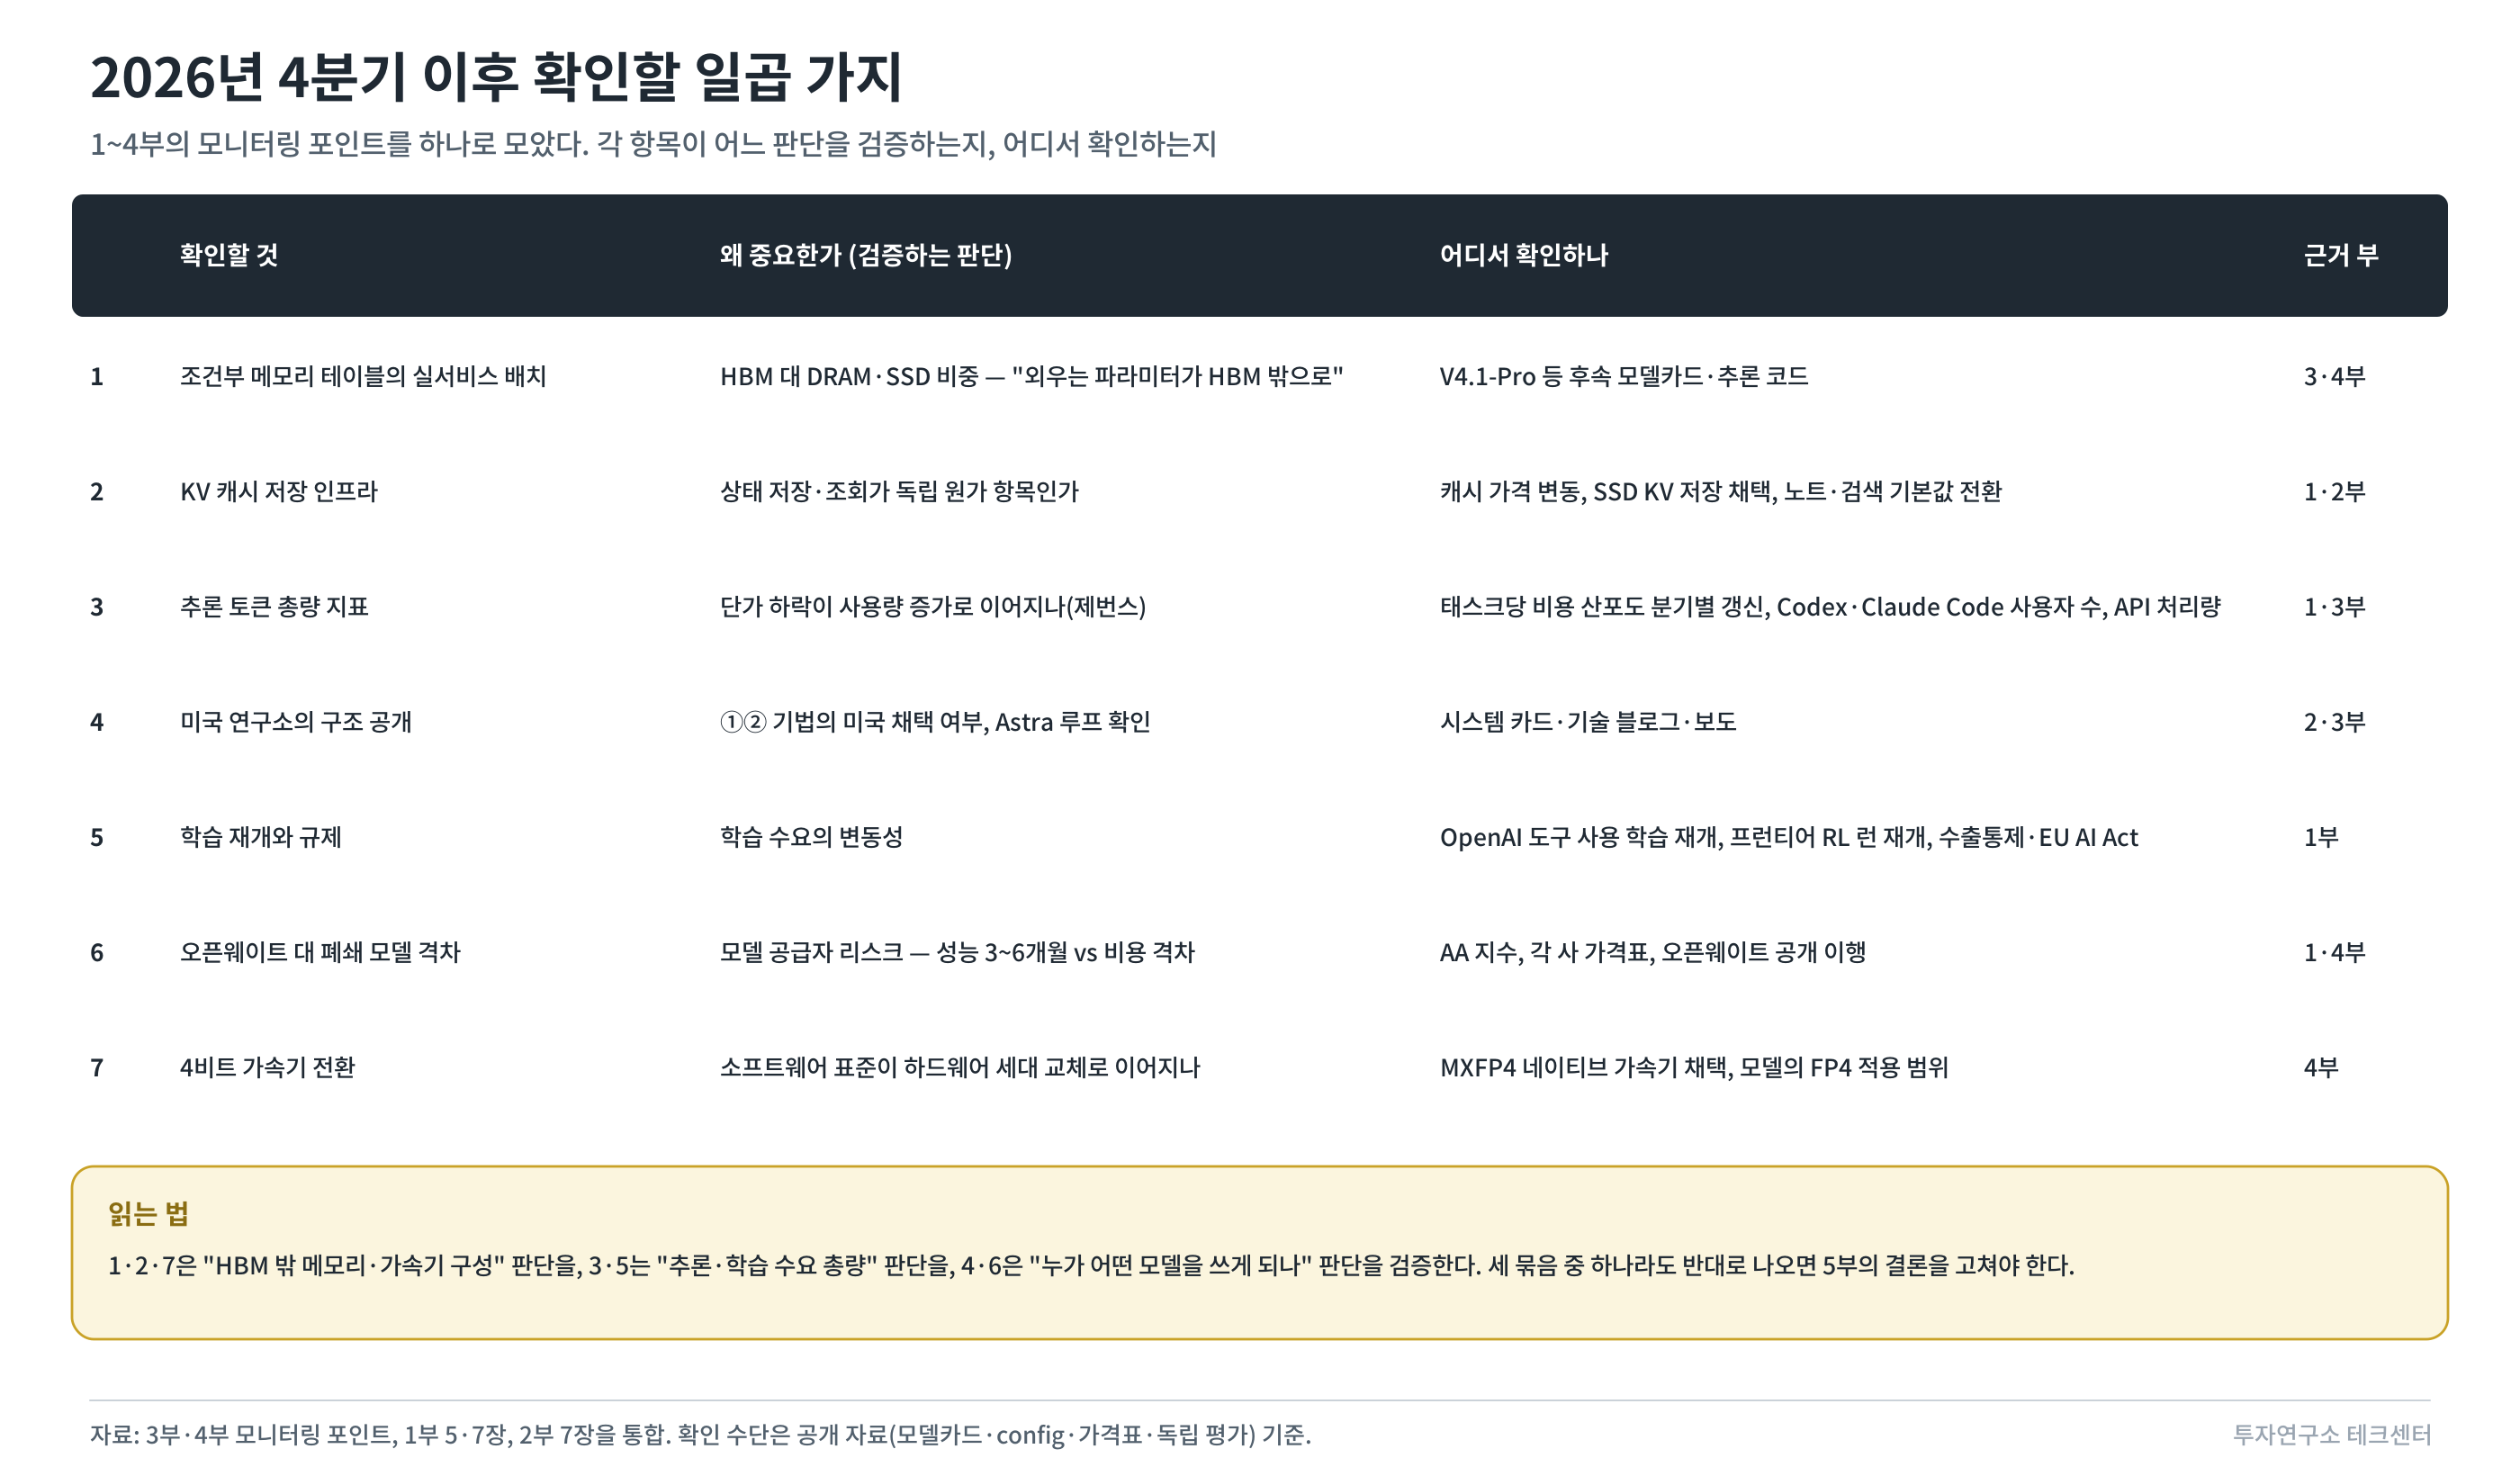
그림 5-8. 2026년 4분기 이후 확인할 일곱 가지 9. 투자 시사점 - 시리즈를 마치며
(1) 추론 수요는 토큰이 아니라 "작업"에 비례해 늘어난다. 토큰당 가격은 내려가지만, 에이전트가 사람의 작업 시간을 대체하는 한 기계가 쓰는 시간은 늘어난다. 그리고 그 수요의 상당 부분은 연구소 내부와 RL 학습 클러스터 안의 추론처럼 외부 매출 통계에 잡히지 않는다. 개인적으로는 토큰 생산의 효율성이 올라갈수록, AI가 AI를 연구/개발할수록 기하급수적인 수요가 있을 것이라고 생각된다.
(2) 하드웨어는 병목이 옮겨 가는 곳에 투자한다. HBM은 용량보다 대역폭과 세대 교체로 보고, 그 아래의 DRAM·CXL·플래시 계층과 계층 사이의 데이터 이동, GPU 사이의 연결이 새 수요의 중심이 된다. 추론 칩은 프리필용과 디코드용으로 갈라지고, 특화 칩의 가치는 큰 시스템에 편입될 때 실현된다.
(3) 소프트웨어는 "모델이 좋아질수록 더 필요해지는가"로 고른다. 서빙 소프트웨어(모델이 자주 바뀔수록), 채점 환경(더 많은 영역을 배울수록), 실행 격리(더 오래 혼자 일할수록), 작업 화면(하니스가 표준이 될수록)이 그렇다. 모델의 약점을 메우는 제품은 피한다. 개인적으로는 모델의 약점은 언젠가 대부분 해결이 된다고 생각한다.
(4) VC는 다음 병목, 그리고 대형사가 사 줄 수밖에 없는 조각에 건다. 2025~2026년의 큰 회수는 대형사가 플랫폼의 빈 조각을 인수·라이선스로 채운 거래였다. 투자 시점에 인수자와 이유가 설명되는 회사가 좋은 투자처다.
(5) 국내는 메모리 계층의 2차 수혜, NPU 소프트웨어 생태계, 규제 산업의 통합 운영, 한국 업무의 채점 환경에 기회가 있다. 국내 메모리 대기업과 규제 산업이 첫 고객이 될 수 있다는 점이 다른 나라에 없는 이점이고, 대기업이 직접 만들기에는 작고 사 오기에는 핵심인 조각이 최적 지점이다.
이 시리즈는 모델 쪽에서 출발해 하드웨어·소프트웨어 수요와 투자 방향까지 왔다. 종목 단위의 분석은 이 시리즈의 범위 밖이며, 각 영역의 밸류체인은 이 블로그의 반도체·AI 인프라 글들에서 이어서 다룬다.
Reference
1~4부 인용 자료
- 각 부의 레퍼런스(각 사 공식 발표·시스템 카드·기술보고서·모델카드·논문, Artificial Analysis, UK AISI, 보도)
5부에서 추가한 자료
- The Register, "Nvidia's context-optimized Rubin CPX GPUs were inevitable" (2025.9.10) - 프리필 전용 GPU, GDDR7 128GB
- TechRepublic, "Nvidia Licenses Groq AI Inference Technology in $20B Deal" (2025.12) - 비독점 라이선스, 경영진 영입, Groq 독립 유지
- NVIDIA 보도자료, "NVIDIA BlueField-4 Powers New Class of AI-Native Storage Infrastructure" (2026.1 CES) / NAND Research, "Improving Inference: NVIDIA's Inference Context Memory Storage Platform" - G3.5 계층, 2026년 하반기 출시
- Light Reading, "Marvell to scoop up Celestial AI for $3.25B" (2025.12)
- SiliconANGLE, "Inferact launches with $150M in funding to commercialize vLLM" (2026.1.22) / Bloomberg (2026.1.22)
- VentureBeat, "Anthropic says it hit a $30 billion revenue run rate" (2026.5.8) - Claude Code 연환산 매출
- Constellation Research, "OpenAI touts broadening Codex usage with 5 million weekly active users" (2026.6.2)
- 인베스트조선, "국민성장펀드 투자 받은 리벨리온·퓨리오사AI...힘 실리는 코스닥行" (2026.6.10)
- 딜사이트, "리벨리온 이기려는 퓨리오사…프리IPO 3조 고수"
- 과학기술정보통신부, 「독자 AI 파운데이션 모델」 프로젝트 2차 단계평가 결과 발표 (2026.8.18) / 서울신문 (2026.8.18)
- MTN, "네이버·엔씨AI, 국가대표 AI 1차 탈락" (2026.1.15)
이 글은 스터디를 하면서 쓴 글이고, 투자 권유가 아닙니다. 투자의 책임은 투자자 본인에게 있습니다.
반응형'최신 기술동향 > 인공지능 (AI)' 카테고리의 다른 글
[AI 모델 동향 4부] 2026년 최신 LLM 알고리즘 - DeepSeek·Kimi·Qwen이 트랜스포머에서 바꾼 것 (0) 2026.10.05 [AI 모델 동향 3부] LLM 성능을 올리는 연구/개발 동향 (1) 2026.10.04 [AI 모델 동향 2부] 세 플래그십의 공통 기술 - 추론 학습, 루프 구조, 사고 기록, 컨텍스트 관리, 멀티에이전트 (0) 2026.10.04 [AI 모델 동향 1부] AI 모델 비교 - 기업별 AI 설계 철학 (0) 2026.10.03 데이터센터와 광통신 - 3부 AI DC 광연결과 기업 동향 (0) 2026.09.09